Hallo! Ich bin Andrei Kvapil, in Communitys rund um Kubernetes und Cloud-native-Tools kennt man mich vielleicht als @kvaps. In diesem Artikel möchte ich zeigen, wie wir in der Open-Source-PaaS-Plattform Cozystack einen eigenen Extension-API-Server umgesetzt haben.
Kubernetes beeindruckt mich immer wieder mit seinen mächtigen Erweiterungsmöglichkeiten. Wahrscheinlich kennen Sie bereits das Controller-Konzept und Frameworks wie kubebuilder und operator-sdk, mit denen man es umsetzt. Kurz gesagt erweitern Sie damit Ihren Kubernetes-Cluster, indem Sie Custom Resources (CRDs) definieren und zusätzliche Controller schreiben, die Ihre Geschäftslogik für das Reconciling und die Verwaltung dieser Ressourcen abbilden. Dieser Ansatz ist gut dokumentiert, und im Netz finden sich Unmengen an Material dazu, wie man eigene Operatoren entwickelt.
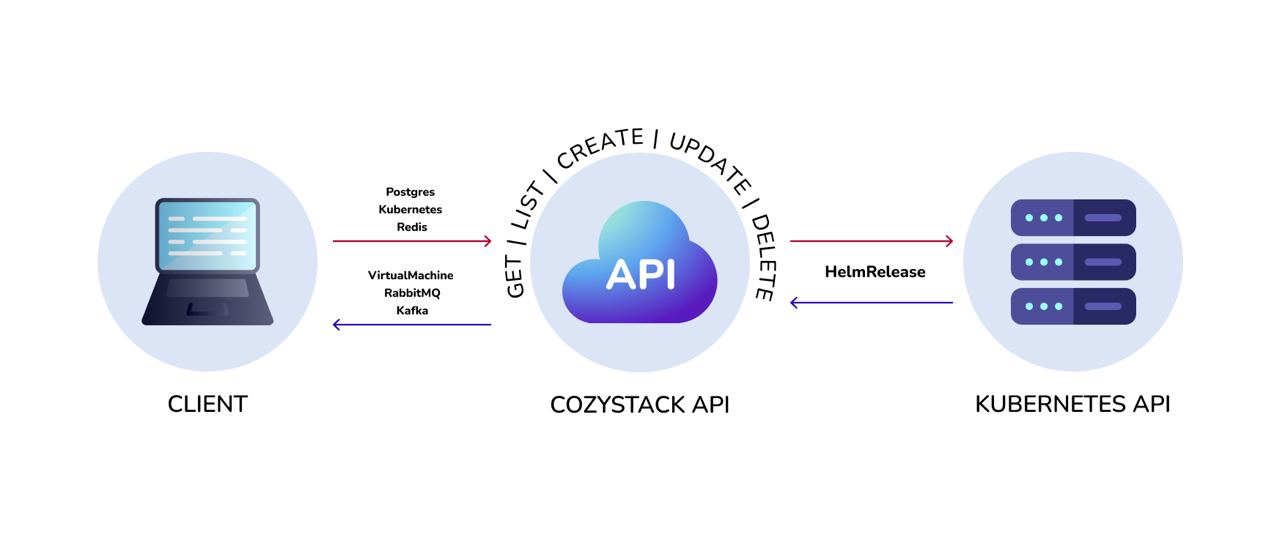
Das ist jedoch nicht der einzige Weg, die Kubernetes-API zu erweitern. Für komplexere Szenarien, etwa imperative Logik, die Verwaltung von Subresources oder dynamisch erzeugte Antworten, bietet der Aggregation Layer der Kubernetes-API eine wirkungsvolle Alternative. Über den Aggregation Layer können Sie einen eigenen Extension-API-Server entwickeln und nahtlos in das übergreifende Kubernetes-API-Gefüge einbinden.
In diesem Artikel beleuchte ich den API Aggregation Layer: welche Probleme er gut löst, in welchen Fällen er weniger geeignet ist und wie wir mit diesem Modell in Cozystack unseren eigenen Extension-API-Server umgesetzt haben.
Was ist der API Aggregation Layer?
Klären wir zunächst die Begriffe, damit es später keine Verwirrung gibt. Der API Aggregation Layer ist ein Feature von Kubernetes, ein Extension-API-Server dagegen eine konkrete Implementierung eines API-Servers für diesen Aggregation Layer. Ein Extension-API-Server funktioniert wie der normale Kubernetes-API-Server, läuft aber separat und bedient Anfragen für Ihre spezifischen Ressourcentypen.
Mit dem Aggregation Layer können Sie also einen eigenen Extension-API-Server schreiben, ihn ohne großen Aufwand in Kubernetes integrieren und Anfragen für Ressourcen einer bestimmten Gruppe direkt verarbeiten. Anders als beim CRD-Mechanismus wird die Extension-API in Kubernetes als APIService registriert. Damit weiß Kubernetes, dass es diesen neuen API-Server berücksichtigen soll und dass er bestimmte APIs bereitstellt.
Mit diesem Befehl listen Sie alle registrierten APIServices auf:
kubectl get apiservices.apiregistration.k8s.io
Beispiel für einen APIService:
NAME                          	SERVICE                   	AVAILABLE   AGE
v1alpha1.apps.cozystack.io    	cozy-system/cozystack-api 	True    	7h29m
Sobald der Kubernetes-API-Server Anfragen für Ressourcen der Gruppe v1alpha1.apps.cozystack.io erhält, leitet er sie alle an unseren Extension-API-Server weiter, der sie nach der Geschäftslogik verarbeitet, die wir in ihn eingebaut haben.
Wann sich der API Aggregation Layer anbietet
Der API Aggregation Layer hilft bei mehreren Problemen, für die der übliche CRD-Mechanismus nicht ausreicht. Gehen wir sie der Reihe nach durch.
Imperative Logik und Subresources
Neben regulären Ressourcen kennt Kubernetes auch sogenannte Subresources.
Subresources sind in Kubernetes zusätzliche Aktionen oder Operationen, die Sie über die Kubernetes-API auf primären Ressourcen (etwa Pods, Deployments, Services) ausführen können. Sie bieten Schnittstellen, um bestimmte Aspekte einer Ressource zu verwalten, ohne das gesamte Objekt anzufassen.
Ein einfaches Beispiel ist status, das traditionell als eigene Subresource bereitgestellt wird und sich unabhängig vom übergeordneten Objekt ansprechen lässt. Das Feld status ist nicht dafür gedacht, von Benutzern geändert zu werden; Controller aktualisieren es über diese Subresource.
Neben /status haben Pods in Kubernetes aber auch Subresources wie /exec, /portforward und /log. Interessanterweise sind das keine der in Kubernetes üblichen deklarativen Ressourcen, sondern Endpunkte für imperative Operationen: Logs ansehen, Verbindungen proxyen, Befehle in einem laufenden Container ausführen und so weiter.
Wenn Ihre eigene API solche imperativen Befehle unterstützen soll, müssen Sie eine Extension-API und einen Extension-API-Server implementieren. Einige bekannte Beispiele:
- KubeVirt: ein Add-on für Kubernetes, das dessen API so erweitert, dass klassische virtuelle Maschinen laufen können. Der Extension-API-Server von KubeVirt bedient für virtuelle Maschinen Subresources wie
/restart,/consoleund/vnc. - Knative: ein Kubernetes-Add-on, das die Plattform um Serverless Computing erweitert und die Subresource
/scaleimplementiert, um für seine Ressourcentypen Autoscaling einzurichten.
Übrigens: Auch wenn die Logik von Subresources in Kubernetes imperativ sein kann, lässt sich der Zugriff darauf deklarativ über das Standard-RBAC-Modell von Kubernetes steuern.
So können Sie beispielsweise den Zugriff auf die Subresources /log und /exec des Kinds Pod regeln:
kind: Role
apiVersion: rbac.authorization.k8s.io/v1
metadata:
  namespace: default
  name: pod-and-pod-logs-reader
rules:
- apiGroups: [""]
  resources: ["pods", "pods/log"]
  verbs: ["get", "list"]
- apiGroups: [""]
  resources: ["pods/exec"]
  verbs: ["create"]
Sie sind nicht an etcd gebunden
Normalerweise nutzt der Kubernetes-API-Server etcd als Backend. Ein eigener API-Server legt Sie aber nicht auf etcd fest. Wenn es keinen Sinn ergibt, den Zustand Ihres Servers in etcd abzulegen, können Sie die Daten in einem beliebigen anderen System speichern und die Antworten zur Laufzeit erzeugen. Ein paar Beispiele zur Veranschaulichung:
- metrics-server ist eine Standarderweiterung für Kubernetes, mit der Sie Echtzeitmetriken Ihrer Nodes und Pods einsehen können. Er definiert in seiner eigenen API metrics.k8s.io alternative Kinds für Pod und Node. Anfragen an diese Ressourcen werden direkt in Metriken aus dem Kubelet übersetzt. Wenn Sie also
kubectl top nodeoderkubectl top podausführen, holt metrics-server die Metriken in Echtzeit aus cAdvisor und gibt sie an Sie zurück. Da diese Informationen in Echtzeit entstehen und nur im Moment der Anfrage relevant sind, müssen sie nicht in etcd gespeichert werden. Das spart Ressourcen. - Bei Bedarf können Sie ein anderes Backend als etcd verwenden und sogar eine Kubernetes-kompatible API dafür implementieren. Nutzen Sie etwa Postgres, können Sie dessen Entitäten transparent in der Kubernetes-API abbilden. Datenbanken, Benutzer und Grants in Postgres erscheinen dank Ihres Extension-API-Servers dann als reguläre Kubernetes-Ressourcen. Verwalten können Sie sie mit
kubectloder jedem anderen Kubernetes-kompatiblen Tool. Anders als Controller, die Geschäftslogik über Custom Resources und Reconciliation abbilden, macht ein Extension-API-Server separate Controller für jeden Kind überflüssig. Sie müssen also keinen Zustand zwischen der Kubernetes-API und Ihrem Backend synchronisieren.
Einmal-Ressourcen
- Kubernetes besitzt eine spezielle API, die Benutzern Auskunft über ihre Berechtigungen gibt. Umgesetzt ist sie über die SelfSubjectAccessReview-API. Eine Besonderheit dieser Ressourcen: Sie lassen sich nicht mit den Verben get oder list ansehen. Man kann sie nur erstellen (mit dem Verb create) und erhält als Ausgabe die Information, worauf man in diesem Moment Zugriff hat.
- Wenn Sie direkt
kubectl get selfsubjectaccessreviewsausführen, bekommen Sie nur einen Fehler wie diesen:
Error from server (MethodNotAllowed): the server does not allow this method on the requested resource
- Der Grund: Der Kubernetes-API-Server unterstützt für diesen Ressourcentyp keine andere Interaktion (Sie können ihn nur per CREATE anlegen).
- Die SelfSubjectAccessReview-API unterstützt Befehle wie
kubectl auth can-i create deployments --namespace dev - Wenn Sie den obigen Befehl ausführen, legt
kubectlüber die Kubernetes-API einen SelfSubjectAccessReview an. Dadurch ermittelt Kubernetes die möglichen Berechtigungen Ihres Benutzers und erzeugt in Echtzeit eine personalisierte Antwort auf Ihre Anfrage. Diese Logik unterscheidet sich von einem Szenario, in dem die Ressource einfach in etcd gespeichert wird. - Ähnlich verhält es sich mit der KubeVirt-Erweiterung CDI (Containerized Data Importer), mit der sich per
virtctlDateien von einem lokalen Rechner in ein PVC hochladen lassen. Bevor der Upload beginnt, ist ein spezielles Token nötig. Dieses Token entsteht, indem über die Kubernetes-API eine UploadTokenRequest-Ressource angelegt wird. Kubernetes leitet (proxyt) alle Anfragen zum Anlegen von UploadTokenRequest-Ressourcen an den Extension-API-Server von CDI weiter, der das Token erzeugt und in der Antwort zurückgibt.
Volle Kontrolle über Konvertierung, Validierung und Ausgabeformat
- Ihr eigener API-Server kann sämtliche Fähigkeiten des Vanilla-Kubernetes-API-Servers mitbringen. Ressourcen, die Sie in Ihrem API-Server anlegen, lassen sich sofort serverseitig validieren, ohne zusätzliche Webhooks. CRDs unterstützen zwar ebenfalls serverseitige Validierung, deklarativ über die Common Expression Language (CEL) und über ValidatingAdmissionPolicies, ganz ohne Webhooks. Ein eigener API-Server erlaubt bei Bedarf aber komplexere und passgenauere Validierungslogik.
- Kubernetes kann für jeden Ressourcentyp mehrere API-Versionen bereitstellen, traditionell
v1alpha1,v1beta1undv1. Nur eine davon kann als Storage-Version festgelegt werden. Alle Anfragen an andere Versionen müssen automatisch in die Storage-Version konvertiert werden. Bei CRDs geschieht das über Conversion Webhooks. In einem Extension-API-Server dagegen können Sie einen eigenen Konvertierungsmechanismus implementieren, verschiedene Storage-Versionen mischen (ein Objekt wird alsv1serialisiert, ein anderes alsv2) oder sich auf eine externe Backing-API stützen. - Wenn Sie die Kubernetes-API direkt implementieren, können Sie die Tabellenausgabe frei gestalten und sind nicht an die
additionalPrinterColumns-Logik von CRDs gebunden. Stattdessen schreiben Sie einen eigenen Formatter für die Tabellenausgabe und die darin enthaltenen benutzerdefinierten Felder. MitadditionalPrinterColumnskönnen Sie Feldwerte zum Beispiel nur nach JSONPath-Logik anzeigen. In Ihrem eigenen API-Server können Sie Werte zur Laufzeit erzeugen und einfügen und die Tabellenausgabe ganz nach Wunsch formatieren.
Dynamische Registrierung von Ressourcen
Die Ressourcen, die ein Extension-API-Server bereitstellt, müssen nicht vorab als CRDs registriert sein. Sobald Ihr Extension-API-Server über einen APIService registriert ist, fragt Kubernetes ihn regelmäßig ab, um herauszufinden, welche APIs und Ressourcen er bedienen kann. Nach Erhalt der Discovery-Antwort registriert der Kubernetes-API-Server automatisch alle verfügbaren Typen dieser API-Gruppe. Auch wenn das nicht als gängige Praxis gilt, können Sie Logik implementieren, die die benötigten Ressourcentypen dynamisch in Ihrem Kubernetes-Cluster registriert.
Wann man den API Aggregation Layer besser nicht einsetzt
Es gibt einige Anti-Patterns, bei denen vom API Aggregation Layer abzuraten ist. Sehen wir sie uns an.
Instabiles Backend
Wenn Ihr API-Server aus irgendeinem Grund nicht mehr antwortet, weil das Backend nicht erreichbar ist oder andere Probleme auftreten, kann das Teile der Kubernetes-Funktionalität blockieren. Beim Löschen von Namespaces etwa wartet Kubernetes auf eine Antwort Ihres API-Servers, um zu prüfen, ob noch Ressourcen übrig sind. Bleibt die Antwort aus, hängt das Löschen des Namespace fest.
Vielleicht kennen Sie auch die Situation, in der bei nicht verfügbarem metrics-server nach jeder API-Anfrage (selbst ohne Bezug zu Metriken) eine zusätzliche Meldung in stderr erscheint, dass metrics.k8s.io nicht verfügbar ist. Ein weiteres Beispiel dafür, wie der API Aggregation Layer Probleme verursachen kann, wenn der API-Server, der die Anfragen bearbeitet, nicht erreichbar ist.
Langsame Anfragen
Wenn Sie nicht garantieren können, dass Benutzeranfragen sofort beantwortet werden, sollten Sie besser eine CustomResourceDefinition mit Controller in Betracht ziehen. Andernfalls machen Sie Ihren Cluster womöglich instabiler. Viele Projekte implementieren einen Extension-API-Server nur für eine begrenzte Menge an Ressourcen, insbesondere für imperative Logik und Subresources. Diese Empfehlung findet sich auch in der offiziellen Kubernetes-Dokumentation (Hinweis).
Warum wir das in Cozystack brauchten
Zur Erinnerung: Wir entwickeln die Open-Source-PaaS-Plattform Cozystack, die sich auch als Framework für den Aufbau einer eigenen Private Cloud nutzen lässt. Deshalb ist es für uns entscheidend, dass sich die Plattform leicht erweitern lässt.
Cozystack basiert auf FluxCD. Jede Anwendung ist in ein eigenes Helm-Chart verpackt, das für das Deployment in einem Tenant-Namespace bereitsteht. Um eine Anwendung auf der Plattform auszurollen, legt man eine HelmRelease-Ressource an und gibt darin den Chart-Namen und die Parameter der Anwendung an. Die gesamte übrige Logik übernimmt FluxCD. Mit diesem Muster können wir die Plattform leicht um neue Anwendungen erweitern; neue Anwendungen müssen lediglich in ein passendes Helm-Chart verpackt werden.
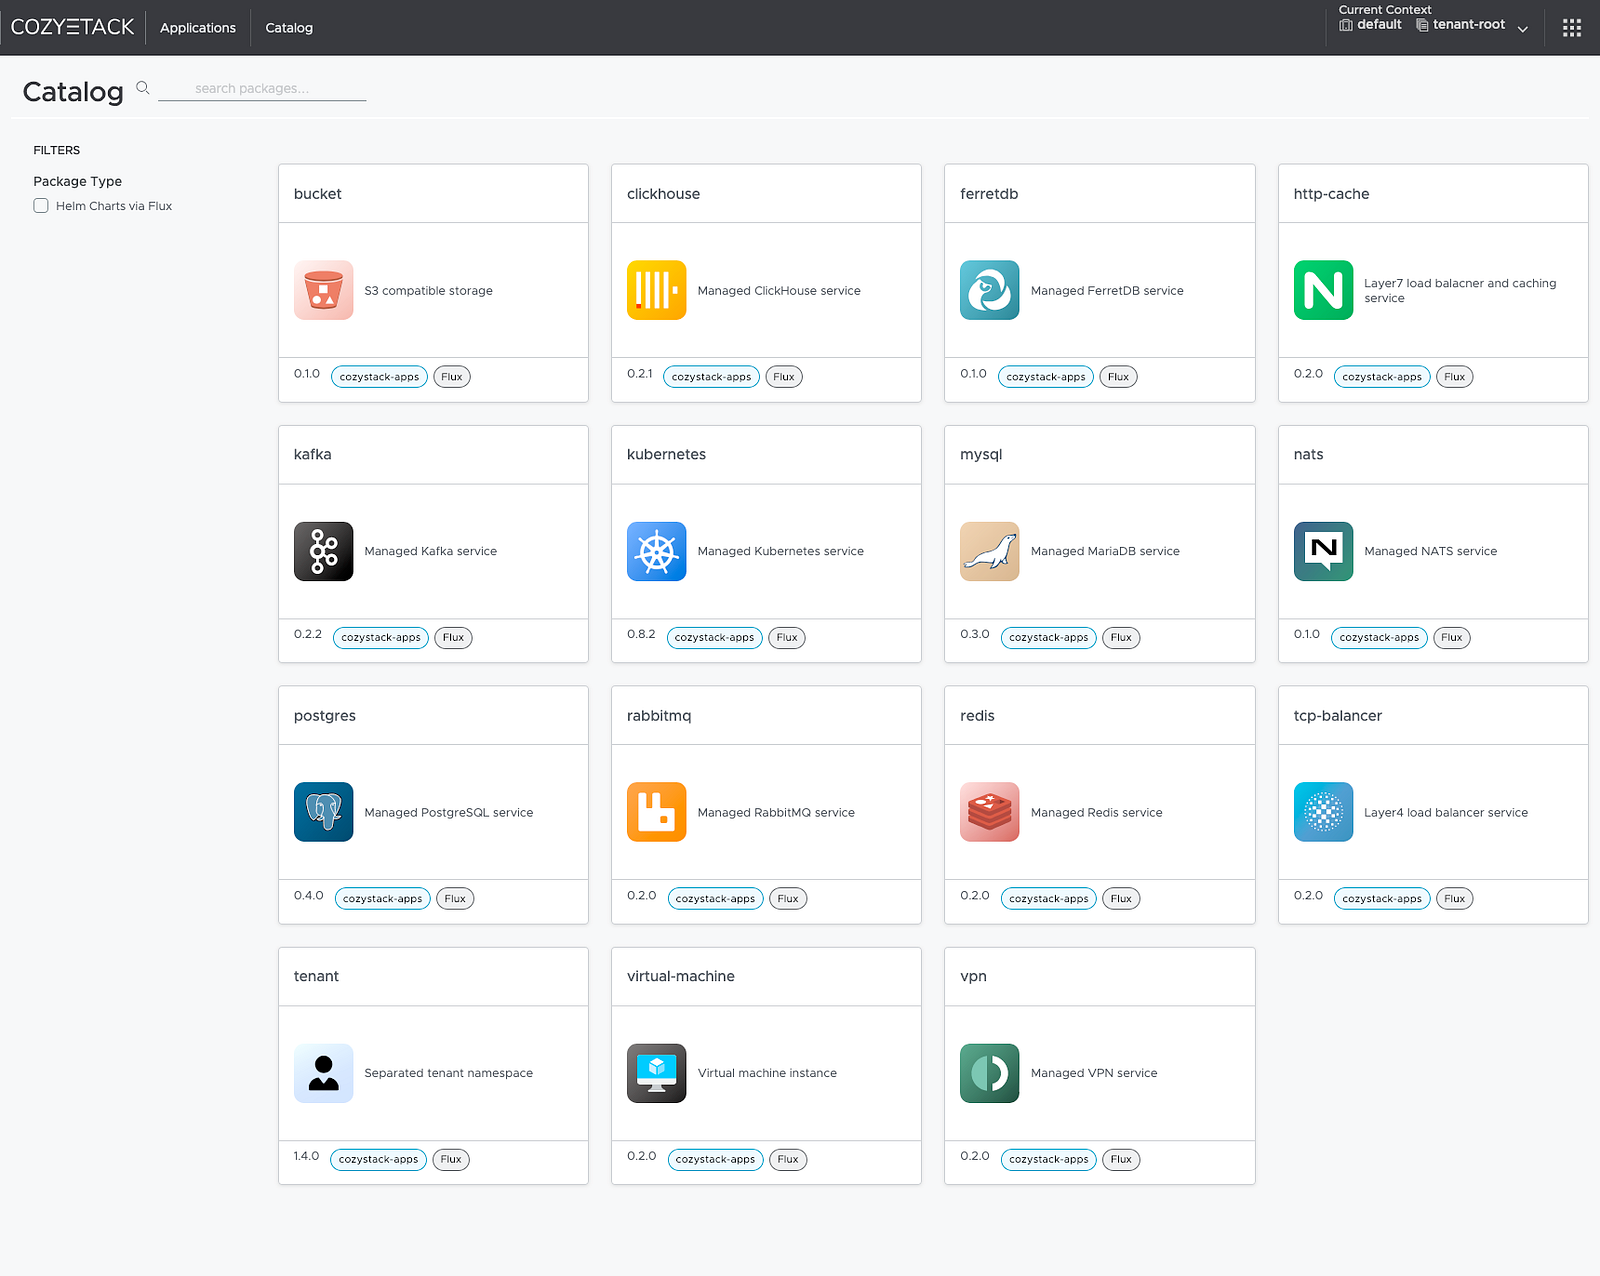
Oberfläche der Cozystack-Plattform
Auf unserer Plattform wird also alles als HelmRelease-Ressource konfiguriert. Dabei sind wir jedoch auf zwei Probleme gestoßen: die Grenzen des RBAC-Modells und den Bedarf an einer öffentlichen API. Sehen wir sie uns genauer an
Grenzen des RBAC-Modells
Das verbreitete RBAC-System von Kubernetes erlaubt es nicht, den Zugriff auf eine Liste von Ressourcen desselben Kinds anhand von Labels oder bestimmten Feldern in der Spec einzuschränken. Beim Anlegen einer Rolle können Sie den Zugriff innerhalb eines Kinds nur begrenzen, indem Sie in resourceNames konkrete Ressourcennamen angeben. Für Verben wie get oder update funktioniert das. Beim Verb list greift die Filterung über resourceNames jedoch nicht auf diese Weise. Sie können das Auflisten also nach Kind einschränken, nicht aber nach Namen.
Deshalb haben wir beschlossen, neue Ressourcentypen einzuführen, die nach den verwendeten Helm-Charts benannt sind, und die Liste der verfügbaren Kinds in unserem Extension-API-Server zur Laufzeit dynamisch zu erzeugen. So können wir das Standard-RBAC-Modell von Kubernetes nutzen, um den Zugriff auf bestimmte Ressourcentypen zu steuern.
Bedarf an einer öffentlichen API
Da unsere Plattform das Deployment verschiedener Managed Services ermöglicht, wollen wir einen öffentlichen Zugang zur API der Plattform schaffen. Wir können Benutzern aber nicht erlauben, direkt mit Ressourcen wie HelmRelease zu arbeiten, denn dann könnten sie beliebige Namen und Parameter für die auszurollenden Helm-Charts angeben und damit unser System gefährden.
Benutzer sollten einen bestimmten Service einfach dadurch ausrollen können, dass sie in Kubernetes eine Ressource des entsprechenden Kinds anlegen. Der Typ dieser Ressource sollte genauso heißen wie das Chart, aus dem sie ausgerollt wird. Einige Beispiele:
kind: Kubernetes→chart: kuberneteskind: Postgres→chart: postgreskind: Redis→chart: rediskind: VirtualMachine→chart: virtual-machine
Außerdem wollen wir nicht jedes Mal einen neuen Typ in den Codegen aufnehmen und unseren Extension-API-Server neu kompilieren müssen, wenn wir ein neues Chart hinzufügen, damit es bereitgestellt wird. Das Schema sollte sich dynamisch aktualisieren oder vom Administrator über eine ConfigMap vorgegeben werden.
Konvertierung in beide Richtungen
Derzeit haben wir bereits Integrationen und ein Dashboard, die weiterhin HelmRelease-Ressourcen verwenden. Die Unterstützung dieser API wollten wir an dieser Stelle nicht aufgeben. Da wir lediglich eine Ressource in eine andere übersetzen, bleibt die Unterstützung erhalten, und zwar in beide Richtungen. Legen Sie eine HelmRelease an, erhalten Sie in Kubernetes eine Custom Resource; legen Sie in Kubernetes eine Custom Resource an, ist sie ebenso als HelmRelease verfügbar.
Wir haben keine zusätzlichen Controller, die den Zustand zwischen diesen Ressourcen synchronisieren. Alle Anfragen an Ressourcen in unserem Extension-API-Server werden transparent an HelmRelease durchgereicht und umgekehrt. Das beseitigt Zwischenzustände und erspart uns, Controller und Synchronisationslogik zu schreiben.
Implementierung
Wenn Sie die Aggregation API umsetzen wollen, bieten sich als Ausgangspunkt folgende Projekte an:
- apiserver-builder: derzeit im Alpha-Stadium und seit zwei Jahren nicht aktualisiert. Es funktioniert ähnlich wie kubebuilder und stellt ein Framework zum Erstellen eines Extension-API-Servers bereit, mit dem Sie Schritt für Schritt eine Projektstruktur anlegen und Code für Ihre Ressourcen generieren.
- sample-apiserver: ein fertiges Beispiel für einen implementierten API-Server auf Basis der offiziellen Kubernetes-Bibliotheken, das Sie als Grundlage für Ihr Projekt nutzen können.
Aus praktischen Gründen haben wir uns für das zweite Projekt entschieden. Folgendes war zu tun:
etcd-Unterstützung deaktivieren
In unserem Fall brauchen wir sie nicht, da alle Ressourcen direkt in der Kubernetes-API gespeichert werden.
Die etcd-Optionen lassen sich deaktivieren, indem man RecommendedOptions.Etcd den Wert nil übergibt:
Einen gemeinsamen Ressourcen-Kind erzeugen
Wir haben ihn Application genannt, und er sieht so aus:
Das ist ein generischer Typ, der für jeden Anwendungstyp verwendet wird; seine Verarbeitungslogik ist für alle Charts gleich.
Das Laden der Konfiguration einrichten
Da wir unseren Extension-API-Server über eine Konfigurationsdatei steuern wollen, haben wir die Konfigurationsstruktur in Go angelegt:
Außerdem haben wir die Logik der Ressourcenregistrierung so angepasst, dass die von uns erzeugten Ressourcen im Scheme mit unterschiedlichen Kind-Werten registriert werden:
Das Ergebnis ist eine Konfiguration, in der Sie alle möglichen Typen übergeben und festlegen können, worauf sie abgebildet werden:
Eine eigene Registry implementieren
Um den Zustand nicht in etcd zu speichern, sondern direkt in Kubernetes-HelmRelease-Ressourcen zu übersetzen (und umgekehrt), haben wir Konvertierungsfunktionen von Application nach HelmRelease und von HelmRelease nach Application geschrieben:
Wir haben Logik implementiert, die Ressourcen nach Chart-Name, sourceRef und Präfix im HelmRelease-Namen filtert:
Auf dieser Logik aufbauend haben wir dann die Methoden Get(), Delete(), List() und Create() implementiert.
Das vollständige Beispiel finden Sie hier:
Am Ende jeder Methode setzen wir den korrekten Kind und geben ein unstructured.Unstructured{}-Objekt zurück, damit Kubernetes das Objekt korrekt serialisiert. Andernfalls würde es die Objekte immer mit kind: Application serialisieren, was wir nicht wollen.
Was haben wir erreicht?
In Cozystack stehen nun alle unsere Typen aus der ConfigMap unverändert in Kubernetes zur Verfügung:
kubectl api-resources | grep cozystack
buckets                   apps.cozystack.io/v1alpha1      true        Bucket
clickhouses               apps.cozystack.io/v1alpha1      true        ClickHouse
etcds                     apps.cozystack.io/v1alpha1      true        Etcd
ferretdb                  apps.cozystack.io/v1alpha1      true        FerretDB
httpcaches                apps.cozystack.io/v1alpha1      true        HTTPCache
ingresses                 apps.cozystack.io/v1alpha1      true        Ingress
kafkas                    apps.cozystack.io/v1alpha1      true        Kafka
kuberneteses              apps.cozystack.io/v1alpha1      true        Kubernetes
monitorings               apps.cozystack.io/v1alpha1      true        Monitoring
mysqls                    apps.cozystack.io/v1alpha1      true        MySQL
natses                    apps.cozystack.io/v1alpha1      true        NATS
postgreses                apps.cozystack.io/v1alpha1      true        Postgres
rabbitmqs                 apps.cozystack.io/v1alpha1      true        RabbitMQ
redises                   apps.cozystack.io/v1alpha1      true        Redis
seaweedfses               apps.cozystack.io/v1alpha1      true        SeaweedFS
tcpbalancers              apps.cozystack.io/v1alpha1      true        TCPBalancer
tenants                   apps.cozystack.io/v1alpha1      true        Tenant
virtualmachines           apps.cozystack.io/v1alpha1      true        VirtualMachine
vmdisks                   apps.cozystack.io/v1alpha1      true        VMDisk
vminstances               apps.cozystack.io/v1alpha1      true        VMInstance
vpns                      apps.cozystack.io/v1alpha1      true        VPN
Wir können mit ihnen genauso arbeiten wie mit regulären Kubernetes-Ressourcen.
S3-Buckets auflisten:
kubectl get buckets.apps.cozystack.io -n tenant-kvaps
Beispielausgabe:
NAME         READY   AGE    VERSION
foo          True    22h    0.1.0
testaasd     True    27h    0.1.0
Kubernetes-Cluster auflisten:
kubectl get kuberneteses.apps.cozystack.io -n tenant-kvaps
Beispielausgabe:
NAME     READY   AGE    VERSION
abc      False   19h    0.14.0
asdte    True    22h    0.13.0
Festplatten virtueller Maschinen auflisten:
kubectl get vmdisks.apps.cozystack.io -n tenant-kvaps
Beispielausgabe:
NAME               READY   AGE    VERSION
docker             True    21d    0.1.0
test               True    18d    0.1.0
win2k25-iso        True    21d    0.1.0
win2k25-system     True    21d    0.1.0
Instanzen virtueller Maschinen auflisten:
kubectl get vminstances.apps.cozystack.io -n tenant-kvaps
Beispielausgabe:
NAME        READY   AGE    VERSION
docker      True    21d    0.1.0
test        True    18d    0.1.0
win2k25     True    20d    0.1.0
Wir können jede dieser Ressourcen anlegen, ändern und löschen. Jede Interaktion damit wird in HelmRelease-Ressourcen übersetzt, wobei die Ressourcenstruktur und das Namenspräfix angewendet werden.
Alle zugehörigen Helm-Releases anzeigen:
kubectl get helmreleases -n tenant-kvaps -l cozystack.io/ui
Beispielausgabe:
NAME                     AGE    READY
bucket-foo               22h    True
bucket-testaasd          27h    True
kubernetes-abc           19h    False
kubernetes-asdte         22h    True
redis-test               18d    True
redis-yttt               12d    True
vm-disk-docker           21d    True
vm-disk-test             18d    True
vm-disk-win2k25-iso      21d    True
vm-disk-win2k25-system   21d    True
vm-instance-docker       21d    True
vm-instance-test         18d    True
vm-instance-win2k25      20d    True
Nächste Schritte
Mit unserer API wollen wir hier nicht stehen bleiben. Für die Zukunft planen wir neue Funktionen:
- Validierung auf Basis einer OpenAPI-Spezifikation, die direkt aus den Helm-Charts generiert wird.
- Einen Controller, der Release Notes aus ausgerollten Releases einsammelt und Benutzern die Zugangsdaten für bestimmte Services anzeigt.
- Einen Umbau unseres Dashboards, damit es direkt mit der neuen API arbeitet.
Fazit
Mit dem API Aggregation Layer konnten wir unser Problem schnell und effizient lösen: Er bietet einen flexiblen Mechanismus, um die Kubernetes-API um dynamisch registrierte Ressourcen zu erweitern und diese zur Laufzeit zu konvertieren. Im Ergebnis ist unsere Plattform dadurch noch flexibler und erweiterbarer geworden, ohne dass wir für jede neue Ressource Code schreiben müssen.
Sie können die API selbst in der Open-Source-PaaS-Plattform Cozystack ausprobieren, ab Version v0.18.
Von Andrei Kvapil am 12. Dezember 2024.
Exportiert von Medium am 5. Oktober 2026.