Geht es darum, virtuelle Maschinen mit KubeVirt in Kubernetes zu betreiben, stellen Engineers als Erstes die Frage: „Wie hoch ist der Overhead?“ Schauen wir uns das im Detail an, aufgeteilt in drei Kernbereiche: Compute, Storage und Netzwerk.
Compute-Overhead. Spoiler: Es gibt keinen
Um zu verstehen, warum es praktisch keinen CPU-Overhead gibt, müssen wir uns ansehen, wie der Linux-Kernel mit Containern umgeht.
Im Kern gibt es sogenannte Namespaces, mit denen sich Prozesse mit eigenem Netzwerk, eigenem Mount-Bereich, eigenen PIDs und so weiter ausführen lassen.
Entscheidend ist: Jeder einzelne Prozess unter Linux muss in irgendeinem Namespace leben. Dem Kernel ist es egal, ob das der Host-Namespace oder ein isolierter ist; er behandelt beide exakt gleich.
Bekanntlich ist ein Container nichts anderes als ein Prozess, eingehüllt in isolierte Kernel-Namespaces und cgroups (die für Ressourcenlimits zuständig sind). Diese cgroups sind keine Besonderheit der Containerisierung; auch das ganz normale systemd nutzt sie. Das klassische libvirt verwaltet die Ressourcenlimits virtueller Maschinen ebenfalls über cgroups.
Und was ist eine virtuelle Maschine aus Sicht des Systems? Schlicht ein QEMU-Prozess mit zusätzlichen Rechten und Zugriff auf /dev/kvm. Wenn eine VM nur ein Prozess ist, warum steckt man sie dann nicht einfach in einen Container? Genau das ist die Grundidee von KubeVirt. Für den Kernel macht es keinen Unterschied, ob QEMU im Host-Namespace läuft oder in einem eigenen, von Kubernetes verwalteten. Bei der CPU gibt es schlicht keine Leistungseinbuße.
Ein paar Worte zu libvirt
Einen kleinen Overhead gibt es, weil KubeVirt einen separaten libvirt-Daemon für die VM-Einstellungen startet. Ehrlich gesagt ist er vernachlässigbar.
Die Architekturentscheidung ist hier ziemlich … hm … überraschend: Normalerweise läuft pro Host eine einzige libvirt-Instanz, die mehrere VMs auf diesem Host verwaltet. Das Problem: Friert sie ein, verlieren Sie die Kontrolle über alles auf diesem Server. KubeVirt geht einen anderen Weg und startet für jede VM einen eigenen libvirtd-Daemon. Der Preis für diese Isolation sind etwas zusätzliche Ressourcen für den Daemon, der neben dem VM-Prozess läuft. Viel ist das aber nicht; libvirtd dient im Wesentlichen als Shim für grundlegende Aufgaben wie das Starten und Stoppen von VMs, Snapshots, das Hotplugging von Disks oder das Anstoßen von Live-Migrationen.
Storage: Alles hängt davon ab, wie man es macht
QEMU bietet mehrere Wege, virtuelle Volumes an eine VM anzubinden.
Klassische Optionen sind:
- Eine Datei (raw oder qcow2) in einem Dateisystem anlegen und an QEMU übergeben.
- Ein vorhandenes Block-Device verwenden und QEMU zuweisen.
In beiden Fällen ist der Kernel als Vermittler beteiligt — das Dateisystem oder Block-Device muss auf dem Host existieren.
Direkte Anbindung: QEMU kann eigenständig auf Storage zugreifen und Volumes direkt aus dem Userspace anbinden, am Kernel vorbei. Unterstützt werden verschiedene Treiber, darunter Ceph, iSCSI, NBD und weitere. Vitastor funktioniert zum Beispiel so — QEMU baut eine direkte Verbindung auf.
Die Philosophie von KubeVirt
Das wichtigste Ziel von KubeVirt ist, so Kubernetes-nativ wie möglich zu sein. Das Team hat dafür sogar eine Art „Rasiermesser“-Regel: „Ist ein Feature sowohl für VMs als auch für Container nützlich, gehört es in Kubernetes, nicht in KubeVirt.“ Manchmal bremst diese Philosophie die Entwicklung VM-spezifischer Features.
Beim Storage stützt sich KubeVirt stark auf native Kubernetes-Primitive — allen voran CSI-Treiber. K8s erwartet, dass jedes Volume entweder ein Filesystem oder ein BlockDevice ist — beides wird unterstützt und verursacht keinen Overhead.
Allerdings lässt sich QEMU bisher nicht direkt mit dem Storage verbinden, weil Kubernetes dafür schlicht die passenden Abstraktionen fehlen.
In der Praxis setzen große Unternehmen ohnehin meist auf geteilte Lösungen wie NetApp NFS oder Block-Devices über iSCSI. Interessanterweise unterstützt KubeVirt direktes iSCSI.
Fazit: Im Vergleich zu Standard-Setups gibt es keinen Overhead. Sicher, die direkten Treiber von QEMU wären schneller, aber weniger flexibel. Generische Lösungen unterstützen nur Standardoptionen, herstellerspezifische Implementierungen dagegen müssten für jeden einzelnen Anbieter eigens entwickelt und gepflegt werden.
Netzwerk: Hier wird es knifflig
Jeder Container (oder Prozess, wenn wir vom Linux-Kernel sprechen) kann einen eigenen Netzwerk-Stack und eigene Interfaces haben. Um den Netzwerk-Namespace des Containers mit dem des Hosts zu verbinden, nutzen wir veth-Interfaces — eine Art virtuelles „Patchkabel“, dessen eines Ende im Host und das andere im Container steckt. Das ist die Basis jedes Container-Setups.
Außen übernimmt ein CNI-Plugin die Logik: Es hängt das Interface etwa an eine Linux-Bridge (wie Flannel) oder bindet ein eBPF-Programm daran (wie Cilium). Für das System ist eine VM einfach ein weiterer Container.
Was passiert unter der Haube?
In 95 % der Fälle bekommt die VM ein TAP-Interface, das für den Host wie jedes andere Netzwerk-Interface aussieht. Die eigentliche Frage ist, wie man dieses TAP-Interface mit dem inneren veth-Interface verbindet.
Übliche Wege dafür:
Bridge: Der Kernel legt eine Linux-Bridge an und hängt sowohl das innere veth-Ende als auch das TAP-Interface der VM daran.
Masquerade: Eine iptables-Regel leitet den Traffic zwischen den Interfaces weiter.
Beide Methoden kosten etwas Latenz — jeder zusätzliche Hop in der Kette verbraucht CPU-Zyklen für die Paketverarbeitung.
Wie man den Overhead umgeht
Der Effekt ist nicht dramatisch, lässt sich aber trotzdem vermeiden:
- mit macvtap-cni, das sich direkt an das physische Interface des Hosts hängt.
- mit SR-IOV — Virtualisierung auf Hardware-Ebene.
Wie beim Storage lässt sich QEMU so einrichten, dass es im Userspace direkt mit einem SDN kommuniziert und den Kernel komplett umgeht. KubeVirt unterstützt das noch nicht vollständig, weil es an die CNI-Spezifikation gebunden ist.
Manche CNI-Treiber (wie Kube-OVN) haben eigene, parallele APIs, um das Netzwerk aus dem Kernel auszulagern. Außerdem bietet KubeVirt eine sehr leistungsfähige Plugin-Schnittstelle, falls Sie eine eigene Art der Netzwerkanbindung bauen müssen.
Abschließende Gedanken
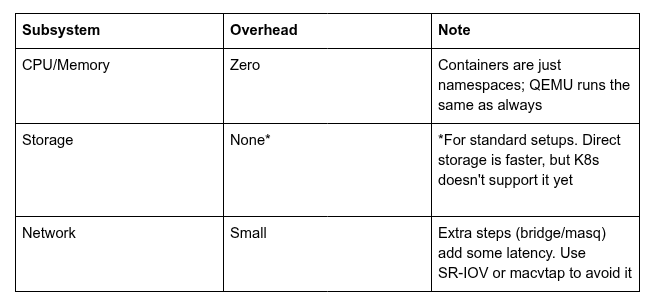
KubeVirt ist ein guter Kompromiss zwischen Performance und Flexibilität. Wer das letzte Quäntchen Leistung braucht und komplexe Setups nicht scheut, kann noch weiter gehen. Wer aber etwas Standardisiertes, Herstellerneutrales und leicht Supportbares sucht, ist mit KubeVirt bestens bedient.
P.S. Dieser Artikel beruht auf einer Diskussion in der Fach-Community. Ich danke den Teilnehmenden für ihre wertvollen Beiträge.
Werden Sie Teil der Community
- Telegram-Gruppe
- Slack-Gruppe (Einladung unter https://slack.kubernetes.io)
Von Andrei Kvapil am 20. Januar 2026.
Exportiert von Medium am 5. Oktober 2026.