Viele Jahre lang habe ich davon geträumt, eine eigene Cloud-Plattform zu bauen. Nach mehreren Anläufen in verschiedenen Unternehmen habe ich schließlich mein eigenes Projekt gestartet: Cozystack. In diesem Artikel teile ich unsere Erfahrungen und unseren Ansatz für den Aufbau einer modernen Infrastrukturplattform rund um Kubernetes und seine API. Ich gehe auf den „Plattformansatz“ ein: was eine Plattform ist, wie sie funktioniert, für wen sie gedacht ist und wie man eine an den Start bringt. Außerdem vergleiche ich verschiedene Architekturen, erkläre, warum wir uns für K8s entschieden haben, und zeige, wie wir darauf eine produktionsreife Lösung aufgebaut haben.
Nach dieser Artikelserie werden Sie in der Lage sein, Ihre eigene robuste und moderne Lösung zu bauen, ob Sie meine Muster übernehmen, sie als Referenz nutzen oder komplett verwerfen. So oder so ist es einfacher, als eine Plattform von Grund auf zu bauen; und es ist immer aufschlussreich, in das Innenleben anderer Projekte zu schauen und ihre Logik zu verstehen. Cozystack wächst und verändert sich ständig, daher beschreibe ich hier den Stand vom Herbst 2025. Von einigen unserer frühen Architekturentscheidungen haben wir uns bereits verabschiedet (gerade bauen wir die „Engine“ der Plattform grundlegend um; dazu gibt es ein Update, sobald 1.0 erschienen ist).
Bevor wir beginnen, möchte ich Nick Volynkin ganz herzlich danken. Er hat viel Arbeit investiert, um aus meinem ursprünglichen Vortrag diesen umfassenden Artikel zu machen, und ist damit faktisch zum Co-Autor geworden.
Was ist Cozystack
Cozystack ist eine umfassende Open-Source-Plattform zum Aufbau von Bare-Metal-Clouds, mit der sich Managed Kubernetes, Database-as-a-Service (DBaaS), Application-as-a-Service (AaaS) und virtuelle Maschinen auf Basis von KubeVirt schnell bereitstellen lassen. Kafka, FerretDB, PostgreSQL, Cilium, Grafana, Victoria Metrics und weitere Services lassen sich damit per Mausklick ausrollen. Auch GPU-Workloads in virtuellen Maschinen und K8s-Clustern werden unterstützt. Cozystack ist ein CNCF-Sandbox-Projekt und steht unter der Lizenz Apache 2.0.
Kunden und Managed Applications
Stellen Sie sich vor, Sie erbringen Dienstleistungen für mehrere Kunden, von denen jeder seine eigenen Anwendungslandschaften betreiben muss. Diese Anwendungen hängen von verschiedensten Komponenten ab, etwa Datenbanken, Queues und Caches, und Ihre Kunden erwarten, dass Sie diese als Managed Services bereitstellen. Daraus ergibt sich eine recht lange Liste an Komponenten, die Sie unterstützen müssen: PostgreSQL, Kafka, Redis, ClickHouse, S3-kompatible Buckets und mehr. Darüber hinaus benötigen Ihre Kunden Managed-Kubernetes-Cluster und virtuelle Maschinen (VMs), um ihre eigenen Anwendungen auszurollen.
Aus diesen Anforderungen heraus machen Sie sich daran, eine umfassende schlüsselfertige Lösung zu bauen: eine vorintegrierte Suite von Managed Services als Plattform aus einem Guss.
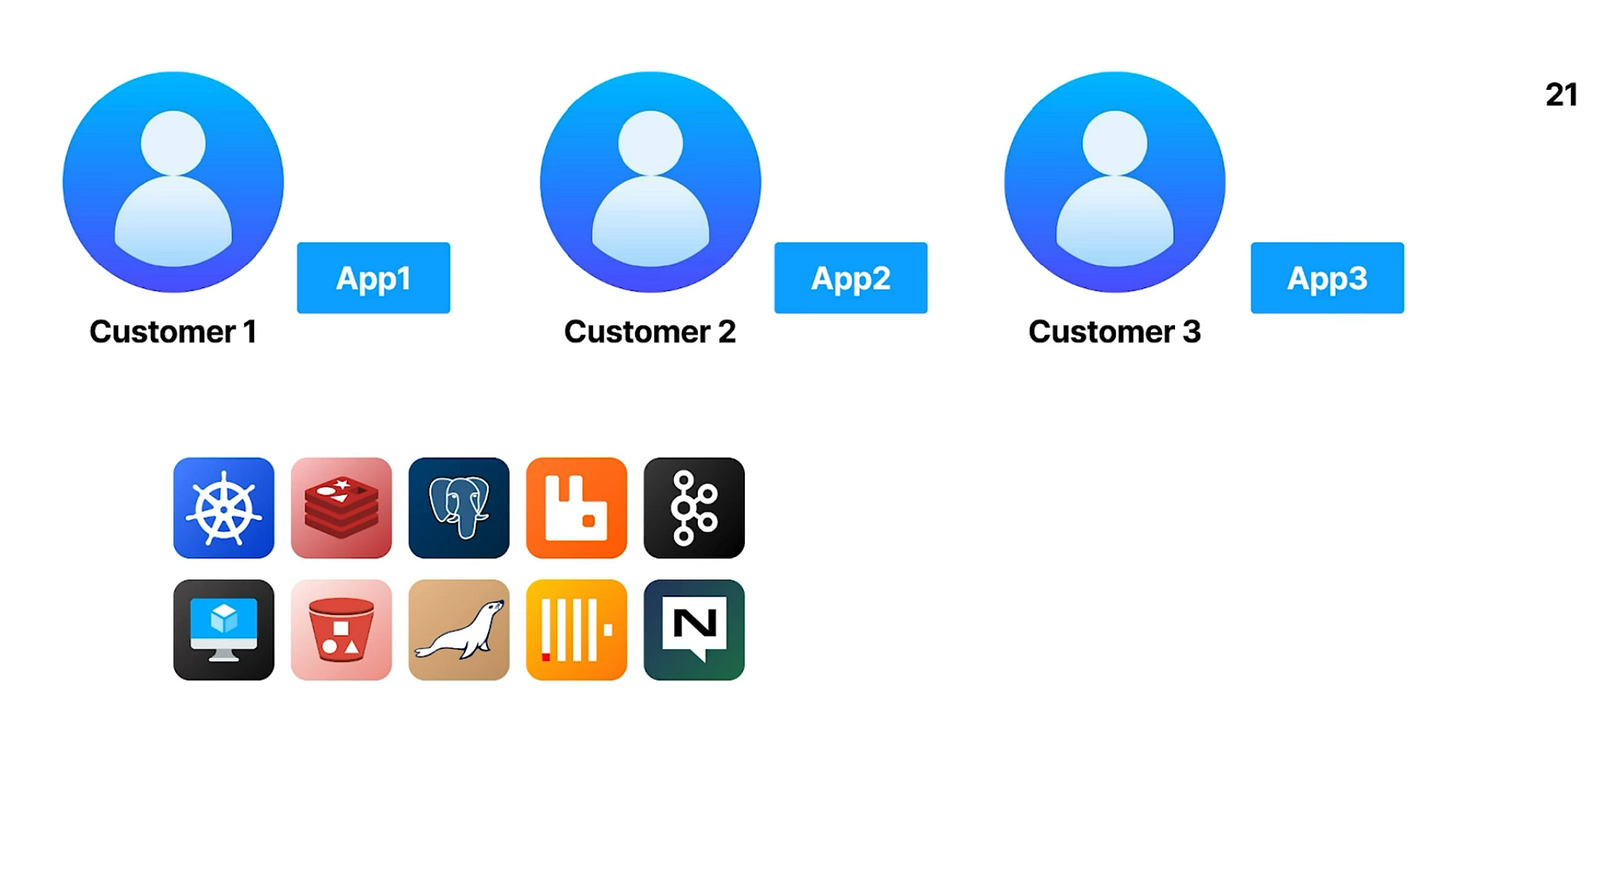
Die Herausforderung Technologie-Stack
Bevor Sie mit dem Aufbau von Plattform-Services beginnen können, müssen Sie zuerst die zugrunde liegende Infrastruktur schaffen. Es gibt Grundlagen, um die Sie sich kümmern müssen: Storage, Server-Provisionierung, Networking, Virtualisierung und Monitoring. Da diese Services zustandsbehaftet sind, brauchen Sie eine robuste automatisierte Provisionierung und verlässliche Failover-Mechanismen. In der Praxis bauen Sie zuerst den Infrastruktur-Stack, dann den Plattform-Stack, und erst dann können Sie sich dem Anwendungs-Stack widmen, den Ihre Kunden brauchen.
Das Ergebnis ist ein komplexer „Turm“ aus Technologien:
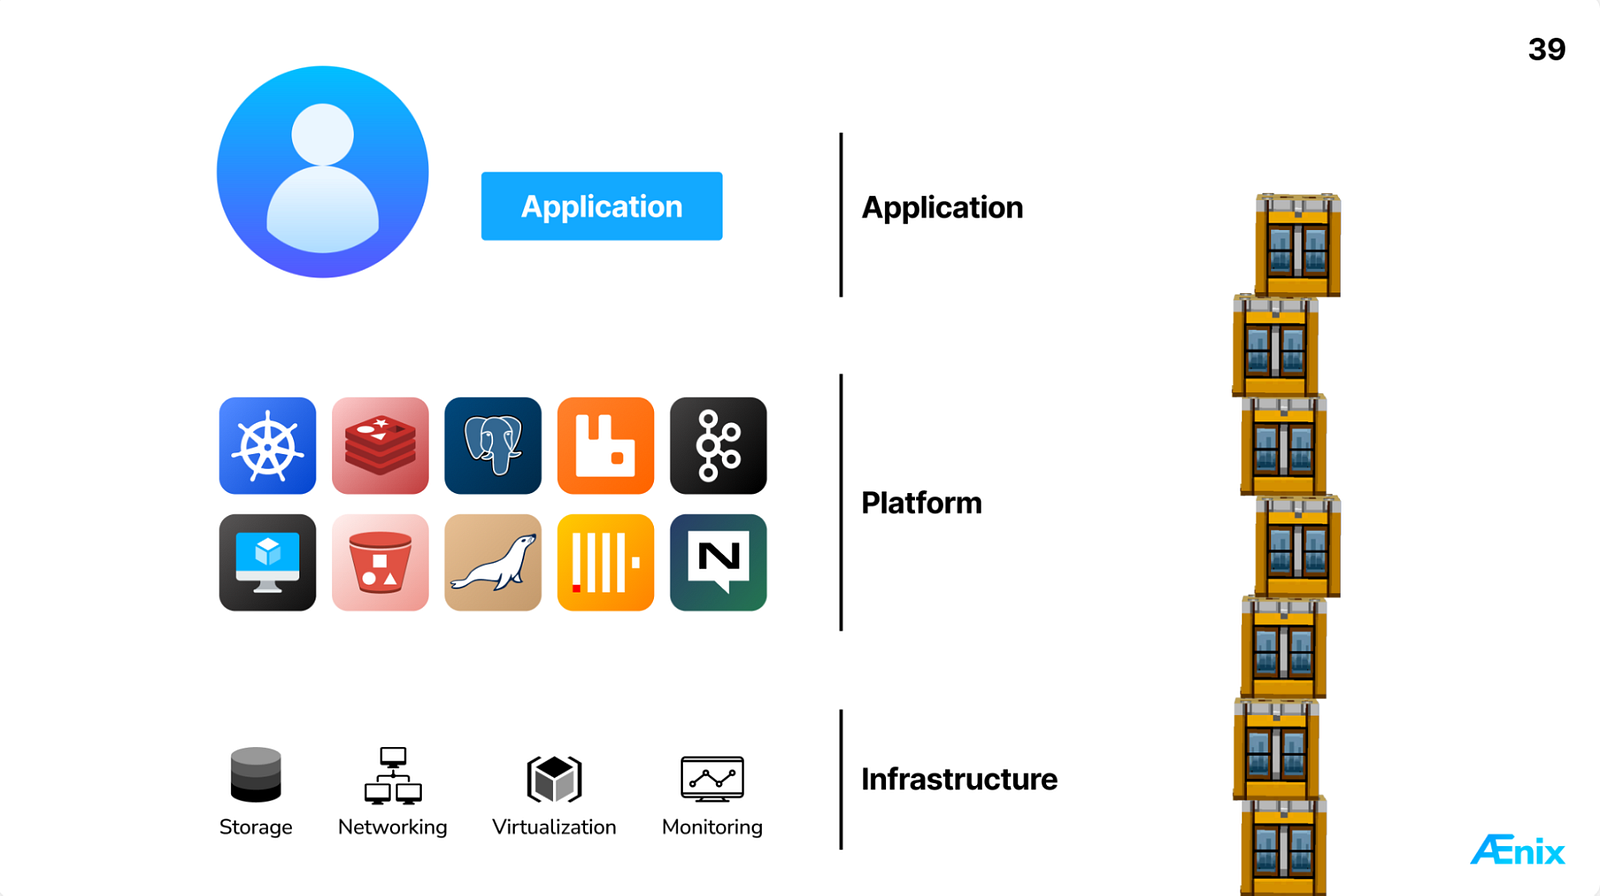
Hinzu kommt: Wer eigene Infrastruktur und eine eigene Plattform aufbaut und betreibt, braucht tiefes Know-how in einer Vielzahl von Technologien. Sie sind für jede Komponente verantwortlich, die Sie ausliefern, während jede Schicht ihre eigenen Bugs, ihre eigene Komplexität und unerwartete Updates mitbringt. Der Betrieb Ihrer Lösung erfordert also erheblichen Aufwand; andernfalls gerät dieser Turm ins Wanken und stürzt ein.
Wie lässt sich das vermeiden? Sie können bestimmte Schichten des Stacks nach dem „as-a-Service“-Modell auslagern. Die folgende Grafik zeigt verschiedene Möglichkeiten, die Verantwortung entlang des Plattform-Stacks aufzuteilen.
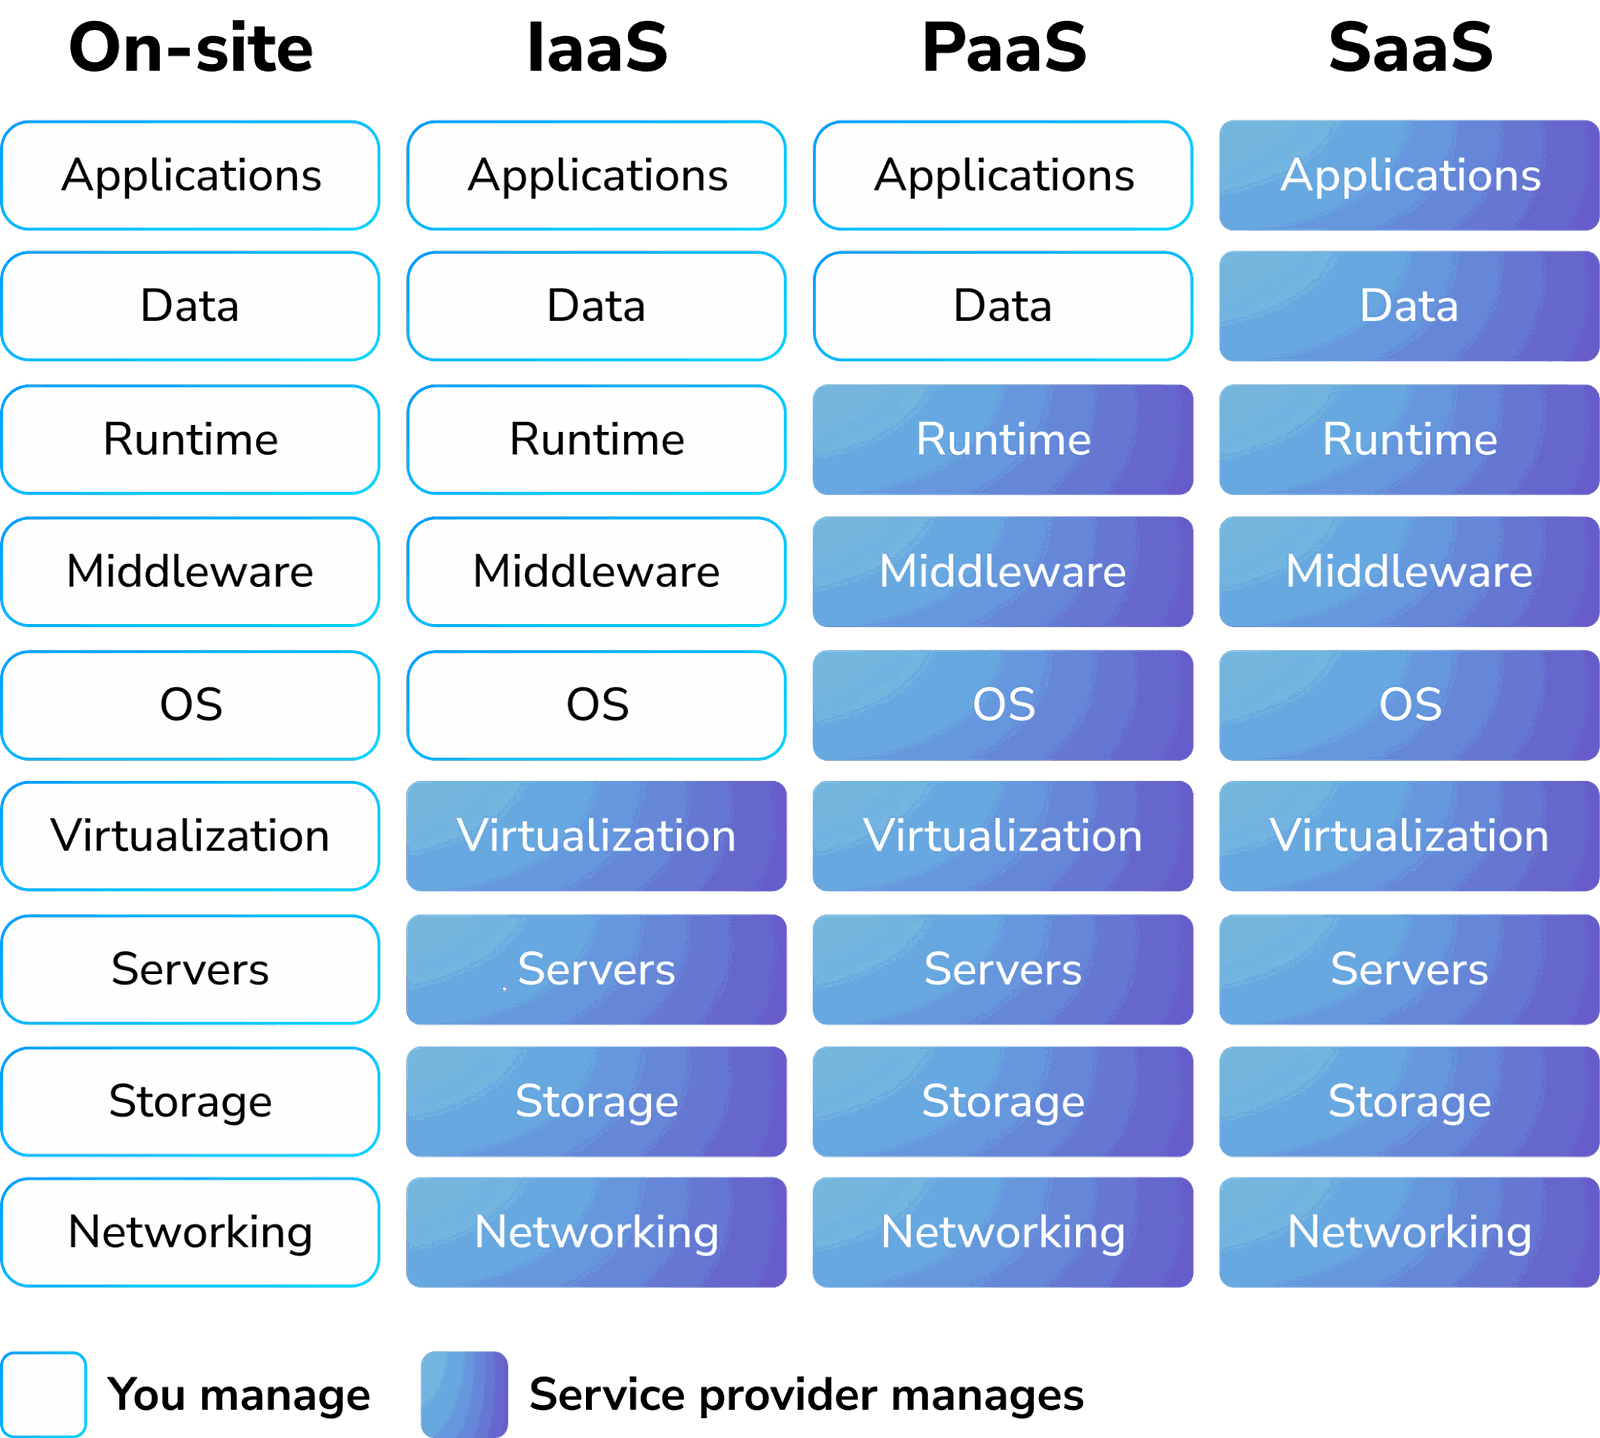
- On-Site: der anspruchsvollste Ansatz, bei dem Sie die Verantwortung für den gesamten Stack tragen, von der Infrastruktur bis zu den Services. Das ist unser Ausgangspunkt.
- Infrastructure as a Service (IaaS): Der Anbieter verwaltet Networking, Storage, Server und Virtualisierung. Sie betreiben die virtuellen Maschinen, müssen sich aber weiterhin um das Betriebssystem und die Infrastruktur-Services kümmern.
- Platform as a Service (PaaS): Die Verwaltung der Infrastruktur wird wegabstrahiert, sodass Sie sich ausschließlich auf Anwendungen und deren Daten konzentrieren können.
- Software as a Service (SaaS): Sie müssen keine Anwendungen verwalten, sondern erhalten ein fertiges Produkt (z. B. Google Drive oder Slack). Das ist häufig das eigentliche Ziel Ihrer Kunden.
Die meisten Kunden suchen die dritte Option: eine Plattform, auf der sie ihre Anwendungen ausrollen können, während Sie als Anbieter die darunterliegende Komplexität und den Support im Griff haben.
Optionen für den Plattform-Stack
Nun müssen Sie sich um den Infrastruktur- und den Plattform-Stack kümmern. Sehen wir uns an, welche Optionen es für den Aufbau einer Plattform gibt und welche Kompromisse sie mit sich bringen.
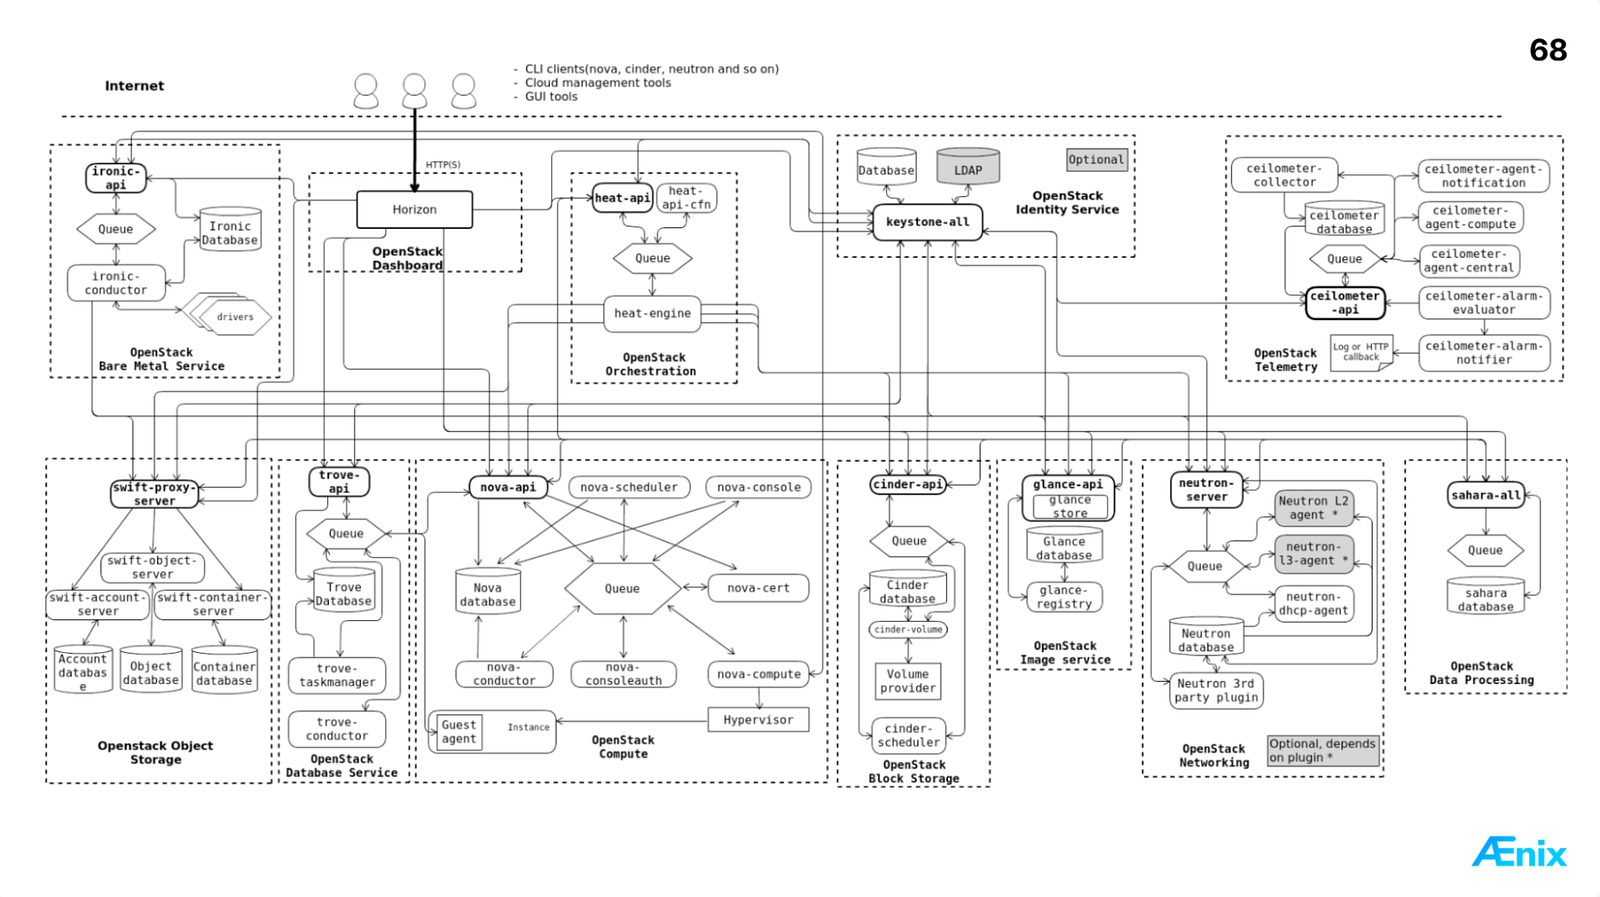
OpenStack ist oft der erste Kandidat. Sobald Sie es jedoch einführen wollen, stellen Sie fest, dass es aufgrund seiner komplexen Architektur und einer Unmenge asynchroner APIs alles andere als leicht zu betreiben ist. Sie brauchen ein eigenes Entwicklungsteam, um OpenStack und all seine Komponenten zu pflegen:
Docker ist eine weitere verbreitete Alternative. Es bietet eine riesige Bibliothek an Container-Images, die sich mit einem einfachen docker run <image> leicht starten lassen. Für einzelne Instanzen funktioniert das, doch Docker fehlen die Werkzeuge für Hochverfügbarkeit und Multi-Node-Anwendungen, also genau die Eigenschaften, die Kunden von einer Managed-Plattform erwarten.
Cloud Foundry war vor dem Aufstieg von Kubernetes sehr populär. Heute sehe ich jedoch kaum noch Unternehmen, die es einsetzen. Entsprechend gibt es wenige Engineers mit Erfahrung darin, und kaum jemand ist bereit, sich diese Erfahrung anzueignen. Wegen des schrumpfenden Fachkräftepools ist es eine riskante Wahl.
Und schließlich gibt es Kubernetes, das für die meisten Plattformaufgaben eine breite Palette an Funktionen mitbringt. Kubernetes ist zum De-facto-Standard für den Betrieb von Server-Workloads geworden. Es setzt moderne Muster wie den Reconciliation Loop um. Über Projekte wie KubeVirt profitieren sogar virtuelle Maschinen vom Lifecycle-Management im Kubernetes-Stil, einschließlich Live-Migration bei Node-Ausfällen. Und dank seiner sauberen RESTful-API eignet es sich ideal als Basis für eigene Plattform-Services.
Als Sahnehäubchen gibt es für Kubernetes viele einsatzbereite Operatoren. Ein Operator ist ein in Kubernetes laufender Controller, der den Lebenszyklus einer Anwendung verwaltet. Operatoren übernehmen die imperative Arbeit, die jede Aufgabe erfordert: Deployment, Upgrade, Replikation, Wiederherstellung aus dem Backup und mehr. Und das auf die bestmögliche Weise, denn in ihnen steckt die gesammelte Erfahrung der Entwickler der jeweiligen Software. Benutzer müssen sich nicht mehr mit dem Low-Level-Betrieb herumschlagen, sondern arbeiten mit einer deklarativen High-Level-API. Sie beschreiben den gewünschten Zustand der Anwendung, und der Operator sorgt dafür, dass der tatsächliche Zustand diesem entspricht.
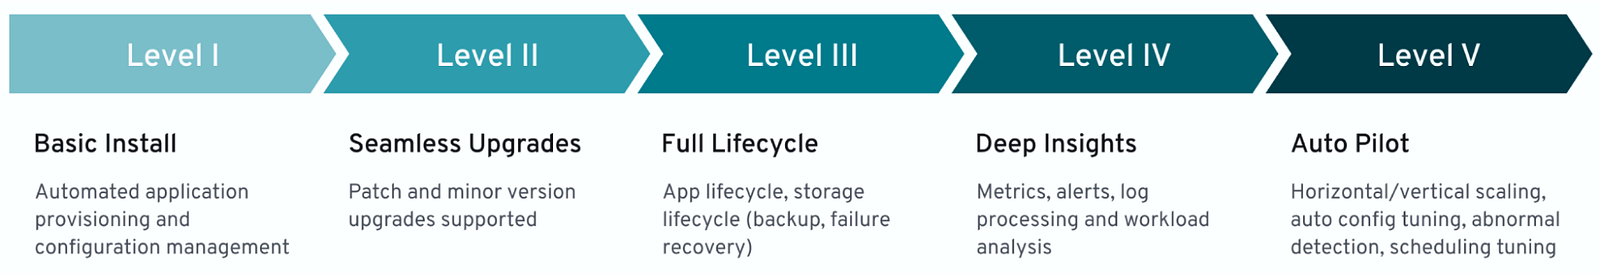
Hier einige der Operatoren, die wir in Cozystack einsetzen. Jeder davon erreicht mindestens Level 3:
- https://github.com/kubevirt/kubevirt
- https://github.com/cloudnative-pg/cloudnative-pg
- https://github.com/spotahome/redis-operator
- https://github.com/mariadb-operator/mariadb-operator
- https://github.com/Altinity/clickhouse-operator
- https://github.com/rabbitmq/cluster-operator
Kubernetes lässt sich über Custom Resource Definitions (CRDs) erweitern, sodass Operatoren den kompletten Lebenszyklus einer Anwendung verwalten können. In der Liste oben ist KubeVirt, der Operator für virtuelle Maschinen, ein Paradebeispiel für diese Erweiterbarkeit in der Praxis.
Kurz gesagt: Kubernetes ist die erste Wahl für einen Plattform-Stack, und wir haben es als Fundament für Cozystack gewählt.
Herausforderungen und Lösungen beim Verwalten von Kubernetes-Operatoren
Der nächste Schritt ist Self-Service für Kunden: Benutzer sollen Infrastruktur bereitstellen können, ohne dass der Plattform-Administrator eingreifen muss. Dafür brauchen sie eine einheitliche API.
Hier stoßen wir auf ein klassisches Kubernetes-Paradoxon: K8s bietet hervorragende Möglichkeiten, ist technologisch aber auch sehr heterogen. Jeder Anbieter baut seinen Operator anders, und das Ergebnis ist eine chaotische Landschaft inkonsistenter APIs.
Werfen Sie einen Blick auf die folgenden Spezifikationen für Kafka, Postgres, MariaDB und ClickHouse. Jeder Operator macht seine Arbeit gut, doch ihre API-Schemas haben keinerlei gemeinsame Struktur:
Kafka
apiVersion: kafka.strimzi.io/v1beta2
kind: Kafka
metadata:
  name: kafka-example
spec:
  kafka:
    version: 3.9.0
    replicas: 3
    config:
      offsets.topic.replication.factor: 3
      transaction.state.log.replication.factor: 3
      transaction.state.log.min.isr: 2
      default.replication.factor: 3
      min.insync.replicas: 2
      inter.broker.protocol.version: "3.9"
  zookeeper: { }
  entityOperator: { }
Cloud-Native PostgreSQL
apiVersion: postgresql.cnpg.io/v1
kind: Cluster
metadata:
  name: postgres-example
spec:
  instances: 3
  postgresql:
    parameters:
      max_worker_processes: "60"
    pg_hba:
      - host all all all md5
  primaryUpdateStrategy: unsupervised
  storage:
    size: 1Gi
MariaDB
apiVersion: k8s.mariadb.com/v1alpha1
kind: Database
metadata:
  name: mariadb-example
spec:
  mariaDbRef:
    name: mariadb
  characterSet: utf8
  collate: utf8_general_ci
  cleanupPolicy: Delete
  requeueInterval: 30s
  retryInterval: 5s
ClickHouse
apiVersion: clickhouse.altinity.com/v1
kind: ClickHouseInstallation
metadata:
  name: clickhouse-example
spec:
  configuration:
    clusters:
      - name: "shard1-repl2"
        layout:
          shardsCount: 1
          replicasCount: 2
Daraus ergibt sich eine typische Plattform-Herausforderung: Operator-APIs sind uneinheitlich, haben keine eigene Oberfläche und lassen sich schwer erweitern. Schlimmer noch: Wer Benutzern die rohen Custom Resources der Operatoren in die Hand gibt, schafft unnötige Risiken und Komplexität.
Als Plattformanbieter wollen Sie Benutzern ermöglichen, Managed Services über Custom Resources anzufordern, die von Operatoren verarbeitet werden. Gleichzeitig müssen Sie festlegen können, welche Felder sie ändern dürfen. Dürften Benutzer etwa Basis-Images austauschen oder Ressourcenlimits ändern, könnte das die Plattform gefährden. Das wollen Sie auf keinen Fall.
Sehen wir uns an, welche Lösungen für dieses Problem infrage kommen.
- Eine Option ist, mit Kyverno oder OPA eine Policy zu erstellen. Das löst das Problem allerdings nur teilweise: Sie können zwar Änderungen an bestimmten Feldern einschränken, doch feingranulare Kontrolle wird schnell komplex und fehleranfällig.
- Alternativ könnten Sie API-Objekte auf höherer Ebene und einen eigenen Operator zu deren Verwaltung entwickeln. Dafür bräuchten Sie aber CRDs für jeden Backend-Ressourcentyp, Codegenerierung und Reconciliation-Logik zur Synchronisierung der Zustände. Der Aufwand geht dann gegen „unendlich“; es ist schlicht zu viel Arbeit.
- Sie können auch Helm-Charts verwenden. Anders als Operatoren sind Charts leichter zu erstellen, weil sie deklarative Kubernetes-Objekte bündeln; Sie müssen also keinen Code schreiben, um die Anwendung auszurollen. So können Sie Benutzern einfache Charts mit einer sauberen, einheitlichen Schnittstelle anbieten.
Helm fehlt jedoch ein umfassendes Lifecycle-Management. Es kann zwar Ressourcen in einen Kubernetes-Cluster ausrollen, aber keine Selbstheilung garantieren, etwa die Wiederherstellung eines PostgreSQL-Replikats nach einem Node-Ausfall.
Wie Sie sehen, ist keine der Optionen für sich allein eine vollständige Lösung; im Backend kommen wir um Operatoren nicht herum.
Hybrider Ansatz für das Anwendungsmanagement
Cozystack verfolgt einen hybriden Ansatz: Helm dient als API für die Benutzer, während Operatoren im Backend den kompletten Lebenszyklus übernehmen. Benutzer geben Parameter an und rollen Helm-Charts in Kubernetes aus. Die Charts erzeugen dann Ressourcen verschiedener Kinds (kind:), die von Operatoren verwaltet werden. Als benutzerseitige API stellt values.yaml nur die Parameter bereit, die ein Tenant ändern darf.
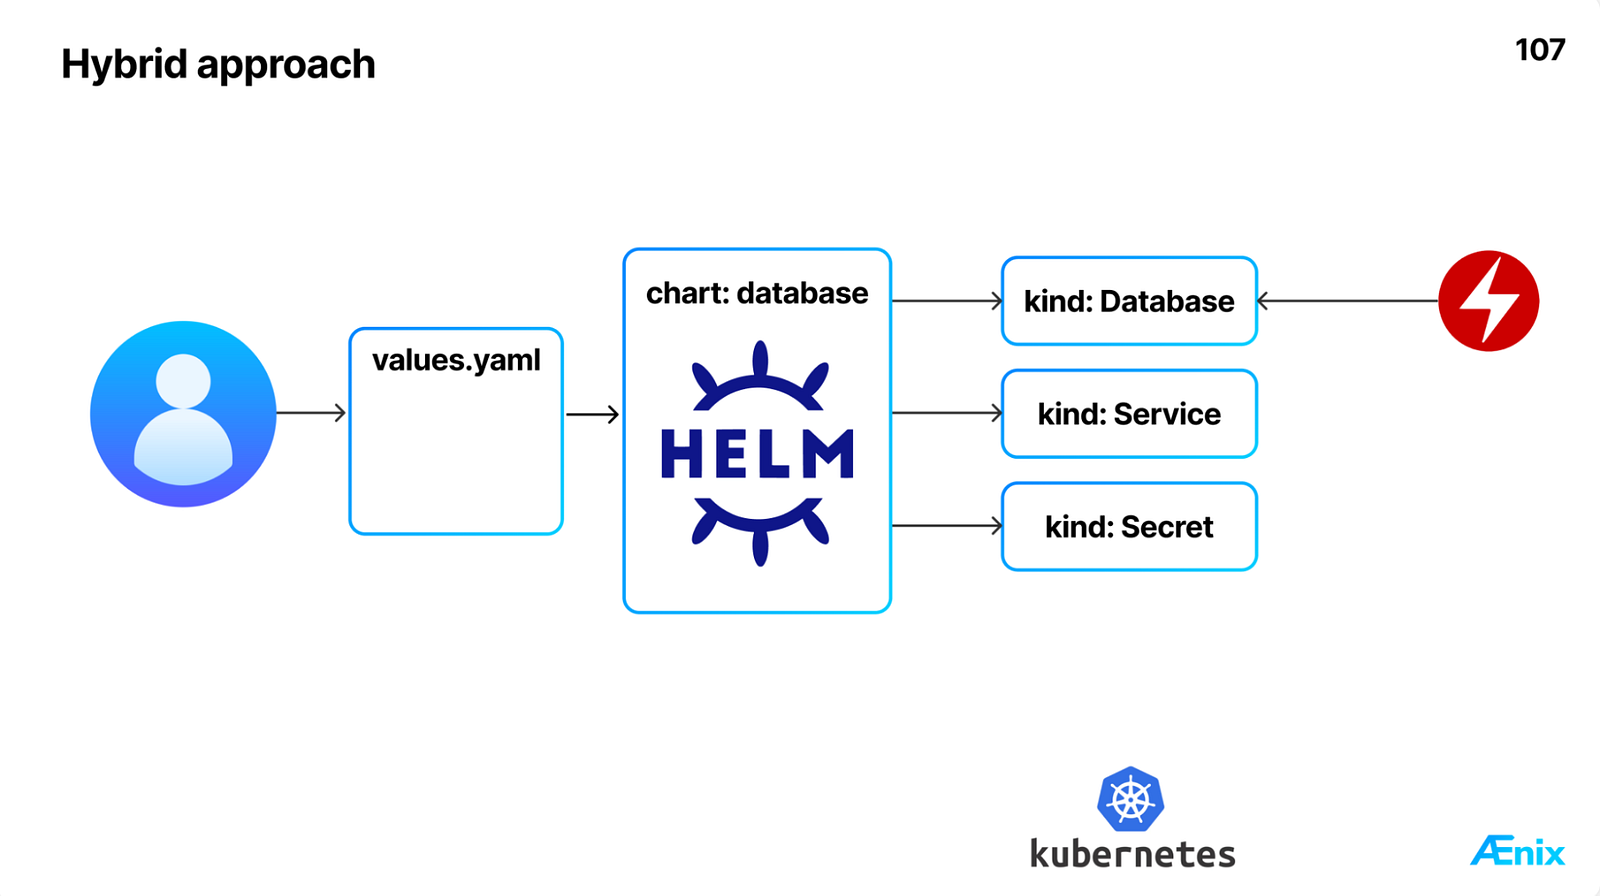
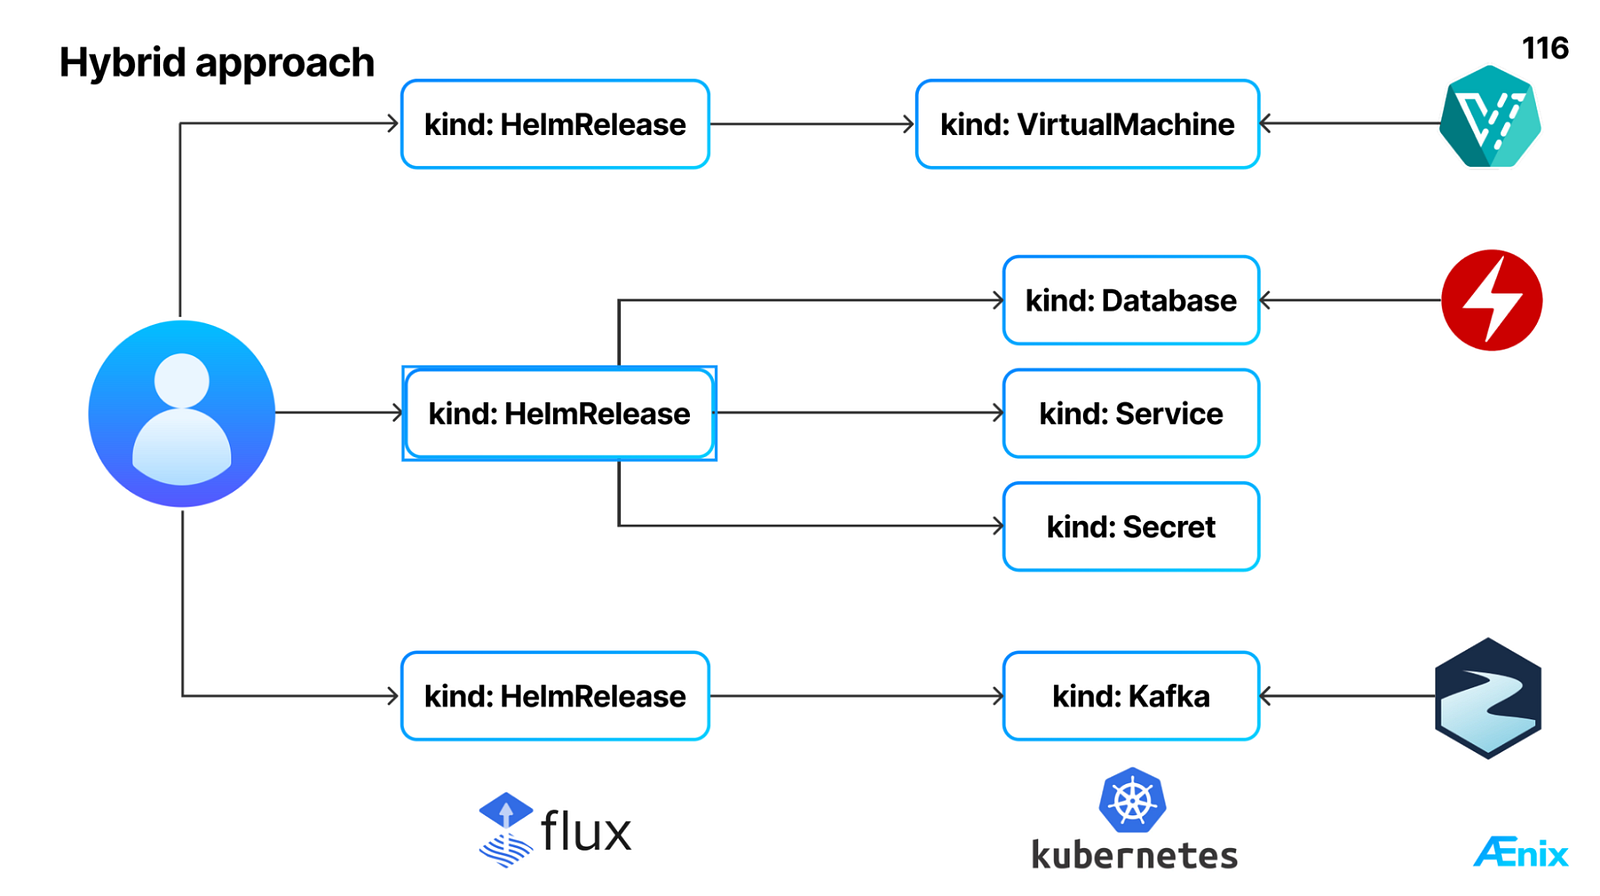
Den benutzerseitigen Teil dieses Ablaufs übernimmt Flux CD, ein Helm-Operator für Kubernetes mit der Custom Resource HelmRelease. Benutzer beschreiben ihre Deployments in einer HelmRelease, und Flux CD führt das Reconciling durch und rollt die Anwendung aus.
Um beispielsweise eine virtuelle Maschine bereitzustellen, legt ein Benutzer eine Ressource mit kind: HelmRelease an. Flux CD wendet daraufhin das Chart an, das wiederum eine kind: VirtualMachine erzeugt, die vom KubeVirt-Operator verwaltet wird.
Bei Kafka läuft es genauso: Sie beginnen mit einer kind: HelmRelease und erhalten am Ende eine Instanz vom Typ kind: Kafka, die vom Kafka-Operator verwaltet wird. So entstehen eine einheitliche API und ein schlanker Prozess für das Deployment ganz unterschiedlicher Anwendungen:
Sehen wir uns zwei Beispiele an, eines für Redis und eines für MySQL. Dabei fallen einige zentrale Gemeinsamkeiten und Unterschiede auf:
- apiVersion und kind: HelmRelease zeigen, dass es sich um Custom Resources von Flux CD handelt.
- Jede verweist im Feld spec.chart.spec.chart auf ein anderes Chart.
- Beide referenzieren in spec.chart.spec.sourceRef dasselbe Quell-Repository: das Standard-Anwendungs-Repository von Cozystack, das über HTTP bereitgestellt wird.
- Beide enthalten einen Block spec.values. Dieser Block stammt direkt aus der Datei values.yaml des jeweiligen Charts.
Redis
apiVersion: helm.toolkit.fluxcd.io/v2
kind: HelmRelease
metadata:
  name: redis-some
spec:
  chart:
    spec:
      chart: redis
      reconcileStrategy: Revision
      sourceRef:
        kind: HelmRepository
        name: cozystack-apps
        namespace: cozy-public
  values:
    authEnabled: true
    external: false
    replicas: 2
    resourcesPreset: nano
    size: 1Gi
    storageClass: ""
MySQL
apiVersion: helm.toolkit.fluxcd.io/v2
kind: HelmRelease
metadata:
  name: mysql-some
spec:
  chart:
    spec:
      chart: mysql
      reconcileStrategy: Revision
      sourceRef:
        kind: HelmRepository
        name: cozystack-apps
        namespace: cozy-public
  values:
    external: false
    replicas: 2
    resourcesPreset: nano
    size: 10Gi
    storageClass: ""
Benutzeroberfläche und API
Mit unserem hybriden Design haben wir nun eine einheitliche API für das Deployment von Anwendungen, deren Operator-APIs ursprünglich sehr unterschiedlich waren. Nachdem wir gesehen haben, wie das unter der Haube funktioniert, schauen wir uns an, wie Benutzer damit arbeiten. Dank dieser einheitlichen API kann die Plattform all diese Anwendungen in einem Dashboard darstellen, jeweils mit Namen, Metadaten und einem Icon für jedes Helm-Chart. Anfangs nutzte Cozystack dafür Kubeapps, doch wir steigen gerade auf ein neues Frontend um (mehr dazu in kommenden Beiträgen).
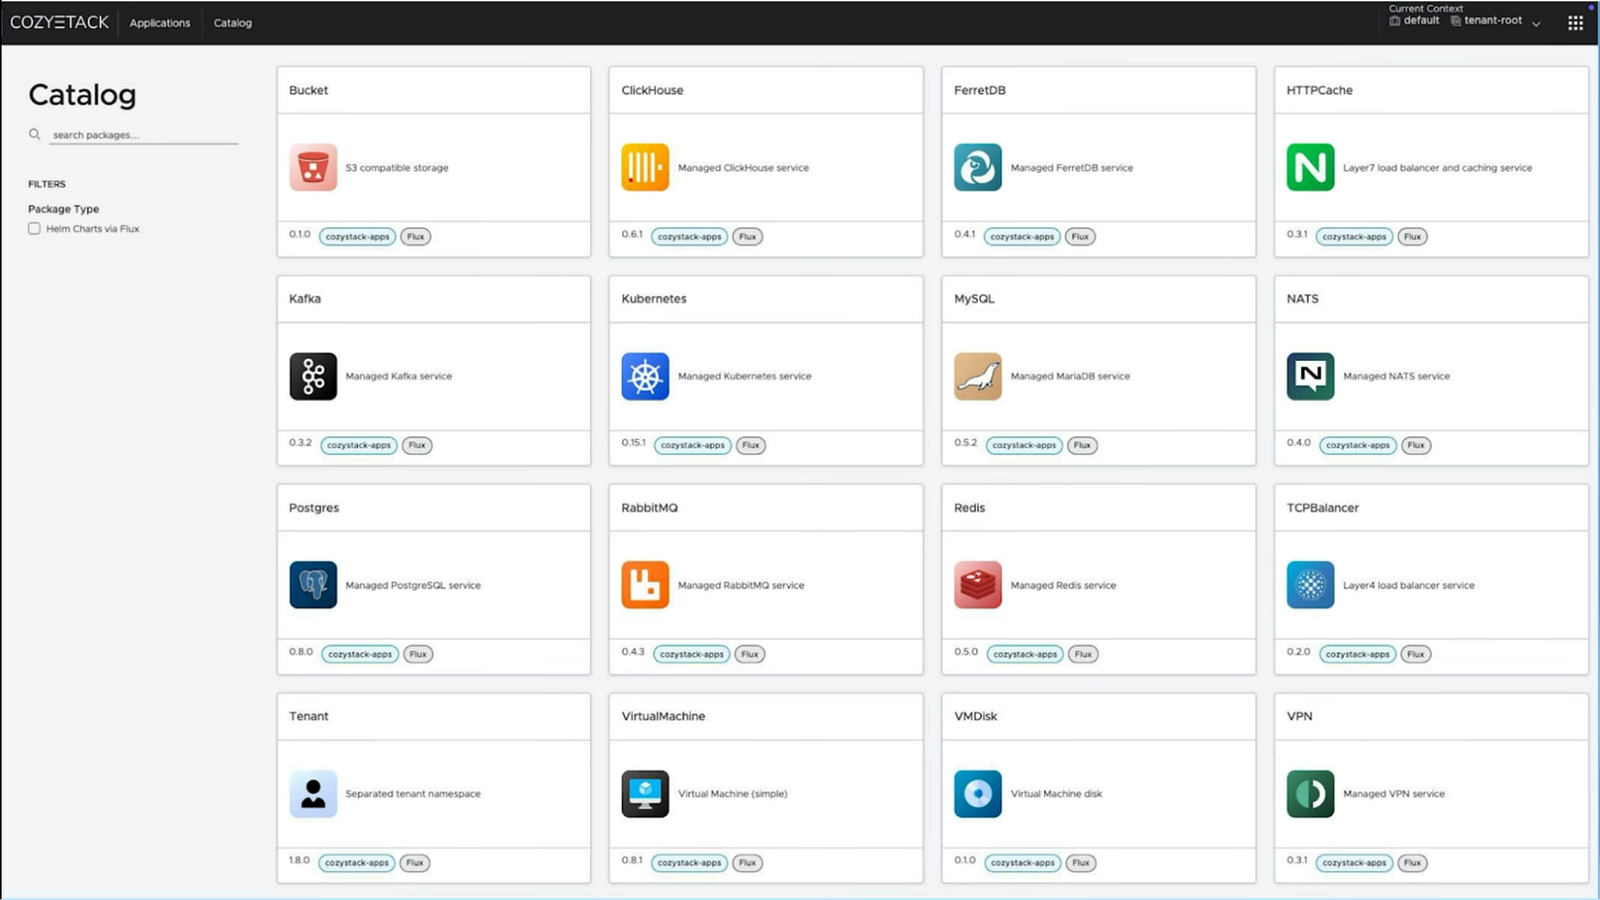
Wenn ein Benutzer eine Anwendung ausrollen möchte, legt er eine einzige YAML-Datei mit Parametern an. Das sieht so aus:
# virtual machine
running: true
systemDisk:
  image: ubuntu
  storage: 5Gi
  storageClass: replicated
resources:
  cpu: 1
  sockets: 1
  memory: 1024M
# ...
Das Dashboard kann diese Parameter sogar in einem visuellen Editor darstellen, da sie durch ein OpenAPI-Schema definiert sind.
Fassen wir die wichtigsten Punkte des hybriden Systems, das wir für Cozystack gebaut haben, kurz zusammen:
- Anwendungen definieren wir über Helm-Charts.
- Den gesamten Lebenszyklus der Anwendungen verwalten Kubernetes-Operatoren.
- Ein einheitliches Dashboard sorgt für ein konsistentes Erscheinungsbild aller Anwendungen.
Dieses System passte hervorragend zu unserem typischen Anwendungsfall: einem Internet Service Provider, der ein Backend für seine Dienste aufbaut. Solche Anbieter betreiben in der Regel eine Website, ein Abrechnungssystem und eine Reihe weiterer Anwendungen. Entscheidend ist dabei, dass die Anbieter die einzigen Benutzer ihrer eigenen Plattform sind; es handelt sich also um ein klassisches Single-Tenant-Setup.
Zugriff für Endbenutzer
In frühen Versionen von Cozystack war der Zugriff Sache der Administratoren. Mit unserem Wachstum zeichnete sich jedoch eine zentrale Rückmeldung ab: Unsere Kunden wollten ihren Endbenutzern direkten Zugriff auf die Plattform geben. Daraus ergaben sich zwei neue Herausforderungen:
- Rollenbasierter Zugriff für viele Benutzer. Wie ermöglichen wir Benutzern, Anwendungen auf derselben Plattform auszurollen, ohne ihnen Administratorrechte zu geben?
- Eine klare, benutzerfreundliche Darstellung der Ressourcen. Endbenutzer erwarten reguläre Kubernetes-Kinds wie
PostgresoderRedisund keine ausgefallenen HelmReleases.
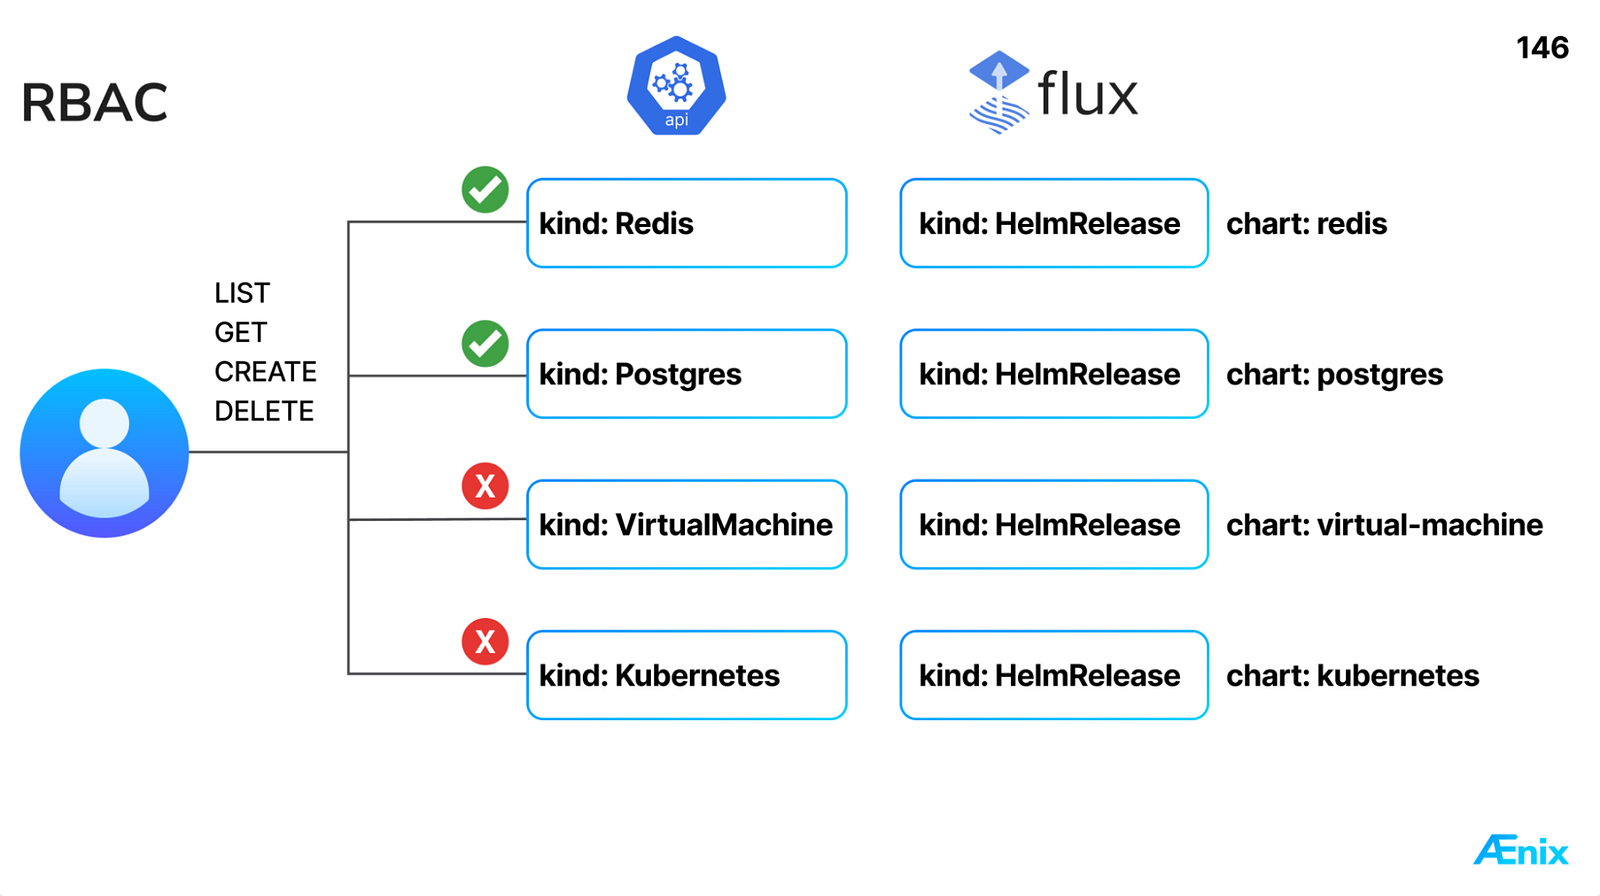
Bei vielen Benutzern kommt es nicht infrage, allen Zugriff auf den Management-Cluster zu geben. Obwohl unterschiedliche Charts verwendet werden, haben alle denselben kind: HelmRelease. RBAC-Policies können daher nicht zwischen einer HelmRelease für eine VirtualMachine und einer für eine Postgres-Instanz unterscheiden. Service-Provider brauchen aber häufig genau diese Granularität bei der Isolation.
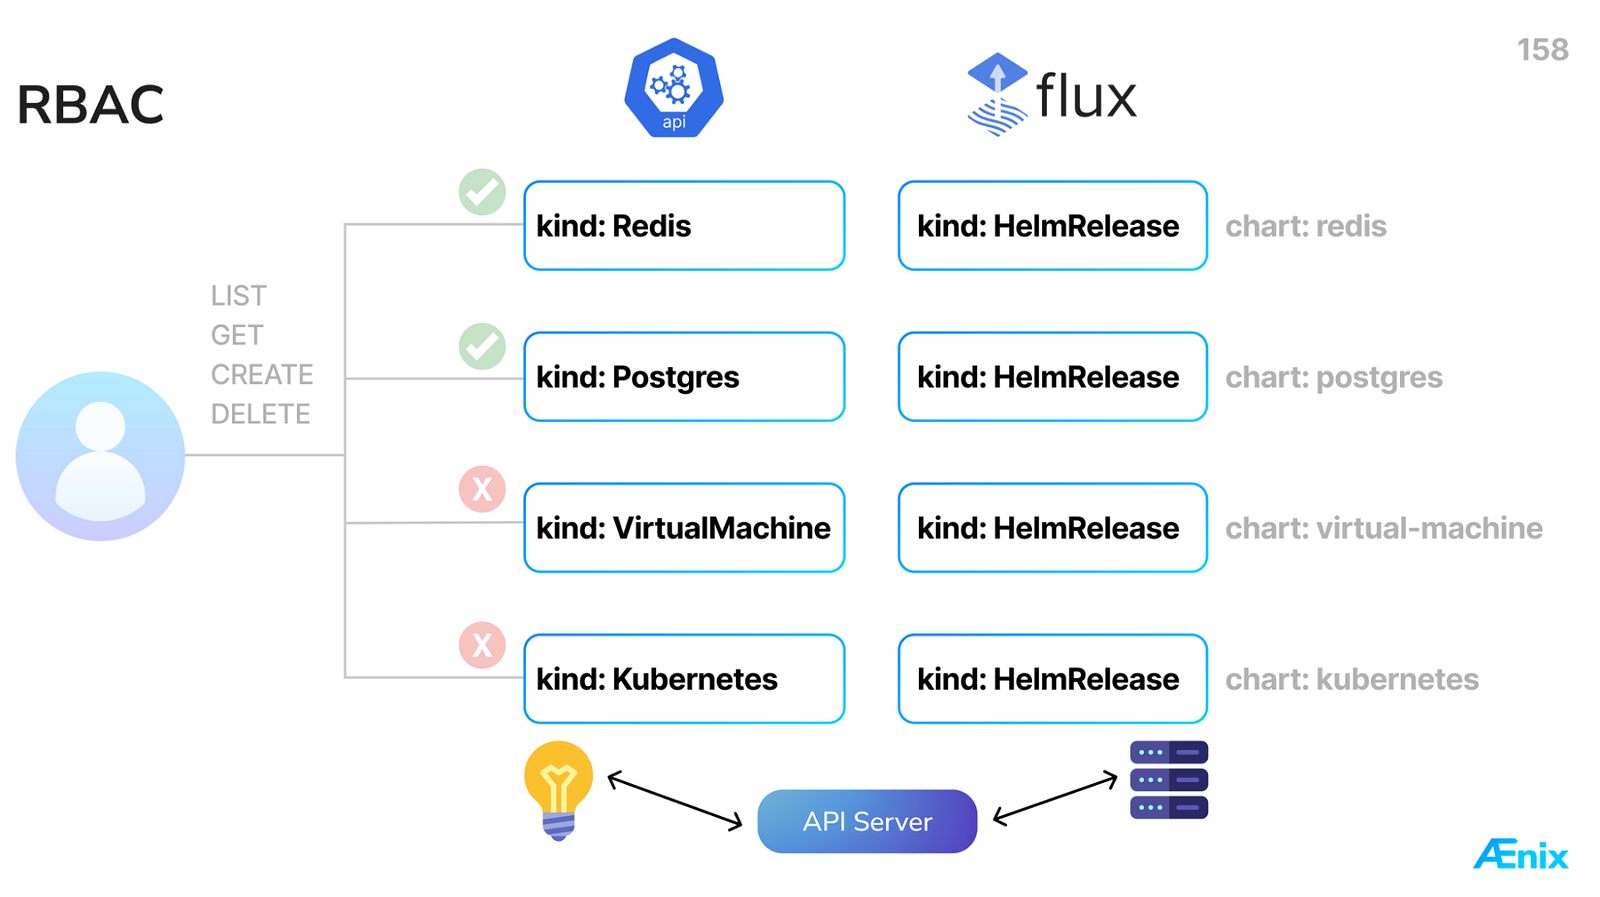
Unsere Lösung bestand darin, API-Objekte auf höherer Ebene einzuführen, die die Anwendungs-Kinds der zugrunde liegenden Ressourcen abbilden (Redis, Postgres, VirtualMachine, Kubernetes usw.). Damit lässt sich eine granulare RBAC-Regel formulieren, die z. B. Zugriff auf Redis und Postgres gewährt, den Zugriff auf VirtualMachine und Kubernetes aber verweigert.
Zustandssynchronisierung
Als Nächstes müssen wir den Zustand zwischen unseren API-Objekten auf höherer Ebene und den nachgelagerten HelmReleases synchronisieren, die sie ausrollen. Sehen wir uns die beiden Ansätze an, die wir geprüft haben, und warum wir uns für einen davon entschieden haben.
Das übliche Kubernetes-Muster ist, einen Controller oder Operator zu bauen, der den gewünschten Zustand in Ihren Custom Resources speichert und daraus HelmReleases erzeugt. Bei diesem Modell sind wir jedoch auf zwei Probleme gestoßen:
- Es führt eine zustandsbehaftete Komponente ein, was die Komplexität erhöht und eine potenzielle Fehlerquelle schafft. Wir wollten das System unbedingt einfach halten.
- Der Datenfluss läuft nur in eine Richtung: Änderungen an einer HelmRelease werden nicht in die API-Objekte auf höherer Ebene zurückgespiegelt.
Unsere Alternative war ein zustandsloser API-Server, der die vorhandenen HelmReleases im Cluster als Datenspeicher nutzt und die Ressourcen auf höherer Ebene zur Laufzeit dynamisch erzeugt. Diese Ressourcen existieren nur zum Zeitpunkt der Anfrage, doch Benutzer können mit ihnen arbeiten wie mit jeder anderen regulären Kubernetes-Ressource. Dieser Ansatz behebt die Schwächen des vorherigen:
- Da er zustandslos ist, bleibt das System einfach.
- Er unterstützt die Synchronisierung in beide Richtungen und spiegelt Änderungen zwischen den Ressourcen und den HelmReleases.
Einen eigenen API-Server zu bauen ist ein erhebliches Unterfangen. Wie man die Kubernetes-API erweitert und welche konkrete Lösung wir umgesetzt haben, beschreiben wir ausführlich im nächsten Artikel. Zunächst sehen wir uns unsere Lösung aber aus Sicht der Benutzer an und wie sie damit arbeiten.
So sieht unsere API in der Praxis aus
Wie fühlt es sich also an, mit unserer neuen API zu arbeiten? Gehen wir das Deployment einer Redis-Instanz durch. Ein Benutzer legt eine Ressource an, wie sie im ersten Beispiel gezeigt ist. Sie wird automatisch in die HelmRelease übersetzt, die Sie im zweiten Manifest sehen. Beachten Sie das gemeinsame Muster:
kind: Rediswird aufspec.chart.spec.*abgebildet, das den Chart-Namen und die Repository-Referenz enthält.- Aus dem Service-Namen in
metadata.name: example wirdmetadata.name:redis-example. - Die Anwendungsversion
appVersionwird zur Chart-Version inspec.chart.spec.version. - Die Werte aus der Spec werden in
spec.valuesübernommen.
Beispiel: Redis
Die vom Benutzer angelegte Ressource:
apiVersion: apps.cozystack.io/v1alpha1
appVersion: 0.6.0
kind: Redis
metadata:
  name: example
spec:
  authEnabled: true
  external: false
  replicas: 2
  resourcesPreset: nano
  size: 1Gi
  storageClass: ""
Die resultierende HelmRelease:
apiVersion: helm.toolkit.fluxcd.io/v2
kind: HelmRelease
metadata:
  name: redis-example
spec:
  chart:
    spec:
      chart: redis
      reconcileStrategy: Revision
      sourceRef:
        kind: HelmRepository
        name: cozystack-apps
        namespace: cozy-public
      version: 0.6.0
  values:
    authEnabled: true
    external: false
    replicas: 2
    resourcesPreset: nano
    size: 1Gi
    storageClass: ""
Dasselbe Muster verwenden wir für alles, auch für Tenant-Kubernetes-Cluster. Wir stellen Helm-Charts bereit, die sämtliche Manifeste für den Betrieb von Kubernetes-in-Kubernetes bündeln. Benutzer arbeiten einfach mit High-Level-Ressourcen vom Typ kind: Kubernetes. Diese erzeugen wiederum HelmReleases von Flux CD, die die übrigen Charts ganz ohne externe Controller ausrollen.
Beispiel: virtuelle Maschine
Hier derselbe Ablauf, diesmal für eine VirtualMachine.
Die vom Benutzer angelegte Ressource:
apiVersion: apps.cozystack.io/v1alpha1
appVersion: 0.7.0
kind: VirtualMachine
metadata:
  name: example
spec:
  instanceProfile: ubuntu
  instanceType: u1.xlarge
  running: true
  sshKeys:
    - ssh-rsa AAAAAA...
  systemDisk:
    image: ubuntu
    storage: 110Gi
    storageClass: replicated
Die resultierende HelmRelease:
apiVersion: helm.toolkit.fluxcd.io/v2
kind: HelmRelease
metadata:
  name: virtual-machine-example
spec:
  chart:
    spec:
      chart: virtual-machine
      reconcileStrategy: Revision
      sourceRef:
        kind: HelmRepository
        name: cozystack-apps
        namespace: cozy-public
      version: 0.7.0
  values:
    instanceProfile: ubuntu
    instanceType: u1.xlarge
    running: true
    sshKeys:
      - ssh-rsa AAAAAA...
    systemDisk:
      image: ubuntu
      storage: 110Gi
      storageClass: replicated
Beispiel: Kubernetes
Ein weiteres Beispiel: ein Tenant-Kubernetes-Cluster.
Die vom Benutzer angelegte Ressource:
apiVersion: apps.cozystack.io/v1alpha1
appVersion: 0.15.2
kind: Kubernetes
metadata:
  name: example
spec:
  host: ""
  nodeGroups:
    md0:
      minReplicas: 0
      maxReplicas: 10
      ephemeralStorage: 20Gi
      instanceType: u1.medium
      role:
        - ingress-nginx
  storageClass: "replicated"
Die resultierende HelmRelease:
apiVersion: helm.toolkit.fluxcd.io/v2
kind: HelmRelease
metadata:
  name: kubernetes-example
spec:
  chart:
    spec:
      chart: kubernetes
      reconcileStrategy: Revision
      sourceRef:
        kind: HelmRepository
        name: cozystack-apps
        namespace: cozy-public
      version: 0.15.2
  values:
    host: ""
    nodeGroups:
      md0:
        minReplicas: 0
        maxReplicas: 10
        ephemeralStorage: 20Gi
        instanceType: u1.medium
        role:
          - ingress-nginx
    storageClass: "replicated"
Fazit
Kehren wir zu der Herausforderung zurück, die wir lösen wollten: der, vor der wir bei Cozystack standen und vor der jeder Service-Provider steht. Unser Ziel war eine Plattform mit einheitlicher API und Oberfläche für das Deployment und die Verwaltung von Anwendungen. Diese Plattform brauchte außerdem ein zuverlässiges Backend für Lifecycle-Operationen, klares Feedback zu laufenden Workloads und Schutzmechanismen über RBAC.
So erfüllt unsere Lösung auf Basis von Kubernetes und Helm diese Ziele:
- Helm-Charts definieren jede Anwendung als Paket, das die Custom Resources und alle Kubernetes-Objekte bündelt, die die Anwendung braucht. Nach dem Deployment verwalten Kubernetes-Operatoren den Lebenszyklus der Anwendung.
- Custom Resources auf höherer Ebene bieten Benutzern für jede Anwendung eine konsistente und sichere Schnittstelle. Diese Ressourcen bringen Transparenz, Leitplanken und ein einheitliches Schema gleich mit.
- Einheitliche Oberfläche und API. Unser Dashboard stellt alle Anwendungen konsistent dar und zeigt für jedes Deployment Metadaten, Icons und den aktuellen Workload-Status. Genau dieselben Ressourcen sind über
kubectlund die Kubernetes-REST-API zugänglich, sodass Benutzer und Automatisierung eine konsistente, Kubernetes-native Schnittstelle erhalten. - Im nächsten Artikel zeigen wir, wie wir einen eigenen API-Server gebaut haben, um den Zustand zwischen Helm-Charts und den HelmRelease-Deployments von Flux CD zu synchronisieren. Außerdem geht es darum, die Kubernetes-API über den API Aggregation Layer zu erweitern. Bleiben Sie dran!
Feedback und Pull Requests sind willkommen: https://github.com/cozystack/cozypkg
Werden Sie Teil der Cozystack-Community
Siehe auch
- How Cozystack Was Born: The Philosophy Behind Its Architecture
- Wie wir in Cozystack einen dynamischen Kubernetes-API-Server für den API Aggregation Layer gebaut haben
- DIY: Create Your Own Cloud with Kubernetes (3-part series)
- Cozystack joins the CNCF Sandbox
- Die Evolution von Virtualisierungsplattformen: der Aufstieg der Managed Services und der Vorsprung lokaler Anbieter gegenüber Hyperscalern
- Cozystack became a Certified Kubernetes Platform
- Cozypkg: Wie wir die lokale Entwicklung mit Helm und Flux vereinfacht haben
Von Andrei Kvapil am 9. Februar 2026.
Exportiert von Medium am 5. Oktober 2026.