Am 1. Januar 2024 starb Niklaus Wirth – der Mann, der uns Pascal, Modula-2 und Oberon geschenkt hat, den Turing Award bekam und sein ganzes Leben lang einen hartnäckigen Krieg gegen aufgeblähte Software führte. Weniger bekannt ist, dass er sich, schon weit über siebzig, hinsetzte und einen eigenen Prozessor entwarf: klein und einfach, damit er Studierenden einen ganzen Computer auf einmal zeigen konnte, von den Logikgattern bis zu den Fenstern auf dem Bildschirm.
Im September 2026 habe ich diesen Prozessor genommen und versucht, ihn überall zum Laufen zu bringen, wo ich nur hinkam. Zuerst direkt in einem Browser-Tab – und zwar nicht als Emulator, sondern als genau die Schaltung, die Wirth gezeichnet hat. Dann in QEMU, als ganz gewöhnliche virtuelle Maschine. Dann in Kubernetes, wo normalerweise eine ganz andere Sorte VM zu Hause ist, nämlich die, auf der Ubuntu und Datenbanken laufen. Und schließlich in Cozystack, unserer Cloud-Plattform, wo sich Wirths Maschine jetzt mit einem einzigen Klick aus dem Katalog installieren lässt, so wie man PostgreSQL installiert. Nebenbei habe ich endlich etwas gemessen, worüber Programmierer seit Jahrzehnten streiten: was die Prüfung von Array-Grenzen tatsächlich kostet. Ich habe außerdem ein kleines Sprachmodell auf Wirths Prozessor laufen lassen. Und, wenn wir schon ehrlich sind: Mit einer unbedachten Bewegung habe ich sämtliche virtuellen Maschinen in einem produktiven Cluster auf Migration geschickt (verletzt wurde niemand, aber es waren ein paar unangenehme Sekunden).
Daraus ist ein sehr langer Artikel geworden, weil in neun Tagen sehr viel passiert ist und ein guter Teil davon meine eigenen Fehler waren, die ich anschließend finden und beheben musste. Ich habe versucht, so zu schreiben, dass auch jemand folgen kann, der noch nie von Oberon gehört hat, und alles, was nur Spezialisten interessiert, unter Spoilern versteckt. Sie können den Text am Stück lesen oder direkt zu dem Teil springen, der Sie interessiert. Zuerst kommt die Geschichte von Oberon selbst, dann, wie mein ursprünglicher Plan zerfiel, dann der Prozessor und die Bounds-Prüfung, dann der Browser und die Laborübungen, dann QEMU, Kubernetes und Cozystack und ganz am Ende das Sprachmodell und wie Sie das alles selbst installieren.
Der gesamte Quellcode, die Notizen und Anleitungen liegen im Repository github.com/tym83/paleocomputing, die Projektseite ist tym83.github.io/paleocomputing. Wer lieber erst selbst Hand anlegt und danach liest, öffnet das Labor: Es muss nichts installiert werden, die Maschine bootet direkt im Browser.
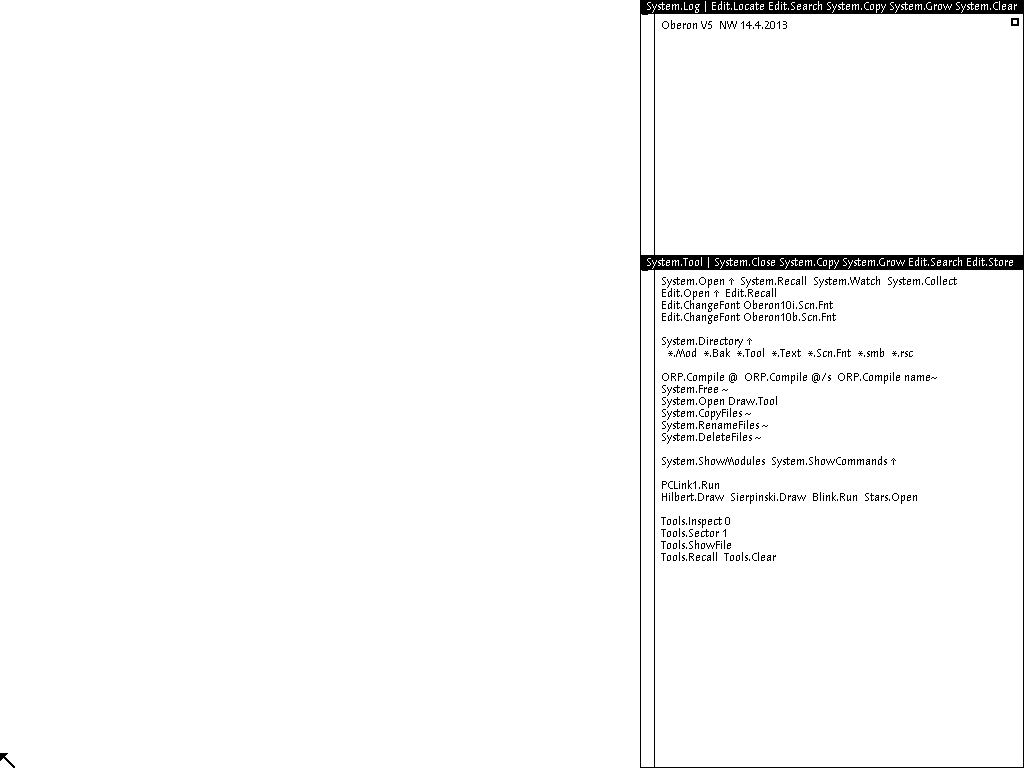
Oberon auf Wirths echter Schaltung. Ich habe dieses Bild fünfhundert Mal gesehen, und fast jedes Mal stimmte es bis auf den letzten Punkt mit der Referenz überein.
Was Oberon ist
Oberon ist zugleich eine Programmiersprache und ein Betriebssystem, entstanden Mitte der 1980er-Jahre an der ETH Zürich, entwickelt von Niklaus Wirth und Jürg Gutknecht. Sie begannen im Herbst 1985, und 1988 lief das System tatsächlich. Nach Wirths eigener Darstellung haben es zwei Leute in den Stunden geschrieben, die neben ihrer eigentlichen Arbeit übrig blieben – was, das müssen Sie zugeben, ziemlich verrückt klingt, wenn man bedenkt, wie viele Menschen heute nötig sind, um irgendein Betriebssystem zu schreiben. Es lief auf der Workstation Ceres, die ebenfalls an der ETH gebaut wurde, und bis etwa Anfang der 2000er-Jahre wurde darauf unterrichtet.
Der Name stammt übrigens von Voyager. Im Januar 1986 schickte die Sonde Bilder von Uranus und seinen Monden zur Erde, und Wirth – der Voyager für ein vorbildliches Ingenieurprojekt hielt, ein Gerät, das weit über seine geplante Lebensdauer hinaus funktionierte – benannte das System nach dem Mond Oberon. Im Buch nennt er Oberon den größten Uranusmond, tatsächlich ist aber Titania größer; auch Wirth hat Tippfehler. Und als Zugabe ist Oberon auch der König der Elfen, was als Namenspate ebenfalls nicht schlecht ist.
Die Leitidee des ganzen Unterfangens steht im Vorwort zum Buch des Projekts: Ein von Grund auf neu gebautes System sollte etwas sein, das man vollständig beschreiben, erklären und verstehen kann – ein einzelner Mensch sollte das Ganze lesen und verstehen können, vom Prozessor bis zur Fensteroberfläche. Nach heutigen Maßstäben klingt das fast wie Fantasy, denn niemand auf der Welt versteht ein modernes Betriebssystem samt Compiler und Prozessor vollständig.
2013 veröffentlichte Wirth eine Neuausgabe des Projekts und zog die Idee darin konsequent bis zum Ende durch. Der Prozessor, auf dem Ceres lief, wurde längst nicht mehr hergestellt, und Wirth entschied: Wenn alles andere im System von ihm stammt und verständlich ist, soll auch der Prozessor von ihm sein. Er entwarf einen einfachen RISC-Prozessor – in den Quellen heißt er RISC5 – und beschrieb ihn in Verilog, der Sprache, mit der man digitale Schaltungen beschreibt. Eine solche Schaltung lässt sich auf ein FPGA flashen, einen programmierbaren Chip, und heraus kommt ein echter, funktionierender Computer. Wirths Exemplar lief auf einem preiswerten Board mit einem Megabyte Speicher bei 25 MHz. Das ist ungefähr hundertmal langsamer als ein einzelner Kern Ihres Smartphones, für Oberon aber mehr als genug, denn der Compiler übersetzt sich, wie Wirth schreibt, in etwa drei Sekunden selbst. Das Buch und die Quellen von System, Compiler und Prozessor sind offen zugänglich, und genau das macht Oberon einzigartig. Noch ein Detail, das für uns wichtig wird: Das System selbst stammt aus den späten 1980er-Jahren, der Prozessor, auf dem wir es betreiben werden, entstand dagegen erst in den 2010er-Jahren.
Was Oberon so ungewöhnlich macht, falls Sie es noch nie gesehen haben
Jeder Text kann ein Befehl sein. Eine Kommandozeile im üblichen Sinn gibt es in Oberon nicht. Steht irgendwo auf dem Bildschirm, in irgendeinem Fenster, etwas der Form Module.Procedure, dann ist das bereits ein Befehl. Sie zeigen mit der Maus darauf, drücken die mittlere Taste, und er wird ausgeführt. Menüs gibt es auch, aber ein Menü ist hier einfach eine Textzeile in der Titelleiste eines Fensters, in der Befehle aufgezählt sind. Sie wollen ein eigenes Menü? Schreiben Sie die gewünschten Befehle in eine Textdatei und öffnen Sie sie. Diese Idee hat später den Editor Acme in Plan 9 stark beeinflusst, und Rob Pike hat das auch selbst gesagt.
Sie brauchen eine Drei-Tasten-Maus. Die linke Taste setzt den Cursor, die mittlere führt aus, die rechte markiert – und dazu gibt es Akkorde, bei denen man eine Taste gedrückt hält und, ohne sie loszulassen, eine zweite drückt. Auf einem Laptop ohne mittlere Taste ersetzen wir sie durch Klicks mit Modifikatortasten; mehr dazu weiter unten.
Es gibt immer genau ein Programm. Das gewohnte Multitasking fehlt. Darunter dreht sich eine einzige Schleife, die Tastatur und Maus abfragt und Befehle einen nach dem anderen aufruft, und solange ein Befehl nicht fertig ist, passiert nichts anderes. Wirth räumt selbst ein, dass das sehr einschränkend klingt, und erklärt ausführlich, warum es für einen Menschen an einem Computer genügt.
Keine Header-Dateien und keine Dependency-Hölle. Jedes Modul beschreibt seine eigene Schnittstelle, und diese Beschreibung trägt so etwas wie eine Prüfsumme. Ändert sich die Schnittstelle, weigert sich das System schlicht, Module zu starten, die gegen die alte Version gebaut wurden – dass ein Programm gegen eine veraltete Bibliothek gebaut wurde und irgendwo unergründlich abstürzt, ist hier also grundsätzlich unmöglich. Und das im Jahr 1988.
Es gibt keinen Speicherschutz; die Sprache übernimmt seine Rolle. Der Prozessor hat keinen Mechanismus, der ein Programm daran hindern würde, in den Speicher eines anderen zu greifen. Die gesamte Sicherheit beruht darauf, dass die Sprache streng typisiert ist und ihren Müll selbst einsammelt und dass der Compiler jeden Array-Zugriff prüft. Genau das werden wir in den Laborübungen kaputt machen.
Die Sprache ist klein. Der vollständige Report zu Oberon-07 umfasst 17 Seiten, und sein Motto ist Einsteins Satz, man solle alles so einfach wie möglich machen, aber nicht einfacher.
Warum sich 2026 mit einem Museumsstück beschäftigen? Ich habe drei Gründe. Der erste: wie tief Oberon das geprägt hat, was wir heute benutzen. Go – die Sprache, in der die halbe heutige Cloud-Infrastruktur geschrieben ist, Kubernetes eingeschlossen – nennt Oberon ausdrücklich als einen seiner Vorfahren; das steht direkt in der Go FAQ. Und Robert Griesemer, einer der drei Autoren von Go, hat bei Wirth an der ETH promoviert und zeichnet in seinem Vortrag “The Evolution of Go” einen Stammbaum, in dem eine gerade Linie von Oberon zu Go führt. Der zweite Grund: Oberon passt wirklich in einen Kopf. Wer verstehen will, wie ein Computer vom Gatter bis zum Fenster funktioniert, für den kenne ich kein besseres Lehrmittel. Und der dritte Grund: 1995 schrieb Wirth “A Plea for Lean Software”, ein Manifest gegen aufgeblähte Software – die Quelle des Wirthschen Gesetzes, wonach Software schneller langsamer wird, als Hardware schneller wird, wobei Wirth die Beobachtung redlicherweise seinem Kollegen Martin Reiser zuschrieb –, und Oberon war sein Beweis, dass es auch anders geht. Dreißig Jahre später ist es, vorsichtig gesagt, nur schlimmer geworden.
Und Oberon lebt erfreulicherweise noch. Es gibt aktive Forks, die erst vor wenigen Tagen aktualisiert wurden, und eine russischsprachige Community, OberonCore, die das alles lebhaft diskutiert.
Was man über Oberon lesen und ansehen sollte (das Beste, was ich gefunden habe)
- Project Oberon, Ausgabe 2013 – die Primärquelle: das Buch über System, Compiler und Prozessor mit sämtlichen Quellen.
- projectoberon.net – die Seite von Paul Reed, der bequemste Einstieg: Mirrors, Archive, ein fertiges Disk-Image.
- The Programming Language Oberon (Oberon-07) – die ganze Sprache auf 17 Seiten, Lektüre für einen Abend.
- Wirth, “Modula-2 and Oberon” – die Geschichte aus erster Hand: was Wirth von Xerox PARC übernommen und was er bewusst verworfen hat. Mein Lieblingssatz daraus: “We were inspired by what could be done, and shown how not to do it.”
- Wirth, “A Plea for Lean Software” – das Manifest von 1995 selbst.
- Wirth, “Compiler Construction” – ein kurzes, sehr gut lesbares Lehrbuch über Compiler, aufgebaut um ein abgespecktes Oberon für denselben Prozessor.
- The RISC Architecture – der Prozessor, beschrieben auf wenigen Seiten.
- Video: Wirth führt Oberon auf Ceres vor, 2011.
- Video-Interview der ETH mit Wirth, 2021 – der Link öffnet den ersten von drei Teilen.
- Griesemer, “The Evolution of Go” und die Folien – die Brücke von Oberon zu Go.
- Emulatoren: oberon-risc-emu von Peter De Wachter, OberonEmulator von Michael Schierl (läuft im Browser), Norebo – ein Oberon-Compiler, den man von einer gewöhnlichen Kommandozeile aus starten kann und ohne den es die Hälfte dieses Artikels nicht gäbe – sowie Extended Oberon von Andreas Pirklbauer.
- Auf Russisch: die OberonCore-Bibliothek mit Übersetzungen von Wirth, das Forum, Informatika-21 und das Buch Project Oberon: The Design of an Operating System and Compiler, 2012 bei DMK Press erschienen. Dem Jahr nach zu urteilen ist das eine Übersetzung der Ausgabe vor 2013 – also der ohne Wirths Prozessor –, selbst nachgeprüft habe ich das allerdings nicht; korrigieren Sie mich, falls ich falschliege.
Woher die ganze Idee kam
Ich führte schon lange eine Liste vergessener Systeme. Betriebssysteme, Sprachen und ganze Maschinen, die einmal funktionierten, manchmal sehr gut, und dann verschwanden – oft samt Ideen, die seither niemand richtig nachgebaut hat. Die Burroughs B5000, die schon 1961 Datentypen direkt in der Hardware prüfte. KeyKOS, für das ein aus der Wand gerissenes Stromkabel ein normales Ereignis war und keine Katastrophe. Transputer, Lilith, der iAPX 432. Über alle wurden Artikel und Bücher geschrieben, aber fast niemand betreibt sie tatsächlich, und genau das wollte ich – sie wirklich laufen lassen, mit allen Innereien, und sehen, was sie können.
So entstand die Reihe, die ich Paleocomputing genannt habe. Die Idee dahinter ist einfach. Viele dieser Systeme haben nicht verloren, weil sie schlecht waren, sondern weil sie teuer waren. Eigenes Silizium für eine eigene Sprache kostete Unsummen, während gewöhnliche Intel-Prozessoren schneller billiger wurden, als irgendjemand etwas Kluges bauen konnte. Heute sieht die Wirtschaftlichkeit anders aus. Programmierbare Chips kosten Centbeträge, die offene Architektur RISC-V erlaubt offiziell, dem Prozessor eigene Instruktionen hinzuzufügen, und das Projekt CHERI – dazu unten noch viel mehr – bringt im Grunde genau den Hardware-Speicherschutz in moderne Prozessoren zurück, den Burroughs schon vor meiner Geburt beherrschte. Das heißt, die alten Ideen lassen sich wieder von Hand ausprobieren, und genau das habe ich mir vorgenommen.
Für die erste Folge habe ich Oberon gewählt, obwohl ich eigentlich lieber Burroughs gemacht hätte. Der Grund ist simpel: Bei Oberon ist absolut alles vorhanden, was man zum Arbeiten braucht. Die Quellen des Prozessors, der Compiler, das Betriebssystem, das Buch, das alles erklärt, lebendige Emulatoren und fertige Disk-Images. Man kann sofort in die volle Tiefe eintauchen, statt einen Monat lang Dokumentation auszugraben – und für den Start einer Reihe brauchte ich genau diese Größenordnung.
Wie es gemacht wurde
Ich gebe gleich vorweg zu, dass der Großteil des Codes in diesem Projekt nicht von mir geschrieben wurde, sondern von einem neuronalen Netz. Genauer gesagt von mehreren KI-Agenten, denen ich verschiedene Rollen zugeteilt habe. Die einen schrieben Code, die anderen prüften ihn, und wieder andere bekamen die Aufgabe herauszufinden, warum das Ganze nicht funktionierte – und nahmen das sehr ernst. Sie tauchen im Text immer wieder als Reviewer und Auditoren auf, und ich möchte von Anfang an klarstellen, dass das keine lebenden Menschen sind, sondern dieselben neuronalen Netze, denen ich die Rolle eines pedantischen Lesers, eines Hardware-Spezialisten oder eines Messmethodikers zugewiesen habe. Sie arbeiteten unabhängig voneinander und unabhängig von dem Agenten, der den Code schrieb, und das war, glaube ich, die mit Abstand nützlichste Erfindung des ganzen Projekts. Bei mir blieben das Design, die Entscheidungen, die endlosen Fragen, ob wirklich alles geprüft wurde, und ein produktiver Cluster, den man, wie sich herausstellte, sehr leicht aus der Fassung bringt.
Ich erwähne das nicht, um auf einem Modethema mitzureiten, sondern weil der Rest der Geschichte ohne diesen Umstand keinen Sinn ergibt. Erstens wurde alles, was hier beschrieben ist, in neun Tagen erledigt, vom 21. bis zum 29. September, und dieses Tempo wäre unmöglich gewesen, hätte ich alles von Hand geschrieben. Zweitens ist es der Grund, warum sich ein Teil des Codes nicht an die großen Open-Source-Projekte übergeben lässt; dazu komme ich im Abschnitt über QEMU. Und drittens hat ein neuronales Netz eine sehr charakteristische Angewohnheit: Es meldet liebend gern, dass alles erledigt ist und alle Checks grün sind. In der Praxis hieß das oft, dass der Check schlicht gar nichts prüfte. Deshalb ging der größte Teil dieser neun Tage nicht ins Codeschreiben, sondern darein, den Checks beizubringen, ehrlich zu erröten, wenn etwas kaputt ist – ein roter Faden, der sich durch den ganzen Artikel zieht.
Der Plan, der an einem Tag zerfiel
Auf dem Papier klang der Plan großartig. Wirths echter Prozessor sollte direkt in einem Browser-Tab laufen, Takt für Takt – und nicht als Emulator, der nach der Dokumentation geschrieben wurde, sondern als seine eigene Schaltung. Ein Leser könnte den Befehlssatz dieses Prozessors direkt auf der Seite ändern, einen Knopf drücken und ein paar Sekunden später zusehen, wie das Betriebssystem auf der veränderten Hardware weiterläuft. Und obendrauf wollte ich drei laute Behauptungen setzen. Dass der ganze Computer, von den Gattern bis zu den Fenstern, in einem Browser läuft. Dass ein kleines neuronales Netz mindestens doppelt so schnell läuft, wenn man dem Prozessor eine spezielle Instruktion hinzufügt, die in einem Zug multipliziert und addiert, und dass man das in etwa einer Minute erledigt. Und dass man, wenn man dem Prozessor eine Hardware-Prüfung der Array-Grenzen hinzufügt, zum ersten Mal ehrlich messen kann, was eine solche Prüfung kostet – denn, wie ich im Entwurf selbstbewusst schrieb, diese Zahl hat niemand.
Ich gab mir zwei bis vier Wochen. Na klar.
Bevor ich mich ans Codeschreiben machte, schickte ich den Plan an fünf Reviewer, jeder mit eigenem Fachgebiet: Zeitplan, Hardware, Compiler, Messmethodik und Browser. Die Aufgabe war für alle dieselbe: herausfinden, warum das nicht funktionieren wird. Die Kommentare summierten sich auf mehr als achtzig Kilobyte Text, und danach stand vom Plan nicht mehr viel.
Am ärgerlichsten war, dass der Platz für neue Instruktionen im Prozessor, den ich gefunden zu haben glaubte, gar nicht frei war. Ich hatte in der Instruktionskodierung ein Bit gesehen, das immer null ist, und wollte dort meine neuen Instruktionen unterbringen. Der Hardware-Reviewer öffnete Wirths Schaltung und zeigte, dass der Prozessor dieses Bit schlicht nicht beachtet – auf einem echten Prozessor würden also alle meine neuen Instruktionen stillschweigend als die häufigste Instruktion überhaupt ausgeführt, als Datentransfer, und das Programm würde in aller Ruhe etwas völlig anderes tun als das, was geschrieben steht. Freien Platz gab es im Befehlssatz überhaupt nicht. Später fand sich zwar doch eine kleine Stelle, an der Wirths Compiler immer Nullen schreibt, und darüber, wie ich mich dort hineinzuquetschen versuchte, gibt es eine eigene Geschichte.
Auch die Verdopplung der Geschwindigkeit für das neuronale Netz überstand das Review nicht. Die Reviewer zählten direkt an der Schaltung ab, wie viele Takte jede Operation braucht, und selbst wenn die neue Instruktion völlig kostenlos wäre, könnte sie das Programm grundsätzlich nicht um mehr als den Faktor zwei beschleunigen – und die tatsächlich gebaute würde mit Glück ein paar Prozent schaffen. Und genau hier lag der entscheidende Punkt, der sich später bestätigte: Der Engpass ist gar nicht die fehlende Instruktion, sondern Wirths sehr langsamer Multiplizierer, der das Produkt mit einem Bit pro Takt berechnet.
Die Zahl, die angeblich niemand hat, wurde zur ziemlichen Blamage. Der Methodiker brachte eine Liste von Arbeiten mit, in denen die Kosten von Hardware-Speicherschutz vielfach gemessen worden waren, auch auf modernen Arm-Prozessoren und im CHERI-Projekt. Relativ neu war eigentlich nur, dass ich als Last ein System verwenden wollte, das sich selbst neu baut – aber auch das ist eher ein Detail als eine Entdeckung.
Außerdem stellte sich heraus, dass man in Oberon die Prüfung der Array-Grenzen in gewöhnlichem Code überhaupt nicht abschalten kann; sie ist fest in den Compiler eingeschweißt. Es gab schlicht nichts, womit man Wirths System ohne Prüfungen hätte vergleichen können, und ich musste von Anfang an einen eigenen Compiler-Patch einplanen, der einen Build ohne Prüfungen erzeugt.
Was die Reviewer sonst noch zerlegt haben
Ich wollte die Ergebnisse mit einem Konfidenzintervall angeben, wie es ordentliche Statistik verlangt. Der Methodiker wies darauf hin, dass das auf einem Simulator sinnlos ist, weil derselbe Lauf immer dieselbe Zahl liefert, bis auf den Takt genau – es gibt dort keine Streuung, aus der ein Intervall entstehen könnte. Streuung entsteht erst, wenn man viele verschiedene Programme nimmt, und genau das sollte man messen.
Die Reviewer merkten außerdem an, dass auf einer echten Maschine der Videocontroller etwa 7 % der Prozessorzeit beansprucht, weil er ständig Speicher für den Bildschirm liest, und dass jede Zahl ein wenig rosiger als die Wirklichkeit ausfällt, wenn man das ignoriert. Dass zwei Multiplikationen direkt hintereinander auf Wirths Maschine mehr kosten als zwei Multiplikationen mit Abstand. Dass das gängige offene Werkzeug zur Abschätzung der Schaltungsfläche standardmäßig mehr als die Hälfte der Speicherelemente verliert. Und dass der ganze Plan keinen einzigen Zwischenpunkt hatte, an dem man anhalten und den Leuten etwas zeigen konnte – was für ein Projekt in der Freizeit tödlich ist.
Die überarbeitete Zeitschätzung nach dem Review: neun bis dreizehn Wochen Arbeit an den Abenden. Wir haben es in neun Tagen geschafft, aber nur, weil den Code Agenten geschrieben haben – das hatte ich ja schon erwähnt.
Nach dem Review habe ich den Plan neu geschrieben. In der ersten Folge blieben zwei Behauptungen übrig. Erstens, dass der ganze Computer in einem Browser läuft. Zweitens, dass man die Kosten der Bounds-Prüfung auf einem vollständig offenen System ehrlich messen kann, auf dem alles sichtbar ist, von der Prozessorschaltung bis zum Compiler. Das neuronale Netz und seine neue Instruktion habe ich in eine eigene Folge verschoben. Und in der Risikotabelle tauchte ein Satz auf, den ich sehr mag: dass die Zahl höchstwahrscheinlich langweilig ausfallen wird, um die sechs Prozent – und dass genau das das Ergebnis ist.
Um vorzugreifen: Ich habe am Ende doch ein neuronales Netz auf Wirths Prozessor laufen lassen, und in der Hauptsache hatten die Reviewer recht – alles lief auf den Multiplizierer hinaus. Aber dazu mehr gegen Ende.
Wirths echten Prozessor zum Laufen bringen
Alles beginnt ganz einfach. Wirth hat seinen Prozessor in Verilog beschrieben, und diese Beschreibung ist kein Programm, sondern eine Schaltung – Register, Leitungen und die Logik dazwischen. Um eine solche Schaltung ohne echten Chip auszuführen, gibt es ein Werkzeug namens Verilator, das daraus ein C++-Programm macht, das in jedem Takt jede Leitung des Prozessors getreu neu berechnet. Das läuft langsamer als echte Hardware, aber genau wie sie, ohne Näherungen. An den Prozessor müssen noch Bildschirm, Festplatte, Tastatur und Maus angeschraubt werden. Diese Umgebung habe ich selbst gebaut und dabei exakt die Schnittstelle nachgebildet, die das System erwartet, den Prozessor selbst aber um keine einzige Zeile verändert. Das war mir grundsätzlich wichtig, denn alles, was ich später messe, muss auf seiner Schaltung gemessen werden, nicht auf meiner.
Der erste Arbeitstag begann am 22. September um ein Uhr nachts, und bis zum Mittag hatte Wirths echte Schaltung das echte Project Oberon gebootet. Der Bootvorgang umfasst etwa zwölf Millionen Instruktionen, und auf meinem Laptop schafft die Simulation das in vier Sekunden. Das Bild ganz oben im Artikel stammt aus genau diesem Lauf.
Woran das Booten bis zum Mittag hing
Zuerst hatte ich den falschen Bootloader erwischt. In Wirths Repository liegt ein Bootloader, der das System über eine serielle Schnittstelle empfängt und überhaupt nicht von der Festplatte liest, und weil sein Anfang mit dem identisch ist, den ich brauchte, habe ich ziemlich lange auf Code gestarrt, der richtig aussah.
Dann führte der Prozessor als erste Instruktion Unsinn aus. Während der Prozessor zurückgesetzt wird, liest er trotzdem eine Instruktion vom Datenbus, und stehen dort in diesem Moment Nullen, wird als Erstes ein sinnloser Datentransfer ausgeführt statt eines Sprungs zum Bootloader, und die Maschine steht einfach still. In genau diesen Bug bin ich auf verschiedenen Prüfständen noch dreimal getreten, und einmal hat er sich extrem gut versteckt – dazu weiter unten mehr.
Und das Dritte war ein auf dem Kopf stehender Bildschirm, weil Wirths Videocontroller das Bild von unten nach oben aus dem Speicher liest. Der Hardware-Reviewer hatte das vorhergesagt, und die Warnung hat mir einen Haufen Zeit gespart.
Es zum Laufen zu bringen, ist nur die halbe Arbeit; man muss sicher sein, dass es korrekt läuft. Dafür gibt es eine Technik namens Lockstep-Vergleich. Man nimmt eine Referenz, der man vertraut, und lässt sie parallel zur eigenen Maschine dasselbe Programm abarbeiten, Instruktion für Instruktion, wobei nach jeder einzelnen der Inhalt sämtlicher Register verglichen wird. Weicht irgendwo auch nur ein einziges Bit ab, erfährt man es sofort und weiß genau, bei welcher Instruktion es passiert ist. Als Referenz nahm ich den Emulator aus dem Projekt Norebo, und über den gesamten Systemstart – fast fünfzehn Millionen Instruktionen – wich meine Schaltung kein einziges Mal von ihm ab. Anfangs gab es allerdings eine Abweichung, und die ging auf mein Konto: Auf Anraten eines Reviewers hatte ich vorsorglich einen Verwaltungswert in den Speicher geschrieben, den der Emulator nur in einer bestimmten Situation schreibt, die in diesem Lauf gar nicht eintrat. Richtig war, gar nichts anzufassen.
Hier sollte ich sagen, warum das überhaupt wichtig ist. Alle Taktzahlen in diesem Artikel berechnet ein separates schnelles Modell, weil die echte Schaltung unter schwerer Last viel zu lange braucht. Und diesem Modell kann man genau so weit trauen, wie es mit der Schaltung übereinstimmt. Ich habe die beiden auf demselben Bootvorgang gegeneinander geprüft und eine perfekte Übereinstimmung bekommen, bis auf den Takt genau – aber zunächst behauptete der Vergleich, das Modell liege um fast sechzehn Prozent daneben, und ich hätte es beinahe geglaubt. Gelogen hatte der Vergleich selbst, weil er die Instruktionsadresse einen Takt früher abgriff als vorgesehen. Hätte ich damals veröffentlicht, dass das Modell um 16 % danebenliegt, wäre jede Zahl im Projekt entwertet gewesen. Seitdem habe ich eine Regel: Ein negatives Ergebnis muss genauso sorgfältig geprüft werden wie ein positives, denn man kann sich in beide Richtungen irren.
Was die Prüfung von Array-Grenzen kostet
Nun zur zentralen Frage der ersten Folge. Schreibt man in C a[i] und ist i zufällig größer als das Array, liest oder schreibt das Programm stillschweigend fremden Speicher. Aus diesem simplen Fehler ist ein riesiger Teil der Sicherheitslücken der letzten fünfzig Jahre erwachsen, von den Buffer Overflows der Neunziger bis zu den heutigen Sicherheitsbulletins der Browser. Sich davor zu schützen, ist sehr einfach: Vor jedem Array-Zugriff wird der Index mit der Länge verglichen und, falls er außerhalb liegt, das Programm angehalten. Viele Sprachen tun genau das, Oberon tut es immer, und in C und C++ wird diese Prüfung traditionell nicht geschrieben, weil sie als langsam gilt. Ich wollte also herausfinden, wie langsam sie tatsächlich ist, und zwar auf einem System, auf dem absolut alles sichtbar ist.
Dafür braucht man drei Varianten desselben Systems. Die erste ohne jede Prüfung – ein solches Oberon gibt es nicht, also habe ich es selbst gebaut, indem ich eine einzige Zeile im Compiler geändert habe. Die zweite mit der Software-Prüfung, wie bei Wirth, bei der der Compiler vor jedem Zugriff einen Vergleich und einen Sprung zum Fehlerbehandler einfügt. Und die dritte mit einer Hardware-Prüfung, bei der der Prozessor eine neue Instruktion bekommt, die all das selbst in einem Takt erledigt. Diese Instruktion bekommt einen eigenen Abschnitt. Als Last nahm ich den Oberon-Compiler, der mehrere Module des Systems selbst übersetzt, denn das ist ein echtes, großes Programm und kein synthetischer Test.
Die erste Zahl, die ich bekam, lag unter einem halben Prozent, und ich freute mich, dass Prüfungen fast nichts kosten. Dann merkte ich, dass ich das Falsche verglichen hatte. Ich hatte zwei verschiedene Compiler laufen lassen, einen mit Prüfungen und einen ohne, und der Compiler ohne Prüfungen hatte schlicht weniger Arbeit, weil er niemandem sonst Prüfungen in den Code einfügen musste. Vergleichen muss man dieselbe Arbeit – also ein und denselben Compiler in zwei Varianten bauen und beiden dieselbe Aufgabe geben. Nachdem ich das korrigiert hatte, wuchs die Zahl um ein Mehrfaches.
Danach gab es noch einige Durchgänge, und die ehrliche Antwort lautete so. Solange die Prüfungen nur aus dem Compiler selbst entfernt werden, kosten sie etwa zwei Prozent der Zeit. Entfernt man sie aus dem gesamten System, auf dem der Compiler läuft, einschließlich der Verarbeitung von Text, Dateien und Speicher, sind es fast fünf Prozent. Von je hundert Takten Compilerarbeit gehen also zwischen zwei und fünf dafür drauf, dass das Programm nie über das Ende eines Arrays hinausläuft. Ob das viel oder wenig ist, mag jeder Leser selbst entscheiden; für meinen Geschmack ist es sehr billig dafür, dass eine ganze Klasse von Sicherheitslücken wegfällt. Mit einem Vorbehalt, den die Reviewer schon am ersten Tag gemacht hatten: Ich habe nur eine einzige Last, das ist also eine Zahl über den Oberon-Compiler und nicht über alle Programme der Welt.
Hier wartete die erste Überraschung auf mich. Als ich nachzählte, welche Prüfungen tatsächlich im Code stehen, stellte ich fest, dass es in Oberon sehr wenige Prüfungen von Array-Grenzen gibt und die überwältigende Mehrheit Prüfungen darauf sind, dass ein Zeiger nicht leer ist – also nicht NIL. Allein im Compiler sind es mehr als dreihundert davon gegenüber einer Handvoll Indexprüfungen. Die Kosten der Sicherheit in Oberon entstehen also hauptsächlich dadurch, dass das Programm keinen Nullzeiger dereferenzieren kann, und Arrays als solche sind hier Nebensache.
Wie ich beim Nacherzählen fremder Arbeiten erwischt wurde
Zuerst verglich ich meine Prozentwerte mit veröffentlichten Arbeiten zum Speicherschutz auf anderen Prozessoren und bekam eine sehr hübsche kleine Tabelle. Der Auditor zog sie komplett zurück, weil ich drei der vier Zahlen falsch wiedergegeben hatte. An einer Stelle hatte ich den Wert für einen leichtgewichtigen Schutzmodus genommen, während der vollständige fünfmal mehr kostete. An einer anderen kam der Großteil des Verlusts von Cache-Misses, und Wirths Prozessor hat überhaupt keinen Cache, ein Vergleich mit unserer Zahl ist also sinnlos. An einer weiteren hatte ich zwei verschiedene Betriebsmodi für eine Wertespanne gehalten. Und in einer Arbeit war das Ergebnis als Faktor angegeben, ich aber hatte es als Prozentwert gelesen, sodass aus einer Verlangsamung um das Anderthalb- bis Zweieinhalbfache in meinen Händen eine Verlangsamung um anderthalb bis zweieinhalb Prozent wurde. Für Letzteres schäme ich mich am meisten.
Am nächsten an meinem eigenen Aufbau lag schließlich eine Dissertation, in der mehrere CHERI-Prozessoren bei 10–16 % landeten, gemessen wird dort aber vollständiger Zeigerschutz, eine deutlich breitere Sache, das ist also eher eine Orientierung als ein Vergleich. Und die Behauptung, diese Zahl habe niemand, überlebte nicht einmal das, denn schon 1981 gab es eine Arbeit, die die Kosten von Prüfungen in Pascal maß. Und zwar gemessen. Korrekt kann man nur sagen, dass wir in diesen und jenen Quellen etwas nicht gefunden haben, und nur so formuliere ich es heute.
Wie ich dem Prozessor beibrachte, selbst zu prüfen
Jetzt zur Hardware-Prüfung. Die Idee ist einfach. Statt zweier Instruktionen – eines Vergleichs und eines bedingten Sprungs – bekommt der Prozessor eine neue Instruktion, die ich CHK genannt habe. Sie nimmt einen Index und eine Array-Länge und springt, wenn der Index außerhalb des Bereichs liegt, selbst zum Fehlerbehandler. Alles in einem Takt statt in zweien.
Die Schwierigkeit lag darin, wo in der Instruktion die Array-Länge unterzubringen ist. Eine Instruktion auf Wirths Prozessor hat 32 Bit, und fast alle sind schon belegt. Die einzige Stelle, die der Prozessor wirklich nicht nutzt – was ich durch Aufzählen aller möglichen Werte bewiesen habe –, sind zwölf Bit in der Mitte der Instruktion. Zwölf Bit bedeuten Arrays mit bis zu viertausend Elementen, und das ist in Oberon die überwältigende Mehrheit, also war ich zufrieden und legte die Länge dorthin.
Und bekam ein sehr hässliches Ergebnis. Schlägt in Oberon eine Prüfung an, meldet das System, wo und welcher Fehler genau aufgetreten ist, und die Fehlernummer entnimmt es genau den Bits der Instruktion, in die ich die Länge gelegt hatte. Ich machte ein Experiment mit einem echten Fehler, einem Programm, das über das Ende eines Arrays mit hundert Elementen hinausgreift. Das gewöhnliche System meldete ehrlich, dass der Index außerhalb der Array-Grenzen lag. Meines, mit der neuen Instruktion, meldete ebenso selbstbewusst, es habe eine Nullzeiger-Dereferenzierung gegeben, weil ein Stück der Zahl 100 im Feld für die Fehlernummer gelandet war. Ein Programmierer, der diese Meldung bekommt, würde einem nicht existierenden Zeiger-Bug hinterherjagen und einen halben Tag damit verlieren. Das ist schlimmer, als wenn das System gar nichts sagt.
Danach versuchte ich ein paarmal, mich herauszuwinden, indem ich die Länge auf acht Bit verkürzte, und beide Male ging es schief. Zuerst zeigte die Statistik, dass acht Bit für die meisten Arrays reichen, dann stellte sich aber heraus, dass die Mehrheit in dieser Statistik aus identischen Puffern für Dateinamen bestand, die kaum je benutzt werden, während die heißen Schleifen, die millionenfach laufen, gerade mit den großen Arrays arbeiten und nicht in acht Bit passen. Die Lösung fand sich an anderer Stelle. Die neue Instruktion braucht nämlich kein Zielregister, weil sie nichts berechnet, sondern nur prüft, und die vier Bit, die gewöhnlich dieses Register bezeichnen, sind frei. Die Länge lässt sich in zwei Teile schneiden: Die vier oberen Bit kommen dorthin, die acht unteren in die Mitte der Instruktion, so platziert, dass sie die Fehlernummer nicht berühren. Das ergab sowohl die zwölf Bit Länge als auch korrekte Fehlermeldungen.
Wie die neue Instruktion in der Prozessorschaltung aussieht und welche Fallen sie barg
Die gesamte Änderung am Prozessor steckt hinter einem einzigen Schalter, sodass man exakt dieselbe Schaltung mit und ohne die neue Instruktion bauen und vergleichen kann (hier vereinfacht, ohne das Zusammensetzen der Länge aus zwei Teilen):
`ifdef WITH_CHK
assign CHK     = ~p & ~q & ~u & v & (op == 1);
assign chkFail = CHK & (B >= chkLim);
`else
assign CHK     = 1'b0;
assign chkFail = 1'b0;
`endif
Anfangs fehlte in der ersten Zeile das ~u, und deshalb belegte die neue Instruktion zwei Kodierungen statt einer und kaperte dabei nebenbei eine andere, völlig unbeteiligte. Gefunden hat das ein Check, der jede mögliche Instruktion auf dem gewöhnlichen Prozessor und auf dem Prozessor mit der neuen Instruktion durchspielt und sucht, wo sie sich unterschiedlich verhalten. Die richtige Antwort ist genau eine Stelle; er fand zwei.
Der Auditor hat außerdem durchgespielt, was passiert, wenn ein Modul mit der neuen Instruktion versehentlich auf einem gewöhnlichen Prozessor gestartet wird. Der gewöhnliche Prozessor hält sie für einen Shift und beschädigt stillschweigend eines der Register – welches, hängt von der Array-Länge ab, und bei einer Länge um die viertausend ist es das Register mit der Rücksprungadresse einer Prozedur. Von außen sähe das wie eine unerklärliche Stack-Beschädigung aus. Inzwischen werden solche Module mit einer neuen Formatversion gekennzeichnet, und das gewöhnliche System weigert sich schlicht, sie zu laden. Das Komische daran: Die Forderung nach der Versionskennzeichnung stand schon im allerersten Review; ich hatte sie angenommen und dann verloren.
Wie viel spart die Hardware-Prüfung also am Ende? Beim Compiler fällt etwa ein Sechstel der Prüfkosten weg, bei einer gemischten Last mit Arrays unterschiedlicher Größe ein Zehntel und bei rein rechnendem Code mit kleinen Arrays die Hälfte. Die Hälfte ist übrigens die Obergrenze, mehr wird es nie, denn aus zwei Instruktionen wurde eine. Der Unterschied zwischen den Lasten hat eine ganz einfache Erklärung. Die Instruktion hilft nur dort, wo die Array-Länge in zwölf Bit passt. Wo das Array größer ist, greift der Compiler auf die alte Software-Prüfung zurück, und es gibt keinen Gewinn.
Und noch eine schöne Geschichte aus diesem Abschnitt. Für die zweite Last schrieb ich ein kleines Programm mit einer Sortierung und einer Matrixmultiplikation. In der Variante mit Prüfungen stürzte es sofort mit einer Out-of-Bounds-Meldung ab, und der Fehler steckte in meinem Programm selbst: Ich hatte einen Index falsch berechnet und lief um das Dreieinhalbfache über das Array hinaus. Die Variante ohne Prüfungen lief stillschweigend durch, als sei alles in Ordnung, und schrieb in aller Ruhe zweieinhalbtausend Zahlen in fremden Speicher. Gefunden wurde der Bug nur, weil die Prüfungen eingeschaltet waren, und ehrlich gesagt fällt mir keine bessere Werbung für Bounds-Checking ein.
Wie viel die neue Instruktion in Hardware kostet – wie viel Platz sie auf dem Chip einnimmt und ob sie den Prozessor verlangsamt –, habe ich ebenfalls gemessen, und die Antwort fiel langweilig aus. Sie fügt weniger als ein Prozent Logik hinzu und berührt die Taktfrequenz überhaupt nicht. Interessant ist hier, wie ich zu dieser langweiligen Antwort kam, denn unterwegs erwies sich das Rauschen bei solchen Messungen als größer als der Effekt selbst.
Wie das Rauschen größer ausfiel als der Effekt
Die Fläche einer Schaltung schätzt man mit offenen Synthesewerkzeugen ab, die eine Verilog-Beschreibung in eine Menge von Logikelementen übersetzen. Die erste Falle: Das Werkzeug ließ im Standardmodus stillschweigend drei Viertel der Speicherelemente weg, und der einzige Hinweis darauf war ein Pluszeichen ganz am Ende einer Zeile im Bericht. Die zweite: Ohne explizit angegebene Constraints ignorierte es das Geschwindigkeitsziel einfach, und die Schaltung für 200 Pikosekunden und für 50 Nanosekunden fiel bis auf die letzte Ziffer identisch aus.
Das Schlimmste aber war etwas anderes. Ich nahm Wirths Schaltung und schrieb sie viermal so um, dass sich an der Logik überhaupt nichts änderte – etwa mit überflüssigen Klammern oder einem sinnlosen ODER mit null. Die Fläche schwankte danach um etwa so viel, wie meine neue Instruktion hinzufügt. Der Effekt, den ich messen wollte, war also genauso groß wie der Unterschied, der sich allein daraus ergibt, wie ein völlig unveränderter Ausdruck zufällig hingeschrieben ist. Ehrlich sagen kann man also nur, dass es unter einem Prozent liegt; und was die Frequenz angeht, zeigte eine Bauweise ein wenig schneller, eine andere ein wenig langsamer, und sich eine davon auszusuchen, hieße, eine bequeme Antwort zu wählen, statt eine zu messen.
Dann habe ich die Schaltung auf einem echten FPGA platziert und geroutet – also die Werkzeuge gebeten, sie auf die tatsächlichen Zellen eines bestimmten Chips zu verteilen und die Leitungen dazwischen zu ziehen. Erst danach sieht man, mit welcher Frequenz die Schaltung wirklich laufen wird. Die nativen 25 MHz hielten mit großer Reserve, die neue Instruktion beeinflusste die Frequenz nicht, und der Großteil der Verzögerung in der Schaltung steckt in den Leitungen, nicht in der Logik.
Die Auditoren haben die Arbeit nicht abgenommen
Am Abend des ersten Tages hatte ich viele hübsche Zahlen und übergab sie fünf Auditoren zur Abnahme. Um 17:40 meldeten sie sich zurück, und alle fünf schrieben dasselbe Wort: NICHT ABGENOMMEN, in Großbuchstaben.
Am unangenehmsten und zugleich am nützlichsten war das Mutations-Audit. Seine Idee ist einfach und sehr grausam. Der Auditor baut absichtlich plausible Fehler in den Prozessor ein – ändert etwa in einem Vergleich „größer oder gleich“ in „größer“ – und schaut, ob meine Tests es bemerken. Bleiben die Tests auf einem kaputten Prozessor grün, prüfen sie gar nichts. Von dreißig eingebauten Fehlern fingen meine Tests zehn. Zwei Drittel der kaputten Prozessoren bestanden jede Prüfung als einwandfrei.
Die Gründe waren sehr lehrreich. An einer Stelle zählte ein Check, der gar nicht gelaufen war, als bestanden, und der Bericht verkündete stolz, drei von fünf Fällen seien geprüft und keine Fehler gefunden worden. An einer anderen war der Test-Build so konfiguriert, dass sein Scheitern den Lauf nicht stoppte, und Erfolg wurde an einem Smiley in der letzten Ausgabezeile festgemacht, sodass null ausgeführte Tests einen vollständig grünen Bericht ergaben. Und eine Instruktion, die angeblich den Systemstart prüfte, prüfte in Wahrheit überhaupt nichts: Mit einem Prozessor, bei dem eine seiner Instruktionen kaputt war, blieb die Maschine gleich zu Beginn des Bootvorgangs hängen, und der Check meldete trotzdem Erfolg. Obendrein enthält der Systemstart keine einzige Operation mit Gleitkommazahlen, meine Behauptung, der Vergleich habe die gesamte Arithmetik des Prozessors geprüft, war also schlicht falsch.
Die Hauptschlussfolgerung der Auditoren war, dass fast alle Fehler beim Übertragen der Ergebnisse in den Text passierten. Eine Zahl, die unter bestimmten Bedingungen gewonnen wurde, wanderte als allgemeine Aussage in die Zusammenfassung. Wir haben alles umgeschrieben, was wir fanden, dieselbe Art absichtlicher Sabotage in den automatischen Check bei jeder Änderung aufgenommen und eine Regel eingeführt: Jeder Check muss scheitern können, und das muss vorgeführt werden. Und am nächsten Tag tauchte noch ein Juwel auf. In allen gut zweihundert Prozessortests wurde die allererste Instruktion des Programms gar nicht ausgeführt, und zwar wegen genau jenes Bus-beim-Reset-Bugs, über den ich oben geschrieben habe. Bemerken konnte man das unmöglich, weil jeder Test mit einer Instruktion begann, deren Ergebnis ohnehin keine Rolle spielte. Am ärgerlichsten: Ich hatte diesen Bug auf einem anderen Prüfstand schon gefunden und behoben und dort sogar einen Kommentar hinterlassen, dass ich genau darüber gestolpert war.
Kleine Freuden der ersten Tage
Ich schrieb ein Skript, das auf das Ende eines langen Laufs wartet und das anhand des Prozessnamens prüft. Das Skript wartete anderthalb Stunden, weil es sich selbst fand – der Prozessname stand in seiner eigenen Kommandozeile. Sehr zen, und die ganze Zeit dachte ich, eine lange Kompilierung sei im Gange.
Vier Milliarden Instruktionen gingen ins Leere, weil Emulator und Prozessor Geräteadressen unterschiedlich schreiben und der Check, ob das Programm ein Gerät anfasst, kein einziges Mal anschlug.
Ein und dasselbe Feld einer Sprunginstruktion behandelt Wirths Compiler als 24-Bit-Feld, der Disassembler als 20-Bit-Feld und der Prozessor selbst als 22-Bit-Feld. Drei Teile eines Systems, geschrieben von einem Mann, und jeder hat auf seine Weise recht.
Eines der Werkzeuge zur Testvorbereitung beschädigte stillschweigend das Referenz-Disk-Image direkt im Repository, und der Bildschirm-Check stimmte auf dem beschädigten Image trotzdem überein. Inzwischen läuft alles auf Kopien, und neben der Referenz liegen Prüfsummen.
Zwei Multiplikationen direkt hintereinander kosten auf Wirths Maschine fast anderthalbmal mehr als zwei Multiplikationen mit Abstand, weil der Multiplizierer seinen Zähler nicht rechtzeitig zurücksetzt. Zuerst freute ich mich über den Fund, dann erfuhr ich, dass die Langsamkeit des Multiplizierers schon 2016 in den Oberon-Foren diskutiert worden war. Genau diesen Mechanismus habe ich dort nicht gefunden, aber dass ich etwas nicht gefunden habe, heißt nicht, dass es niemand wusste.
Und um 19:30 am ersten Tag schloss sich der Kreis. Der Oberon-Compiler, der auf Wirths echter Schaltung lief, übersetzte sich selbst, und das Ergebnis stimmte Byte für Byte mit dem überein, was der Emulator erzeugt. Am nächsten Tag gelang dasselbe innerhalb des Systems selbst, mit Fenstern und Maus. Ein Skript aus Klicks und Tastendrücken ließ das System sich vollständig neu bauen, und jede Datei kam genau so heraus wie im ursprünglichen Disk-Image. Nebenbei stellte sich heraus, dass das offizielle System-Image von 2016 nicht ganz mit sich selbst konsistent ist: Ein paar seiner Module waren veraltet, und eines fehlte ganz. Der ganz normale Alltag eines lebendigen Projekts – und ehrlich gesagt hat mich das ziemlich gerührt.
Oberon in einem Browser-Tab
Jetzt zur ersten Behauptung dieser Folge, der über den Browser. Wirths Schaltung, die Verilator in ein C++-Programm verwandelt hat, lässt sich weiter nach WebAssembly übersetzen – in das Format, in dem ein Browser gewöhnlichen kompilierten Code mit nahezu nativer Geschwindigkeit ausführen kann. Und dann dreht sich im Tab kein Emulator, den jemand nach der Dokumentation geschrieben hat, sondern genau die Schaltung, die Wirth auf sein FPGA geflasht hat, mit allen ihren Leitungen und Takten. Ich betone noch einmal: Bildschirm, Festplatte, Tastatur und Maus rund um den Prozessor stammen von mir, gebaut nach derselben Schnittstelle wie bei Wirth, und der Videocontroller, der auf einer echten Maschine ein wenig Prozessorzeit beansprucht, geht in die Messungen nicht ein.
Anfangs hieß es, das sei eine schlechte Idee, weil das Neuberechnen jeder Leitung für einen Browser zu langsam sei. In der Praxis läuft die Browser-Version fast so schnell wie dieselbe Simulation, die direkt auf dem Rechner gestartet wird – der Unterschied liegt bei ein paar Prozent. Das ist etwa sechsmal langsamer als Wirths echte Maschine, das System braucht also ein paar Sekunden zum Booten, danach kann man ganz entspannt damit arbeiten. Und die ganze Maschine samt Disk-Image wiegt etwa dreihundert Kilobyte – weniger als ein durchschnittliches Bild auf einer beliebigen Nachrichtenseite.
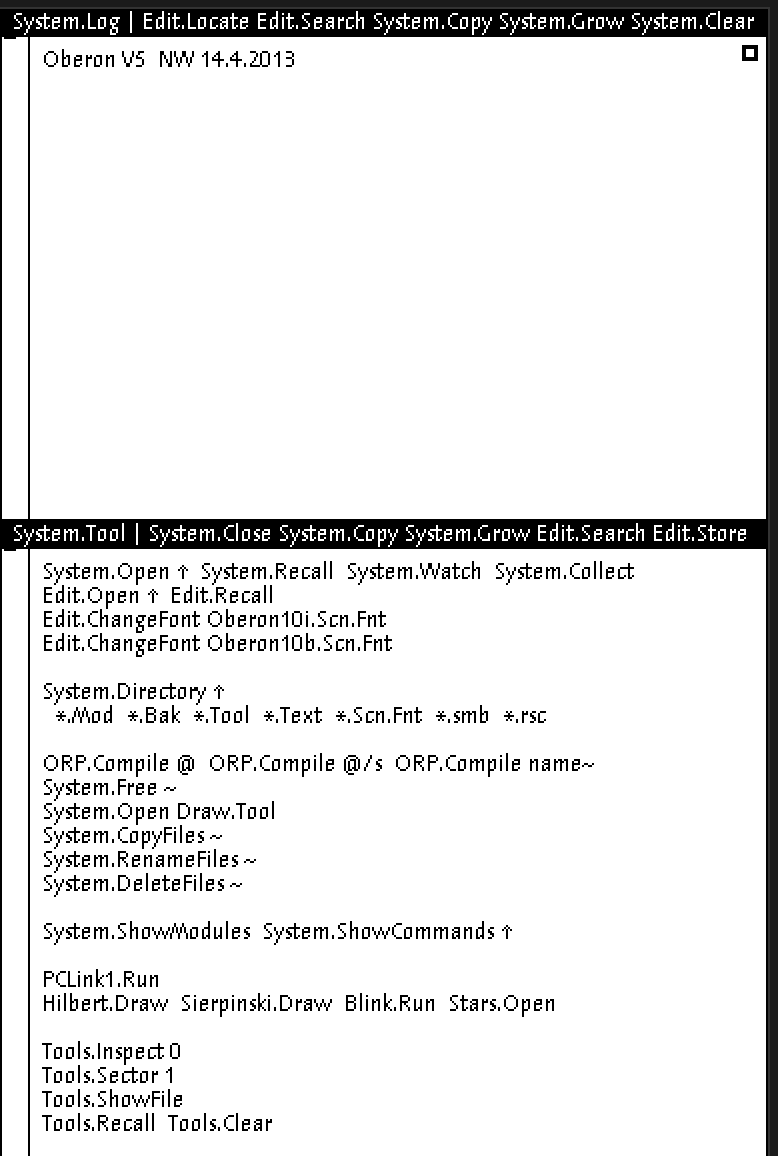
Dasselbe System im Browser. Das Log mit dem Oberon-Startbildschirm und ein System.Tool-Fenster, dessen Text man mit der mittleren Taste anklickt.
Was nötig war, damit das funktioniert
Der WebAssembly-Build brauchte ein paar Stubs für Funktionen, die der Browser nicht hat, und ein paar Workarounds in Verilator selbst, aber das ist der langweilige Teil. Interessanter war, was danach kam.
Öffnet man die Seite in einem Hintergrund-Tab, zeichnet der Browser darauf nichts, und der Bildschirm blieb schwarz, selbst nachdem man zu diesem Tab gewechselt hatte. Ich musste den Moment, in dem der Tab sichtbar wird, gesondert abfangen.
Am interessantesten war die Maus. Oberon muss wissen, welche der drei Tasten gleichzeitig gedrückt sind, der Browser meldet Tastendrücke aber einzeln, also muss der Zustand aller Tasten von Hand zusammengesetzt werden. Auf einem Laptop wird die mittlere Taste durch einen Klick mit gedrückter Alt-Taste ersetzt – nicht Ctrl, wie man es gern hätte, denn auf einem Mac ist Ctrl-Klick die rechte Taste. Und ein Shift-Klick ersetzt einen kniffligen Akkord, bei dem man die linke Taste drückt und, ohne sie loszulassen, die rechte dazunimmt. Die Seite drückt zuerst selbst die linke und nimmt dann die rechte dazu, weil es für Oberon eine Rolle spielt, mit welcher Taste alles begann.
Die Maschine selbst läuft in einem eigenen Thread, um die Seite nicht einzufrieren, und übergibt fertige Bildschirm-Frames ohne Kopieren an den Haupt-Thread. Außerdem rechnet sie nur, solange jemand hinsieht, und ist der Tab verborgen oder hat man die Maschine aus dem Bildschirm gescrollt, hält sie an. Andernfalls würde sie ehrlich einen ganzen Kern Ihres Prozessors verheizen, denn die Schaltung kann nicht untätig sein und zählt einfach Takte.
Dadurch lässt sich die Maschine mit zwei Zeilen in jede beliebige Seite einbetten:
<script type="module" src="https://tym83.github.io/paleocomputing/oberon/embed.js"></script>
<oberon-machine base="https://tym83.github.io/paleocomputing/oberon/"></oberon-machine>
Details und Einstellungen stehen auf der Seite Embed it. Dort können Sie die Maschine auch auf den Prozessor mit der neuen Prüfinstruktion umschalten und vor dem Booten eigene Dateien auf ihre Festplatte legen.
Die Seite, auf der man den Prozessor wechselt
Ursprünglich wollte ich, dass der Leser den Befehlssatz des Prozessors selbst ändern kann, direkt auf der Seite. Das habe ich, wie ich offen zugebe, nicht umgesetzt, weil sich das Neubauen der Schaltung aus Verilog direkt im Browser als zu schwer erwies. Stattdessen funktionierte die Ausweichidee aus demselben Plan: mehrere Prozessorvarianten vorab bauen und zwischen ihnen umschalten lassen. Auf der Seite Change the processor gibt es zwei Kerne – den gewöhnlichen, wie bei Wirth, und einen mit der neuen Instruktion CHK –, und auf jedem lässt sich dieselbe Schleife ausführen, die ein Array durchläuft.
Auf dem gewöhnlichen Prozessor braucht ein Array-Zugriff in dieser Schleife elf Takte, von denen zwei auf die Software-Prüfung entfallen. Auf dem Prozessor mit der neuen Instruktion sind es zehn, weil die Prüfung einen Takt statt zwei braucht. Ein Takt von elf, genau wie beabsichtigt. Jener langweilige Satz aus der Risikotabelle hat sich bewahrheitet.
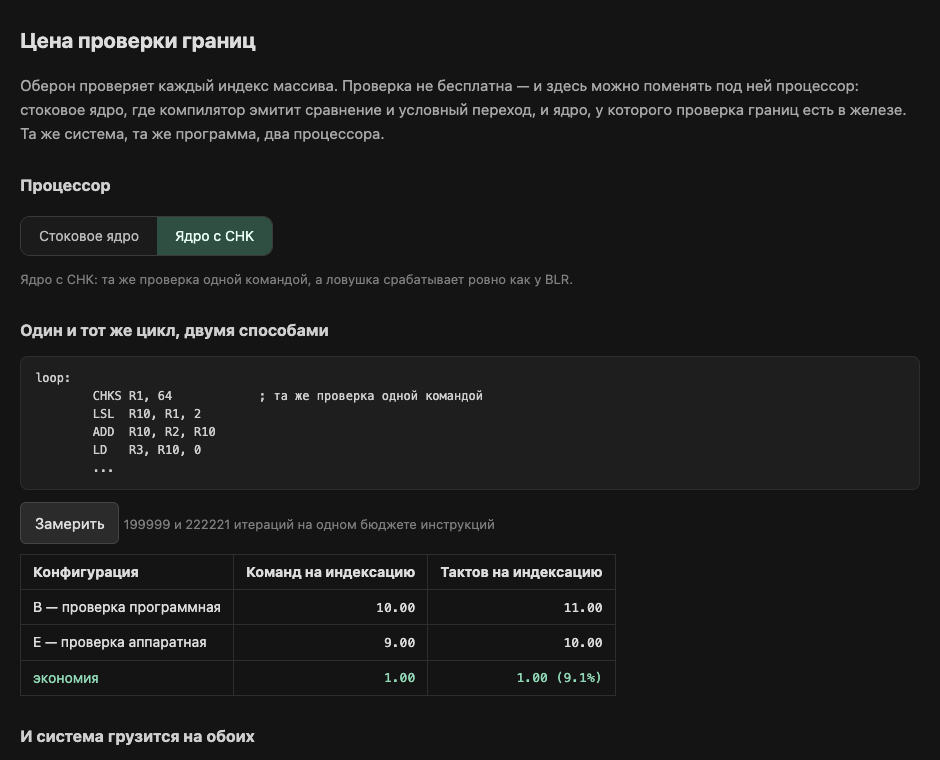
Die Seite, auf der man den Prozessor wechselt. Ein Kernumschalter und die Listings der beiden Varianten der Schleife.
Wie diese Messung anfangs um den Faktor zehn log
Und das Wichtigste, was diese Seite prüft, sind nicht einmal die Kosten der Prüfung. Das gewöhnliche System, ganz ohne neue Instruktionen, muss auf beiden Prozessoren exakt gleich booten, mit demselben Bild auf dem Bildschirm und derselben Anzahl ausgeführter Instruktionen. Verhalten sich die alten Programme nach dem Hinzufügen der neuen Instruktion auch nur ein wenig anders, dann habe ich die Kompatibilität gebrochen und eine andere Maschine erhalten.
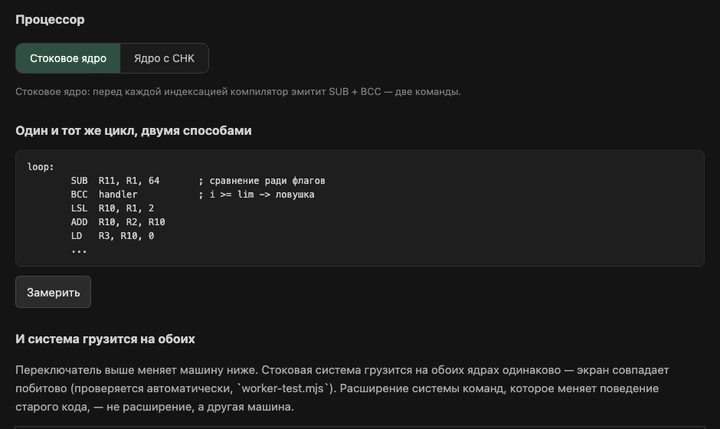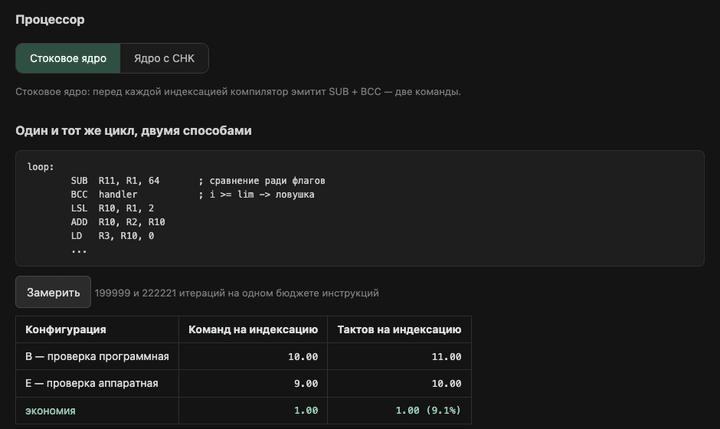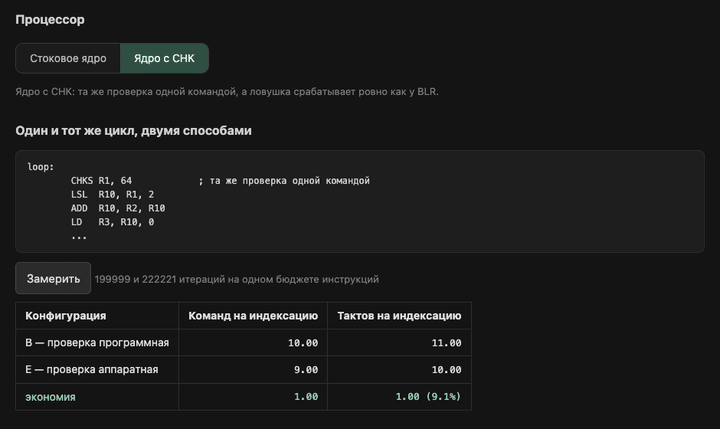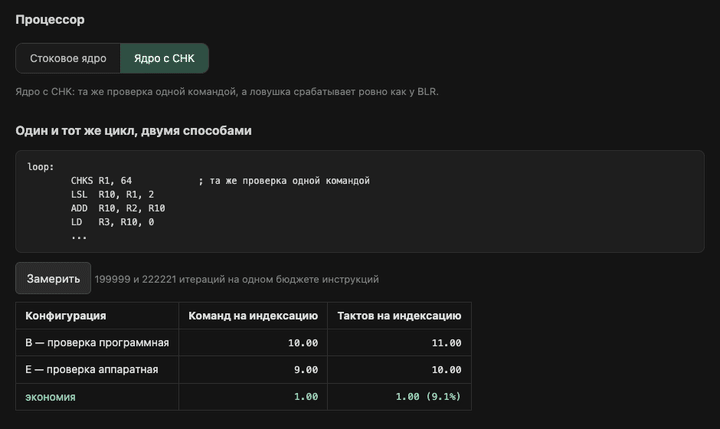
Eine Messung auf dem gewöhnlichen Kern, ein Wechsel zum Kern mit CHK und noch eine. Der Unterschied ist, wie versprochen, ein einziger Takt.
Dreizehn Laborübungen
Da die Maschine im Browser läuft, kann man an ihr lernen. Das Labor umfasst dreizehn Übungen, und jede wird von der Maschine geprüft, statt auf Treu und Glauben angenommen zu werden. Die Prüfung schaut in den Speicher, die Register oder die Festplatte des emulierten Computers selbst und sieht nach, ob Sie getan haben, was verlangt war. Die Übungen sind nach Stufen gegliedert: zuerst nur anschauen, dann verändern, kaputt machen, messen und schließlich selbst bauen.
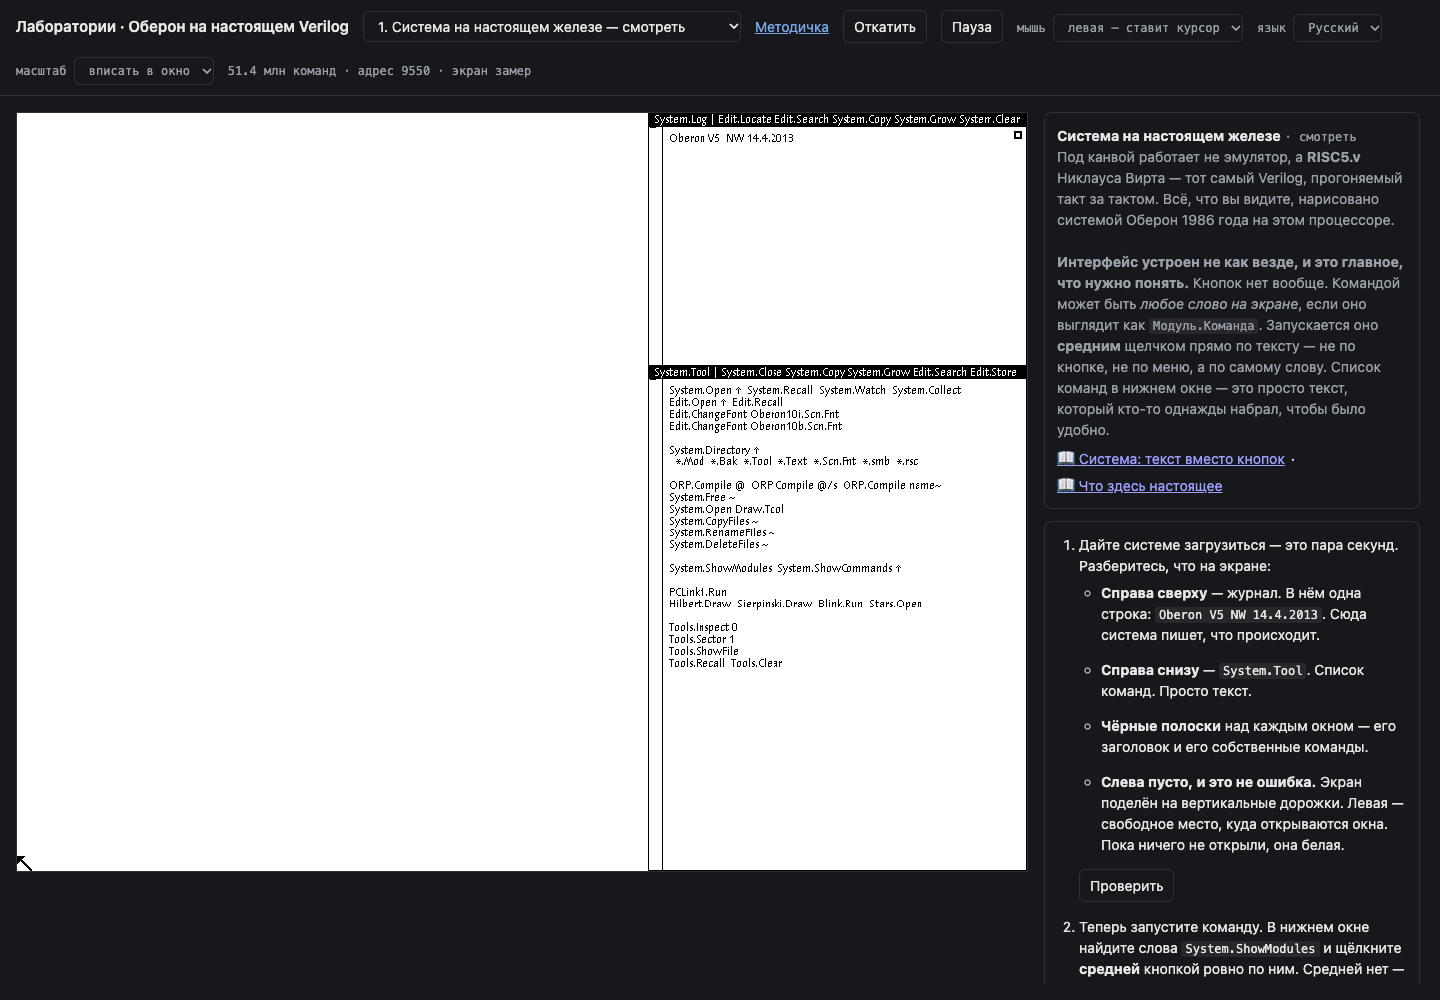
Das Labor. Links die Maschine, rechts die Übung und ein Prüfknopf, der direkt in den Speicher des emulierten Computers schaut.
Und so sieht die Oberfläche von Oberon in Aktion aus. Ein Mittelklick auf den Text System.ShowModules öffnet die Liste der geladenen Module, ein weiterer, auf Hilbert.Draw, zeichnet eine Hilbert-Kurve. Keine Buttons, nur Text:
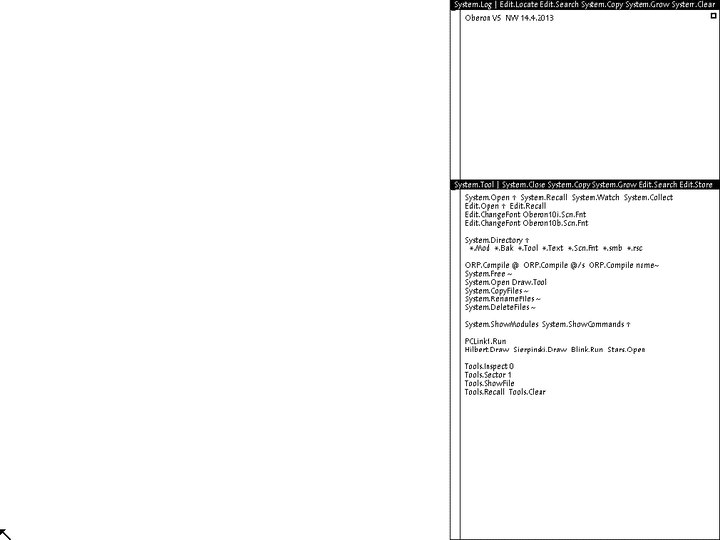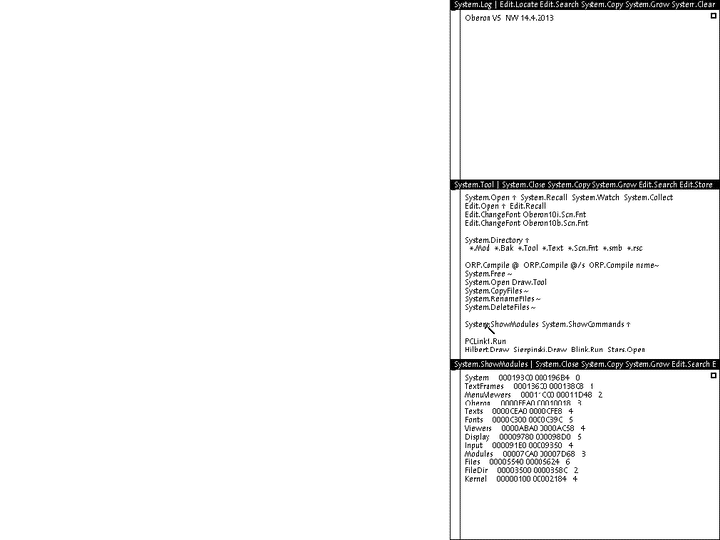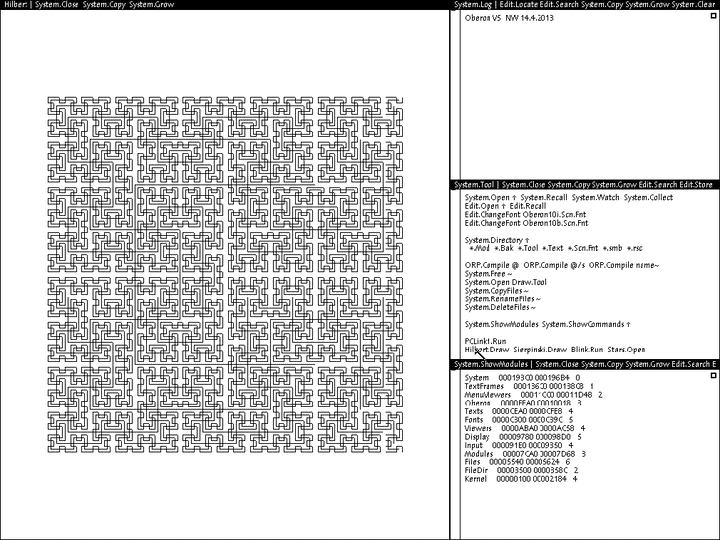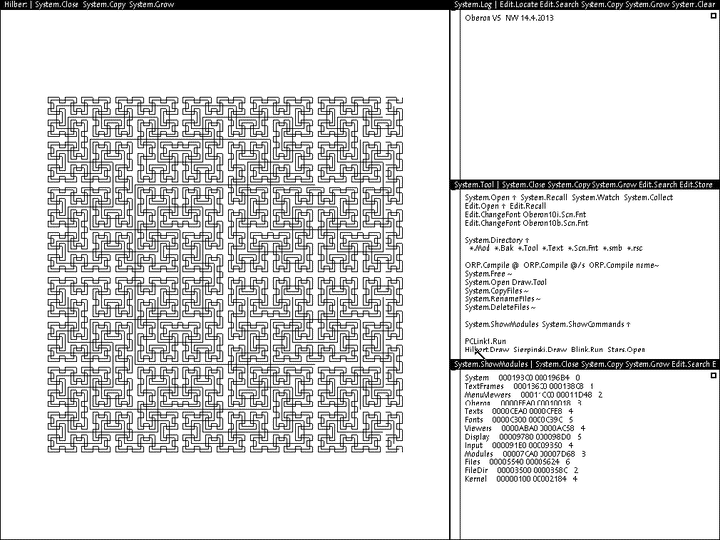
Ein Mittelklick auf Text – so startet man ein Programm.
| # | Übung | Stufe | Was Sie lernen |
|---|---|---|---|
| 1 | Das System auf echter Hardware | anschauen | dass unter dem Bild Wirths Schaltung läuft und wie eine Oberfläche aufgebaut ist, in der jeder Text ein Befehl sein kann |
| 2 | Ihr erstes Modul | anschauen | wie man im eingebauten Editor ein Programm eintippt, speichert und kompiliert |
| 3 | Der Schnittstellenschlüssel | verändern | warum Oberon keine Header-Dateien hat und wie sich das System vor inkompatiblen Modulen schützt |
| 4 | Hier gibt es keinen Speicherschutz | kaputt machen | was passiert, wenn man Müll direkt in den Bildschirmspeicher schreibt, und wie eine einzige Instruktion die Maschine sofort tötet |
| 5 | Wie viele Takte pro Instruktion | messen | warum man auf einer Maschine ohne Cache die Takte im Kopf zählen kann |
| 6 | Der Speicher geht mitten in einer Instruktion aus | kaputt machen | warum die Garbage Collection nur zwischen Instruktionen funktioniert |
| 7 | Das System baut sich selbst neu | bauen | wie man ein Modul innerhalb des Systems neu baut und die Inkonsistenz des Images mit eigenen Händen findet |
| 8 | Zwei Compiler-Generationen | anschauen | warum ein Compiler, der sich selbst baut, noch gar nichts beweist |
| 9 | Im Inneren des Compilers | verändern | wo im Compiler die Instruktionen des Prozessors entstehen |
| 10 | Der Garbage Collector von innen | anschauen | dass die Garbage Collection eine gewöhnliche Aufgabe ist, die das System etwa einmal pro Sekunde aufruft |
| 11 | Eine Aufgabe nach der anderen | kaputt machen | warum eine einzige hängende Aufgabe das ganze System anhält |
| 12 | Die Kosten einer Prüfung, von Hand | messen | wie man drei Varianten an einer eigenen Schleife misst – ohne Prüfung, in Software und in Hardware |
| 13 | Ihre eigene eingebaute Prozedur | bauen | wie man der Sprache eine neue eingebaute Prozedur hinzufügt, indem man den Compiler direkt im System neu baut |
Standardmäßig öffnet sich das Labor auf Englisch und wechselt per Button oder über einen Link mit ?lang=ru auf Russisch, die Wahl wird gespeichert. Daneben gibt es ein Handbuch mit acht Kapiteln, das damit beginnt, was hier echt ist, und damit endet, was wir gemessen haben; es gibt auch eine englische Fassung. Wenn Sie Rechnerarchitektur unterrichten und diese Übungen für sich übernehmen möchten, schreiben Sie mir, und ich helfe Ihnen beim Einrichten. Sie sind offen, und die Maschine lässt sich mit demselben Tag in Ihre eigene Seite einbetten.
Was mir die Laborübungen gezeigt haben
Der Garbage Collector in Oberon ist sehr faul. Er läuft nur, wenn der Benutzer zwanzig Aktionen geschafft hat oder der Speicher fast erschöpft ist, sodass ein paar hundert Kilobyte Müll unbegrenzt herumliegen können. Und er arbeitet nur zwischen Instruktionen, weil er den Stack nicht durchsuchen kann und alle lebenden Objekte ausschließlich über die globalen Variablen der Module findet.
Das automatische Tippen in einer der Übungen beschädigte stillschweigend das Programm. Wegen eines Fehlers in der Tastentabelle wurde die schließende Klammer nicht getippt, die Datei wurde aber problemlos gespeichert, sodass die Prüfung, die nur auf das Vorhandensein der Datei schaute, nichts bemerkte.
Und der Knopf, der die Maschine auf den Anfang zurücksetzt, funktionierte lange nicht, weil in Wirths Schaltung die Register des Prozessors beim Reset nicht genullt werden. Beim ersten Start nullt Verilator sie, bei einem weiteren bleibt drin, was drin war. Auf einem echten FPGA wäre es genauso, das ist also eine Krücke, die speziell mein Prüfstand braucht.
Eine eigene Blamage dieses Abschnitts ist, dass das Labor auf der Website eine Zeit lang tot war. Die Übungsliste war leer, und auf dem Bildschirm drehte sich ein ewiger Spinner. Zuerst fand und behob ich einen Fehler im Code der Seite, aber das half nicht. Die eigentliche Ursache war, dass in der Datei der Seite das schließende Tag eines Scripts fehlte. Ich hatte das für harmlos gehalten – der Browser verzeiht das schon – und sogar dem automatischen Check der Website beigebracht, es ebenfalls zu verzeihen. Nach dem HTML-Standard markiert der Browser ein Script jedoch, wenn eine Datei innerhalb eines nicht geschlossenen Scripts endet, als bereits ausgeführt und führt es schlicht nicht aus, ohne Fehler und ohne Warnung. Inzwischen öffnet der automatische Check die Website in einem echten Browser und verlangt, dass die Seite so viele Übungen hat wie die Quellen. Kurz: Ich sage nicht mehr, dass der Browser alles verzeiht.
Und was kostet die Prüfung auf modernen Prozessoren?
Schön – auf Wirths Prozessor kostet die Software-Prüfung zwei Takte von elf und die Hardware-Prüfung einen einzigen. Aber Wirths Prozessor ist eine sehr einfache Maschine, die eine Instruktion nach der anderen ausführt und nichts errät. Wie sieht es auf den Prozessoren in unseren Laptops und Servern aus?
Ich nahm dieselbe Array-Schleife und schrieb sie in C und in Rust in drei Varianten. In der ersten gibt es überhaupt keine Prüfung, in der zweiten ist sie so geschrieben, wie die Sprache selbst sie schreibt, und in der dritten ist es dem Compiler verboten, sie wegzuwerfen. Alle drei Varianten ließ ich überall laufen, wo ich hinkam. Gleich vorweg, weil man die Zahlen sonst nicht lesen kann: Die Schleife ist absichtlich so gewählt, dass sie für die Prüfung so günstig wie möglich ist. Das Array ist klein und liegt immer im schnellsten Speicher des Prozessors, und die Prüfung geht immer durch, sodass der Prozessor ihr Ergebnis leicht vorhersagen kann. Obendrein habe ich dem Compiler das Vektorisieren verboten – also mehrere Array-Elemente mit einer Instruktion zu verarbeiten –, obwohl Prüfungen in echtem Code vor allem deshalb teuer sind, weil sie genau dabei im Weg stehen. Ich wollte die Prüfung für sich sehen, ohne alles andere.
| Prozessor | Wie stark die Prüfung diese Schleife verlangsamt |
|---|---|
| RISC5, Software-Prüfung | um 22 % |
RISC5, neue Instruktion CHK | um 11 % |
| Apple M4 | nicht sichtbar, geht im Rauschen unter |
| AMD EPYC | nicht sichtbar, geht im Rauschen unter |
| Server-Arm Neoverse N2 | um 2–6 % |
| CHERIoT, Hardware-Prüfung | keine einzige zusätzliche Instruktion |
Erstens hat sich die Prüfung selbst in vierzig Jahren überhaupt nicht verändert – überall ist es derselbe Vergleich mit bedingtem Sprung wie auf Wirths Maschine. Zweitens kostete die Prüfung, so wie die Sprache sie schreibt, nirgends irgendetwas, denn moderne C- und Rust-Compiler fanden selbst heraus, dass der Index in dieser Schleife nie die Grenzen überschreitet, und warfen die Prüfung weg. Wirths Compiler kann das nicht; er lässt die Prüfung immer drin.
Und warum ist die Prüfung auf AMD und Apple unsichtbar, auf dem Server-Arm aber sichtbar? Das halte ich für das interessanteste Ergebnis der ersten Projekthälfte. Ein moderner Prozessor führt mehrere Instruktionen pro Takt aus und ordnet sie selbst um, damit alle seine Ausführungseinheiten beschäftigt sind. Hat ein Programm wenig Arbeit, fallen die zusätzlichen Prüfinstruktionen einfach in die freien Slots und kosten nichts, wie ein Fahrgast, der in einen halb leeren Bus steigt und niemanden bedrängt. Ich habe das überprüft, indem ich der Schleife schrittweise Arbeit und Prüfungen hinzufügte und beobachtete, ab wann die Prüfungen Zeit kosten. Auf AMD kosten eine oder zwei Prüfungen tatsächlich nichts, ab der vierten fangen sie an zu kosten. Auf dem Server-Arm fügt jede Prüfung von Anfang an ein wenig Zeit hinzu, weil dieser Kern weniger freie Slots hat. Wirths Prozessor hat überhaupt keine freien Slots – er führt eine Instruktion nach der anderen aus, und jede Prüfinstruktion ist ein Takt, der immer bezahlt wird.
Was CHERI macht
CHERI ist eine Architektur, in der ein Zeiger seine eigenen Grenzen kennt – er speichert also neben der Adresse, wo der Speicherbereich beginnt und endet, auf den er zugreifen darf, und der Prozessor prüft diese Grenzen bei jedem Speicherzugriff selbst. Ein solcher Zeiger ist doppelt so breit wie eine gewöhnliche Adresse, und ein Programm kann ihn nicht fälschen. Ich wollte CHERI auf dieselbe Leiter stellen, und zwar nicht auf einem großen, komplexen Prozessor, auf dem eine zusätzliche Instruktion alles Mögliche kosten kann, sondern auf dem nächsten Verwandten von Wirths Prozessor. Ich nahm CHERIoT-Ibex, einen einfachen 32-Bit-Kern, der ebenfalls Instruktionen eine nach der anderen ausführt und keinen Cache hat, und ließ dieselbe Schleife auf seiner Schaltung laufen.
Das Ergebnis war sehr aufschlussreich. Auf CHERI kostet die Prüfung in der Schleife keine einzige Instruktion, weil sie in den Speicherzugriff selbst eingebaut ist. Die Schleife mit Schutz ist exakt so lang wie die Schleife ohne. Um sicherzugehen, dass der Schutz wirklich greift, habe ich die Grenzen des Zeigers auf 32 Elemente verengt, und das Programm stürzte genau beim 33. ab. Eine Variante ohne Prüfung gibt es auf CHERI nicht und wird es nie geben, weil es schlicht nichts gibt, womit man sie abschalten könnte. Die veröffentlichten Arbeiten bestätigen das. Auf CHERI ist die Prüfung selbst nahezu kostenlos, bezahlt wird die Zeigerbreite, denn breite Zeiger belegen doppelt so viel Platz im Speicher und im Cache.
So entstand eine Leiter. Auf Wirths Prozessor kostet die Software-Prüfung zwei Instruktionen und zwei Takte, die neue Instruktion CHK eine Instruktion und einen Takt, und CHERI null Instruktionen. Die breiten modernen Prozessoren stehen abseits: Sie haben genauso viele Instruktionen wie Wirths, aber solange der Kern freie Slots hat, kosten diese Instruktionen fast nichts. Und zwischen CHK und CHERI klaffte auf dieser Leiter lange eine Lücke – die ich erst ganz am Ende dieser neun Tage geschlossen habe.
Wirths Maschine in QEMU
Der Browser ist wunderbar, aber ich wollte, dass Wirths Maschine dort lebt, wo gewöhnliche virtuelle Maschinen leben, mit eigener Konsole, Festplatten, Neustarts und allem, was zu einem richtigen Hypervisor gehört. Fast jede VM unter Linux wird auf die eine oder andere Weise von QEMU gestartet, einem Programm, das Computer der unterschiedlichsten Architekturen nachahmen kann. Wirths Prozessor ist natürlich nicht darunter, er musste also von Grund auf geschrieben werden – QEMU musste lernen, sämtliche Instruktionen von RISC5 und seine eigenwillige Gleitkommaarithmetik zu verstehen, und dann musste um den Prozessor herum ein Board zusammengebaut werden, mit Speicher, Festplatte, Tastatur, Maus und Bildschirm.
Wir hatten hier einen Vorteil, den fast niemand hat, der eine neue Architektur für QEMU schreibt. Normalerweise wird die Korrektheit einer solchen Arbeit gegen Dokumentation und Testsuiten geprüft, wir dagegen hatten die Schaltung des Prozessors selbst und einen Referenzemulator, der bereits über fünfzehn Millionen Instruktionen gegen sie geprüft war. Also prüften wir QEMU nicht gegen Papier, sondern gegen die Schaltung, Instruktion für Instruktion, mit derselben Lockstep-Technik. Über anderthalb Millionen Instruktionen des Bootvorgangs fand sich keine Abweichung, das Bild auf dem Bildschirm stimmte bis auf den letzten Punkt mit der Schaltung überein, und die Modulliste, die sich nach einem Klick auf System.ShowModules öffnet, war exakt dieselbe, mit denselben Adressen im Speicher. Die Zahl der dunklen Punkte auf dem Bildschirm nach dem Booten – 18.607 – wurde von da an meine Referenz, und wo auch immer die Maschine lief, verglich ich den Bildschirm damit.
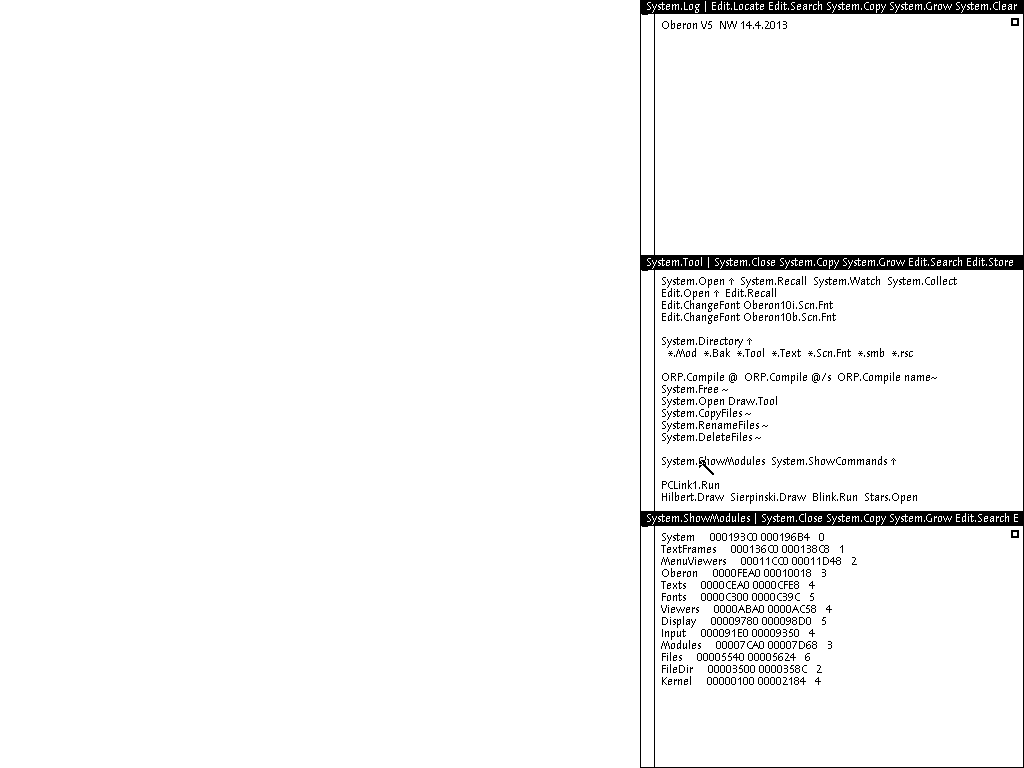
Ein Mittelklick auf System.ShowModules in QEMU. Dieselben Module an denselben Adressen wie auf Wirths Schaltung.
Eine Regel, die in keiner Beschreibung des Prozessors steht
Die erste Abweichung im Lockstep-Vergleich trat sehr früh auf, bei der zweihundertvierundzwanzigsten Instruktion, und der Bootloader war noch nicht einmal bis zu seinem ersten Festplattenzugriff gekommen. Wirths Prozessor, so stellte sich heraus, aktualisiert die Flags, die anzeigen, ob ein Ergebnis negativ und ob es null ist, bei jedem Schreiben in ein Register, auch wenn er bloß eine Zahl aus dem Speicher lädt. In der Beschreibung des Prozessors steht das nicht, in der Schaltung aber schon, und Wirths Bootloader verlässt sich darauf: Direkt nach dem Laden einer Zahl aus dem Speicher prüft er, ob sie null ist, ohne einen eigenen Vergleich durchzuführen. Wegen solcher Dinge prüft man gegen die Schaltung und nicht gegen die Dokumentation.
Die Gleitkommaarithmetik habe ich ebenfalls selbst umgesetzt, statt die fertige Version aus QEMU zu nehmen, denn Wirths Arithmetik ist nicht standardkonform. Sie rundet anders, behandelt sehr kleine Zahlen anders und so weiter, und eine Standardimplementierung würde plausible, aber andere Ergebnisse liefern. Der erste Vergleich zeigte ein paar Dutzend Abweichungen, und ich war schon dabei, meinen Code zu korrigieren, als sich der Vergleich selbst als falsch herausstellte – die Arithmetik hatte auf Anhieb gestimmt. Hätte ich ihm vertraut, hätte ich funktionierenden Code kaputt gemacht.
Bauen und starten lässt sich das so (ausführlich im QEMU-Leitfaden):
git clone https://github.com/tym83/paleocomputing && cd paleocomputing
make -C qemu build        # builds QEMU in a Docker container
docker create --name oberon-payload ghcr.io/tym83/paleocomputing/oberon-run:v0.1.17
docker cp oberon-payload:/opt/oberon/payload/prom.bin .
docker cp oberon-payload:/opt/oberon/payload/oberon.dsk .
docker rm oberon-payload
.qemu-work/build/qemu-system-risc5 -machine oberon -bios prom.bin \
  -drive if=none,id=sd0,file=oberon.dsk,format=raw -vnc :0
Der erste Befehl baut QEMU mit unserem Prozessor, die nächsten drei holen den Bootloader und die Systemfestplatte aus einem fertigen Image, und der letzte startet die Maschine. Den Bildschirm sehen Sie mit jedem VNC-Client unter 127.0.0.1:5900, und wenn Sie chk=on an -machine oberon anhängen, bekommen Sie den Prozessor mit der Hardware-Prüfung. Das Booten ohne Hardwarebeschleunigung dauert bis zu einer Minute, erschrecken Sie also nicht, wenn Sie zunächst nur den Bildschirm des Bootloaders sehen.
Warum das ein eigener Build ist und kein Patch für das Mainline-QEMU, sollte ich ebenfalls erklären. Die Projekte QEMU und libvirt nehmen keinen Code an, an dessen Entstehung ein Sprachmodell beteiligt war – selbst wenn das nur vermutet wird. Ich habe ein öffentliches Repository, in dem ehrlich steht, wie es entstanden ist, upstream kann das also nur gehen, wenn jemand den Code von Hand neu schreibt. Die GPL erlaubt einen eigenen Build ausdrücklich, und der schwierigste Teil der Arbeit – eine exakte Beschreibung des Prozessorverhaltens und eine Möglichkeit, jede Implementierung davon zu prüfen – bleibt ohnehin nützlich. Ein weiteres Ärgernis: Unser Prozessor ist gegen die allerneueste Entwicklungsversion von QEMU geschrieben, bereits veröffentlichte Versionen bauen ihn also nicht.
libvirt, das einem nicht aufs Wort glaubt
Die nächste Schicht ist libvirt. Das ist die Bibliothek, über die fast alles, was unter Linux VMs verwaltet, mit QEMU spricht, vom Kommandozeilenwerkzeug virsh bis zu KubeVirt, um das es gleich geht. Die Frage war, ob sich eine neue Architektur ganz ohne Änderungen anbinden lässt. Es ging nicht – aber nicht aus dem Grund, den ich erwartet hatte.
Zuerst trug ich einfach die Architektur risc5 in die Maschinenbeschreibung ein, und libvirt lehnte sofort ab mit dem Hinweis, eine solche Architektur kenne es nicht. Also wurde ich schlau, gab mich als eine Architektur aus, die es kannte, und schob ihm mein eigenes Programm unter. libvirt lehnte wieder ab, diesmal aber tiefer. Es traut nicht dem, was in der Maschinenbeschreibung steht, sondern fragt QEMU selbst, was es nachahmen kann, QEMU nennt sich ehrlich risc5, und diesen Namen gibt es in der Liste von libvirt nicht. Es über die Maschinenbeschreibung zu täuschen, ist unmöglich.
An einer Änderung an libvirt führt also kein Weg vorbei, und die Änderung war winzig – etwa zehn Zeilen an fünf Stellen. Ich habe es so gebaut, dass die Liste der Architekturen aus einer separaten Datei gelesen wird und die nächste alte Maschine eine neue Zeile in dieser Datei ist statt neuen Codes. Der Build prüft jede Änderung einzeln, denn eine Änderung, die sich stillschweigend nicht anwenden ließ, ist schlimmer als gar keine: libvirt würde ohne Fehler bauen, die Architektur aber nicht kennen. Das zahlte sich sofort aus, als in einer neuen Version von libvirt das betreffende Stück Code in eine andere Datei wanderte und der Build das laut verkündete, statt stillschweigend eine kaputte Bibliothek zu bauen.
Wie libvirt an einer ehrlichen Antwort abstürzte
Und gleich hier eine schöne Geschichte darüber, warum man seinen Augen nicht trauen darf. Der erste Screenshot unter libvirt sah völlig korrekt aus, aber ein byteweiser Vergleich mit der Referenz fand mehrere tausend Unterschiede. Ich verdächtigte nacheinander die Maus, den Zeitpunkt des Screenshots und libvirt selbst – dabei hatte ich schlicht die Adresse des Videospeichers falsch von hexadezimal nach dezimal umgerechnet und um 512 Byte danebengelegen. Das sind genau vier Bildschirmzeilen, und der Unterschied ist mit bloßem Auge völlig unsichtbar. Nach der Korrektur stimmte der Bildschirm Byte für Byte mit der Referenz überein.
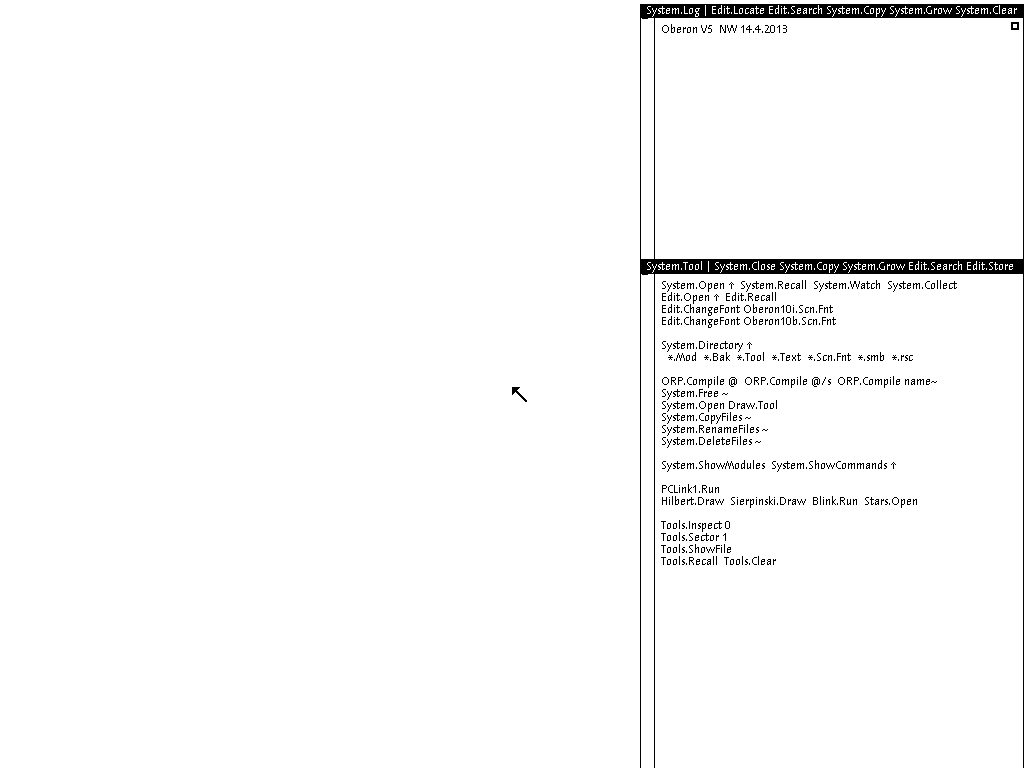
Oberon unter libvirt. Es sieht genau so aus wie mit der Verschiebung um 512 Byte, weshalb ich meinen Augen nicht mehr traue.
KubeVirt ohne Fork
Eine Schicht darüber sitzt KubeVirt. Es erlaubt, virtuelle Maschinen in Kubernetes genauso zu betreiben wie gewöhnliche Container und sie mit denselben Werkzeugen zu verwalten. Im Inneren hat jede solche VM einen Verwaltungs-Pod, und dort leben libvirt und QEMU. Ich musste eine Maschine mit einer völlig anderen Architektur dort hineinschmuggeln, und zwar ohne eine eigene Kopie von KubeVirt oder Cozystack anzulegen. Eine private Kopie eines großen Projekts bleibt für immer an einem hängen, und man muss sie bei jedem Update von Hand mitschleppen, deshalb wollte ich das unbedingt vermeiden.
Zu Hilfe kam ein Standard-Erweiterungspunkt, den nur wenige kennen. Bevor KubeVirt eine VM startet, kann es ihre Beschreibung an einen externen Handler übergeben und dann ausführen, was der Handler zurückliefert. Der Handler kann ein gewöhnliches Skript sein, das in der Kubernetes-Konfiguration liegt, man muss dafür also nicht einmal ein eigenes Image bauen. Unser Handler bekommt die Beschreibung einer ganz gewöhnlichen VM – mit Intel-Prozessor, Festplatten und Netzwerk – und formt sie zu Wirths Maschine um. Er ändert die Architektur, schaltet die Hardwarebeschleunigung ab (die es für eine fremde Architektur ohnehin nicht gibt), setzt unseren Emulator, Bootloader und unser Disk-Image ein und wirft alles hinaus, was Wirths Maschine nicht hat – also fast alles, was KubeVirt standardmäßig hinzufügt.
Den Emulator selbst und das gepatchte libvirt muss man allerdings in das Verwaltungs-Image legen, aus dem KubeVirt alle seine VMs startet. Alles andere erledigen KubeVirt und Cozystack selbst. Für Wirths Maschine braucht der Cluster also genau zwei Dinge, die ein gewöhnlicher Benutzer nicht tun kann: externe Handler erlauben und unser Verwaltungs-Image installieren. Der Administrator stimmt dem einmal zu, und danach installiert jeder Benutzer die Maschine aus dem Katalog, ungefähr so, wie man ein Treiberpaket installiert.
Die Absagen, die erst auf echtem KubeVirt auftauchen
Zuerst schickte ich die Beschreibung, die KubeVirt einer gewöhnlichen VM gibt, durch den Handler und fütterte libvirt auf meinem eigenen Schreibtisch mit dem Ergebnis. Alles startete, der Bildschirm stimmte mit der Referenz überein, und ich hielt die Sache für erledigt. Auf echtem KubeVirt in unserem Cozystack startete die Maschine nicht, und es gab vier Absagen, von denen keine einzige auf dem Schreibtisch aufgetaucht war.
Zuerst lehnte QEMU ab, weil KubeVirt verlangt, dass die Maschine Energieverwaltung unterstützt, die Wirths Maschine nicht hat. Dann lehnte es ab, weil KubeVirt verlangt, Prozessoren im laufenden Betrieb hinzufügen zu dürfen, Wirths Maschine aber einen Prozessor hat und nie mehr. Die dritte Absage war die lustigste. Ich entfernte den Abschnitt mit den Systeminformationen aus der Beschreibung, und nun fiel KubeVirt selbst um, weil es diesen Abschnitt nach dem Start liest. Ich setzte den Abschnitt wieder ein, und QEMU lehnte erneut ab, weil es solche Informationen für diese Architektur nicht unterstützt. Am Ende musste der Abschnitt bleiben, und eine kleine Einstellung musste weg – die, die libvirt veranlasst, ihn an QEMU weiterzugeben. Seitdem entferne ich genau das, was abgelehnt wird, und keine Zeile mehr, denn wer mit dem großen Besen kehrt, macht kaputt, was funktioniert hat. Und die vierte Absage kam, als ich KubeVirt aktualisierte, während unser Verwaltungs-Image noch für die vorherige Version gebaut war. Inzwischen wird das Image für jede unterstützte KubeVirt-Version separat gebaut.
Mit dem Verwaltungs-Image gab es noch eine stille Falle. Wir nehmen das Standard-Image von KubeVirt und ersetzen darin nur libvirt, und die Version unseres libvirt muss exakt der entsprechen, die bereits im Image steckt. Liegt man daneben, baut das Image ohne einen einzigen Fehler, aber unsere Bibliothek landet neben der Standardbibliothek statt an ihrer Stelle, und ausgeführt wird die Standardbibliothek. Deshalb prüft der Build inzwischen, dass im Image genau ein libvirt steckt, und die Zuordnung zwischen KubeVirt- und libvirt-Versionen ist in einer einzigen Datei festgehalten und lässt sich nicht von Hand setzen.
Sechzehn Sekunden bis zur clusterweiten Migration
Das ist wahrscheinlich die lehrreichste Geschichte des Projekts, und sie handelt von meiner eigenen Unaufmerksamkeit; der Code hat damit nichts zu tun.
Das Verwaltungs-Image, aus dem KubeVirt VMs startet, wird für den gesamten Cluster auf einmal festgelegt. Um es auszutauschen, änderte ich die KubeVirt-Konfiguration direkt im laufenden Cluster – unserem Arbeitsstand, auf dem unter anderem die VMs anderer Leute liefen. Sechzehn Sekunden später begann KubeVirt, sämtliche virtuellen Maschinen im Cluster auf das neue Image zu migrieren, ohne sie anzuhalten. Die Sache ist die: In Cozystack sind automatische Updates laufender Maschinen standardmäßig eingeschaltet, und KubeVirt tat genau, was man ihm gesagt hatte – da sich das Verwaltungs-Image geändert hatte, mussten alle Maschinen auf das neue umziehen. Im Laufe von fünf Stunden versuchte es mehr als hundertmal, Maschinen zu migrieren, und mehr als die Hälfte der Versuche scheiterte. Nichts stürzte ab und keine Daten gingen verloren, und die erfolgreichen Migrationen zeigten nebenbei, dass unser Image Maschinen migrieren kann – aber ein schönes Bild war das nicht. So habe ich es gestoppt:
kubectl -n cozy-kubevirt patch kubevirt kubevirt --type=merge \
  -p '{"spec":{"workloadUpdateStrategy":{"workloadUpdateMethods":[]}}}'
Dieser Befehl schaltet automatische Updates der Maschinen ab, ist aber eine Notbremse und keine Lösung. Er bricht bereits laufende Migrationen nicht ab, die Einstellung kommt beim nächsten Cozystack-Update zurück, und ganz ohne automatische Updates auszukommen, ist ebenfalls schlecht, denn nach einem KubeVirt-Update blieben die Maschinen auf dem alten Verwaltungs-Image. Am ärgerlichsten an dieser Geschichte ist, dass ich wusste, wo ich hätte nachsehen müssen. Ich habe nur geprüft, dass das neue Image existiert, und nicht daran gedacht zu prüfen, was es mit dem Cluster anstellen würde.
Warum die Hälfte der Migrationen scheiterte, wurde aus den Logs klar, und mit dem Image hatte das nichts zu tun. Standardmäßig migriert KubeVirt nicht mehr als zwei Maschinen gleichzeitig von einem Server weg; die übrigen warten, bis sie an der Reihe sind, und kommen oft gar nicht dran. Auch Quotas standen im Weg. Während einer Migration existiert eine Maschine gleichzeitig in zwei Kopien und belegt doppelt so viel Speicher, eine Maschine, die das gesamte Quota ihres Benutzers aufgebraucht hat, wird also nie live migriert. Das Quota braucht Spielraum, mindestens so viel wie die größte Maschine.
Ein Katalog für Cozystack
Cozystack ist eine offene Plattform, aus der man auf Basis von Kubernetes seine eigene Cloud zusammenbaut. Wir bei Ænix entwickeln sie gemeinsam mit der Community, und sie gehört zur CNCF, der Foundation, in der auch Kubernetes selbst zu Hause ist. Die Plattform hat eine Weboberfläche, Benutzer – hier Tenants genannt (so etwas wie getrennte Konten in einer Cloud) –, virtuelle Maschinen und einen Anwendungskatalog mit Datenbanken, Kubernetes-Clustern, Caches und so weiter. Und vor Kurzem ist in der Community ein Mechanismus für einsteckbare Kataloge entstanden. Jeder kann seinen eigenen Satz Anwendungen veröffentlichen und in seine Plattform einbinden, und dann erscheinen diese Anwendungen für die Benutzer neben den eingebauten. Für Paleocomputing habe ich genau einen solchen Katalog gebaut und dabei nichts erfunden, was es in der Plattform nicht schon gibt.
Der Katalog ist in vier Teile gegliedert, weil man ihnen unterschiedlich weit vertrauen muss. Der erste enthält die Maschinen und Umgebungen für die Benutzer – die echte VM mit Wirths Prozessor, das Browser-Labor, das Handbuch und ein Bundle, das alles auf einmal installiert. Der zweite enthält die Oberon-Sprachumgebung, in der man Oberon-Programme als gewöhnliche Jobs im Cluster ausführen kann. Der dritte legt Boot-Images in den gemeinsamen Speicher der Plattform, und der vierte tauscht jenes Verwaltungs-Image von KubeVirt aus. Diese beiden letzten betreffen den gesamten Cluster und werden deshalb nur mit ausdrücklicher Zustimmung des Administrators installiert.
Eingebunden wird der Katalog so:
cozypkg tap oci://ghcr.io/tym83/paleocomputing/machines:v0.1.17
cozypkg tap oci://ghcr.io/tym83/paleocomputing/languages:v0.1.17
cozypkg add paleocomputing.machines
cozypkg add paleocomputing.languages
# what touches the whole cluster is installed only with the administrator's explicit consent
cozypkg tap oci://ghcr.io/tym83/paleocomputing/images:v0.1.17
cozypkg tap oci://ghcr.io/tym83/paleocomputing/platform:v0.1.17
cozypkg add paleocomputing.platform --allow-privileged
Der Befehl tap bindet den Katalog nur in die Plattform ein; add installiert seinen Inhalt. Dieser Unterschied hat auch mich einmal verwirrt, und anfangs stand er überhaupt nicht in der Dokumentation.
Bevor Sie den letzten Teil installieren, schauen Sie sich unbedingt die Einstellung für automatische Maschinen-Updates in KubeVirt an. Mit den Standardeinstellungen von Cozystack schickt eine Änderung des Verwaltungs-Images jede VM im Cluster auf Migration, und zwar bei der Installation, bei der Deinstallation und bei jedem KubeVirt-Update. Genau das ist mir passiert. Dieses Loch hat einer der Reviewer beim Prüfen genau dieses Artikels gefunden; ist das automatische Update eingeschaltet, ändert die Komponente deshalb jetzt nichts und wartet, bis der Administrator die Migration ausdrücklich erlaubt. Erlauben lässt sie sich mit der Einstellung allowWorkloadUpdate: true bei der Installation oder mit der Annotation paleocomputing.io/allow-workload-update=true an der KubeVirt-Ressource. Und noch etwas. Das Werkzeug zum Einbinden von Katalogen prüft die digitale Signatur bisher nicht; wenn Sie das also irgendwo installieren, wo es ernster zugeht als auf einem Heim-Prüfstand, prüfen Sie die Signatur selbst – wie, steht in der Anleitung.
Nach dem Einbinden erscheint in den Katalogen der Benutzer ein eigener Bereich Paleocomputing. Allerdings gibt es einen Haken, auf den ich beim Anfertigen der Screenshots für diesen Artikel gestoßen bin. Die aktuelle Weboberfläche von Cozystack zeigt in ihrer Seitenleiste nur drei Bereiche – die, die fest in ihren Code eingebaut sind – und versteckt alle übrigen ganz am Ende der vollständigen Anwendungsliste. Zuerst fand auch ich meinen eigenen Bereich nicht. Dabei ist der ganze Sinn eines einsteckbaren Katalogs, eigene Bereiche mitzubringen, statt sich in fremden aufzulösen. Wir werden das also in Cozystack selbst beheben, und die Oberfläche wird alle Bereiche anzeigen müssen, die ein Katalog mitbringt.
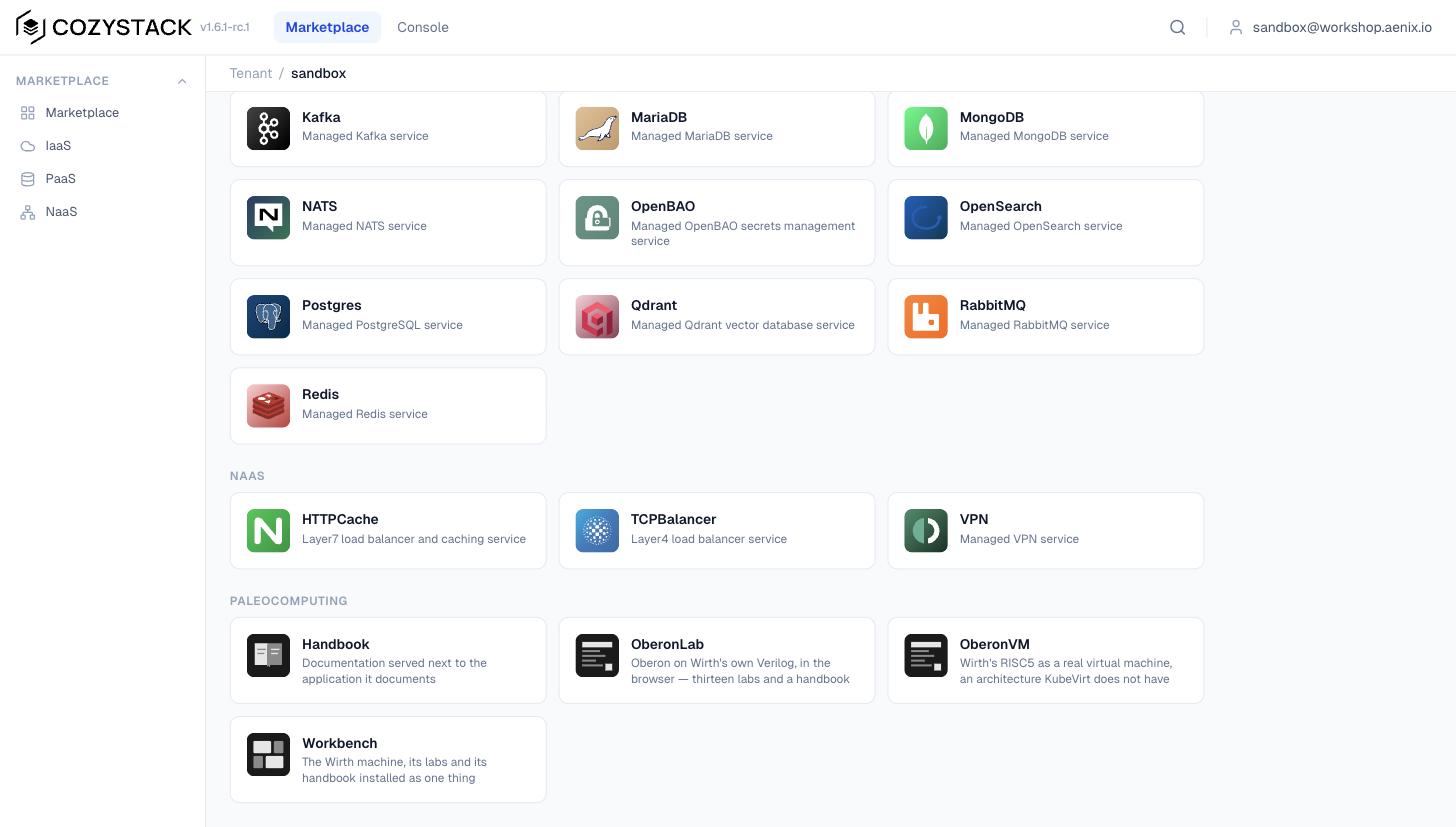
Der Bereich Paleocomputing in der vollständigen Anwendungsliste. In der Seitenleiste ist er noch nicht; das beheben wir in Cozystack.
Installiert wird die Maschine über ein Formular in der Weboberfläche oder mit einer kurzen Beschreibung:
apiVersion: apps.cozystack.io/v1alpha1
kind: OberonVM
metadata:
  name: wirth
spec:
  memory: 128Mi
  hardware: chk     # or base, the ordinary Wirth processor
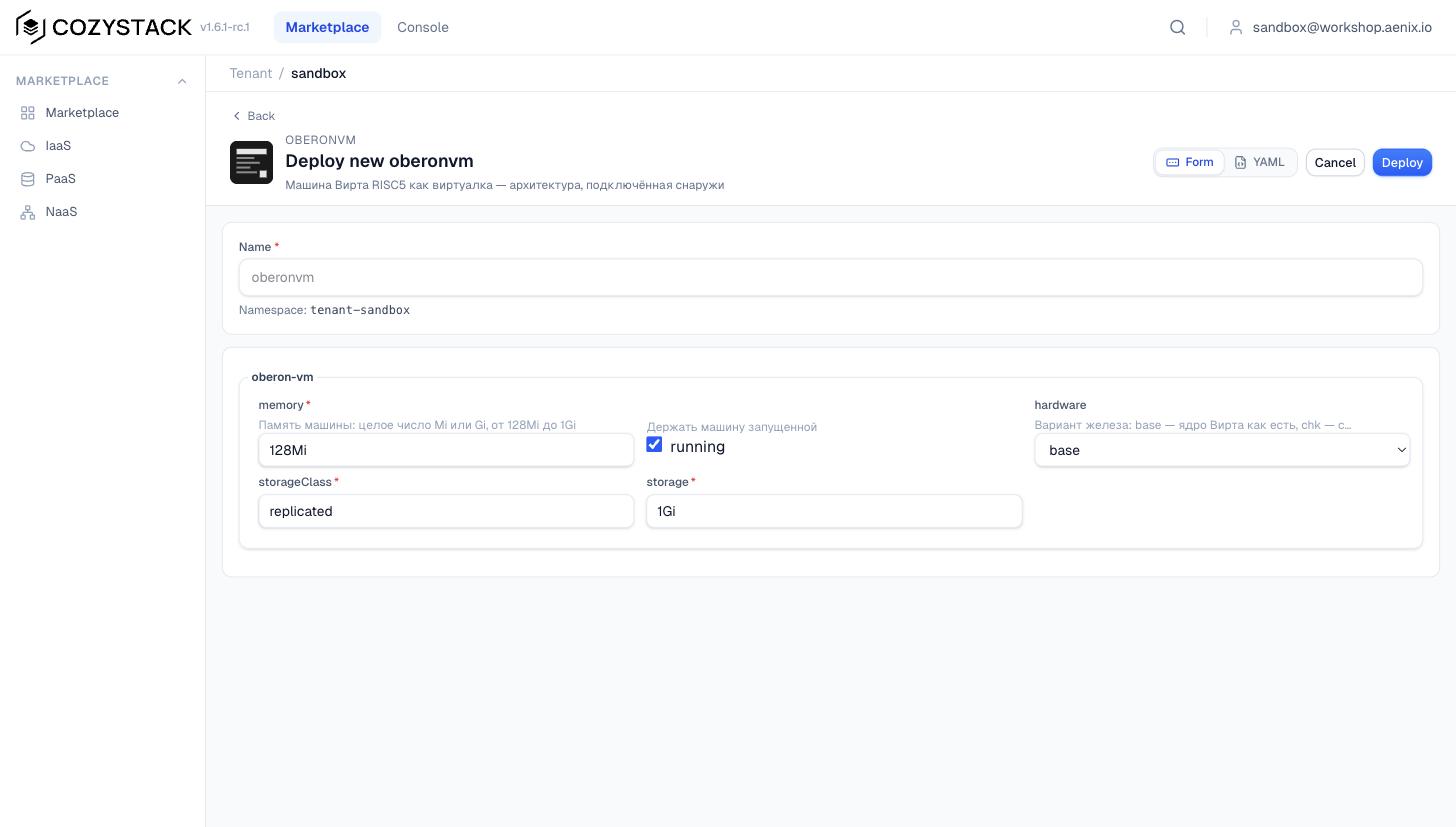
Das OberonVM-Formular: Speicher, Prozessorvariante und Festplattengröße. Das ist die ganze Maschine.
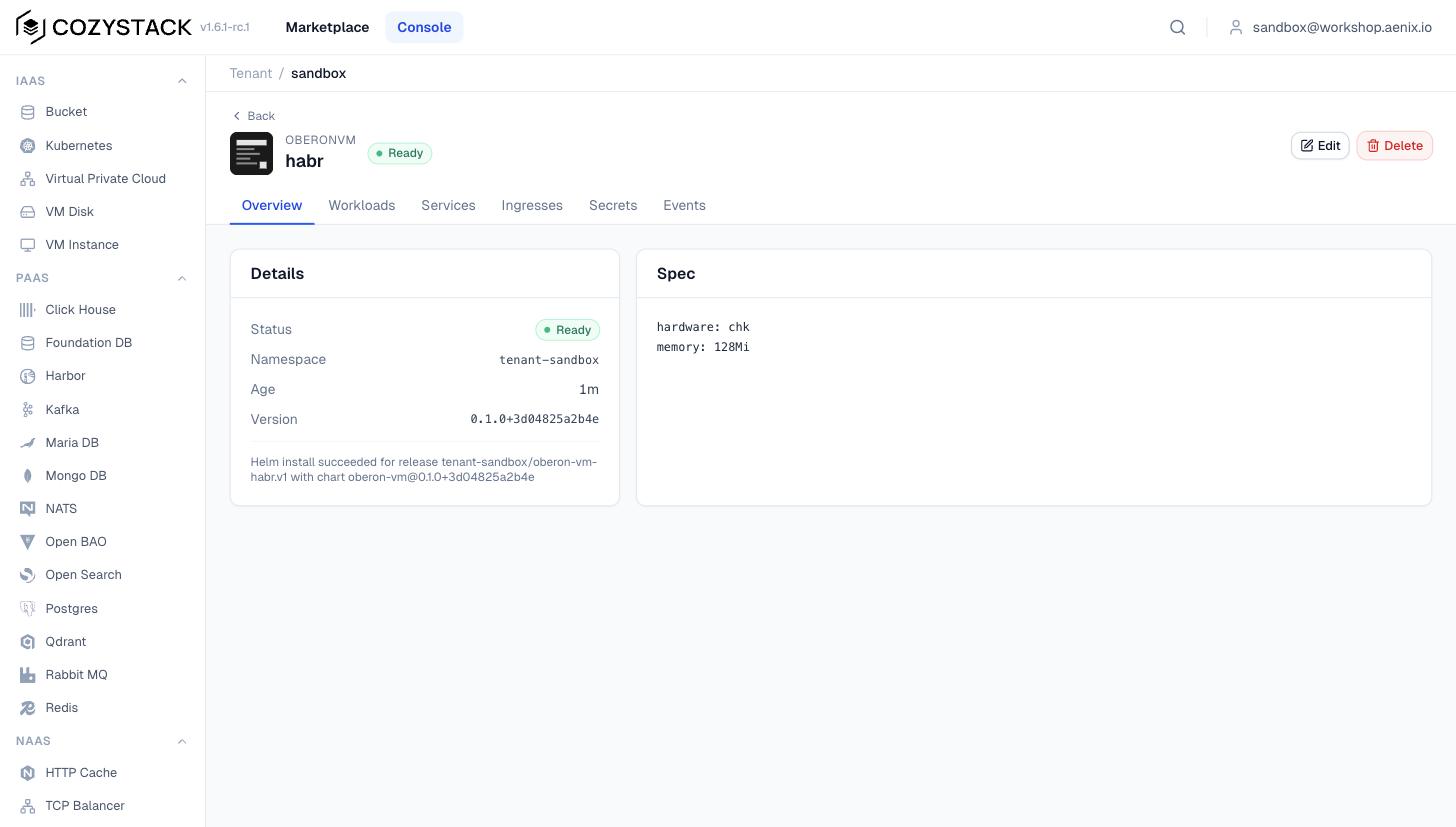
Die fertige Maschine in der Oberfläche, mit ihrem Status und einer Liste dessen, was darunter läuft.
Einen Bildschirm für die Maschine gibt es in der Weboberfläche noch nicht; in den aktuellen Versionen haben ihn nur gewöhnliche VMs. Ansehen können Sie sie mit dem Werkzeug virtctl, mit den Rechten des Benutzers selbst und einem beliebigen VNC-Client:
virtctl -n tenant-sandbox vnc oberon-vm-oberon-vm-habr
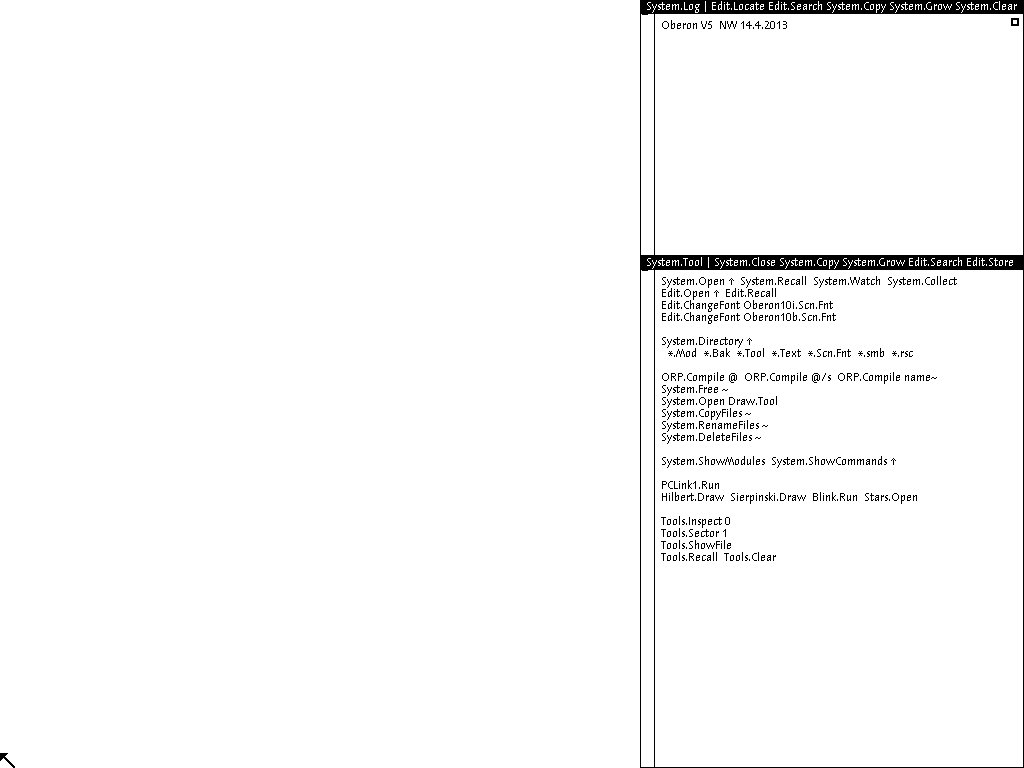
Wirths Maschine in der Cloud, aufgenommen mit den Rechten eines gewöhnlichen Benutzers. Genau dieselben 18.607 dunklen Punkte.
Das Ganze ist so angelegt, dass die nächste alte Maschine keinen neuen Code erfordert. Alles, was Wirths Maschine von den anderen unterscheidet, steht in einer kleinen Datei, die ich den Pass der Maschine nenne: Architektur, Emulator, Bootloader, Festplatte, Prozessorvarianten und Speichergrenzen. Alles andere ist gemeinsam, und der Handler für KubeVirt ist für alle Maschinen ein und derselbe – er liest einfach den Pass. Die nächste Maschine, etwa Lilith, ist ein neuer Pass und keine Kopie des Codes. Um zu beweisen, dass das kein leeres Gerede ist, enthalten die Tests eine zweite, fiktive Maschine mit anderer Architektur, und sie baut ohne eine einzige Änderung am Code.
Wie der Pass einer Maschine aussieht
kind: Machine
name: oberon
image: ghcr.io/tym83/paleocomputing/oberon-run:v0.1.17
domain:
  arch: risc5
  machine: oberon
  emulator: /usr/local/bin/qemu-system-risc5
  vcpus: 1
  graphics: vnc
  terminationGracePeriodSeconds: 0
payload:
  path: /payload
  files:
    - {name: prom.bin,   role: firmware, qemu: ["-bios", "{path}"]}
    - {name: oberon.dsk, role: disk,     qemu: ["-drive", "if=none,id=sd0,file={path},format=raw"]}
variants: {base: {}, chk: {chk: "on"}}
memory: {default: 128Mi, min: 128Mi, max: 1Gi}
Die Zeit für ein ordentliches Herunterfahren ist hier auf null gesetzt, weil Wirths Maschine eine Aufforderung zum Herunterfahren nicht hören kann und KubeVirt bei jedem Neustart vergeblich eine halbe Minute darauf warten würde. Der Bootloader wird bei jedem Katalog-Update durch einen neuen ersetzt, die Festplatte dagegen wird einmal angelegt und gehört danach dem Benutzer, sodass ihre Dateien Updates überstehen.
Alles grün, und nichts funktioniert
Während ich mit dem Cluster hantierte, tauchte dieselbe Falle an einem Abend sechsmal auf, und ich legte eine Notiz mit genau diesem Titel an. Jedes Mal meldete ein Check Erfolg, während in Wirklichkeit nichts funktionierte. Der Katalog ist gebaut, aber die Hauptdatei steckt nicht darin. Die Installation war erfolgreich, aber die Maschine läuft nicht. Der Server antwortet, alles sei in Ordnung, aber das Image enthält die Maschine selbst nicht. Der Build ist grün, aber die Datei, die kopiert wird, existiert nicht. Dann gab es noch ein siebtes Mal – eben jene sechzehn Sekunden.
Was sich erst auf einem lebenden Cluster zeigt
Das Image des Browser-Labors wurde lange ohne die Maschine selbst veröffentlicht. Die Seite war da, Prozessor und Festplatte nicht, und der Check gab sich damit zufrieden, dass die Seite ausgeliefert wurde. Nebenbei entdeckte ich, dass wegen einer einzigen Zeile in der Liste ignorierter Dateien und der Tatsache, dass das Dateisystem des Mac nicht zwischen Groß- und Kleinschreibung unterscheidet, eine komplette Sprachbibliothek mit einundvierzig Dateien es nie ins Repository geschafft hatte.
Die Maschine mit dem Prozessor mit Hardware-Prüfung startete, lief aber tatsächlich auf dem gewöhnlichen. Das Paket für Cozystack enthielt, wie sich herausstellte, eine eigene Kopie des Handlers, und ich hatte eine andere bearbeitet. Inzwischen vergleicht der automatische Check die Kopien.
Der Bildschirm der Maschine in Kubernetes war anfangs leer, weil der Handler die Bildausgabe zusammen mit allem anderen Überflüssigen hinausgeworfen hatte. Als ich sie zurückholte, startete QEMU nicht mehr, weil die Tastaturbelegungen nicht ins Image gelegt worden waren.
Eine Verwaltungsaufgabe hing ganz ohne Fehler. In Cozystack dürfen nur Pods mit einem speziellen Label den Kubernetes-Control-Plane-Server erreichen, und den übrigen antwortet die Netzwerkschicht stillschweigend nicht. Wären es fehlende Berechtigungen gewesen, wäre die Absage sofort gekommen, das Hängen selbst war also der Hinweis.
Und bei der digitalen Signatur passte keines meiner Releases zu dem, was der Community-Katalog erwartet, denn der Katalog erwartet eine Signatur aus einem Build vom Hauptzweig, ich aber hatte per Tag veröffentlicht. Gefunden habe ich das beim Lesen der Quellen des Werkzeugs, das, wie ich feststellte, die Signatur überhaupt nicht prüft.
Am Abend des 27. September gab es eine Episode, für die ich mich bis heute ein wenig schäme. Wir bauten gerade um, wie die Maschine im Cluster beschrieben wird, und die Releases kamen in einer Schlange. Das erste blieb an seinen eigenen Checks hängen. Das zweite hing mausetot, weil die Aufgabe, die die Festplatte der Maschine vorbereitet, darauf wartete, dass die Maschine startet, und die Maschine auf die Festplatte wartete. Das dritte fand zwei weitere Bugs. An diesem Punkt riss mir der Geduldsfaden, und ich fragte den Agenten, warum wir ein Release nach dem anderen ausliefern und ob er die Dinge nicht einfach beim ersten Mal ordentlich prüfen könne (im Original war das deutlicher formuliert).
Er konnte, und danach änderte sich der Release-Prozess. Inzwischen wird jede Änderung zuerst als Testversion gebaut, eine separate Sandbox im Cluster wechselt auf sie, und ein Szenario installiert in der Rolle eines gewöhnlichen Benutzers die Maschine, prüft, dass sie auf dem richtigen Prozessor gestartet ist, vergleicht den Bildschirm mit der Referenz, startet sie neu, löscht sie und bestätigt, dass nichts zurückgeblieben ist. Nur wenn all das durchgeht, landet die Änderung im Hauptzweig und wird zum Release. Ein zweites solches Szenario prüft die Komponente, die das Verwaltungs-Image austauscht, und startet zur Sicherheit ein gewöhnliches Ubuntu auf unserem Image, um zu bestätigen, dass wir die Nachbarn nicht kaputt gemacht haben. Das erste Release, das all das vor der Veröffentlichung bestand, war v0.1.14, und die hängengebliebenen Maschinen kamen danach von selbst hoch.
Amüsanterweise hatte das Szenario selbst eigene Bugs, obwohl das System funktionierte. Zum Beispiel wurde der Start von Ubuntu anfangs über ein Hilfsprogramm im Gast geprüft, das es in einem sauberen Ubuntu-Image schlicht nicht gibt, der Check hätte also ewig gewartet. Dann wurde er über den Login-Prompt auf der Konsole geprüft, und eine Konsole ohne echtes Terminal bleibt stumm. Und die Wartefunktion zählte nur die Pausen, nicht die insgesamt vergangene Zeit, sodass aus zwanzig Minuten Warten zwei Stunden wurden. Das Skript wartete sehr geduldig neben einem längst gebooteten Ubuntu.
Die Komponente, die das Verwaltungs-Image überwacht
Das Verwaltungs-Image von KubeVirt von Hand auszutauschen, ist aus drei Gründen eine schlechte Idee. Es wird von allen VMs des Clusters gemeinsam genutzt, ein Fehler macht also alle kaputt. Es muss zur KubeVirt-Version passen und bleibt nach einem Cozystack-Update alt und macht dann alle Maschinen kaputt. Und meine erste manuelle Methode hat nebenbei mehrere andere KubeVirt-Einstellungen eingefroren, die ich gar nicht anfassen wollte.
Deshalb hat der Katalog eine eigene Komponente, die alle halbe Minute in die KubeVirt-Konfiguration schaut und ihren eigenen Teil in Ordnung bringt. Haben wir ein Image für die aktuelle KubeVirt-Version, installiert sie es. Wenn nicht, entfernt sie ihre Änderung, und der Cluster kehrt zum Standard-Image zurück. Wirths Maschinen starten dann nicht, aber alles andere funktioniert. Sieht irgendetwas fragwürdig aus, entfernt sie ihre Änderung ebenfalls, und konnte sie die Konfiguration nicht lesen, fasst sie nichts an. Ihre Änderung nimmt sie so vor, dass sie, falls KubeVirt jemals die Form seiner Konfiguration ändert, das Image nicht an die falsche Stelle setzt, sondern sich lautstark weigert, angewendet zu werden.
Und auch diese Komponente hat die Sandbox erwischt. Auf dem lebenden Cluster stürzte sie ab, weil sie einem der Werkzeuge Informationen über alle Server des Clusters auf einmal übergab, und auf einem echten Cluster sind diese Informationen riesig. In den Tests waren die Server winzig, und der Testcluster bestand aus einem einzigen, deshalb stürzte dort nichts ab. Inzwischen wird ein Test mit einem Cluster aus dreitausend großen Servern auf dem alten Code rot.
Server mit Intel und mit Arm
Als ich anfing, das alles auch für Arm-Server zu bauen, wurde ich gefragt, wozu überhaupt Builds für verschiedene Prozessoren nötig seien, wenn wir die Oberon-Architektur doch schon zu KubeVirt hinzugefügt haben. Eine gute Frage, und die Verwirrung ist natürlich, denn hier gibt es zwei Architekturen. Die eine ist die Architektur von Wirths Maschine, die QEMU nachahmt, und sie hängt nicht vom Server ab. Die andere ist der echte Prozessor des Servers, Intel oder Arm. Der Emulator und libvirt sind gewöhnliche Programme und müssen für jeden Serverprozessor separat gebaut werden. Das ist wie bei einem Emulator für eine Spielkonsole: Die Konsole ist eine, aber die Builds des Emulators für Windows und für Mac sind verschiedene.
Unser Verwaltungs-Image war nur für Intel gebaut. Und da es für jede VM im Cluster das Standard-Image ersetzt, würde auf einem Cluster aus Arm-Servern keine einzige Maschine starten – nicht nur Oberon. Der Arm-Build ging sofort durch, der eigentliche Start auf Arm blieb aber dreimal stecken. Zuerst, weil das Image mit Bootloader und Festplatte nur für Intel existierte. Dann, weil eines der Build-Werkzeuge ebenfalls nur für Intel veröffentlicht wird. Und das dritte Problem war das interessanteste. Auf Arm gibt KubeVirt einer VM immer moderne Firmware mit eigenem Flash-Speicher, und Wirths Maschine hat überhaupt keinen Flash-Speicher, also beendete sich QEMU sofort nach dem Start. Auf Intel sieht man das nicht, weil dort die Standard-Firmware eine andere ist. Keines dieser drei Probleme war im Code oder im gebauten Image zu sehen – nur auf einem lebenden Server mit dem richtigen Prozessor.
Inzwischen funktioniert all das auf zwei KubeVirt-Versionen und auf beiden Prozessortypen, und der Bildschirm stimmt in allen vier Kombinationen mit der Referenz überein. Der Fairness halber sei gesagt, dass ich auf Arm reines KubeVirt in einem Wegwerf-Testcluster getestet habe; Cozystack auf Arm-Servern habe ich noch nicht laufen lassen.
Wie man die Maschine ohne Cozystack auf dem eigenen KubeVirt installiert
All das funktioniert auch auf gewöhnlichem KubeVirt, ohne Cozystack, und der automatische Check beweist es bei jeder Änderung. Er fährt einen Wegwerf-Cluster hoch, installiert KubeVirt, tauscht das Verwaltungs-Image aus, startet die Maschine und vergleicht den Bildschirm. Eine ausführliche Anleitung steht in kubevirt/GUIDE.md; kurz gesagt sind es drei Schritte:
# 1. allow external handlers (on servers without /dev/kvm you also need useEmulation: true)
kubectl -n kubevirt get kubevirt kubevirt -o json \
  | jq '.spec.configuration.developerConfiguration.featureGates |= ((. // []) + ["Sidecar"] | unique)' \
  | kubectl replace -f -

# 2. install the housekeeping image for your KubeVirt version
git clone --depth 1 -b v0.1.17 https://github.com/tym83/paleocomputing && cd paleocomputing
KV=$(kubectl -n kubevirt get kubevirt kubevirt -o jsonpath='{.status.observedKubeVirtVersion}')
echo "$KV ghcr.io/tym83/paleocomputing/virt-launcher:$KV-paleo-v0.1.17" > /tmp/launchers.txt
kubectl -n kubevirt create configmap kubevirt-paleo-launcher-status
export KUBECTL=kubectl KUBEVIRT_NAMESPACE=kubevirt LAUNCHER_TABLE=/tmp/launchers.txt
R=marketplace/repos/platform/packages/system/kubevirt-paleo-launcher/files/reconcile.sh
until sh $R once && [ "$(kubectl -n kubevirt get cm kubevirt-paleo-launcher-status \
  -o jsonpath='{.data.state}')" = Applied ]; do sleep 10; done

# 3. install the machine with ordinary Helm and open its screen
python3 marketplace/tools/pin-images.py --release v0.1.17
helm install wirth marketplace/repos/machines/packages/apps/oberon-vm \
  -n oberon --create-namespace --set storageClass=<your StorageClass>
virtctl -n oberon vnc oberon-vm-wirth
Bedenken Sie, dass das Erlauben externer Handler im gesamten Cluster wirkt und jeder, der VMs direkt anlegen kann, ihnen seinen eigenen Handler unterschieben kann. Auf einem gemeinsam genutzten Cluster sollte man das abwägen. Und an die automatischen Maschinen-Updates aus der Geschichte oben sollte man auch hier denken.
Die zweite Folge: ein Sprachmodell auf Wirths Prozessor
Erinnern Sie sich an die Behauptung aus jenem allerersten Plan, eine neue Instruktion, die in einem Zug multipliziert und addiert, würde die Geschwindigkeit eines neuronalen Netzes auf Wirths Prozessor verdoppeln? Die Reviewer haben sie zerlegt, aber in meiner Liste aufgeschobener Aufgaben blieb danach eine Zeile mit ihren Schätzungen stehen. Die neue Instruktion würde nach ihrer Rechnung ein paar Prozent bringen, ein schneller Multiplizierer mehr als das Anderthalbfache. Das klang nach einem Ergebnis, aber hinter diesen Zahlen standen weder ein Programm noch eine Möglichkeit, sie nachzuvollziehen – nur Arithmetik anhand der Takttabelle. Ich wollte das von Anfang an von Hand überprüfen.
Die Aufgabe lief auf Folgendes hinaus. Ein kleines Sprachmodell sollte im Oberon-System selbst laufen. Ein Programm in Oberon, übersetzt mit dem systemeigenen Compiler, liest die Gewichte des Modells aus einer Datei und gibt Text aus, und all das läuft auf Wirths echter Schaltung, Takt für Takt. Und dann müsste ich herausfinden, wohin die Zeit geht, und beide Schätzungen der Reviewer überprüfen.
Wirths Maschine hat nicht viel Speicher – ein Megabyte für alles, den Bildschirm eingeschlossen –, das Modell fiel also wirklich winzig aus. Es sagt den nächsten Buchstaben aus den vorangegangenen acht vorher und hat etwa dreiundvierzigtausend Parameter. Zum Vergleich: Die Modelle, mit denen wir chatten, haben millionenfach mehr. Und doch belegt selbst ein solches Modell fast die Hälfte des freien Speichers der Maschine. Trainiert habe ich es auf einem gewöhnlichen Laptop in ein paar Dutzend Sekunden, mit dem Text von Alice’s Adventures in Wonderland, der längst gemeinfrei ist.
Warum kein Transformer und warum keine Ganzzahlen
Moderne Modelle sind als Transformer gebaut, und man könnte auch ein solches Modell schreiben, aber es führt im Kern dieselbe Arithmetik aus und verlangt obendrein mehrere hundert zusätzliche Zeilen verwickelter Mathematik auf Wirths nicht standardkonformen Gleitkommazahlen. Für die Frage, was eine Multiplikation kostet, würde das nichts beitragen.
Und das Modell auf Ganzzahlen umzustellen, was die Berechnung auf schwacher Hardware gewöhnlich beschleunigt, würde auf Wirths Prozessor nichts bringen. Auf Wirths Maschine ist die Ganzzahlmultiplikation sogar langsamer als die Gleitkommamultiplikation, Ganzzahlen würden also nur Arbeit hinzufügen. Entschieden hat das die Arithmetik, nicht die Mode.
Das schreibt das Modell, wenn man es mit alice was startet:
alice was one thought all the tell you spo
Shakespeare kann ruhig schlafen. Uns interessiert hier aber nicht die Literatur, sondern die Stoppuhr.
Die Hauptanforderung war, dass der Text, den das Modell auf Wirths Schaltung ausgibt, Byte für Byte mit einer Referenz übereinstimmt, die auf einem gewöhnlichen Computer berechnet wurde. Dafür durfte die Referenz nicht mit den üblichen Python-Mitteln berechnet werden, sondern in exakt derselben Arithmetik wie auf Wirths Prozessor, wobei jede Operation in derselben Reihenfolge wiederholt wird. Andernfalls hätte nichts übereingestimmt. Ich habe gesondert ausgerechnet, wie weit Wirths Arithmetik vom Standard abweicht, und festgestellt, dass sich fast alle Zwischenwerte in den letzten Stellen unterscheiden. Der erzeugte Text wich dabei allerdings kein einziges Mal ab, aber das ist schlichtes Glück. Ein Vergleich gegen gewöhnliches Python hätte fast immer gestimmt und eines Tages unerklärlich danebengelegen – die schlimmste Sorte Bug, weil er sich weder reproduzieren noch erklären lässt.
Der Text stimmte überall überein. Auf dem Emulator, wo dieser Check inzwischen bei jeder Änderung automatisch läuft; auf Wirths Schaltung; auf der Schaltung mit dem schnellen Multiplizierer, zu dem gleich mehr; und im echten System mit Fenstern. Programm und Gewichte werden auf die Festplatte gelegt, zwei Mittelklicks übersetzen erst das Programm und starten dann die Generierung, und der fertige Text wird von der Festplatte gelesen und stimmt mit der Referenz überein. In QEMU ebenso.
Wohin die Zeit geht
Auf Wirths Prozessor mit seinem nativen Multiplizierer gibt das Modell etwa neun Buchstaben pro Sekunde aus. Auf einer lebenden Maschine, auf der der Videocontroller etwas Prozessorzeit beansprucht, etwas weniger. Kurz: neun Buchstaben pro Sekunde, mit Glück.
Als ich mir ansah, womit der Prozessor die ganze Zeit beschäftigt war, ergab sich ein sehr klares Bild. Fast vierzig Prozent aller Takte gehen auf Gleitkommamultiplikation, und den größten Teil dieser Zeit wartet er einfach darauf, dass der langsame Multiplizierer fertig zählt. Wirths Multiplizierer arbeitet seriell und berechnet das Produkt mit einem Bit pro Takt, eine einzige Multiplikation dauert also sechsundzwanzig Takte. Ein weiteres Viertel der Zeit geht auf das Lesen aus dem Speicher. Und hier zeigte sich noch etwas Interessantes. Die einfachste Zeile des Programms, in der ein Produkt zu einer Summe addiert wird, macht Wirths Compiler zu siebenundzwanzig Instruktionen, von denen nur vier nützlich sind. Der ganze Rest ist Lesen und Schreiben der Summe im Speicher, der Schleifenzähler und – ja – wieder Bounds- und NIL-Prüfungen. Die Sache ist die: Wirths Compiler kann Variablen nicht in den Registern des Prozessors halten und geht jedes Mal in den Speicher, um sie zu holen. Einer der Reviewer hatte das am ersten Tag aus den Quellen vorhergesagt und die Taktzahl fast genau erraten. Das ist übrigens kein Versehen, sondern bewusste Einfachheit: Wirths gesamter Compiler hat weniger als dreitausend Zeilen und baut sich in Sekunden selbst, und eine komplexe Optimierung passte schlicht nicht in dieses Budget.
Der schnelle Multiplizierer
Da alles auf den Multiplizierer hinausläuft, habe ich einen schnellen geschrieben. Er tut dasselbe wie Wirths, aber nicht ein Bit pro Takt, sondern alles auf einmal, in einem oder zwei Takten – mit Rundung und anderen Feinheiten exakt nach Wirths Vorbild nachgebaut. Eingeschaltet wird er genauso wie die Instruktion CHK, mit einem einzigen Schalter beim Bauen des Prozessors.
Die Hauptanforderung an ihn war so streng wie an alles andere: Die Ergebnisse müssen bis aufs letzte Bit mit Wirths Multiplizierer übereinstimmen. Ich habe zig Millionen Zahlenpaare durchgejagt, einschließlich aller unangenehmen Grenzfälle, und keine einzige Abweichung gefunden. Und um sicherzugehen, dass der Check überhaupt Fehler bemerken kann, habe ich die Rundung an einer Stelle absichtlich verdorben, und er fand Zehntausende Abweichungen.
Mit dem schnellen Multiplizierer lief das Modell 1,6-mal schneller – etwa vierzehn Buchstaben pro Sekunde statt neun. Die Schätzung aus dem Profil hatte genau das vorhergesagt, aber auf einer einfachen Maschine ohne Caches ist das eher eine Bestätigung, dass das Profil richtig berechnet wurde, als eine echte Vorhersage. Selbst wenn die Multiplikation völlig kostenlos würde, ließe sich das Programm nicht um mehr als das 1,64-Fache beschleunigen, weil die übrigen Takte ja nicht verschwinden. Die Zahl der Reviewer hat sich also nicht ganz bewahrheitet, aber in der Hauptsache hatten sie recht: Der Multiplizierer war tatsächlich der Engpass.
Für die gewöhnliche Arbeit des Systems bringt der schnelle Multiplizierer allerdings überhaupt nichts. Der Compiler, der sich selbst baut, führt in vierzig Millionen Instruktionen ganze einunddreißig Gleitkommamultiplikationen aus, und der Systemstart keine einzige. Der langsame Multiplizierer war eine völlig vernünftige Wahl für eine Maschine, auf der man Text schreibt und Programme baut. Das Sprachmodell war die erste Aufgabe, für die er zum Engpass wurde.
Und was ist mit der neuen Instruktion, die multipliziert und addiert, mit der alles angefangen hat? Implementiert habe ich sie nicht; ich habe sie anhand der Zähler abgeschätzt. Auf Wirths gewöhnlichem Multiplizierer würde sie anderthalb bis sechs Prozent bringen, auf dem schnellen bis zu zehn. Der Haupthebel ist hier also nicht die neue Instruktion, sondern ein Compiler, der lernt, die Summe in einem Register zu halten, statt für sie in den Speicher zu laufen. Das habe ich aber nicht mehr gemessen.
In Hardware fiel der schnelle Multiplizierer sogar kleiner aus als der native, weil ein FPGA fertige Hardware-Multiplikationsblöcke hat (seine DSP-Slices) und die ganze Logik für das serielle Zählen einfach wegfiel. Die Ein-Takt-Variante senkt allerdings die Höchstfrequenz des Prozessors spürbar, während die Zwei-Takt-Variante fast genauso schnell ist und die Frequenz nicht berührt. Die nativen 25 MHz halten in beiden Fällen mit großer Reserve, wählen müsste man also nur, wenn jemand Wirths Maschine übertakten wollte.
Zwei Funde am Wegesrand
Der erste Fund betrifft den Vergleich von Gleitkommazahlen. Wirths Compiler vergleicht sie genauso wie Ganzzahlen, über eine Subtraktion und eine Prüfung der Prozessor-Flags, und bei einigen Vergleichen verwendet er das Overflow-Flag. Nur wird dieses Flag ausschließlich von Ganzzahloperationen verändert. Ist also irgendwo im Programm vor einem Vergleich von Gleitkommazahlen eine Ganzzahl übergelaufen, kann der Vergleich eine falsche Antwort liefern. Ich habe das mit einem sehr einfachen Programm geprüft. Zuerst sagt es ehrlich, dass eins kleiner als zwei ist; dann lässt es eine Ganzzahl überlaufen; und danach meldet es ebenso selbstbewusst, eins sei nicht kleiner als zwei. Das lässt sich sowohl auf dem Emulator als auch auf der Schaltung reproduzieren. Mein Modell hat keine Überläufe, und die Referenz prüft das. Neuheit beanspruche ich hier nicht: Bestimmt hat das schon jemand gesehen; korrigieren Sie mich, wenn Sie wissen, wo.
Der zweite Fund war lustiger. Das Modell musste eine Textdatei auf die Festplatte speichern, und dabei stellte sich heraus, dass im ganzen Projekt noch nie jemand etwas in unser QEMU geschrieben hatte, weil der Systemstart nur von der Festplatte liest. Und schreiben konnte es nicht, weil die Festplatte ohne Schreibrecht eingebunden war, und der allererste Versuch, irgendetwas zu speichern, riss QEMU komplett mit sich. Obendrein legt das Dateisystem von Oberon neue Daten hinter das Ende der Festplatte, und das Disk-Image war genau so groß wie das, was das System belegte, sodass die Datei auch noch stillschweigend nicht gespeichert wurde.
Als ich das behoben hatte und die Maschine in Kubernetes startete, funktionierte das Schreiben immer noch nicht – diesmal wegen der Dateiberechtigungen. Die Aufgabe, die die Festplatte der Maschine auf ihr Volume legt, sollte das Schreiben erlauben, tat es aber auf eine Weise, die tatsächlich gar nichts erlaubte. Die ganze Zeit über war die Festplatte im Cluster schreibgeschützt, und hätte jemand in Oberon eine Datei gespeichert, wäre die Maschine abgestürzt. Bemerkt hat es niemand, weil niemand etwas speicherte. Inzwischen werden die Berechtigungen explizit gesetzt, auch auf bereits angelegten Festplatten, und das Prüfszenario in der Sandbox fragt QEMU selbst, ob es die Festplatte zum Schreiben geöffnet hat.
Alle Details, Tabellen und Befehle zum Nachvollziehen stehen in der Beschreibung der Folge, und das Wesentliche lässt sich in ein paar Minuten mit cd impl && make lm-check && make lm-profile reproduzieren.
Deskriptoren, zwischen CHK und CHERI
Die Instruktion CHK prüft einen Index gegen eine Länge, die der Compiler in die Instruktion selbst eingebrannt hat, der Compiler muss die Array-Länge also im Voraus kennen. CHERI hält die Grenzen im Zeiger, und die Prüfung lässt sich weder vergessen noch umgehen. Zwischen diesen beiden Extremen standen historisch noch Deskriptoren, wie in eben jener Burroughs B5000 aus den frühen Sechzigern. Ein Deskriptor ist ein Zeiger, der die Array-Länge mit sich trägt, und der Prozessor prüft ihn bei jedem Zugriff, sodass der Compiler nichts mehr im Voraus wissen muss. Ich wollte diese Sprosse auf die Leiter setzen und sie auf demselben vollständig offenen System messen.
Schon die allererste Beobachtung engte die Aufgabe stark ein. In Oberon kennt der Compiler die Länge fast jedes Arrays im Voraus, weil die Sprache schlicht keine Zeiger auf Arrays und keine Arrays variabler Länge kennt. Es gibt eine Ausnahme: wenn ein Array an eine Prozedur übergeben wird, die ein Array beliebiger Länge entgegenzunehmen bereit ist. Innerhalb einer solchen Prozedur ist die Länge nicht im Voraus bekannt, und genau dort hat ein Deskriptor etwas zu tun. Überall sonst kommt CHK bereits zurecht.
Den Deskriptor habe ich in ein gewöhnliches 32-Bit-Wort gepackt. Wirths Prozessor hat eine 24-Bit-Adresse, die Maschine aber nur ein Megabyte Speicher, und für ein Megabyte reichen zwanzig Bit, also gab ich die übrigen zwölf Bit der Array-Länge – bis zu etwas über viertausend Elemente. Dazu eine neue Instruktion, die einen Deskriptor und einen Index nimmt, die Adresse des Elements berechnet und, wenn der Index über die Länge hinausläuft, zum Fehlerbehandler springt. Eine gewöhnliche Adresse, die anstelle eines Deskriptors übergeben wird, sieht aus wie ein Array der Länge null, sodass jeder Zugriff darüber sofort als Fehler behandelt wird. Das ist das nächste Analogon zur zentralen Regel von CHERI – ohne Berechtigung kein Zugriff –, das sich ohne spezielles Hardware-Tag bauen lässt.
Die neue Instruktion wurde so streng geprüft wie CHK: mit denselben absichtlichen Sabotagen, Lockstep-Vergleich gegen den Emulator und einem Check, dass das gewöhnliche System auf einem Prozessor mit der neuen Instruktion genauso bootet wie auf dem gewöhnlichen. Und wieder log der erste Versuch. Der Lauf mit absichtlichen Sabotagen meldete zunächst, er habe alle erwischt. Das Skript, das die Sabotagen einbaute, stürzte selbst ab, die Schaltung baute nicht, und die Tatsache, dass nichts gebaut wurde, zählte als erwischte Sabotage. Inzwischen gilt eine Schaltung, die nicht baut, als gescheiterter Check, nicht als bestandener.
Auf derselben Schleife wie auf der Seite mit den zwei Kernen erwies sich der Deskriptor als der schnellste von allen – schneller sogar als die Variante ganz ohne Prüfungen, acht Takte pro Zugriff gegenüber neun. Ein Wunder ist das nicht. Die neue Instruktion berechnet auch die Adresse des Array-Elements, wofür gewöhnlich zwei weitere Instruktionen nötig sind, und hätte ich eine identische Instruktion ohne Prüfung gebaut, liefe sie genauso schnell. Die Lehre ist hier eine andere, und sie gefällt mir: Wenn die Grenze mit dem Zeiger mitreist, lässt sich die Prüfung in einer Instruktion verstecken, die man ohnehin braucht. Genau so ist es in CHERI gelöst, wo die Prüfung im Speicherzugriff steckt.
Als Nächstes brachte ich dem Compiler bei, Deskriptoren dort zu verwenden, wo die Länge nicht im Voraus bekannt ist, und ließ das System sich mit dem neuen Compiler neu bauen. Es baute sich neu, und die nächste Compiler-Generation stimmte Byte für Byte mit der vorherigen überein. Das ist ein wichtiger Check, denn hätte der Compiler irgendwo vergessen, einen Deskriptor wieder in eine gewöhnliche Adresse zu verwandeln, wäre die Adresse falsch gewesen und es hätte keine Übereinstimmung gegeben.
Und dann fand das echte System zwei Grenzen, auf die ich selbst nie gekommen wäre. Die erste betrifft die Array-Länge. Im gesamten Project Oberon gibt es kein einziges Array mit mehr als viertausend Elementen, aber in den Werkzeugen, mit denen ich es gebaut habe, tauchte ein Puffer mit sechzehntausend Elementen auf, und der Compiler weigerte sich ehrlich, ihn zu bauen, statt die Länge stillschweigend abzuschneiden. Die zweite Grenze war interessanter. Als ich viele Module in einem Lauf baute, wuchs der Speicher im Emulator über ein Megabyte hinaus, mein Deskriptor kann aber nur ein Megabyte adressieren, also blieb der Build einfach hängen, und zwar stillschweigend. Daraus folgt eine sehr aufschlussreiche Schlussfolgerung. Ein Zeiger mit Grenzen lässt sich nicht in die Breite einer gewöhnlichen Adresse quetschen, denn sobald mehr Speicher da ist, bleibt kein Platz mehr für die Länge. Genau deshalb sind die Zeiger von CHERI doppelt so breit wie eine Adresse und komprimieren die Grenzen obendrein geschickt.
Was kostet diese ganze Konstruktion bei großen Lasten? Bei einem synthetischen Programm, das intensiv mit Arrays unbekannter Länge arbeitet, bringen Deskriptoren eine Beschleunigung um etwa ein Viertel, aus demselben Grund wie in der Schleife: Sie sparen bei der Adressberechnung. Beim Compiler dagegen – einem echten Programm – bringen sie eine winzige Verlangsamung, unter einem Prozent, und ich habe ziemlich lange gesucht, woher sie kommt, denn rechnerisch hätte es eine Beschleunigung sein müssen. Mit Deskriptoren hatte das nichts zu tun: Jedes Mal, wenn das Programm einer Prozedur einen String übergibt, baut der Compiler jetzt einen Deskriptor dafür zusammen, wodurch der Code etwas länger wurde, und das System verbringt etwas mehr Zeit mit dem Laden von Modulen. Hätte der Compiler die String-Deskriptoren im Voraus vorbereitet, wäre das nicht passiert, aber das habe ich nicht mehr umgesetzt.
Auf dem FPGA hält der Prozessor mit Deskriptoren weiterhin seine 25 MHz, hat etwa fünf Prozent mehr Logik, und die neue Instruktion landete zum ersten Mal auf dem kritischen Pfad der Schaltung – ihrem längsten Signalweg –, könnte also künftig die Frequenz begrenzen. CHK hat das kein einziges Mal getan.
Am Ende sieht die Leiter so aus:
| Sprosse | Wo die Grenze gespeichert ist | Prüfinstruktionen in der Schleife | Hauptkosten |
|---|---|---|---|
| RISC5, Software-Prüfung | im Code | 2 | am langsamsten |
RISC5, CHK | in der Instruktion selbst | 1 | funktioniert nicht, wenn die Länge nicht im Voraus bekannt ist |
| RISC5, Deskriptor | im Zeiger | 0 | Speicher bis ein Megabyte, Arrays bis viertausend Elemente |
| CHERI | in einem breiten, getaggten Zeiger | 0 | doppelt so breite Zeiger |
Ein Deskriptor entfernt die Prüfung aus der Schleife genauso wie CHERI, hat in Oberon aber fast nichts zu schützen, was CHK nicht schon schützt. Und das Entscheidende, was ihn von CHERI unterscheidet: Ein Deskriptor bleibt eine gewöhnliche Zahl, und ein Programm, dem Low-Level-Operationen erlaubt sind, kann aus beliebiger Länge und beliebiger Adresse jeden beliebigen Deskriptor zusammenbauen. Genau hier setzt CHERI ein spezielles Tag, das sich nicht fälschen lässt. Ein vollständig mit Deskriptoren gebautes System habe ich auf der echten Schaltung noch nicht gebootet; diesen Prozessor gibt es auch noch nicht im Browser oder im Katalog; und alle Details und Befehle zum Nachvollziehen stehen in der Beschreibung der Folge.
Wie Sie das alles selbst installieren
Es gibt vier Wege, vom allereinfachsten, bei dem Sie nichts installieren müssen, bis zur eigenen Cloud.
Am einfachsten ist es, das Labor im Browser zu öffnen und zumindest die ersten vier Übungen zu machen. Sie sehen, wie eine Oberfläche funktioniert, in der jeder Text ein Befehl sein kann, schreiben Ihr erstes Modul und machen die Maschine kaputt, indem Sie Müll direkt in den Bildschirmspeicher schreiben. Wenn Sie keine Übungen wollen, finden Sie auf der Seite Just run the system das nackte System, und auf der Seite Change the processor sehen Sie die Kosten einer Prüfung mit eigenen Augen. Die mittlere Maustaste wird durch einen Klick mit Alt ersetzt, der Zwei-Tasten-Akkord durch einen Klick mit Shift. Von dem, was man selbst ausprobieren sollte, empfehle ich einen Mittelklick auf System.ShowModules, um zu sehen, wie wenige Module das System nach dem Booten braucht, und auf Hilbert.Draw, weil es einfach hübsch ist. Und dann die Laborübungen zwölf und dreizehn, die am stärksten hardwarenahen: In der einen messen Sie die drei Prozessorvarianten selbst, in der anderen fügen Sie der Sprache eine neue eingebaute Prozedur hinzu und bauen den Compiler direkt im System neu.
Wenn Sie Wirths Maschine als gewöhnliche VM möchten, bauen Sie sich Ihr eigenes QEMU mit den Befehlen aus dem QEMU-Abschnitt oder nach dem Leitfaden. Dort lohnt es sich, die Prozessorvarianten mit Hardware-Prüfung und mit Deskriptoren auszuprobieren.
Wenn Sie ein eigenes KubeVirt haben, gibt es einen Leitfaden und die Kurzfassung im Spoiler oben. Unterstützt werden die beiden neuesten KubeVirt-Versionen sowie Server mit Intel und mit Arm. Sie können mit einem Wegwerf-Testcluster beginnen; dasselbe Szenario, das der automatische Check ausführt, lässt sich von Hand starten. Und ich wiederhole die Warnung noch einmal, weil ich mich selbst daran verbrannt habe: Das Verwaltungs-Image wird für alle VMs des Clusters auf einmal geändert, prüfen Sie auf einem Arbeitscluster also zuerst, ob automatische Maschinen-Updates eingeschaltet sind.
Und wenn Sie Cozystack haben, genügt es, den Katalog mit den Befehlen aus dem Cozystack-Abschnitt einzubinden, und Ihre Benutzer bekommen Wirths Maschine, das Labor, das Handbuch und ein Bundle, das alles auf einmal installiert. Die Details stehen auf der Projektseite. Wenn Sie Studierenden oder Kollegen zeigen müssen, wie ein ganzer Computer aufgebaut ist, ist das wahrscheinlich der schnellste Weg. Was die automatischen Maschinen-Updates angeht: Die Komponente fragt inzwischen selbst danach und fasst ohne ausdrückliche Zustimmung nichts an.
Und wenn Sie uns auf die Finger schauen möchten, führt der Befehl cd impl && make deps && make check in etwa acht Minuten sämtliche Prozessortests, den Systemstart, den Lockstep-Vergleich gegen die Referenz, den Selbst-Build des Compilers und einen Neubau des gesamten Systems mit byteweisem Vergleich aus. Dafür brauchen Sie Verilator und einen C++-Compiler.
Was ich daraus mitgenommen habe
Erstens, zur Bounds-Prüfung. Sie ist billiger, als man gemeinhin denkt, aber völlig kostenlos würde ich sie nicht nennen. Auf Wirths Prozessor – sehr einfach, ohne Caches, ohne Sprungvorhersage – kostete sie den Compiler zwischen zwei und fünf Prozent der Zeit, je nachdem, aus welchem Teil des Systems man sie entfernt. Und der Großteil dieser Kosten entfällt auf Nullzeiger-Prüfungen, nicht auf Prüfungen von Array-Grenzen. Auf großen modernen Prozessoren ist sie in meiner absichtlich günstigen Schleife unsichtbar, weil die zusätzlichen Instruktionen in freie Slots fallen; auf dem Server-Arm ist sie sichtbar, wenn auch nur ein wenig. In echten Programmen sind Prüfungen vor allem deshalb teuer, weil sie den Compiler daran hindern, Arrays stapelweise zu verarbeiten, und das habe ich nicht gemessen. CHERI versteckt die Prüfung direkt im Speicherzugriff, und dann gibt es im Programm überhaupt keine Prüfung mehr.
Zweitens: Der Engpass liegt oft nicht dort, wo man ihn sucht. Für das neuronale Netz wollten alle, ich eingeschlossen, eine clevere neue Instruktion, dabei war der Engpass der alte langsame Multiplizierer. Ihn zu ersetzen, beschleunigte das Modell um das 1,6-Fache, während die neue Instruktion schätzungsweise ein paar Prozent gebracht hätte. Die Reviewer haben das am allerersten Tag gesagt, und eine Messung eine Woche später hat es bestätigt. Erst messen, dann Hardware hinzufügen.
Drittens: Ein Zeiger, der seine eigenen Grenzen kennt, muss breiter sein als eine gewöhnliche Adresse. Meine Deskriptoren, in ein gewöhnliches Wort gepackt, stießen an ein Megabyte Speicher und Arrays mit bis zu viertausend Elementen, und genau deshalb sind die Zeiger von CHERI doppelt so breit.
Viertens: Die fiesesten Bugs findet nur eine lebende Umgebung. Meine Tests waren gut, aber die interessantesten Dinge fanden echtes KubeVirt, echtes Cozystack und ein lebender Arm-Server – von einer Maschine, die keine Energieverwaltung braucht, über eine Netzwerkschicht, die stillschweigend nicht antwortet, bis zu sechzehn Sekunden, bevor der ganze Cluster migrierte. Seitdem veröffentliche ich eine neue Version nur, wenn sie vorher einen vollständigen Check in der Sandbox bestanden hat.
Und fünftens: Ein neuronales Netz schreibt Code schnell und beweist langsam, dass er funktioniert. Neun Tage für all das waren nur möglich, weil den Code Agenten geschrieben haben. Aber mehr als die Hälfte dieser Tage ging darauf, den Checks beizubringen, ehrlich zu erröten, und zu jeder hübschen Zahl gab es einen Auditor – ebenfalls ein Agent –, der sie zerlegte. Ist ein Check noch nie rot geworden, prüft er höchstwahrscheinlich gar nichts, vor allem wenn man sich sehr wünscht, dass alles klappt. Und eine eigene offene Frage ist, was man mit solchem Code in Open-Source-Projekten macht. QEMU und libvirt nehmen ihn überhaupt nicht an; die CNCF dagegen sieht das gelassen; und wie Open Source damit leben soll, ist noch nicht recht klar.
Statt eines Schlussworts
All das ist offen. Die Quellen liegen im Repository, unser Code unter der Apache-2.0-Lizenz und der Prozessor für QEMU unter der GPL, wie QEMU selbst. Die Website mit dem Labor ist tym83.github.io/paleocomputing. Jeder Fund samt Befehlen zum Nachvollziehen steht im Repository im Ordner impl/docs, und über Cozystack selbst können Sie auf cozystack.io lesen.
Als Nächstes in der Reihe: die Burroughs B5000 mit ihrem Hardware-Speicherschutz; Lilith, Wirths allererste Maschine, die nur einen neuen Pass brauchen wird; und, sofern die Geduld reicht, mein eigenes Board mit Oberon auf einem FPGA, um die Takte endlich nicht in der Simulation, sondern auf echter Hardware zu messen.
Wenn Sie Oberon in der Lehre einsetzen oder einfach einmal darin geschrieben haben, erzählen Sie es mir in den Kommentaren – ich bin sehr neugierig, wo es heute lebt. Und korrigieren Sie mich unbedingt, wenn ich mich irgendwo geirrt habe; nach diesem Artikel zu urteilen, passiert mir das regelmäßig.
Eine kurze Umfrage: Was machen Sie nach diesem Artikel?
- Das Labor öffnen und die Maschine kaputt machen, indem ich Müll in den Bildschirmspeicher schreibe
- Auf meinem eigenen Cluster die automatischen Updates der VMs prüfen. Und zwar sofort
- Alles in Oberon neu schreiben (Go ist im Grunde Oberon, nur mit Goroutinen)
- Für ein paar Prozent weiterhin die Bounds-Prüfung abschalten
- Ich habe schon in den Neunzigern darin geschrieben und habe in den Kommentaren etwas zu sagen
- Bis zur Umfrage durchgehalten, was an sich schon eine Leistung ist
P.S. Ein besonderer Dank an Niklaus Wirth. Ich bin ihm nie begegnet, aber neun Tage lang habe ich mit seiner Schaltung gesprochen, und sie hat mich fast nie belogen. Im Gegensatz zu meinen eigenen Checks.