Auf einen Blick
- Projekt: kubepkg 1.3, Apache License 2.0, github.com/kuberoot-dev/kubepkg
- Paketformat: Unverändertes Helm-Chart plus Deskriptor in einer OCI-Registry; installierbar auch mit reinem Helm, Flux oder Argo CD
- Öffentliches Repository: 49 aus Rezepten gebaute Pakete, von cert-manager und Cilium bis vLLM und Milvus
- Backends: Helm SDK (Standard), Nelm von werf, Flux HelmRelease, Argo CD Application
- Vertrauen: Signierter Index, Root of Trust nach dem Vorbild von TUF mit Schwellenwert für Root-Schlüssel, ein Admission Webhook, der Image-Digests festlegt
- Air-Gap-Installationen: Ein Bundle mit Index, Charts und Images, beim Import gegen separat eingebrachte Schlüssel verifiziert
Linux hat apt, dnf und pacman, und niemand erinnert sich mehr, wie das Leben ohne sie aussah. Kubernetes hat nach zehn Jahren immer noch nichts, das diese Aufgabe über Komponenten hinweg erledigt. Helm installiert ein einzelnes Chart wunderbar, und Argo CD und Flux sind sehr gut darin, einen Cluster mit Git synchron zu halten. Was keines dieser Werkzeuge weiß: dass die Hälfte Ihrer anderen Komponenten cert-manager braucht, dass sich KubeVirt nach einem Upgrade nicht mehr downgraden lässt oder dass die CRDs, die ein Release installiert hat, nicht stillschweigend mit ihm verschwinden dürfen. Wer eine Plattform auf Kubernetes baut, schreibt diese Schicht am Ende selbst, von Grund auf, jedes Mal aufs Neue.
In diesem Beitrag geht es um kubepkg, einen Paketmanager für Kubernetes, der auf jedem Cluster läuft, gewöhnliche Helm-Charts installiert und so funktioniert wie Debian: ein Paket-Repository, ein signierter Index und Pakete, die aus Upstream-Quellen gebaut werden. Im ersten Teil dieser Serie habe ich erklärt, warum ich das alles angefangen habe, warum wir Kubernetes meiner Meinung nach so behandeln sollten wie den Linux-Kernel und wie mein Baukasten für Kubernetes-Distributionen funktioniert. Die Idee eines universellen Paketmanagers, den man leicht in jede Plattform einbetten oder in einen Vanilla-Cluster setzen kann, habe ich dort nur gestreift. Dieser Beitrag schaut in kubepkg hinein und zeigt, was es kann. Alle Beispiele stammen aus einem echten Cluster, der in einem Cozystack-Tenant läuft.
Woher kubepkg kommt
Wie kubepkg entstanden ist
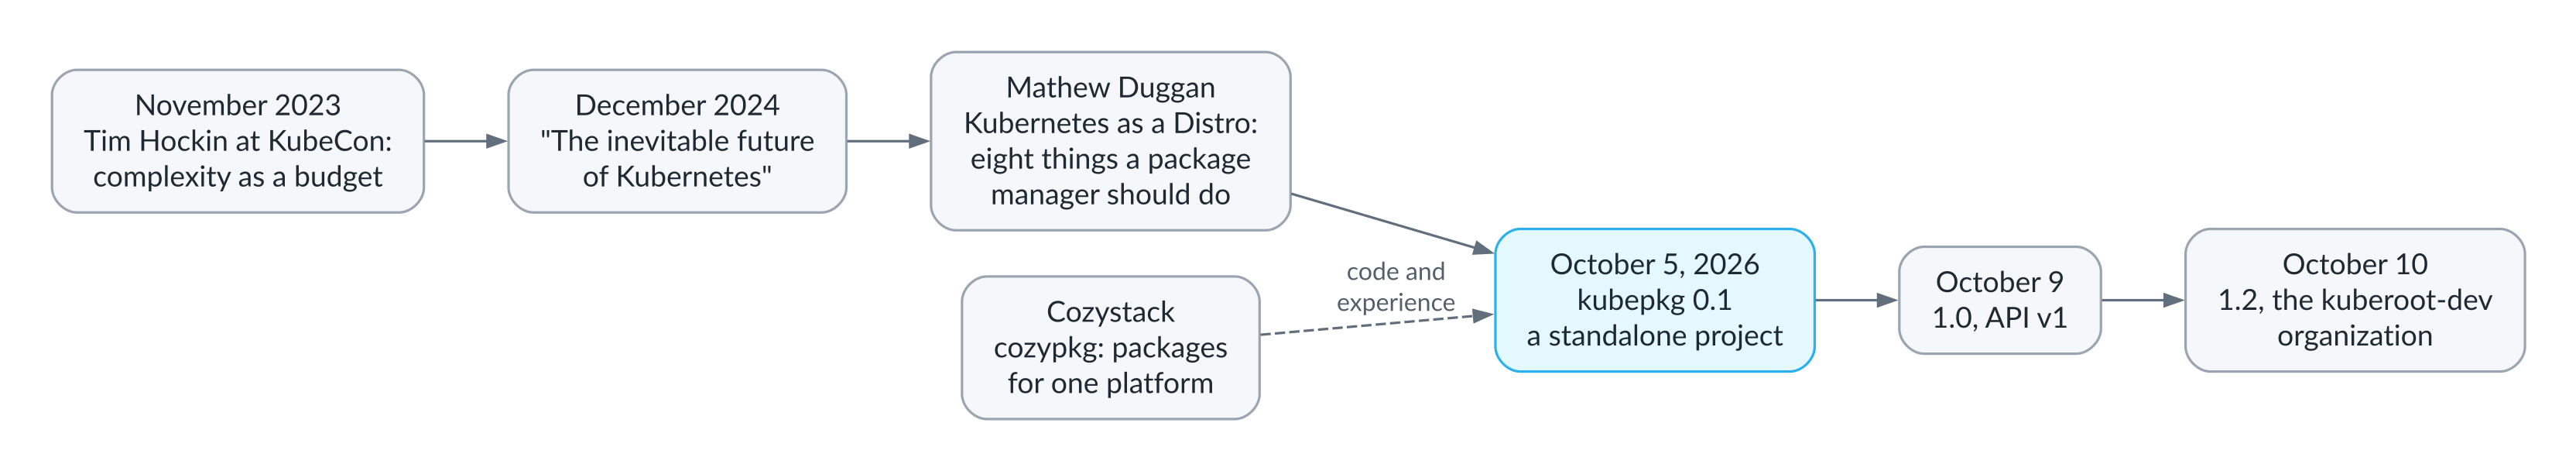
Der erste Teil erzählt die ganze Geschichte, deshalb hier die Kurzfassung. Als Antwort auf einen alten Artikel von mir schrieb Mathew Duggan, dass “the root cause of all of this is simply a lack of a meaningful package management system for Kubernetes”, zählte auf, was ein solches System leisten müsste, und gab ihm später in What would a Kubernetes 2.0 look like sogar einen Arbeitstitel: KubePkg. Der Name meines Projekts ist kein Zufall.
Ich habe nicht bei null angefangen (und ehrlich gesagt habe ich den Code ohnehin nicht wirklich selbst geschrieben). Ausgangspunkt war cozypkg, ein Werkzeug aus dem Cozystack-Projekt. Als Cozystack auf eine paketbasierte Architektur umstieg, musste es Dutzende Komponenten in der richtigen Reihenfolge installieren und aktualisieren und dabei eine klare Historie dessen führen, was passiert war. cozypkg hat diese Aufgabe gut erledigt, war aber fest mit dieser einen Plattform verschweißt. Deshalb habe ich Anfang Oktober einen Teil seines Codes genommen und darauf ein eigenständiges Projekt aufgebaut, das von keiner Plattform abhängt und in einem Vanilla-Cluster genauso gut funktioniert wie in jeder Kubernetes-Plattform. Alles Folgende beschreibt Version 1.3. Sie hat bereits eine v1-API mit Kompatibilitätsversprechen und lebt in der GitHub-Organisation kuberoot-dev, neben kuberoot, dem Distributions-Builder, für den sie gemacht wurde.
Was Helm fehlt
Helm ist hervorragend darin, ein einzelnes Release zu templaten und zu installieren. Schwierig wird es, wenn man viele Releases hat und sie voneinander abhängen. Helm löst keine Abhängigkeiten zwischen Releases auf: Chart-Abhängigkeiten ziehen Subcharts in dasselbe Release. Braucht Ihre Anwendung also cert-manager als separates Release, merkt Helm das erst, wenn die Installation mit no matches for kind "Certificate" scheitert. Helm weiß nicht, welche Komponente welche API bereitstellt, und kann Ihnen deshalb nicht sagen, dass der Prometheus Operator schon im Cluster ist, weil jemand anderes ihn dort installiert hat. Von Haus aus zeigt es nicht, was ein Upgrade ändern wird; dafür braucht man das Plugin helm-diff. Und zu CRDs hat es keine echte Haltung jenseits von “einmal installieren, nie wieder anfassen”, obwohl CRDs das Gefährlichste in Kubernetes sind: Sie gehören dem ganzen Cluster, sie überleben das Release, das sie installiert hat, und wer eine CRD löscht, löscht jedes Objekt dieses Typs.
Jede Plattform stopft diese Löcher auf ihre eigene Weise. Deckhouse hat Module, OpenShift hat OLM, Rancher hat seinen Katalog, und jedes davon ist um die eigene Plattform herum gebaut, nicht dafür gedacht, dass andere es übernehmen. kubepkg soll die Paketschicht für Menschen sein, die Plattformen und Distributionen bauen. Es ersetzt weder Helm noch Argo CD noch Flux, sondern arbeitet auf ihnen und neben ihnen.
Warum es nie ein apt für Kubernetes gab
Die Idee ist nicht neu, und ich bin längst nicht der Erste, der sie hatte. Helm selbst startete 2015 als “the package manager for Kubernetes”, und formal ist es das auch: Es hat Pakete, Repositories und Versionen. Aber der Wert von apt lag nie im Archivformat, sondern im Wissen darüber, wie Pakete nebeneinander existieren, und diese Schicht ist Helm nie gewachsen. Im vergangenen Jahrzehnt haben Leute immer wieder versucht, Helm zu erweitern oder zu ersetzen, und fast jeder Versuch endete gleich.
Schon 2016 baute CoreOS KPM, ein eigenes Paketformat mit eigener Registry, aus dem später App Registry und der Bereich Applications in Quay wurden. Nachdem Red Hat CoreOS gekauft hatte, wurde KPM nicht weiterentwickelt, und 2022 entfernte Quay.io auch Applications. 2018 schlugen Microsoft, Docker und einige andere Unternehmen CNAB vor, ein universelles Bundle-Format für Cloud-Anwendungen jeder Art; die Referenzimplementierung Duffle ist längst archiviert, und die einzige lebende Implementierung ist Porter, ein CNCF-Sandbox-Projekt mit kleiner Nutzerbasis. D2iQ entwickelte KUDO, eine deklarative Art, Operatoren zu beschreiben, mit eigenem Paketformat; das letzte Release erschien im Frühjahr 2021. 2024 bezeichnete sich Glasskube lautstark als Paketmanager der nächsten Generation für Kubernetes und sammelte ein paar tausend Sterne auf GitHub, doch das Team wandte sich einem anderen Produkt zu, und das Repository ist inzwischen archiviert. Selbst Kubeapps, das nie ein Format erfunden hat und einfach ein bequemer Katalog über Helm-Charts war, wurde im August 2025 archiviert und lebt nun als Fork weiter, den SAP pflegt.
Überlebt haben die Projekte mit einer großen Plattform im Rücken. OLM funktioniert innerhalb von OpenShift sehr gut, und kapp-controller aus Carvel, dessen Modell von Paketen und Repositories sehr nah an dem ist, was ich bauen wollte, ist zusammen mit Tanzu groß geworden. Beide sind aber im Ökosystem ihres Herstellers geblieben, und außerhalb nutzt sie kaum jemand.
Der Grund ist immer derselbe, und er ist nicht technisch. Ein neues Paketformat braucht jemanden, der Software darin paketiert. Die Leute hinter cert-manager, Cilium oder KubeVirt werden kein weiteres Format für ein Werkzeug pflegen, das noch niemand nutzt, und Nutzer steigen nicht auf ein Werkzeug um, dem die Pakete fehlen, die sie brauchen. Ein solches Projekt lebt also genau so lange, wie das eigene Team fremde Releases neu paketiert, und wenn das Team ausbrennt oder die Firma den Kurs ändert, stirbt das Projekt. Inzwischen ist das Helm-Chart zum De-facto-Standard für die Auslieferung geworden: Die meisten großen Kubernetes-Projekte veröffentlichen selbst eines (KubeVirt, siehe unten, ist eine bemerkenswerte Ausnahme), mit jedem Release, und Artifact Hub listet Tausende davon.
Daraus folgt die zentrale Designentscheidung in kubepkg. Ein Paket ist ein unverändertes Helm-Chart, und alles, was Helm nicht weiß, steht daneben in einem separaten Deskriptor. Ich verlange von niemandem, irgendetwas neu zu paketieren. Ein Rezept nimmt das Upstream-Release so, wie es ist, und wenn Upstream kein Chart veröffentlicht, wie bei KubeVirt, baut das Rezept eines aus den Release-Manifesten, sodass das Ergebnis trotzdem ein gewöhnliches Chart ist. Ein gebautes Paket liegt in einer OCI-Registry und lässt sich ohne kubepkg installieren, mit reinem Helm, Flux oder Argo CD. Selbst wenn kubepkg morgen verschwände, ließen sich die Charts also weiter installieren. Der Preis: Wir sind an das gebunden, was Helm kann, und alles, was ihm fehlt, von der Installationsreihenfolge über die Bereitschaft von Komponenten bis zur CRD-Ownership, muss außerhalb des Charts passieren statt darin. Wie das geht, zeigt der Rest dieses Beitrags.
Was ein Paket ist: ein unverändertes Helm-Chart plus Deskriptor
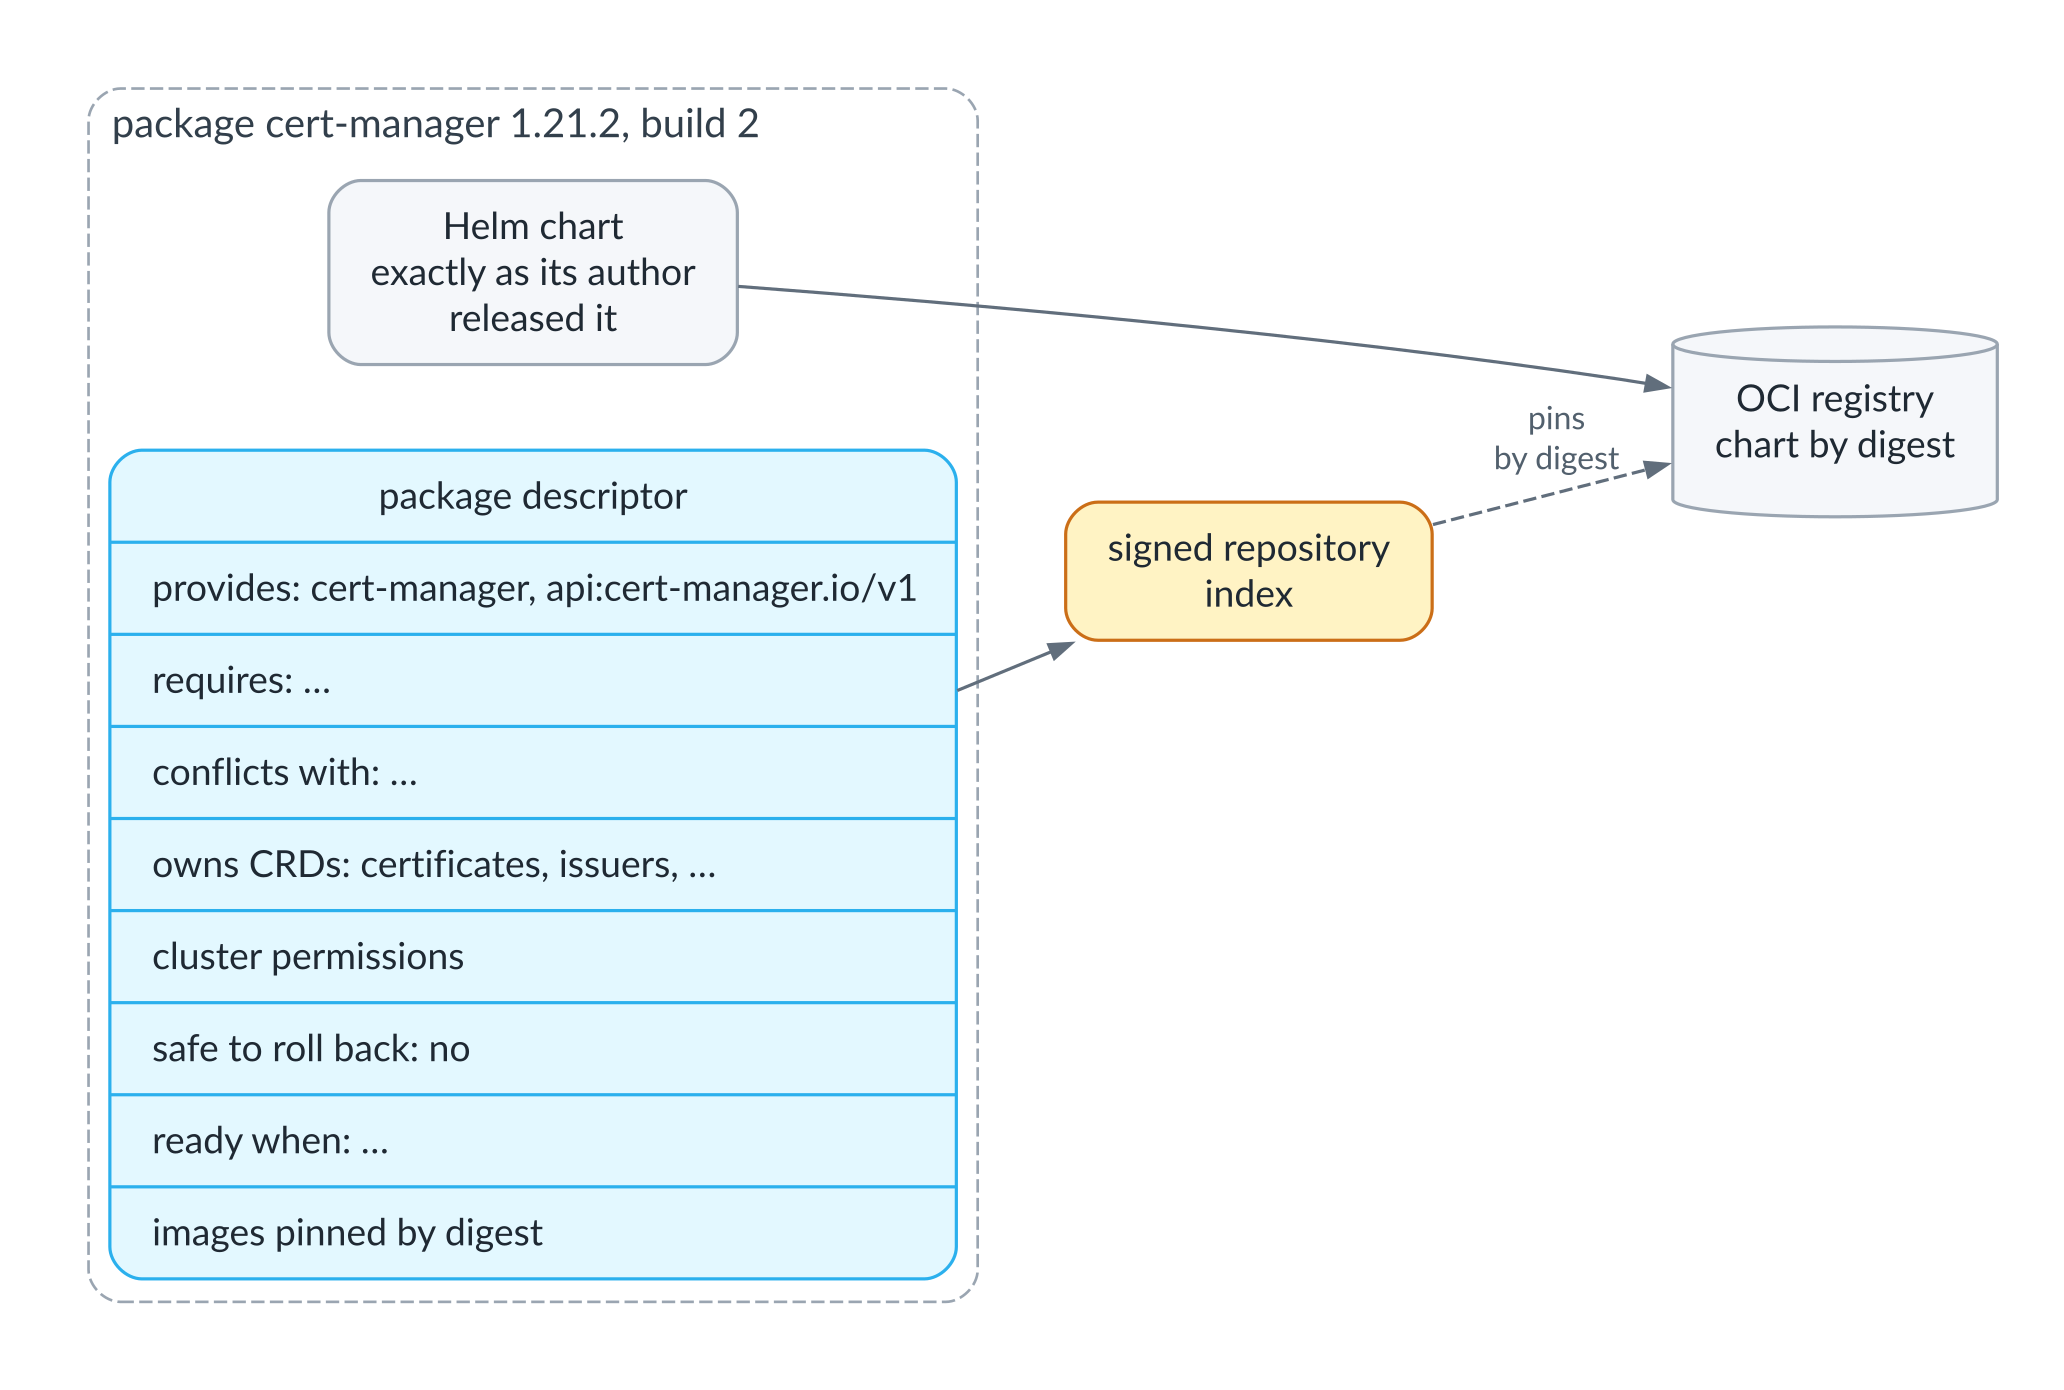
Woraus ein Paket besteht
Das Diagramm zeigt, was neben dem Chart in den Deskriptor gehört. Spannender ist, wie das Ganze funktioniert.
Ein Paket kann aus mehreren Komponenten bestehen, jede ein eigenes Chart und ein eigenes Release in einem eigenen Namespace. KubeVirt ist ein gutes Beispiel: Zuerst kommt der Operator, dann die KubeVirt-Custom-Resource, die den Operator anweist, die Virtualisierung auszurollen. Die zweite Komponente ergibt keinen Sinn, solange die erste nicht bereit ist, also installiert kubepkg sie nacheinander.
Abhängigkeiten gibt es in zwei Arten. Ein Paket kann ein anderes Paket in einem Versionsbereich verlangen, etwa cert-manager ab 1.20 und höchstens Major-Version 2. Oder es verlangt eine Capability wie api:monitoring.coreos.com/v1, die API, die die CRDs des Prometheus Operator bereitstellen. Eine Capability erfüllt entweder ein Paket, das sie bereitstellt, oder der Cluster selbst, wenn er diese API bereits anbietet. Der Prometheus Operator, den jemand vor drei Jahren von Hand installiert hat, zählt also, und kubepkg wird Sie nicht bitten, ihn ein zweites Mal zu installieren.
Gebaute Pakete bleiben gewöhnliche Helm-Charts in einer OCI-Registry. Wenn Sie morgen beschließen, dass Sie kubepkg nicht brauchen, installieren Helm, Flux, Argo CD oder werf (Alexey, Ilya, Ivan, Dmitry — einen großen Gruß an euch!) diese Charts problemlos.
Wie das im Cluster aussieht
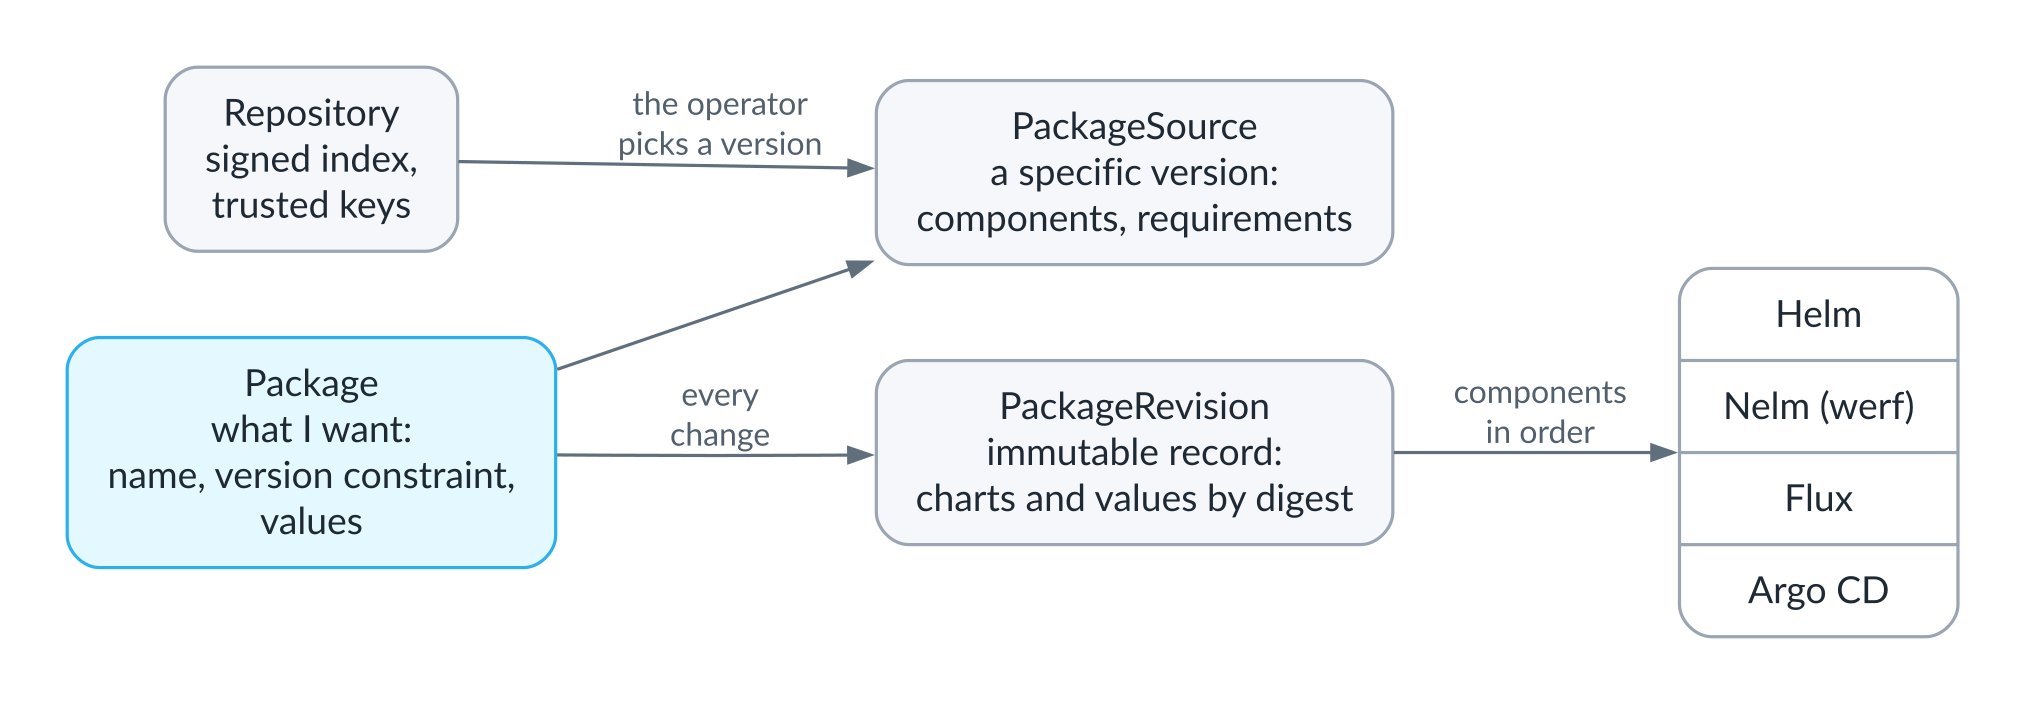
kubepkg-Objekte im Cluster
kubepkg hat keine eigene Paketdatenbank. Sein gesamter Zustand lebt in gewöhnlichen Kubernetes-Ressourcen, und auf einem einzelnen Cluster sind es nur vier.
Ein Repository ist das Abonnement eines Paket-Repositorys: die URL des Index und die Schlüssel, denen der Cluster vertraut. Ein Package beschreibt, was Sie wollen: den Paketnamen, eine Versionsbedingung, Ihre Values für die Charts. Eine PackageSource ist die konkrete Version des Pakets, die der Operator aus den Repositories ausgewählt hat. Und eine PackageRevision ist ein unveränderlicher Datensatz dessen, was genau angewendet wurde, bis hin zum Digest jedes Charts und jedes Satzes von Values.
Sie ändern immer nur das Package; den Rest erledigt der Operator. Er wählt eine Version, prüft Anforderungen, Konflikte und CRD-Ownership, und wenn der gewünschte Zustand von der aktuellen Revision abweicht, legt er eine neue Revision an und wendet die Komponenten in der Reihenfolge ihrer Abhängigkeiten an. Das kann er selbst über das Helm SDK tun oder die Arbeit an Nelm von werf, an Flux oder an Argo CD übergeben.
Erste Schritte
Der Operator wird als gewöhnliches Helm-Chart installiert, danach abonniert der Cluster ein Repository. Das öffentliche Repository des Projekts wird aus kubepkg-recipes gebaut und enthält derzeit 49 Pakete, von cert-manager und Cilium bis vLLM und Milvus.
helm install kubepkg oci://ghcr.io/kuberoot-dev/charts/kubepkg \
  --namespace kubepkg-system --create-namespace --wait

curl -fsSLO https://raw.githubusercontent.com/kuberoot-dev/kubepkg-recipes/main/keys/index.pub
kubepkg repo add main https://kuberoot-dev.github.io/kubepkg-recipes/index.yaml --public-key index.pub
Ab jetzt akzeptiert der Operator den Index des Repositorys nur, wenn er mit diesem Schlüssel signiert ist.
Bevor man etwas installiert, lohnt sich ein Blick darauf, was passieren wird. kubepkg plan löst ein Paket und alles, was es braucht, gegen den aktuellen Zustand des Clusters auf und ändert nichts:
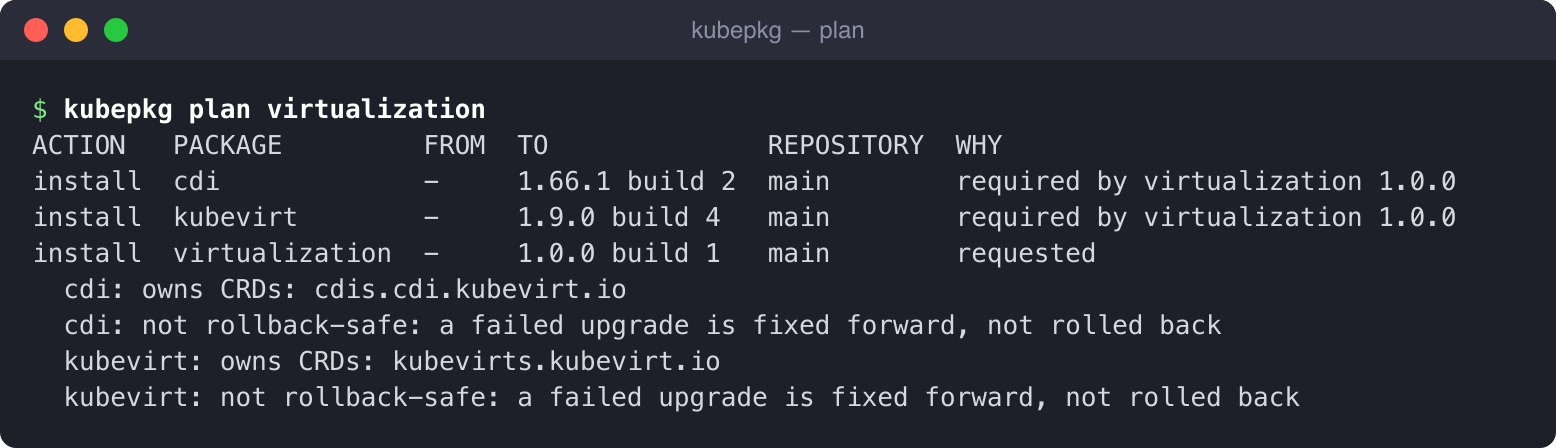
kubepkg plan
Hier ist virtualization ein Metapaket. Es installiert selbst nichts, sondern verlangt nur KubeVirt und CDI in kompatiblen Versionen. Der Plan zeigt, woher jedes Paket kommt, welche CRDs ihm gehören werden und ob es sich zurückrollen lässt. Derselbe Befehl macht sich gut in der CI bei jedem Pull Request: So sehen Reviewer die Folgen einer Änderung und nicht nur einen YAML-Diff.
Die Installation zeigt denselben Plan und schreibt pro Paket ein Package-Objekt in den Cluster; ab da übernimmt der Operator:
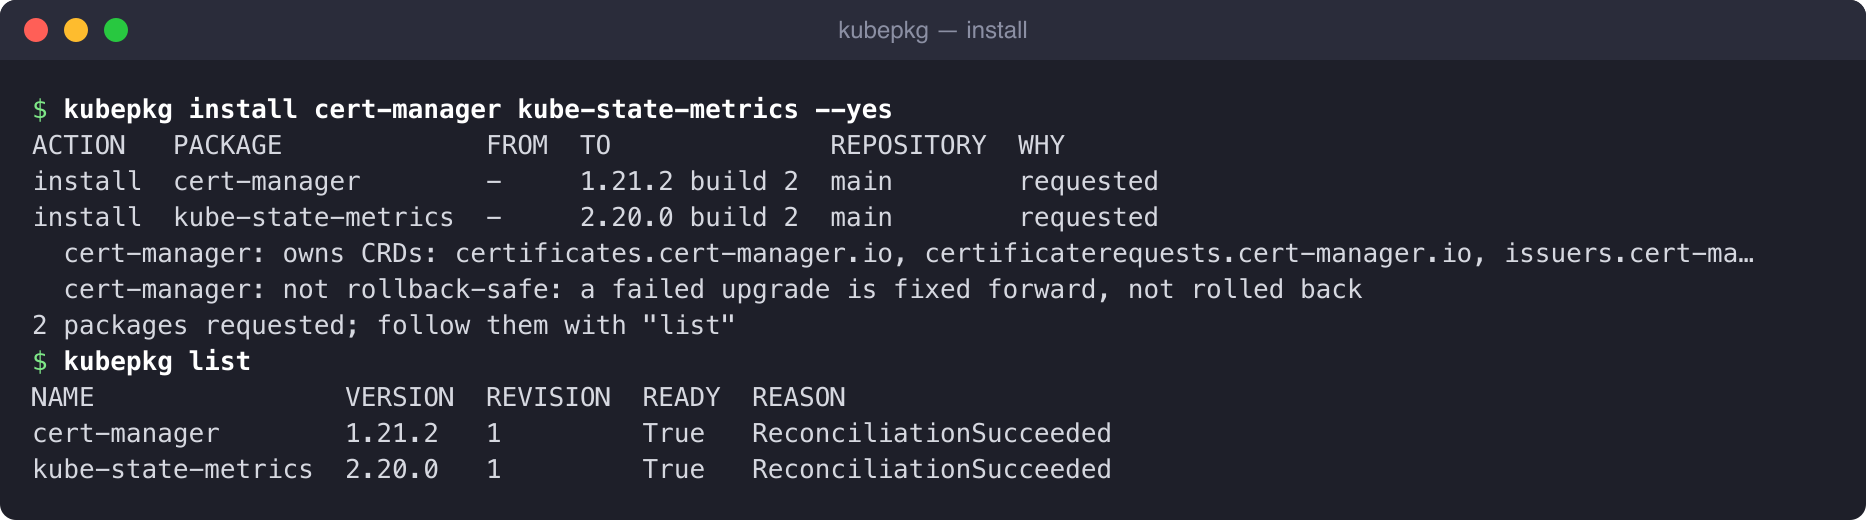
kubepkg install
Jede Änderung an einem Paket, ob neue Version oder andere Values, erzeugt eine neue Revision. Die alten bleiben erhalten, und Sie können zu jeder von ihnen zurückkehren. Auch ein Rollback erzeugt eine neue Revision mit dem alten Inhalt, die Historie wächst also nur und wird nie umgeschrieben:
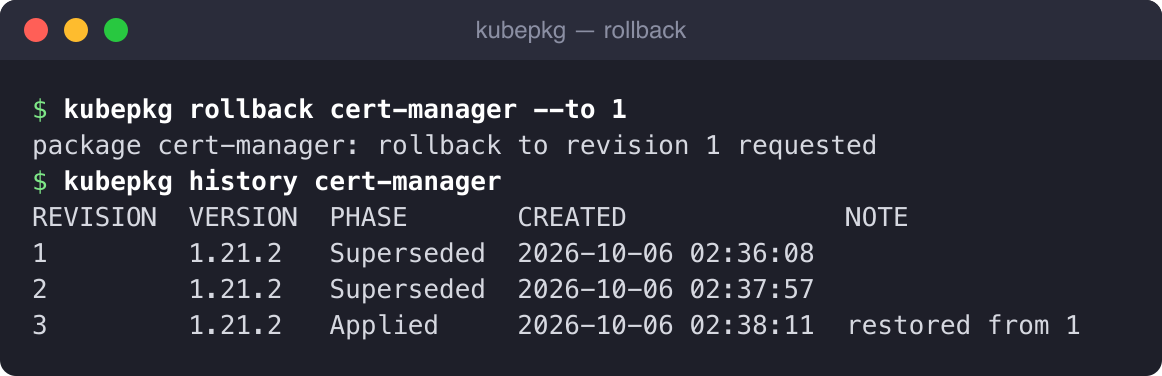
kubepkg rollback
Ein Paket-Repository, aus den Quellen gebaut
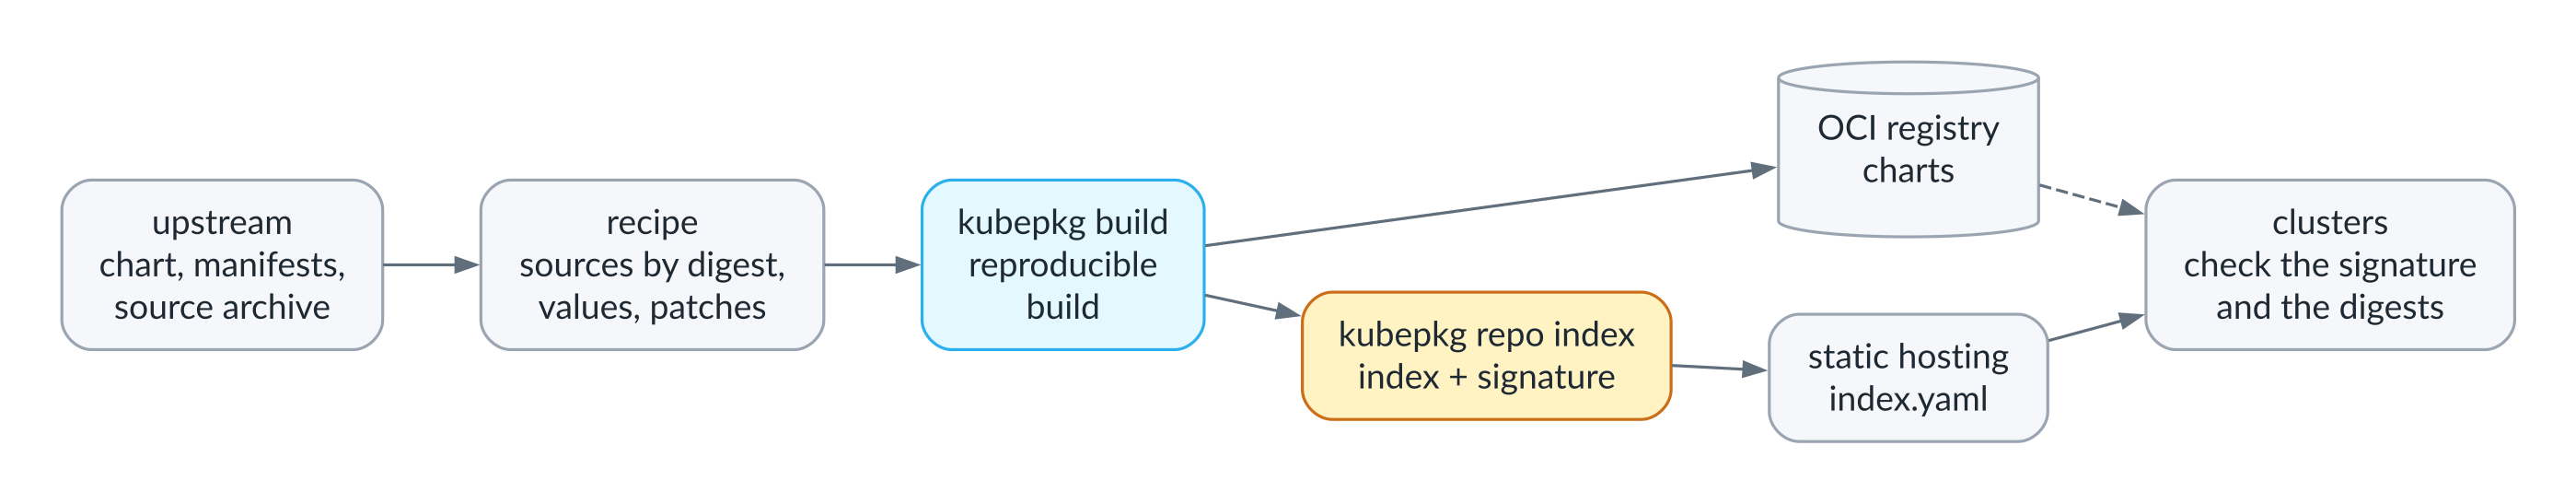
Wie das Repository gebaut wird
Die wichtigste Idee, die ich mir bei Debian geliehen habe: Pakete baut der Maintainer des Repositorys, nicht der Autor der Software. Debian baut seine .deb-Dateien aus Upstream-Quellen, und kubepkg macht es genauso. Dabei spielt es keine Rolle, was Upstream ausliefert: ein fertiges Helm-Chart, einen Satz Manifeste oder einen Quell-Tarball, in dem irgendwo ein Chart vergraben ist. Der Maintainer schreibt ein Rezept, in dem jede Quelle per Digest festgelegt ist, gefolgt von der Anleitung, wie daraus ein Chart wird: welche Values gesetzt, welche Patches angewendet, welche Objekte weggelassen werden.
Ein Rezept für ein neues Paket müssen Sie nicht von Grund auf schreiben: kubepkg init lädt das Upstream-Release herunter, legt es fest, listet seine CRDs und Images auf und schreibt einen Entwurf, den Sie dann verfeinern. Gleich zeige ich das an einem echten Beispiel.
Hier ist ein Ausschnitt aus dem echten KubeVirt-Rezept. Es wird aus den Release-Manifesten gebaut statt aus einem Drittanbieter-Chart, und ein Patch entfernt die verpflichtende Affinity von virt-operator zu Control-Plane-Nodes, die Managed Cluster nicht für das Scheduling freigeben:
spec:
  version: 1.9.0          # upstream version
  build: 4                # our fourth build of this version
  sources:
    operator:
      url: https://github.com/kubevirt/kubevirt/releases/download/v1.9.0/kubevirt-operator.yaml
      sha256: f11307caafc3c23ffedf9887d8beb5a4419e2694da242fa68f63d1ec820de2e0
  charts:
    kubevirt-operator:
      from: [operator]    # plain manifests get wrapped into a chart
      exclude: [{kind: Namespace}]
      patches:
        - kind: Deployment
          name: virt-operator
          merge: {...}
kubepkg build macht aus dem Rezept ein Chart in einer Registry, und kubepkg repo index fasst jede Version jedes Pakets in einem einzigen Index zusammen und signiert ihn. Dasselbe Rezept ergibt immer denselben Inhalt, bis auf den Digest genau. Eine Installation in einen Cluster greift nie wieder auf Upstream zu: Alles, was sie braucht, liegt in Ihrer Registry und ist per Digest im signierten Index festgelegt. Eine veröffentlichte Version ändert sich nie; ein Fix kommt als neuer Build derselben Version.
Der Index ist eine einzige statische Datei, die Sie auf GitHub Pages, in S3 oder hinter nginx ablegen können. Genau so funktioniert das öffentliche Repository: Jeder Merge nach main baut die Pakete, schiebt die Charts in die GitHub Container Registry und veröffentlicht einen signierten Index auf Pages.
Beispiel: vom Entwurf zur Installation
Gehen wir den ganzen Weg auf einem echten Cluster. Wir nehmen podinfo, eine kleine Demo-Anwendung mit offiziellem Helm-Chart, und veröffentlichen sie in einem eigenen Repository. Registry und Webserver für den Index laufen hier direkt im Cluster, aber mit GitHub Container Registry und Pages sieht alles genauso aus.
Alles beginnt mit einem Rezeptentwurf. kubepkg hat das Chart heruntergeladen, per Digest festgelegt und, was wichtig ist, es selbst gerendert und jedes Image aufgelistet, das es ausführt, ebenfalls per Digest:
$ kubepkg init podinfo --chart oci://ghcr.io/stefanprodan/charts/podinfo@6.9.2
wrote podinfo/recipe.yaml; review it, then run: kubepkg validate podinfo
$ cat podinfo/recipe.yaml
apiVersion: kubepkg.dev/v1
kind: Recipe
metadata:
  name: podinfo
  annotations:
    kubepkg.dev/description: "Podinfo Helm chart for Kubernetes"
    kubepkg.dev/home: https://github.com/stefanprodan/podinfo
spec:
  version: 6.9.2
  build: 1
  sources:
    upstream:
      chart:
        repository: oci://ghcr.io/stefanprodan/charts
        name: podinfo
        version: "6.9.2"
        digest: sha256:8eacab4365d917867e855bfb4729afdbff28bead3fd9dc01923ab50b26aa4380
  charts:
    podinfo:
      from: [upstream]
      # values: {}                   # the package's defaults over the upstream ones
  package:
    provides: [podinfo]
    crds: []
    images:   # what the charts run, pinned; add images an operator deploys on its own
      - docker.io/curlimages/curl:7.69.0@sha256:d845b6dd655da0e9ae0623065a35185f9b4438aa717fd1c9a3b89843e8b4ff26
      - docker.io/giantswarm/tiny-tools:latest@sha256:8ccea5962d6e24cf90ac726ff8af6ad25ba8dc6a691ad47cb455e3dfcd3f4c22
      - docker.io/stefanprodan/grpc_health_probe:v0.3.0@sha256:0d7bd9c77ef35c3f0432142b5689ae460331a4fecfa469590fe11f3d575669e4
      - ghcr.io/stefanprodan/podinfo:6.9.2@sha256:cab90e04829cdae73199a8402882a4e3ccaf251b8a0d50bdefede0ab3f6371e7
    rollback:
      safe: false   # true once rolling back to the previous version is known not to lose data
    variants:
      - name: default
        components:
          - name: podinfo
            path: podinfo
            install: {namespace: podinfo}
Der Entwurf ist nur ein Ausgangspunkt; die Entscheidungen darin trifft der Maintainer. Hier habe ich standardmäßig zwei Replicas gesetzt und den Rollback für sicher erklärt, weil podinfo nichts speichert und der vorherige Build jederzeit wieder starten kann. Validierung, Build und Veröffentlichung sind vier Befehle:
$ grep -n -E 'values:|safe:' podinfo/recipe.yaml
21:      values: {replicaCount: 2}
31:      safe: true    # stateless: the previous build can always run again
$ kubepkg validate podinfo
podinfo: ok
$ kubepkg build podinfo --registry oci://demo.demo.svc:5000/demo --plain-http -o dist
published oci://demo.demo.svc:5000/demo/podinfo, wrote dist/podinfo-6.9.2-1.yaml
$ kubepkg repo keygen demo
wrote demo.key (private) and demo.pub
$ kubepkg repo index dist --plain-http --sign-key demo.key -o /site/demo/index.yaml
signed /site/demo/index.yaml.sig
wrote /site/demo/index.yaml: 1 packages, 1 versions
$ ls /site/demo
index.yaml
index.yaml.sig
Die Registry enthält jetzt das Chart, der Webserver den signierten Index. Bleibt nur noch, den Cluster das Repository abonnieren zu lassen und das Paket zu installieren:
$ kubepkg repo add demo http://demo.demo.svc:8000/demo/index.yaml --public-key demo.pub
repository demo added
$ kubepkg search podinfo
NAME     LATEST  REPOSITORY  DESCRIPTION
podinfo  6.9.2   demo        Podinfo Helm chart for Kubernetes
$ kubepkg plan podinfo
ACTION   PACKAGE  FROM  TO             REPOSITORY  WHY
install  podinfo  -     6.9.2 build 1  demo        requested
$ kubepkg install podinfo --yes
ACTION   PACKAGE  FROM  TO             REPOSITORY  WHY
install  podinfo  -     6.9.2 build 1  demo        requested
1 packages requested; follow them with "list"
$ kubepkg list
NAME                VERSION  REVISION  READY  REASON
cert-manager        1.21.2   2         True   ReconciliationSucceeded
kube-state-metrics  2.20.0   1         True   ReconciliationSucceeded
podinfo             6.9.2    1         True   ReconciliationSucceeded
$ kubectl -n podinfo get deploy,pods
NAME                      READY   UP-TO-DATE   AVAILABLE   AGE
deployment.apps/podinfo   2/2     2            2           10s

NAME                          READY   STATUS    RESTARTS   AGE
pod/podinfo-c4fdfd856-7sd7c   1/1     Running   0          10s
pod/podinfo-c4fdfd856-f628c   1/1     Running   0          10s
Von einem Link auf das Chart eines anderen bis zu einem laufenden Paket im eigenen signierten Repository hat es etwa zehn Befehle gebraucht, und für keinen davon musste man ein Template schreiben.
Warum sich nicht alles zurückrollen lässt
Im ersten Teil habe ich erklärt, warum ein Rollback mit Snapshots des Cluster-Zustands nicht funktioniert: Ein Snapshot von Objekten rollt keine Daten zurück. Hat eine neue KubeVirt-Version die gespeicherten Objekte bereits auf eine neue API-Version migriert, bringt das Zurückspielen der alten Manifeste die alten Daten nicht zurück; eher macht es kaputt, was noch funktioniert hat. So geht kubepkg in der Praxis damit um.
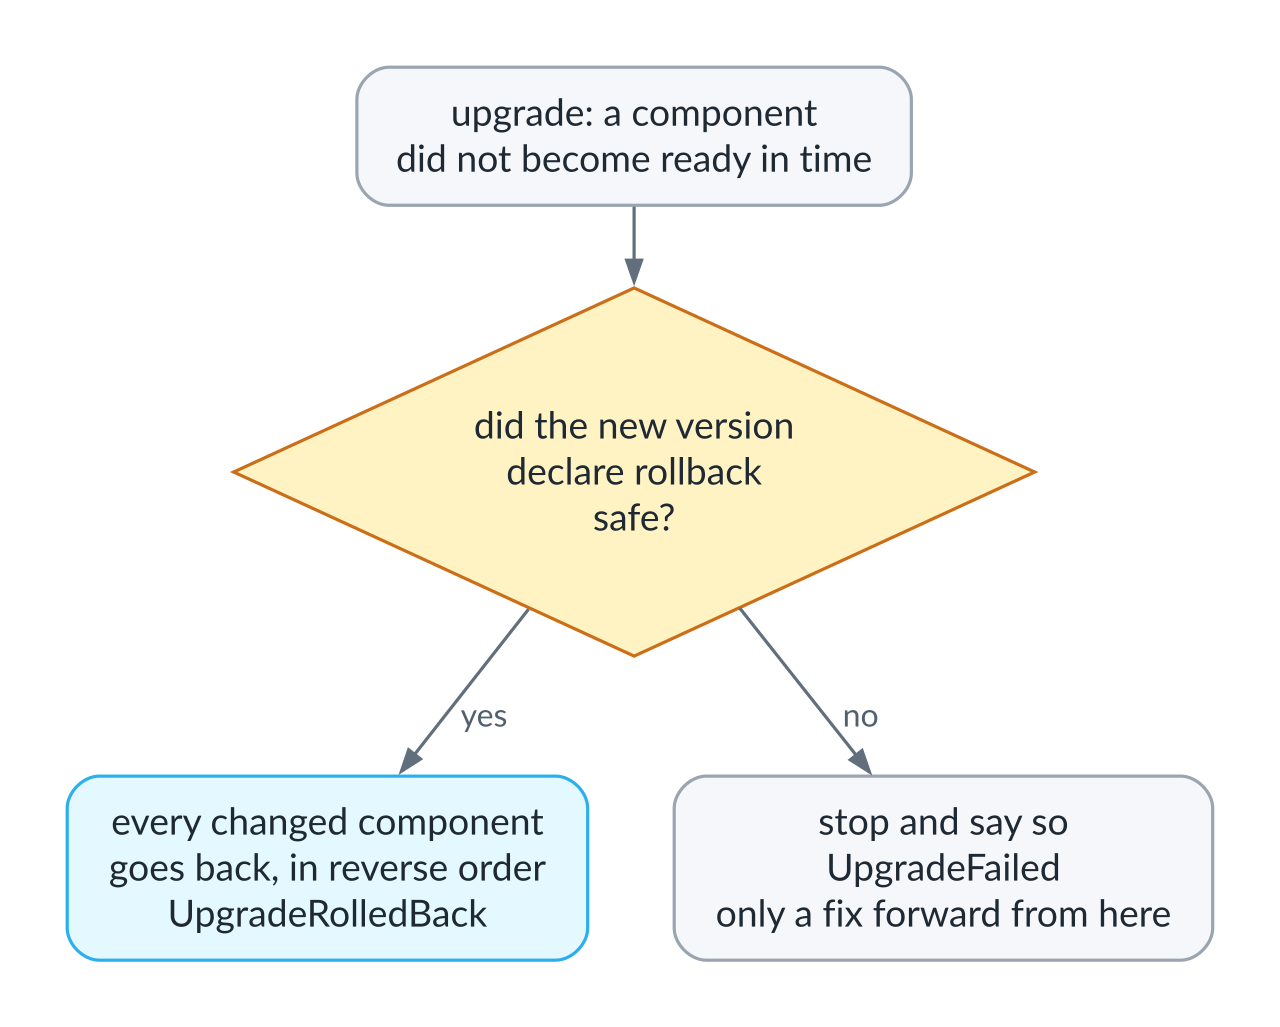
Die Entscheidung über den Rollback
Ob ein Rollback sicher ist, erklärt der Autor der neuen Paketversion, denn nur er weiß, was ihre Migrationen tun. Scheitert ein Upgrade und hat die neue Version den Rollback für sicher erklärt, kehrt jede bereits geänderte Komponente in umgekehrter Reihenfolge zur vorherigen Revision zurück. Hat sie das nicht, hält kubepkg an und sagt klar, dass das Upgrade gescheitert ist und der einzige Ausweg ein Roll-forward mit einem Fix ist. Ein Rollback, der Daten beschädigt, ist schlimmer als ein gescheitertes Upgrade. Für Fälle, in denen vor einem Upgrade etwas passieren muss, etwa ein Backup oder eine Migration, kann ein Paket eine Pre-Upgrade-Komponente enthalten, typischerweise einen Job, der die Ausgangs- und die Zielversion übergeben bekommt.
Live: Ein schlechter Build rollt sich selbst zurück
Zurück zu podinfo. Diesen Teil habe ich später aufgenommen, in einem separaten Lauf auf einem Cluster, auf dem auch Virtualisierung läuft, deshalb sieht die Paketliste anders aus. Das podinfo-Rezept erklärt den Rollback für sicher. Damit das Warten kurz bleibt, geben wir dem Paket zwei Minuten, um bereit zu werden, und lassen das Repository alle dreißig Sekunden neu einlesen. Auch eine Änderung am Paket wird als Revision festgehalten, deshalb bekommt podinfo jetzt Revision 2:
$ kubectl patch package podinfo --type merge -p '{"spec":{"upgrade":{"timeout":"2m"}}}'
package.kubepkg.dev/podinfo patched
$ kubectl patch repository demo --type merge -p '{"spec":{"interval":"30s"}}'
repository.kubepkg.dev/demo patched
Stellen wir uns jetzt vor, der Maintainer liefert einen schlechten Build aus. In diesem Build startet podinfo, wird aber nie bereit, wie eine Anwendung, die nach einem Upgrade ihre Datenbank nicht erreicht oder ihre eigenen Health Checks nicht besteht:
$ grep -n -E 'build:|values:' podinfo/recipe.yaml
10:  build: 2
21:      values: {replicaCount: 2, faults: {unready: true}}
$ kubepkg build podinfo --registry oci://demo.demo.svc:5000/demo --plain-http -o dist
published oci://demo.demo.svc:5000/demo/podinfo, wrote dist/podinfo-6.9.2-2.yaml
$ kubepkg repo index dist --plain-http --merge /site/demo/index.yaml --sign-key demo.key -o /site/demo/index.yaml
signed /site/demo/index.yaml.sig
wrote /site/demo/index.yaml: 1 packages, 2 versions
Eine halbe Minute später sieht der Operator den neuen Build im Index und startet das Upgrade. Die neuen Pods sind nicht bereit, während ein alter Pod noch läuft und Anfragen beantwortet:
$ kubepkg list
NAME            VERSION  REVISION  READY  REASON
cdi             1.66.1   5         True   ReconciliationSucceeded
cert-manager    1.21.2   5         True   ReconciliationSucceeded
kubevirt        1.9.0    4         True   ReconciliationSucceeded
podinfo         6.9.2    2         False  Progressing
virtualization  1.0.0    1         True   ReconciliationSucceeded
$ kubectl -n podinfo get pods
NAME                       READY   STATUS    RESTARTS   AGE
podinfo-84df66bbb8-bwpkg   0/1     Running   0          7s
podinfo-84df66bbb8-vlcwb   0/1     Running   0          7s
podinfo-c4fdfd856-kjts4    1/1     Running   0          116s
Zwei Minuten später läuft das Timeout ab. Der neue Build erklärt den Rollback weiterhin für sicher (der Maintainer hat nur die Values geändert), also holt kubepkg von selbst den vorherigen zurück, ohne auf einen Menschen zu warten. Revision 3 wird mit Begründung als fehlgeschlagen markiert, und Revision 4 stellt den Inhalt von Revision 2 wieder her:
$ kubepkg history podinfo
REVISION  VERSION  PHASE       CREATED              NOTE
1         6.9.2    Superseded  2026-10-18 08:33:16
2         6.9.2    Superseded  2026-10-18 08:34:34
3         6.9.2    Failed      2026-10-18 08:35:04  component podinfo failed: upgrade podinfo/podinfo: resource Deployment/podinfo/podinfo not ready. status: InProgress, message: Pending termination: 1 context deadline exceeded
4         6.9.2    Applied     2026-10-18 08:37:08  restored from 2
$ kubectl get package podinfo -o jsonpath='{range .status.conditions[*]}{.type}={.status} {.reason}: {.message}{"\n"}{end}'
Ready=False UpgradeRolledBack: revision 3 failed (component podinfo failed: upgrade podinfo/podinfo: resource Deployment/podinfo/podinfo not ready. status: InProgress, message: Pending termination: 1
context deadline exceeded), restored revision 2; failed 1 time(s), trying again at 2026-10-18T08:37:35Z, or set kubepkg.dev/retry to try now
$ kubectl get package podinfo -o jsonpath='{.status.retry}{"\n"}'
{"attempts":1,"nextAttempt":"2026-10-18T08:37:35Z"}
$ kubectl -n podinfo get pods
NAME                      READY   STATUS    RESTARTS   AGE
podinfo-c4fdfd856-kdllf   1/1     Running   0          10s
podinfo-c4fdfd856-kjts4   1/1     Running   0          3m59s
Das Paket bleibt absichtlich nicht bereit. Es führt den vorherigen Build aus, aber der gewünschte Zustand, der neueste Build im Repository, ist nicht erreicht, und davon sollte ein Mensch erfahren, nicht nur das Log des Operators. Aufgegeben wird trotzdem nicht. Es versucht dasselbe Upgrade von selbst erneut, zuerst nach dreißig Sekunden, dann mit jeweils doppelter Wartezeit bis zu zehn Minuten, und hält in status.retry fest, wie viele Versuche es gab und wann der nächste fällig ist. So erholt sich ein Cluster, den niemand beobachtet, von selbst von einem vorübergehenden Fehler oder übernimmt einen reparierten Build 3, sobald der Maintainer ihn veröffentlicht. Eine Änderung am Paket oder die Annotation kubepkg.dev/retry wirkt sofort, ein Rollback dagegen, den ein Mensch mit kubepkg rollback ausgelöst hat, wird nie wiederholt. So sieht es ein paar Minuten später aus, noch ohne reparierten Build. Inzwischen ist das Upgrade zweimal gescheitert, der Operator hat beide Male die funktionierende Version wiederhergestellt und wartet eine Minute bis zum nächsten Versuch:
$ kubepkg history podinfo
REVISION  VERSION  PHASE       CREATED              NOTE
1         6.9.2    Superseded  2026-10-18 08:33:16
2         6.9.2    Superseded  2026-10-18 08:34:34
3         6.9.2    Failed      2026-10-18 08:35:04  component podinfo failed: upgrade podinfo/podinfo: resource Deployment/podinfo/podinfo not ready. status: InProgress, message: Pending termination: 1 context deadline exceeded
4         6.9.2    Superseded  2026-10-18 08:37:08  restored from 2
5         6.9.2    Failed      2026-10-18 08:37:35  component podinfo failed: upgrade podinfo/podinfo: resource Deployment/podinfo/podinfo not ready. status: InProgress, message: Pending termination: 1 context deadline exceeded
6         6.9.2    Applied     2026-10-18 08:39:38  restored from 4
$ kubectl get package podinfo -o jsonpath='{.status.retry}{"\n"}'
{"attempts":2,"nextAttempt":"2026-10-18T08:40:35Z"}
Die Bereitschaft ist ein eigenes Problem. Selbst mit --wait hält Helm ein Release für bereit, sobald die von ihm erzeugten Objekte bereit melden; was ein Operator danach tut, weiß es nicht. Das KubeVirt-Chart erzeugt eine einzige KubeVirt-Ressource und kehrt sofort zurück, und der Operator braucht dann noch mehrere Minuten, um den eigentlichen Virtualisierungs-Stack auszurollen. Ein Paket kann die Bedingung angeben, unter der eine Komponente wirklich bereit ist, zum Beispiel wenn die KubeVirt-Ressource die Condition Available meldet, und bis das erfüllt ist, startet die nächste Komponente nicht, und Pakete, die davon abhängen, warten.
CRDs als Teil des Pakets
CRDs sind für jeden Paketmanager unbequem. Sie gehören dem ganzen Cluster: Ein Cluster hält genau eine Kopie jeder CRD, zwei Releases können also nicht jeweils ihre eigene Kopie nebeneinander mitbringen. Sie überleben das Release, das sie installiert hat, und wer eine CRD löscht, löscht jedes Objekt dieses Typs in jedem Namespace. Helms Antwort ist radikal: CRDs im Verzeichnis crds werden einmal installiert und nie aktualisiert.
kubepkg macht CRD-Ownership zu einem eigenständigen Konzept. Ein Paket erklärt, welche CRDs ihm gehören, und der Plan zeigt das, bevor irgendetwas installiert wird. Zwei Pakete können nicht dieselbe CRD besitzen, und kubepkg verweigert die Installation eines zweiten Pakets, das eine bereits vergebene CRD für sich beansprucht. Eine CRD lässt sich von einem Paket an ein anderes übergeben, etwa wenn eine Komponente in ein anderes Paket umzieht. Wird ein Paket entfernt, bleiben seine CRDs standardmäßig samt ihren Objekten im Cluster, und um sie zu löschen, muss man das ausdrücklich verlangen. Außerdem sorgt kubepkg dafür, dass Helm nicht stillschweigend CRDs löscht, die ein Chart in seinen Templates mitliefert und in einer neuen Version weglässt.
Vertrauen: signierte Indizes, eine Root of Trust nach TUF und festgelegte Images
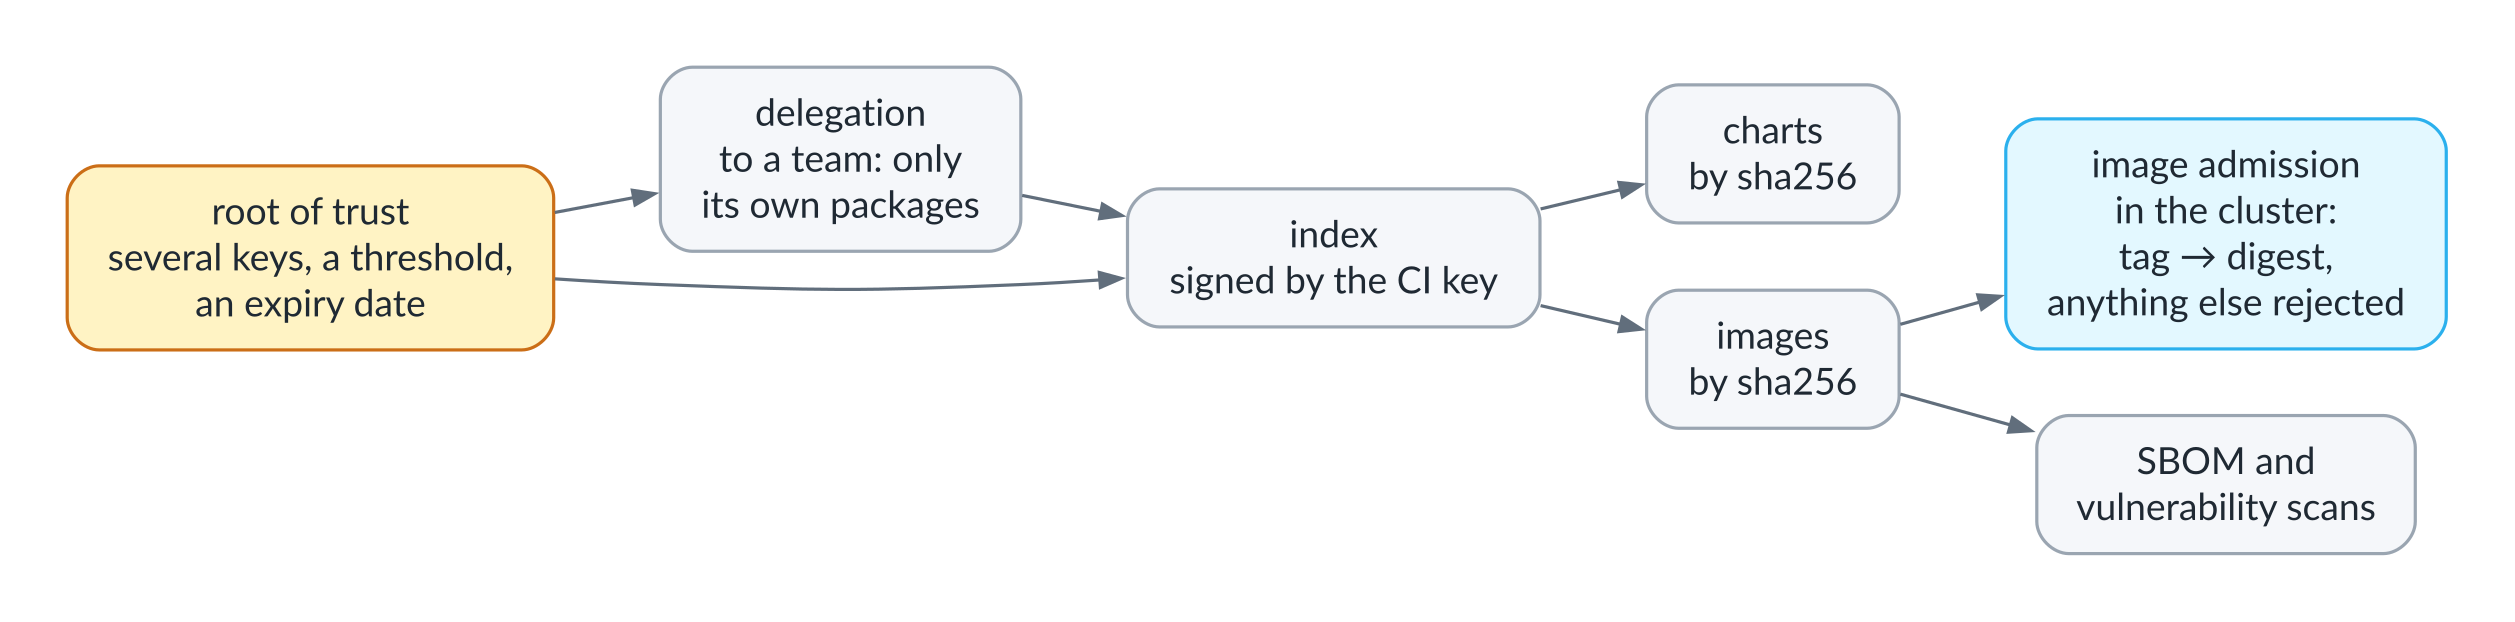
Die Vertrauenskette
Jedes Repository bringt eigene Schlüssel mit, und der Cluster entscheidet selbst, wem er vertraut. Ein unsigniertes Repository akzeptiert er nur, wenn das ausdrücklich erlaubt ist.
Ein einfaches Repository wird mit einem einzigen Schlüssel signiert. Ein ernsthaftes bekommt eine Root of Trust nach dem Design von TUF (The Update Framework): eine signierte Datei, die festhält, welchen Schlüsseln der Cluster vertraut und was jeder davon signieren darf. Es gibt mehrere Root-Schlüssel, die verschiedene Personen offline aufbewahren, und eine Änderung der Root braucht eine festgelegte Zahl ihrer Signaturen, etwa zwei beliebige von dreien. Ein einzelner gestohlener oder verlorener Schlüssel entscheidet also nichts. Den Index selbst signiert ein separater Schlüssel, der in der CI liegt. Wird dieser Schlüssel kompromittiert, veröffentlichen die Inhaber der Root-Schlüssel eine neue Root-Version mit einem neuen Index-Schlüssel, und die Cluster übernehmen ihn, indem sie der Kette der Roots folgen, ohne Änderung an ihrer Konfiguration. Ein Index kann ein Ablaufdatum tragen, und ein Cluster akzeptiert nie einen Index, der älter ist als der, den er bereits hat. Das schützt Cluster davor, dass ihnen jemand einen alten Index voller alter, verwundbarer Versionen unterschiebt. Schließlich kann die Root of Trust einige Pakete an ein anderes Team übergeben: Die Schlüssel eines Teams gelten nur für die an es delegierten Pakete, und Versionen dieser Pakete werden nur mit genügend Signaturen des Teams akzeptiert, sodass der CI-Schlüssel allein sie nicht mehr veröffentlichen kann. So funktioniert Vertrauen in großen Archiven, in denen verschiedene Pakete von verschiedenen Menschen gepflegt werden.
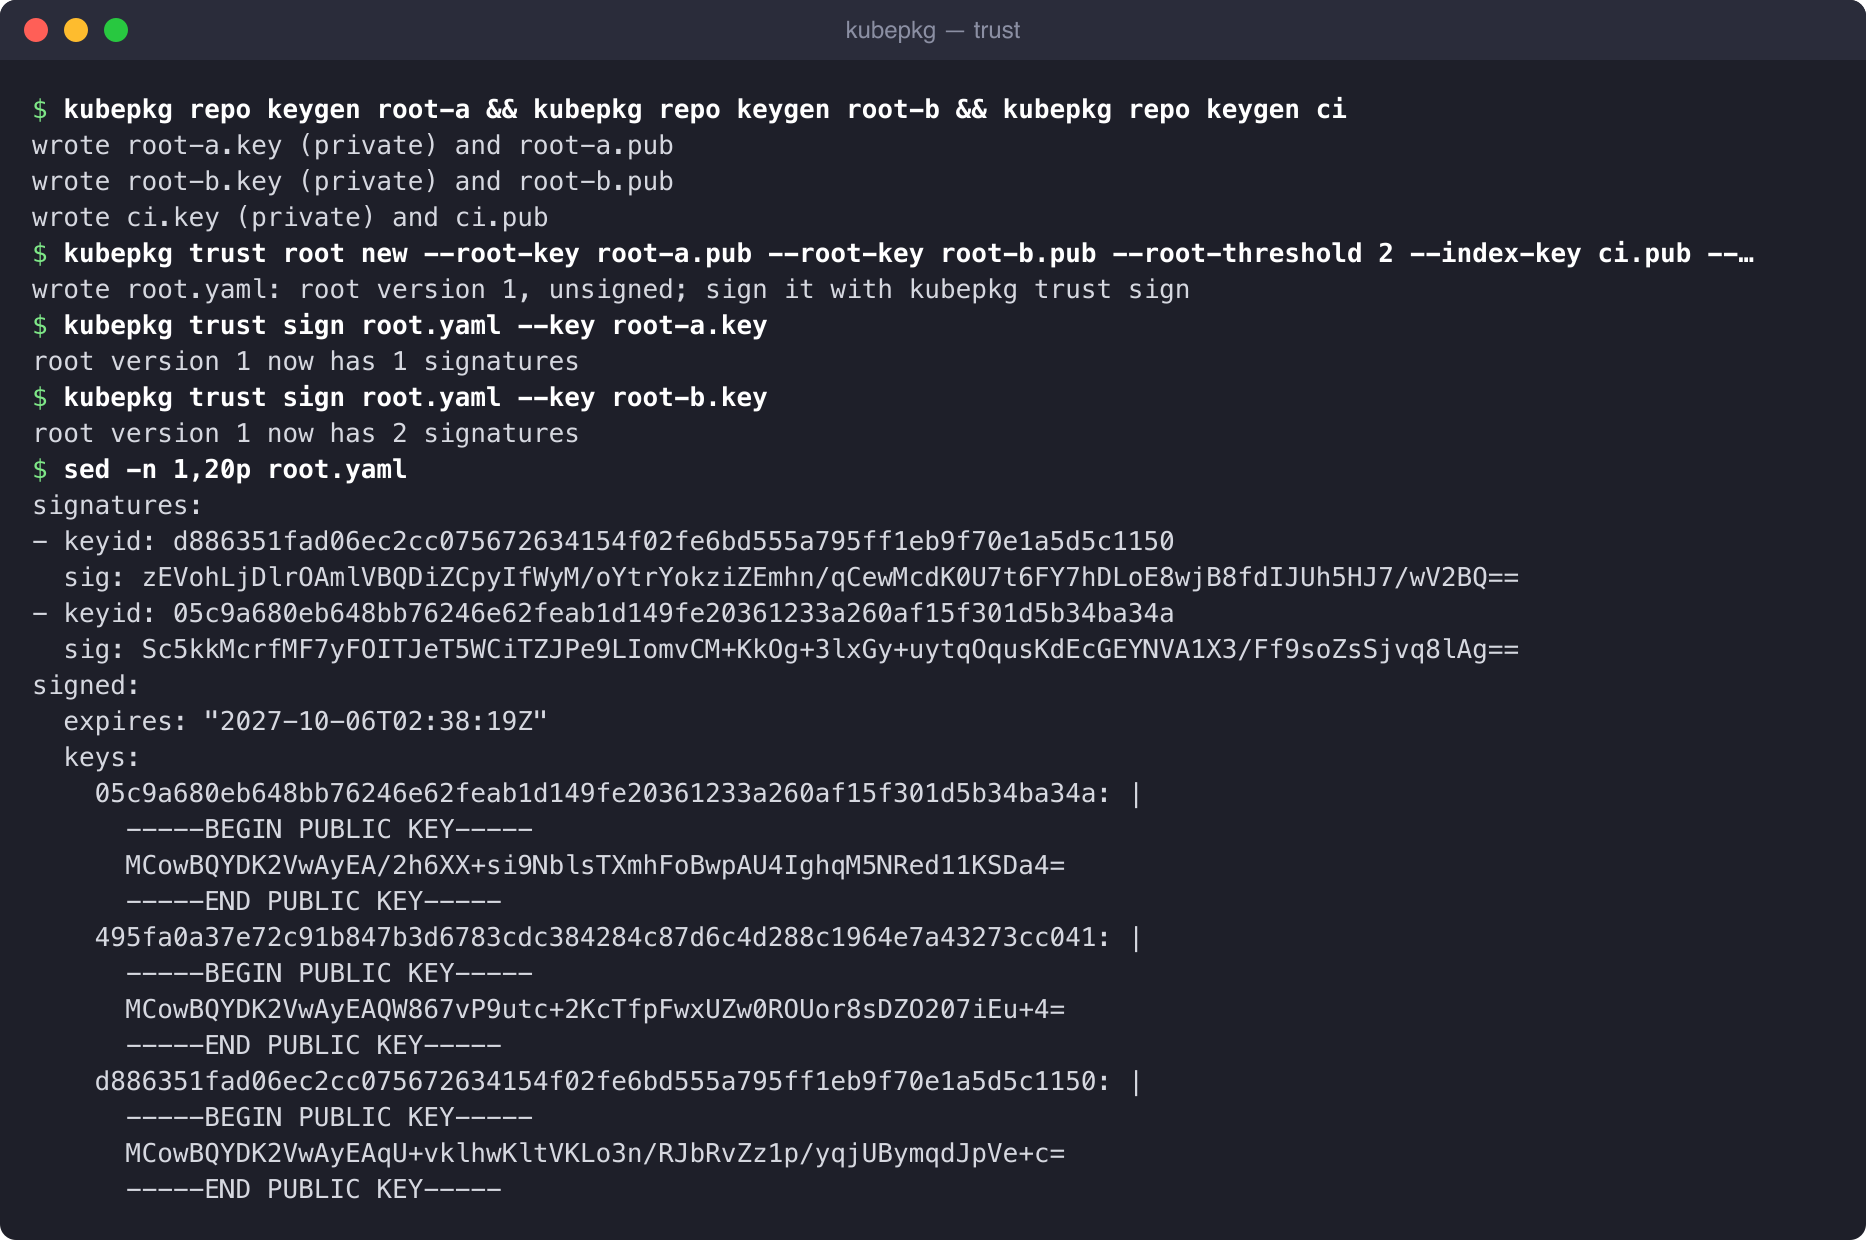
Eine Root of Trust mit zwei Schlüsseln
Weil der Index jedes Chart und jedes Image, das die Rezepte auflisten, per Digest festlegt, deckt seine Signatur ab, was das Repository in einen Cluster installiert. Das eröffnet drei weitere Möglichkeiten. kubepkg sbom schreibt eine Software Bill of Materials (SBOM) im CycloneDX-Format, für ein einzelnes Paket oder für den ganzen Cluster. kubepkg scan lässt Trivy gegen jedes Image laufen, das die Pakete festlegen, und kann einen CI-Job scheitern lassen, wenn kritische Schwachstellen gefunden werden. Und mit der Image-Policy setzt der Cluster durch, dass in Paket-Namespaces genau die Images laufen, die der Index festgelegt hat.
Letzteres lohnt einen genaueren Blick. Charts referenzieren Images fast immer per Tag, und ein Tag in der Registry eines anderen kann jederzeit auf ein anderes Image zeigen. Wenn ein Pod erstellt wird, hängt der mutierende Admission Webhook von kubepkg den festgelegten Digest an das Tag an, sodass die Nodes genau das Image ziehen, für das der Index bürgt. Im Modus enforce wird ein Image, das kein installiertes Paket festlegt, schlicht abgelehnt:
Error from server: admission webhook "pods.images.kubepkg.dev" denied the request: no installed package pins docker.io/library/busybox:1.36; namespace cert-manager runs only images packages pin (kubepkg.dev/image-policy=enforce)
Das Zertifikat des Webhooks stellt der Operator selbst aus und erneuert es auch selbst. Das ist Absicht: kubepkg darf nicht von cert-manager abhängen, weil es durchaus dasjenige sein kann, das cert-manager installiert.
Ohne Internet: Air-Gap-Installationen aus einem verifizierten Bundle
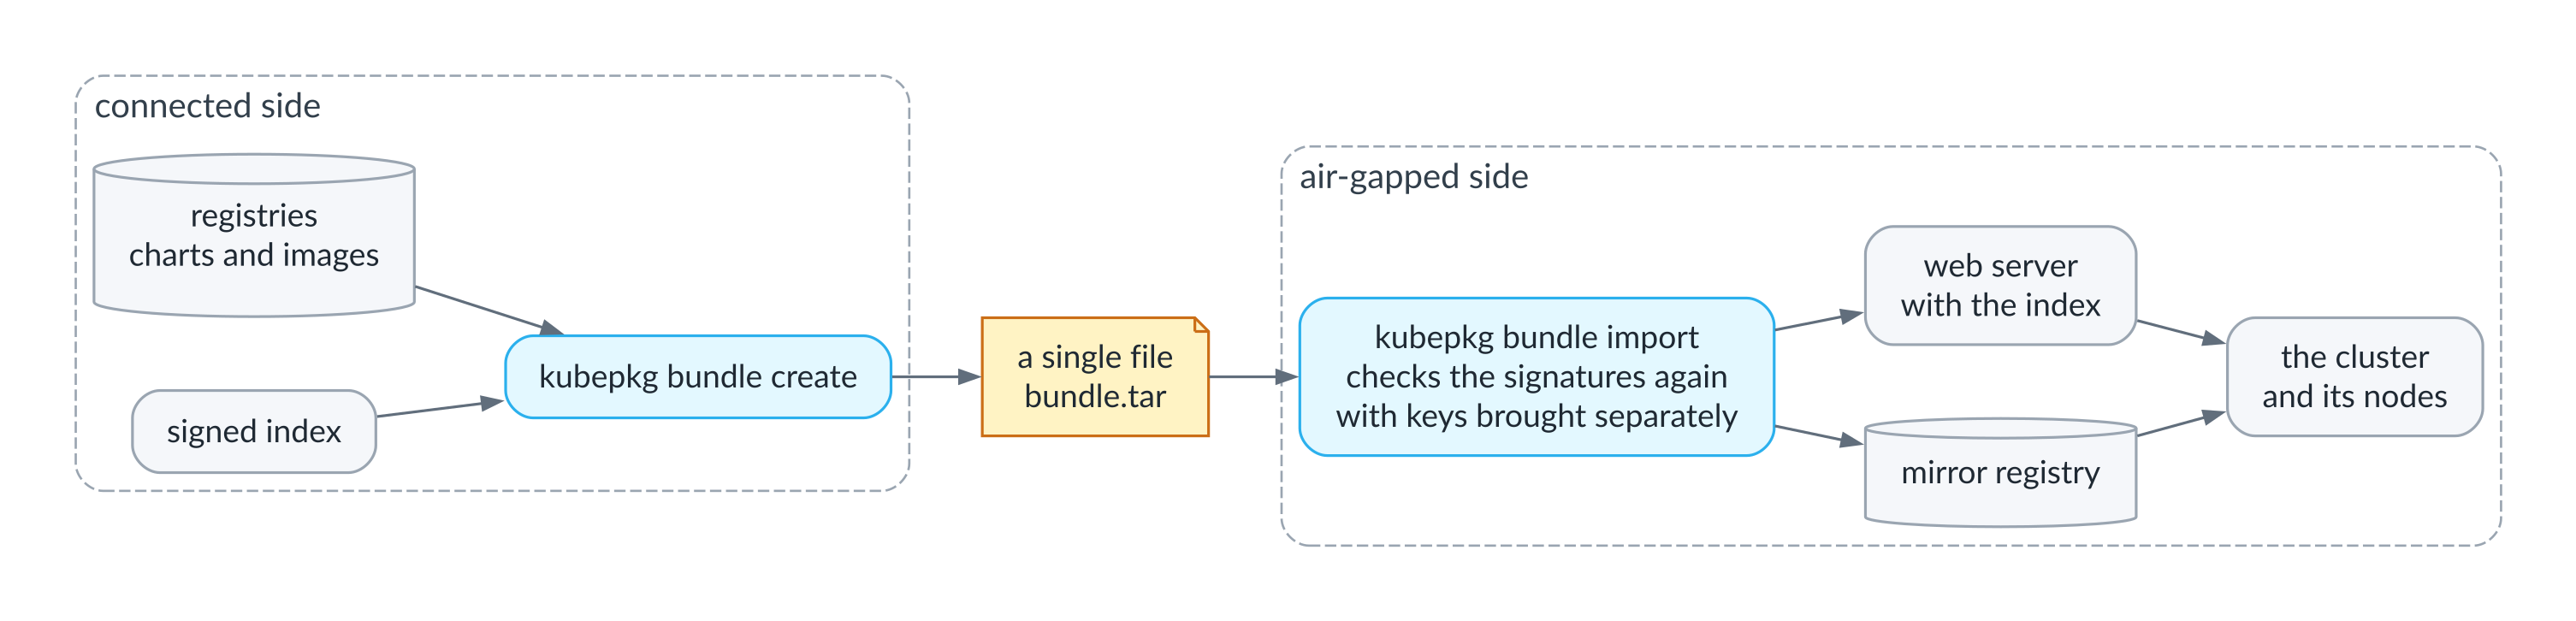
Installation in einer Air-Gap-Umgebung
Viele Cluster sehen das Internet nie: Behörden, Banken, Industrieanlagen, souveräne Clouds. Für solche Air-Gap-Umgebungen baut kubepkg ein Bundle, eine einzige Datei mit dem signierten Repository-Index, den Charts der ausgewählten Pakete samt all ihren Abhängigkeiten und jedem Image, das diese Pakete ausführen.
Was folgt, ist ein echter Lauf auf einem Testcluster. Der kubepkg-Operator darin ist durch eine Cilium-Network-Policy von der Außenwelt abgeschnitten und sieht nur den Cluster selbst; eine Mirror-Registry und ein Webserver für den Index laufen im Cluster. Das Bundle wird auf einem Rechner mit Internetzugang aus dem öffentlichen Repository gebaut:
$ kubepkg bundle create cert-manager kube-state-metrics --repo https://kuberoot-dev.github.io/kubepkg-recipes/index.yaml --public-key index.pub -o platform-2026-10.tar
wrote platform-2026-10.tar: 2 packages, 2 charts, 0 package trees, 5 images
$ ls -lh platform-2026-10.tar
-rw-r--r--. 1 root root 377M Oct 12 03:30 platform-2026-10.tar
$ kubepkg bundle inspect platform-2026-10.tar
created 2026-10-12T03:30:25Z

PACKAGE             VERSION         REPOSITORY
cert-manager        1.21.2 build 3  main
kube-state-metrics  2.20.0 build 3  main

IMAGE                                                                                                                                  PINNED BY   PACKAGES
quay.io/jetstack/cert-manager-cainjector:v1.21.2@sha256:c85268c64f2e0e76684bf5fe8906caff34b82523561c6affe0fae3546bd87562               repository  cert-manager
quay.io/jetstack/cert-manager-controller:v1.21.2@sha256:70f532fd9cfde0b09d55687200942399d89838bc2d5d5b45152eb799a15912b8               repository  cert-manager
quay.io/jetstack/cert-manager-startupapicheck:v1.21.2@sha256:46e75b6866359ffb5d82624f41e3ed1c70b2994982702ced547ce5edb418a8f5          repository  cert-manager
quay.io/jetstack/cert-manager-webhook:v1.21.2@sha256:a60e2dac46dbb8a7f3df95c54ce941012f54c2fe022f0ee55aaa1ab40ed957ae                  repository  cert-manager
registry.k8s.io/kube-state-metrics/kube-state-metrics:v2.20.0@sha256:42cfe3723a5f058171c627537fb57a3ea0f26e4380fa18555a95cb1a1b4cfc5b  repository  kube-state-metrics

2 charts, 0 package trees
Jedes Image in der Liste ist per Digest festgelegt, und zwar vom Repository, also vom signierten Index, nicht vom Bundle selbst. Das ist für das Folgende wichtig.
Spannend wird es innerhalb des Air-Gaps. kubepkg vertraut einem Bundle nicht schon deshalb, weil es aufgetaucht ist. Füttern wir den Import zuerst mit einem Bundle, in dem ein Chart unterwegs beschädigt wurde, simuliert durch ein einzelnes Byte, das an sein Archiv angehängt wurde:
$ kubepkg bundle import tampered.tar --public-key index.pub --mirror oci://demo.demo.svc:5000/mirror --plain-http --site /site
error: the bundle does not check out: chart kube-state-metrics 2.20.0-3 in the bundle has digest sha256:ff78152558d651ae9564bdb4a2ec705d7e234be872e83753398596ff79fda8df, the package pins sha256:2bf8279f5f6195dfb6332dfb8c1251bdcf5a00754dd97102411a614f685d329e
Die Manipulation wird erkannt, und die Fehlermeldung zeigt beide Digests: den, den wir bekommen haben, und den, den das signierte Paket festgelegt hat. Als Nächstes nehmen wir das echte Bundle, prüfen es aber mit dem falschen Schlüssel:
$ kubepkg bundle import platform-2026-10.tar --public-key other.pub --mirror oci://demo.demo.svc:5000/mirror --plain-http --site /site
error: the bundle does not check out: repository main: index is not signed by a trusted key
Die vertrauenswürdigen Schlüssel nimmt kubepkg nur von der Kommandozeile, nie aus dem Bundle selbst. Sie müssen den Air-Gap also separat überqueren, zum Beispiel zusammen mit Ihrer Konfiguration. Mit dem richtigen Schlüssel legt der Import alles an seinen Platz und schreibt zusätzlich Einstellungen für die Nodes:
$ kubepkg bundle import platform-2026-10.tar --public-key index.pub --mirror oci://demo.demo.svc:5000/mirror --plain-http --site /site --node-config node-config
verified and imported 2 packages: 2 charts, 0 package trees, 5 images into oci://demo.demo.svc:5000/mirror
repository files: /site/main/; serve them over HTTP and point the cluster's repositories there
node settings for quay.io, registry.k8s.io: node-config
operator: helm upgrade kubepkg ... --set mirror=oci://demo.demo.svc:5000/mirror
$ find /site node-config -type f
/site/sbom.cdx.json
/site/main/index.yaml
/site/main/index.yaml.sig
node-config/containerd/certs.d/quay.io/hosts.toml
node-config/containerd/certs.d/registry.k8s.io/hosts.toml
node-config/talos-registries.yaml
$ cat node-config/containerd/certs.d/quay.io/hosts.toml
server = "https://quay.io"

[host."http://demo.demo.svc:5000/v2/mirror/quay.io"]
  capabilities = ["pull", "resolve"]
  override_path = true
Nodes ziehen Images über die Container-Runtime, nicht über kubepkg, deshalb braucht man neben dem Mirror auch diese Einstellungen: Mit ihnen holt sich containerd Images von quay.io aus dem Mirror, und für Talos gibt es einen fertigen Machine-Config-Patch. Die Charts referenzieren weiterhin quay.io, die Digests ändern sich nicht, und der Pod bekommt genau das Image, das der Index festgelegt hat. In diesem Lauf war nur der Operator abgeschnitten, die Nodes kamen noch ins Internet, diesen Teil habe ich also nicht getestet, sondern zeige nur die Konfiguration. In einem echten Air-Gap braucht der Mirror außerdem einen Namen, den die Nodes auflösen können, und ein Zertifikat, dem sie vertrauen, denn containerd nutzt nicht das Cluster-DNS.
Bleibt, den Operator auf den Mirror und auf den Index auf dem internen Webserver zu verweisen:
helm upgrade kubepkg oci://ghcr.io/kuberoot-dev/charts/kubepkg -n kubepkg-system --reuse-values \
  --set mirror=oci://demo.demo.svc:5000/mirror \
  --set 'repositories[0].name=main' \
  --set 'repositories[0].url=http://demo.demo.svc:8000/main/index.yaml' \
  --set-file 'repositories[0].publicKeys[0]=index.pub'
Prüfen wir, dass der Operator wirklich abgeschnitten ist und das öffentliche Repository nicht erreicht:
$ kubepkg repo list
NAME  PRIORITY  PACKAGES  READY  URL
main  0         49        True   http://demo.demo.svc:8000/main/index.yaml
$ kubepkg repo add public https://kuberoot-dev.github.io/kubepkg-recipes/index.yaml --public-key index.pub --priority -1
repository public added
$ kubepkg repo list
NAME    PRIORITY  PACKAGES  READY                URL
main    0         49        True                 http://demo.demo.svc:8000/main/index.yaml
public  -1        0         False (FetchFailed)  https://kuberoot-dev.github.io/kubepkg-recipes/index.yaml
$ kubepkg repo remove public
repository public removed
Das Haupt-Repository wird jetzt vom internen Webserver gelesen und akzeptiert, das öffentliche bleibt unerreichbar. Installieren wir ein Paket und schauen uns an, was im Mirror liegt:
$ kubepkg install kube-state-metrics --yes
ACTION   PACKAGE             FROM  TO              REPOSITORY  WHY
install  kube-state-metrics  -     2.20.0 build 3  main        requested
1 packages requested; follow them with "list"
$ kubepkg list
NAME                VERSION  REVISION  READY  REASON
cert-manager        1.21.2   2         True   ReconciliationSucceeded
kube-state-metrics  2.20.0   1         True   ReconciliationSucceeded
$ python3 -c 'import json,urllib.request; [print(r) for r in json.load(urllib.request.urlopen("http://demo.demo.svc:5000/v2/_catalog"))["repositories"]]'
mirror/ghcr.io/kuberoot-dev/kubepkg-packages/cert-manager/cert-manager
mirror/ghcr.io/kuberoot-dev/kubepkg-packages/kube-state-metrics/kube-state-metrics
mirror/quay.io/jetstack/cert-manager-cainjector
mirror/quay.io/jetstack/cert-manager-controller
mirror/quay.io/jetstack/cert-manager-startupapicheck
mirror/quay.io/jetstack/cert-manager-webhook
mirror/registry.k8s.io/kube-state-metrics/kube-state-metrics
Nebenbei ist der bereits im Cluster vorhandene cert-manager auf den frischen Build aus dem Mirror gewechselt und hat Revision 2 bekommen; diese Revision hat der neue Build erzeugt, nicht der Mirror selbst. Veröffentlichte Versionen liegen im Mirror unter den Pfaden ihrer ursprünglichen Registries, die Paketbeschreibungen ändern sich also nicht, und das Einschalten des Mirrors erzeugt für sich genommen keine neuen Revisionen.
Übernehmen, was schon installiert ist
In echten Clustern läuft bereits einiges: ein cert-manager, der vor zwei Jahren mit helm install installiert wurde, ein Operator, der per kubectl apply angewendet wurde, ein Monitoring-Stack, den das Skript eines Herstellers ausgerollt hat. Niemand will davon etwas neu installieren, schon gar nicht in Produktion. kubepkg adopt übernimmt solche Installationen an Ort und Stelle in die Verwaltung. Es findet das Release, zeigt, was es gefunden hat, und ändert nichts, bis Sie bestätigen:
$ kubepkg adopt cert-manager
adopt cert-manager 1.21.2 build 2 from main

COMPONENT     RELEASE                    FOUND                                                     THEN
cert-manager  cert-manager/cert-manager  cert-manager v1.21.2 (app v1.21.2), revision 2, deployed  upgrade in place to the package's chart, keeping its 2 top-level values
Nach der Bestätigung wird das Release an Ort und Stelle auf das Chart des Pakets aktualisiert und behält seine aktuellen Values. Das Deployment bleibt dasselbe Objekt, Pods werden nicht unnötig neu erstellt, und von da an hat das Paket Revisionen, Rollback, Abhängigkeiten und CRD-Ownership. Auch Objekte, die ohne Helm installiert wurden, werden übernommen, aber nur in der ersten Revision, damit eine spätere zufällige Namenskollision nie zur stillen Übernahme des Objekts eines anderen wird.
Helm, werf, Flux und Argo CD
Der Operator entscheidet, was in welcher Reihenfolge installiert wird, kann das eigentliche Anwenden der Manifeste aber an ein anderes Werkzeug übergeben. Standardmäßig installiert er Charts selbst über das Helm SDK und braucht im Cluster nichts außer sich selbst. Mit werf arbeitet er über Nelm, die Deployment-Engine von werf. Mit Flux wird jede Komponente zu einem HelmRelease, mit Argo CD zu einer Application:
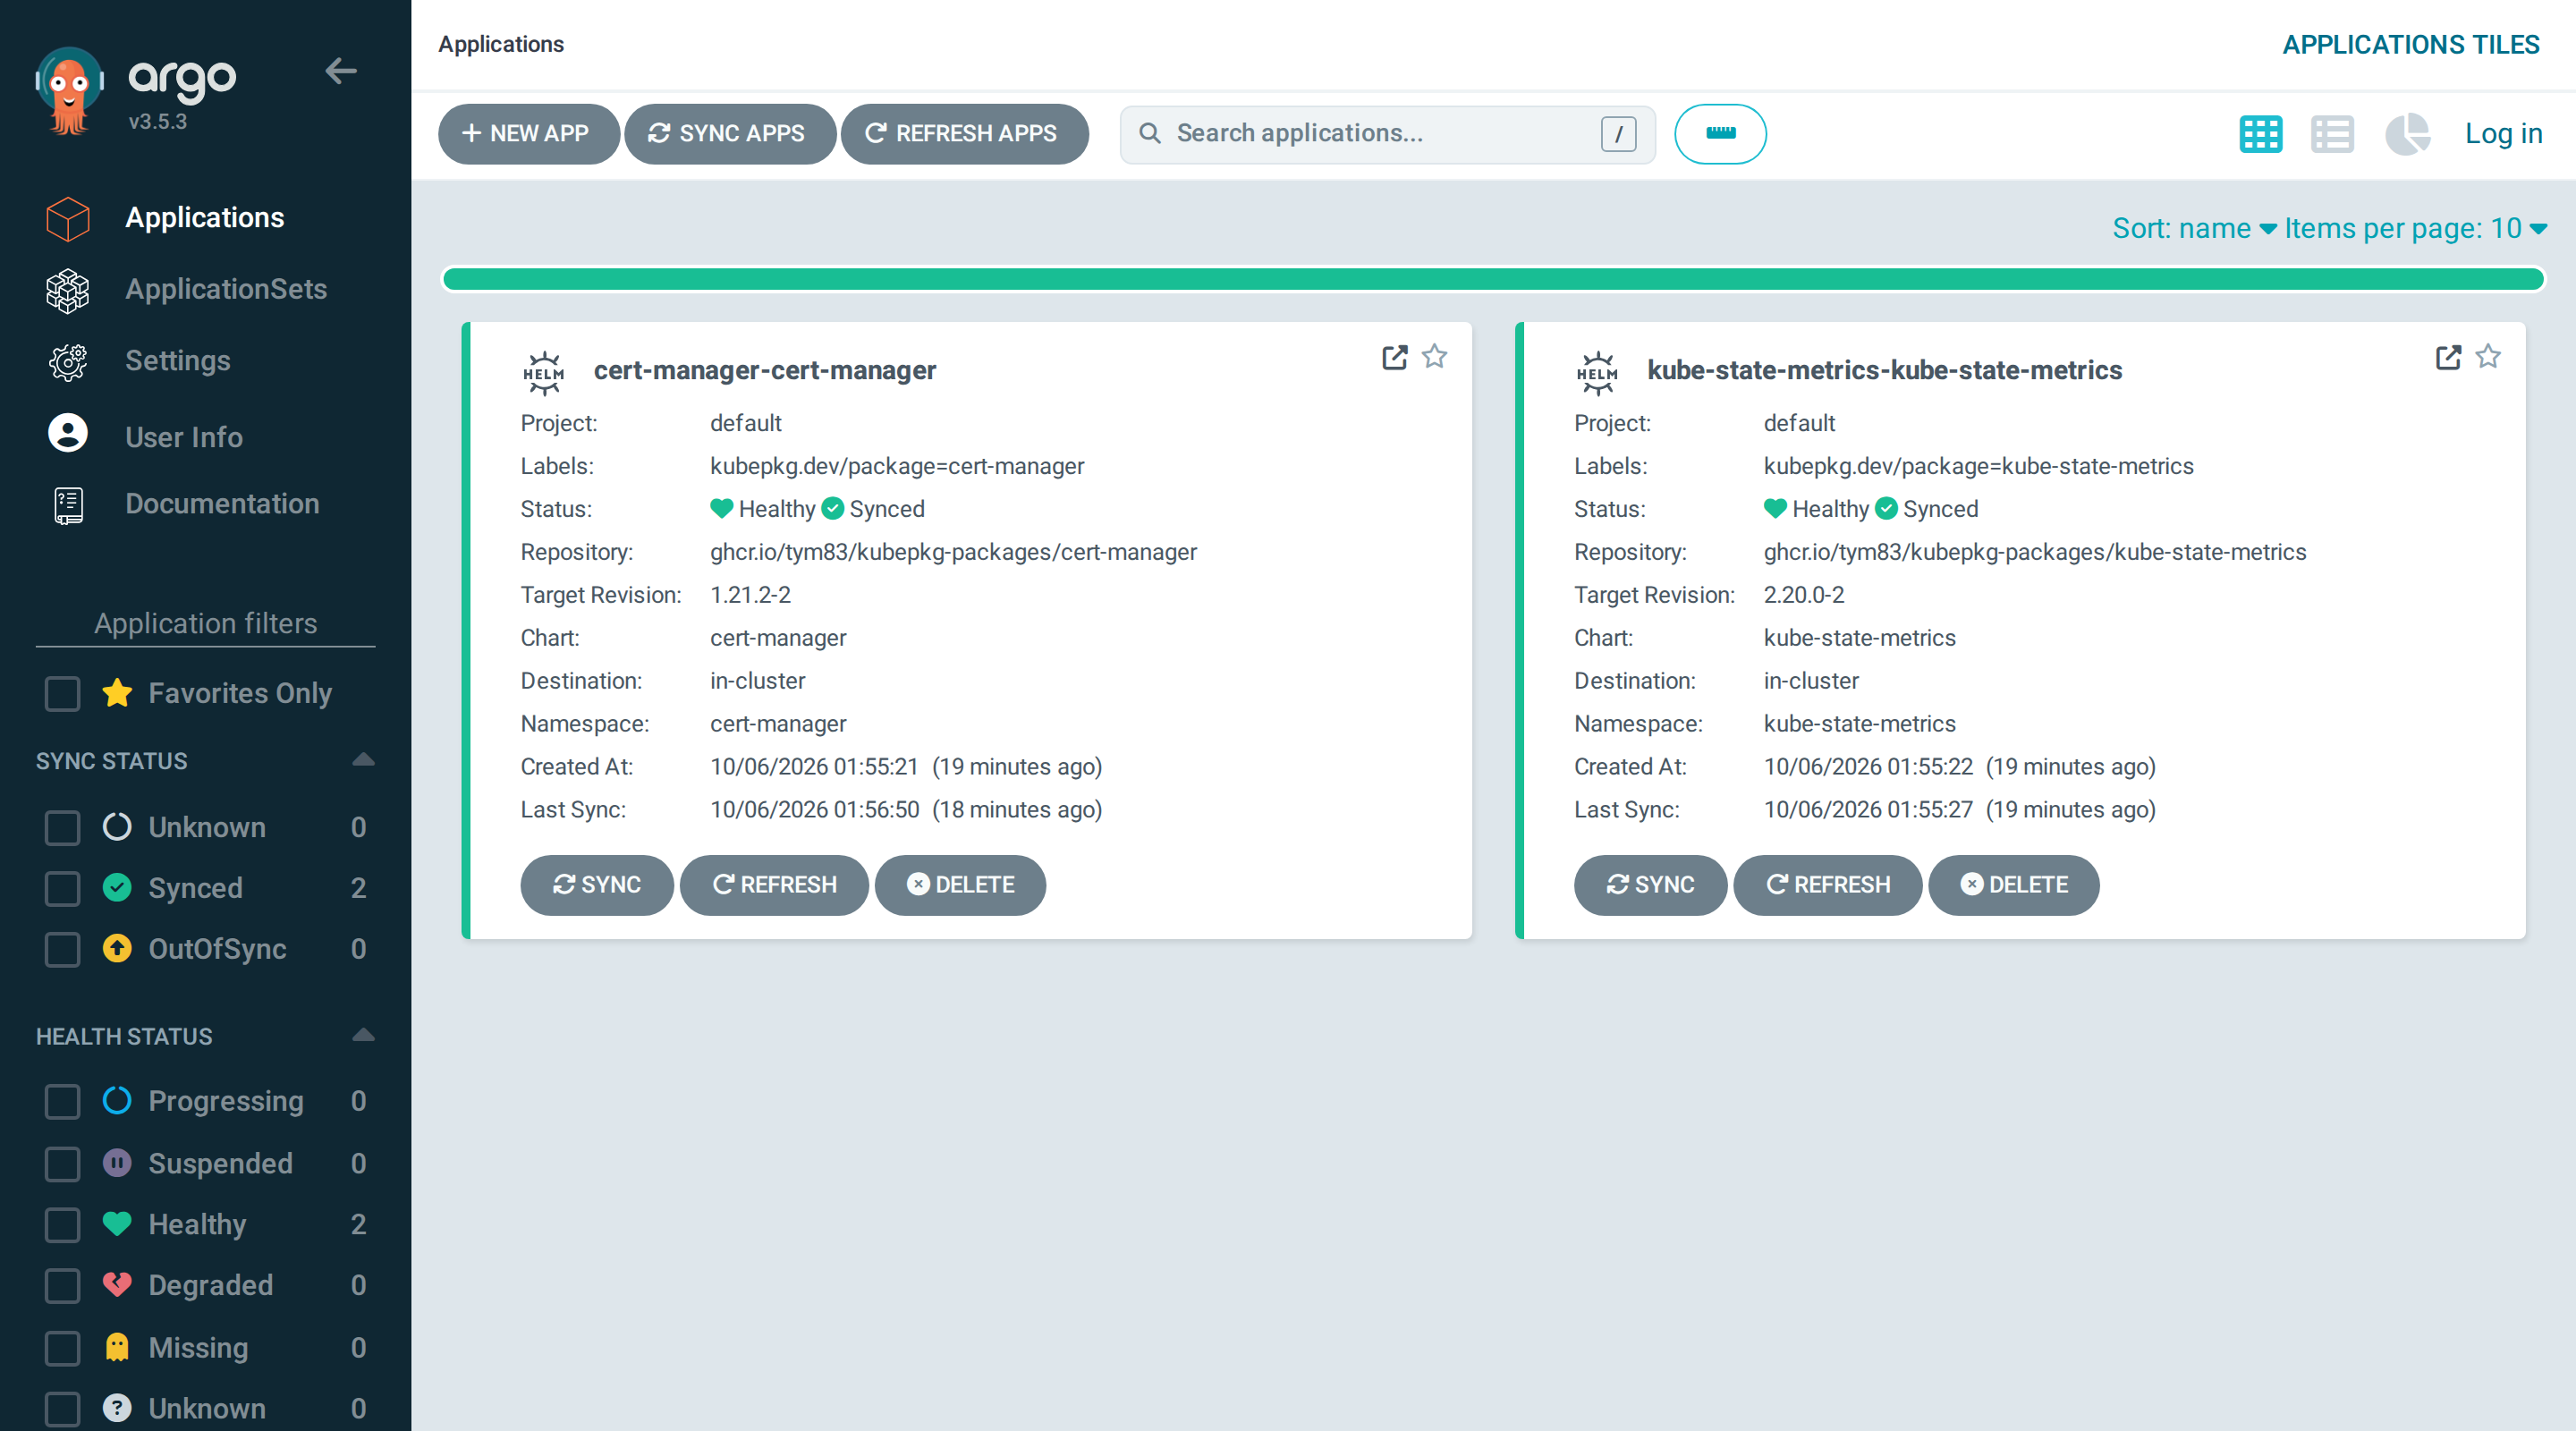
Von kubepkg in Argo CD angelegte Applications
Nelm verdient einen genaueren Blick. Es ist aus einer teilweise neu geschriebenen Helm-Codebasis hervorgegangen, versteht dieselben Charts und speichert Releases im selben Format, verfolgt aber viel genauer, was während einer Installation mit den Ressourcen passiert, ordnet sie innerhalb eines Releases präziser und aktualisiert, anders als Helm, bei einem Upgrade auch CRDs aus dem Verzeichnis crds des Charts. Während eine Installation läuft, zeigt Nelm den Zustand jeder Ressource samt Fehlern und Pod-Logs. Bleibt ein Upgrade hängen, sehen Sie den Grund also sofort, statt hinterher im Cluster danach zu graben. Bei Paketen wie KubeVirt oder Cilium, deren Upgrades ohnehin schwer zu verfolgen sind, macht das einen echten Unterschied.
Zum Einschalten genügt eine Operator-Einstellung, backend: werf, und im Cluster muss nichts zusätzlich installiert werden, weil das Nelm-Binary bereits im Operator-Image steckt, per Prüfsumme festgelegt. Der Operator bereitet Charts genauso vor und verifiziert sie wie bei Helm und installiert dann über Nelm ein Release pro Komponente des Pakets. Da die Release-Historie Helm-kompatibel bleibt, tauchen Releases sowohl in nelm release list als auch in helm list auf, und das Zurückrollen eines ganzen Pakets funktioniert genauso wie mit Helm. Auch das Übernehmen von Dingen, die jemand einmal von Hand installiert hat, klappt, weil Nelm bestehende Ressourcen zwangsweise in ein Release übernehmen kann.
Sie fragen sich vielleicht, warum kubepkg kein werf-Projekt schreibt, sondern Nelm für jede Komponente separat aufruft. Ein werf-Projekt deployt pro Umgebung ein einziges Helm-Release in einen Namespace, während ein kubepkg-Paket oft aus mehreren Releases in verschiedenen Namespaces besteht, wie virtualization, bei dem KubeVirt und CDI getrennt leben. Die Integration findet also auf der Ebene der Engine statt, nicht des Projekts. Der Weg funktioniert auch umgekehrt: Gebaute kubepkg-Pakete bleiben gewöhnliche Charts in einer Registry, und ein werf-Projekt kann sie als Abhängigkeiten einbinden.
Reihenfolge, Anforderungen, Bereitschaftsbedingungen und Revisionen funktionieren mit jedem Backend gleich. Der Unterschied liegt darin, wer die Manifeste anwendet und ob sich ein ganzes Paket zurückrollen lässt: Flux und Argo CD besitzen diese Releases selbst und geben kubepkg keinen Rollback, den es komponentenübergreifend steuern könnte. Mit ihnen lässt sich ein Paket also nicht als Ganzes zurückrollen, und kubepkg sagt das vorab.
Es gibt auch einen dritten Weg, ganz ohne Operator. kubepkg render löst Pakete und ihre Abhängigkeiten auf und schreibt das Ergebnis für Flux, Argo CD oder helmfile heraus, mit der richtigen Reihenfolge, ausgedrückt über dependsOn, Sync Waves oder needs. Sie committen das Ergebnis nach Git, und ab da ist kubepkg aus dem Spiel. Dabei verlieren Sie allerdings Revisionen, Rollback und die Prüfung der CRD-Ownership, deshalb ist ein Mittelweg meist bequemer: Package-Objekte in Git halten, Argo CD oder Flux sie anwenden lassen und kubepkg herausfinden lassen, wie der Cluster sicher in den gewünschten Zustand kommt.
Viele Cluster: der kubepkg-Hub und Canary-Rollouts
Im ersten Teil habe ich geschrieben, dass kubepkg das Flottenmanagement bewusst Argo CD, Flux, OCM und Karmada überlässt. Für eine große Flotte gilt das weiterhin, aber es hat sich gezeigt, dass Plattformen etwas viel Einfacheres brauchen: einmal festlegen, dass auf jedem Produktionscluster cert-manager 1.21 und virtualization 1.0 laufen, und Änderungen in Wellen ausrollen, ohne dafür ein separates System aufzusetzen.
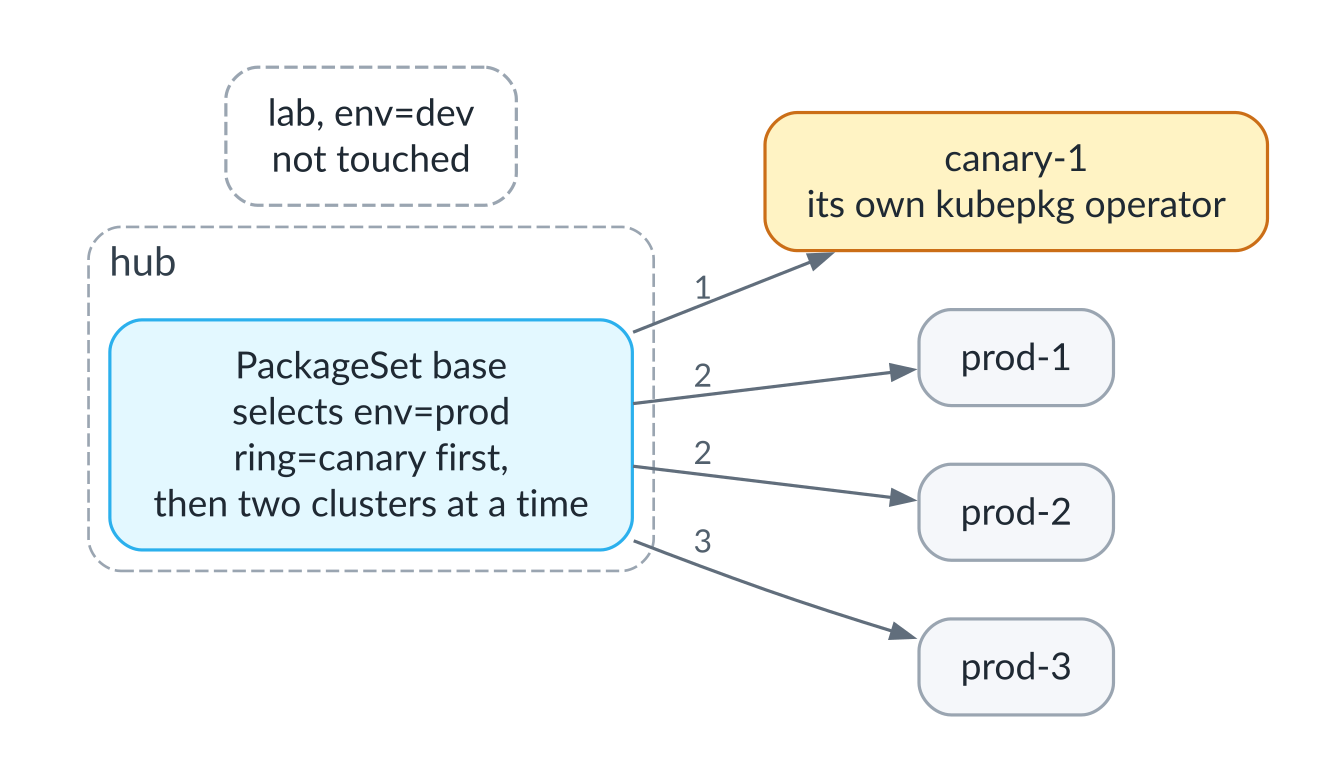
Der Hub und seine Cluster
Dafür gibt es den kubepkg-Hub. Er ist ein Cluster, der seine Mitglieder an ihren Labels erkennt und gemäß einem PackageSet Repository- und Package-Objekte in sie schreibt. Auf jedem Mitglied läuft ein eigener kubepkg-Operator, sodass Revisionen, Rollbacks und Bereitschaft lokal bleiben und auch dann weiter funktionieren, wenn der Hub nicht erreichbar ist. Der Hub fasst nie Objekte an, die er nicht selbst erstellt hat, und meldet einen Konflikt, wenn er einen findet.
Eine Änderung an einem Set lässt sich vorsichtig ausrollen: zuerst auf Canary-Cluster, dann auf eine begrenzte Zahl von Clustern gleichzeitig, mit sofortigem Stopp, sobald irgendein Cluster ein fehlgeschlagenes Upgrade meldet.
Live: ein Canary-Rollout über zwei Cluster
Nehmen wir zwei echte Cluster. Der Hub registriert sich selbst als Canary unter dem Namen self und den zweiten Cluster unter dem Namen edge:
$ kubepkg cluster add self --kubeconfig hub.kubeconfig --label env=prod --label ring=canary
$ kubepkg cluster add edge --kubeconfig edge.kubeconfig --label env=prod
$ kubepkg cluster list
NAME  KUBERNETES  READY  LABELS                STATUS
edge  v1.35.6     True   env=prod              kubepkg is installed
self  v1.35.6     True   env=prod,ring=canary  kubepkg is installed
Das Set besagt, dass auf jedem Produktionscluster kube-state-metrics laufen soll, zuerst auf den Canaries, dann Cluster für Cluster. Die Version ist bewusst exakt festgelegt: Mit einem Bereich würde jedes Mitglied von selbst auf einen neueren Build wechseln, sobald das Repository einen bekommt, und die Wellen umgehen:
apiVersion: kubepkg.dev/v1
kind: PackageSet
metadata:
  name: prod
spec:
  clusterSelector: {matchLabels: {env: prod}}
  rollout:
    canary: {matchLabels: {ring: canary}}
    maxInProgress: 1
  repositories:
    - name: fleet
      spec:
        url: https://kuberoot-dev.github.io/kubepkg-recipes/index.yaml
        publicKeys: [...]
  packages:
    - name: kube-state-metrics
      spec:
        version: "2.20.0"
        upgrade: {timeout: 90s}
        components: {kube-state-metrics: {values: {replicas: 1}}}
Solange das Paket auf dem Canary nicht bereit ist, wartet edge, und der Status des Sets sagt genau das: Es wartet auf die Canaries. Dann erscheint das Paket auf beiden Clustern. Die nächste Änderung, zwei Replicas statt einer, verhält sich genauso: Eine Weile laufen auf dem Canary schon zwei Replicas, während edge noch eine hat, und die Änderung geht erst weiter, wenn der Canary bereit ist.
Jetzt machen wir das Set kaputt, indem wir es auf ein Image-Tag verweisen lassen, das es nicht gibt. Auf dem Canary wird das Upgrade nicht innerhalb von neunzig Sekunden bereit und wird zurückgerollt, und der Rollout hält an:
$ kubepkg set status prod
prod: 0 of 2 clusters ready, 1 updated
rollout paused: stopped after a failure on self: kube-state-metrics: revision 3 failed (component kube-state-metrics failed: upgrade kube-state-metrics/kube-state-metrics: resource Deployment/kube-state-metrics/kube-state-metrics not ready. status: InProgress, message:…; change the set to go on

CLUSTER  UPDATED  KUBE-STATE-METRICS
self     yes      2.20.0
edge     no       2.20.0
Die fehlerhafte Änderung hat edge nie erreicht, dort läuft weiter das vorherige Image. Das Set zu reparieren, etwa mit den richtigen Values, ist eine neue Änderung, und der Rollout geht mit ihr weiter:
$ kubepkg set status prod
prod: 2 of 2 clusters ready

CLUSTER  UPDATED  KUBE-STATE-METRICS
self     yes      2.20.0
edge     yes      2.20.0
$ kubepkg set list
SET   CLUSTER  UPDATED  READY  STATUS
prod  self     yes      1/1    -
prod  edge     yes      1/1    -
Dieser Lauf hat noch etwas geprüft. Wenn edge allein durch eine Änderung seines Labels aus dem Produktions-Set in ein Test-Set wechselt, das ebenfalls kube-state-metrics enthält, wird das Paket nicht neu installiert: Das Deployment bleibt dasselbe Objekt, die Revisionshistorie läuft weiter, und es ändern sich nur der Eigentümer und die Values aus dem neuen Set.
Observability
Der Operator exportiert Prometheus-Metriken: die Bereitschaft jedes Pakets, seine Version und Revision, die Ergebnisse der Revisionen sowie ob jeder Index geladen wurde und wie alt er ist. Das Chart kann optional einen ServiceMonitor, Alerts und ein Grafana-Dashboard installieren:
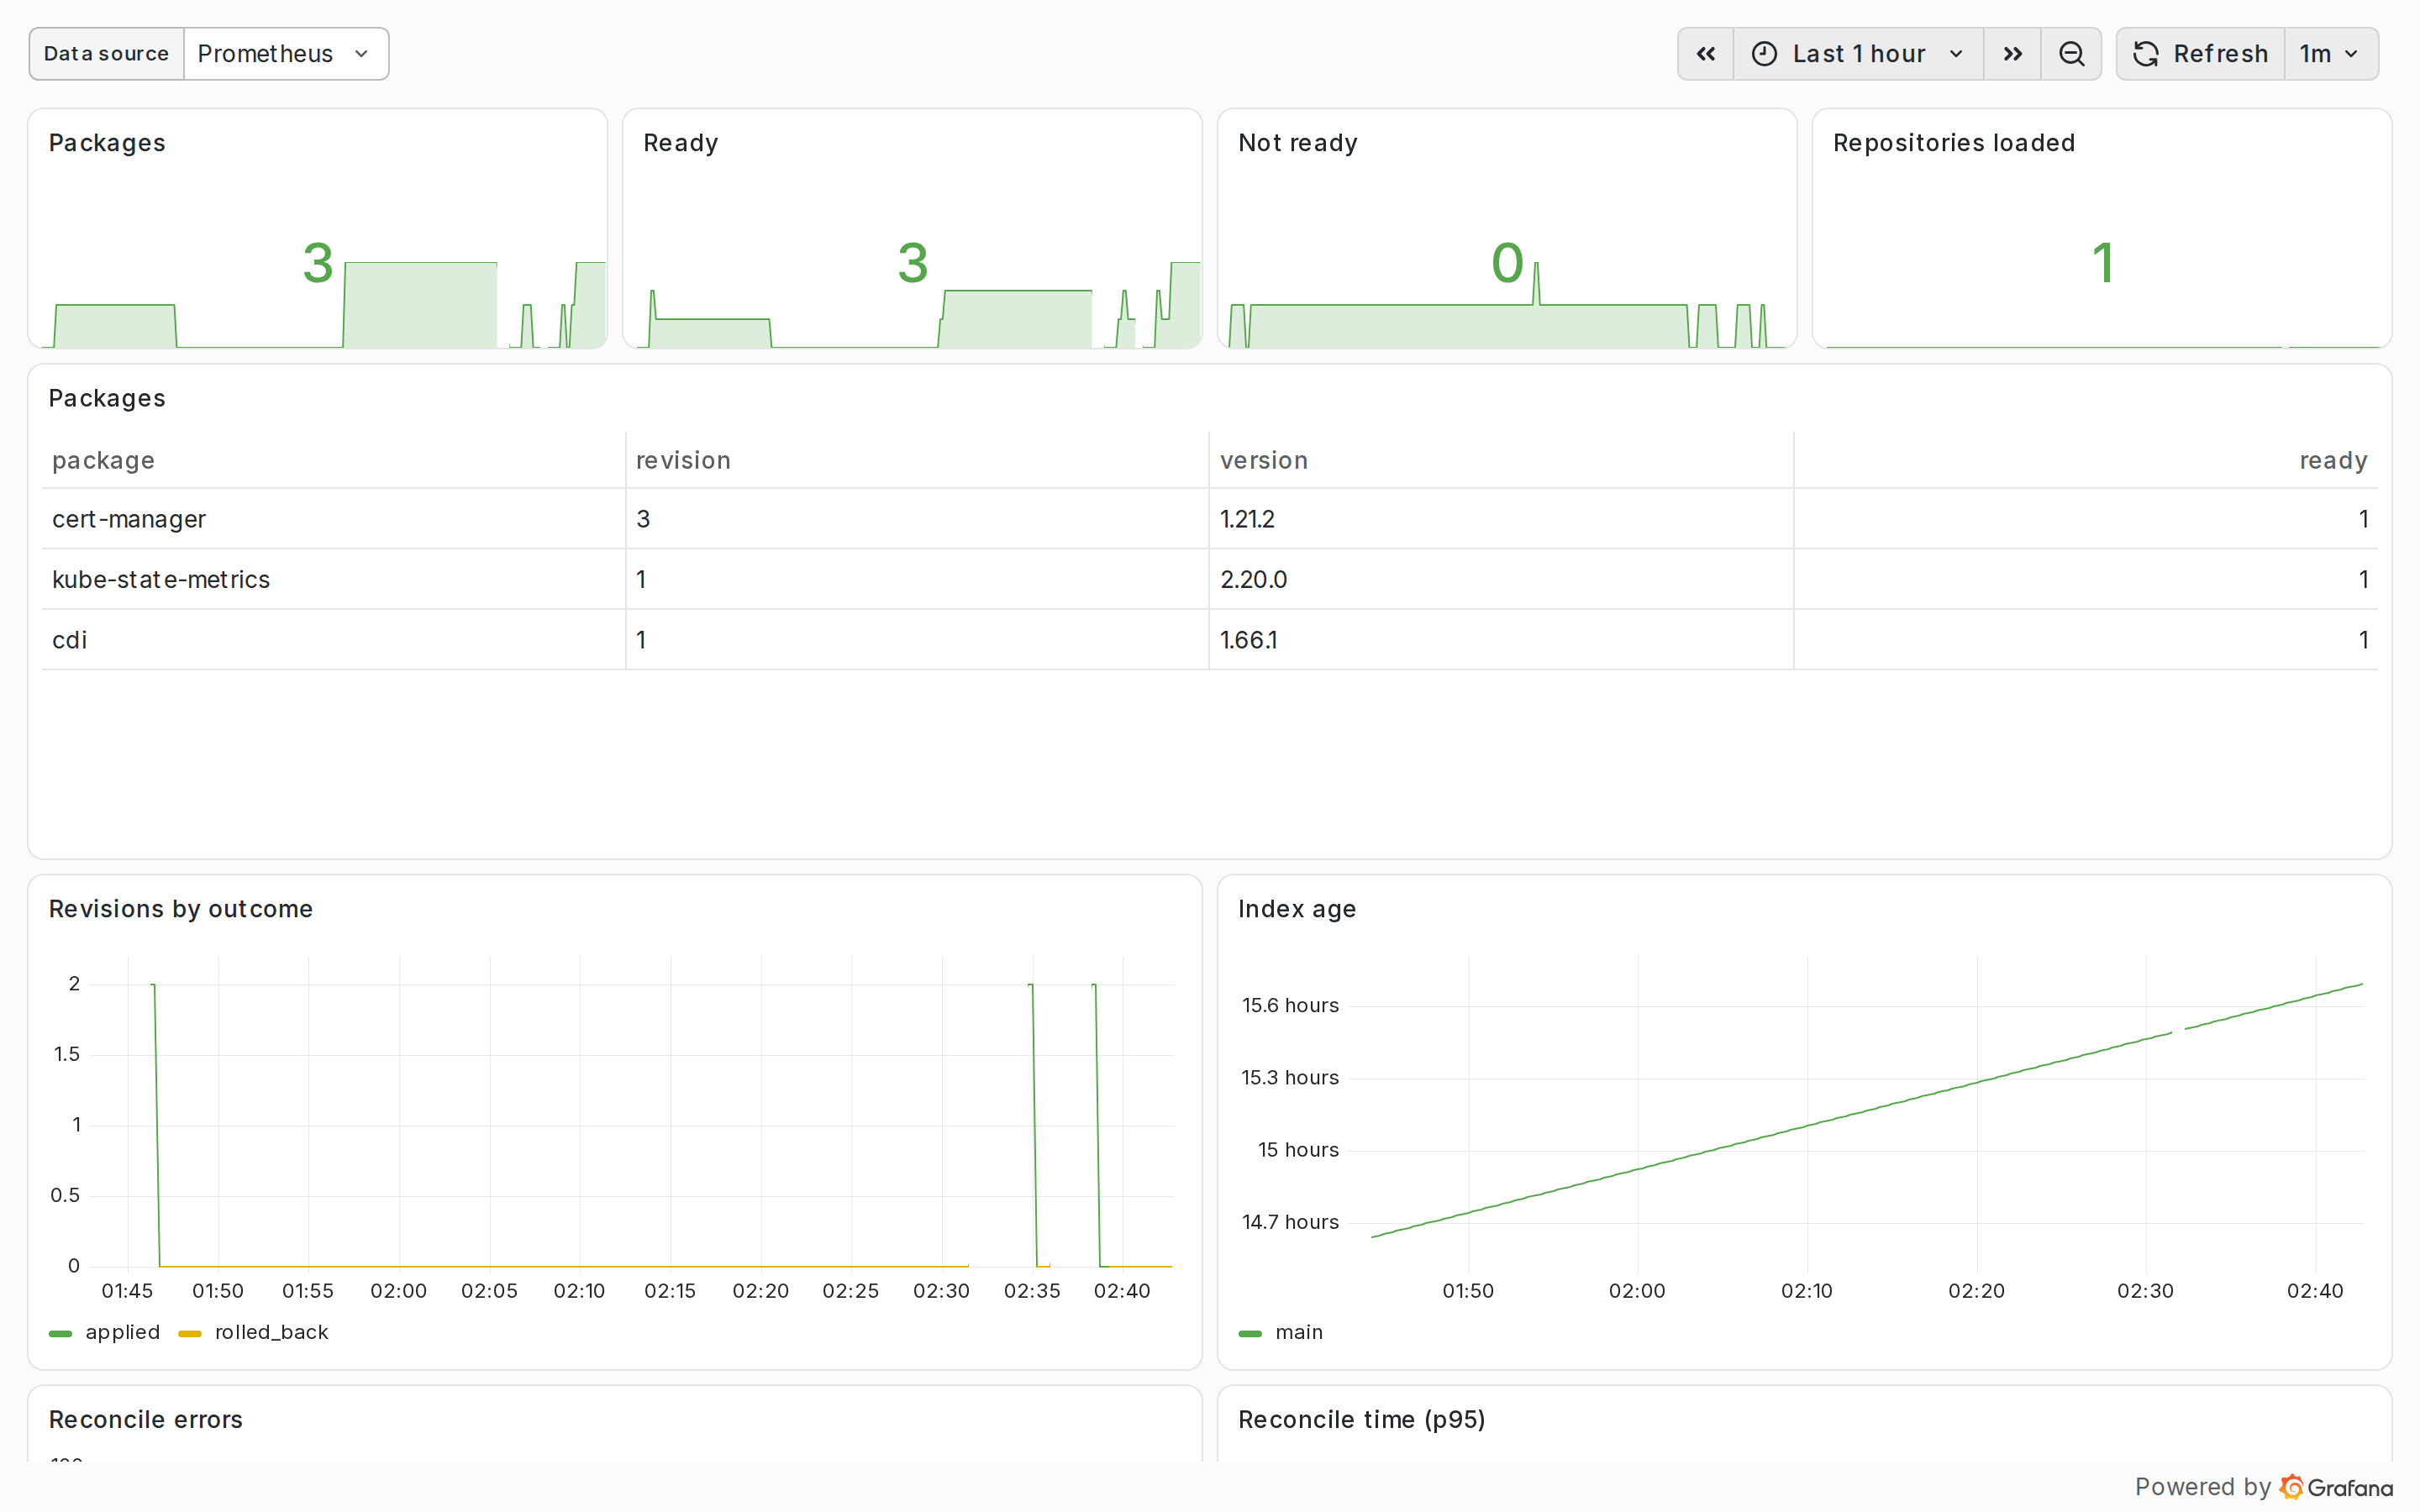
Das kubepkg-Dashboard in Grafana
Ein eigener Alert überwacht das Alter des Index. Hat ein Index ein Ablaufdatum und bricht die Veröffentlichungs-Pipeline unbemerkt zusammen, lehnen die Cluster den Index irgendwann ab. Liegt die Schwelle des Alerts unter dem Ablaufdatum, schlägt er an, bevor es so weit ist.
Eine Distribution als Metapaket
Alles bisher Gesagte läuft auf das Hauptszenario hinaus, für das kubepkg gebaut wurde. Eine Kubernetes-Distribution ist ein Cluster plus ein Satz Komponenten in Versionen, die zusammen getestet wurden. In kubepkg beschreibt man einen solchen Satz mit einem Metapaket, das keine eigenen Charts hat, nur Anforderungen:
apiVersion: kubepkg.dev/v1
kind: Recipe
metadata:
  name: mydistro
spec:
  version: 2.0.0
  package:
    variants:
      - name: default
        requires:
          - {package: cert-manager, version: "~1.21"}
          - {package: kube-state-metrics, version: "~2.20"}
          - {package: virtualization, version: "~1.0"}
      - name: minimal
        requires:
          - {package: cert-manager, version: "~1.21"}
Die Installation von Version 2.0 der Distribution installiert jede Komponente in der richtigen Reihenfolge, und das Upgrade auf 2.1, die cert-manager 1.22 verlangt, hebt cert-manager auf diese Version. Varianten geben einer Distribution Profile, etwa default und minimal wie oben.
Genau deshalb hat kubepkg keinen cleveren Versions-Solver wie apt oder npm: Die exakten Versionen, die zusammen getestet wurden, legt das Metapaket der Distribution fest, und die Bedingungen in den Paketen selbst bleiben minimal.
Einstellungen, die zum Cluster gehören und nicht zu einem Paket, etwa die Cluster-Domain, der Zertifikats-Issuer oder die Storage Class, kommen in ein einziges Secret, und der Operator legt sie unter die Values jeder Komponente. Charts, deren striktes Values-Schema unbekannte Schlüssel ablehnt, bekommen nur die Plattform-Schlüssel, die dieses Schema deklariert, und lassen sich so unverändert installieren.
kubepkg in eine fremde Plattform einbetten
kubepkg ist dafür gemacht, Teil einer fremden Plattform zu sein, ob Kubernetes-Distribution, Managed Service oder interne Entwicklerplattform. Ein Fork ist auf keiner Ebene nötig. Auf der Ebene der Konfiguration kann eine Plattform die Ressourcen von kubepkg unter ihrer eigenen API-Gruppe ausliefern, etwa packages.example.org, sodass ihre Nutzer die eigene API der Plattform sehen; sie kann jedem Paket-Namespace eigene Labels geben und ein Backend wählen. Auf der Build-Ebene fügt sie Plugins in beliebiger Sprache hinzu, die ihren internen Artefaktspeicher anbinden oder Images in ihre Registry kopieren. Und auf der Code-Ebene steckt alles, was die Binaries von kubepkg tun, in Go-Paketen, aus denen eine Plattform ihren eigenen Operator und ihre eigene CLI zusammensetzen kann, mit eigenem Namen, eigenen Vertrauensregeln und eigenen Backends.
Für die Ressourcen-API kubepkg.dev/v1 gilt seit 1.0 ein Kompatibilitätsversprechen. Breaking Changes kann es erst in 2.0 geben, ältere API-Versionen werden über die gesamte 1.x-Linie weiter ausgeliefert, und der Operator migriert gespeicherte Objekte von selbst auf die neue Version.
Wie kuberoot kubepkg nutzt
kuberoot wurde zum ersten und anspruchsvollsten Nutzer von kubepkg. Dort gibt es keinen Administrator, der den Paketmanager mit einem Chart installiert und danach im Auge behält: Ein Node bootet, und ein paar Minuten später muss darauf eine vollständige Distribution laufen, ohne einen einzigen manuellen Befehl.
Deshalb läuft der kubepkg-Operator in kuberoot nicht als Pod im Cluster, sondern als Dienst des Nodes selbst, neben dem API-Server. kinit, der erste Prozess des Systems, startet ihn gemäß dem Profil der Distribution, und die Flags des Operators stehen im selben Profil wie alles andere:
- name: kubepkg-operator
  after: apiserver
  args:
  - /usr/bin/kubepkg-operator
  - --backend=helm
  - --values-secret=kube-system/kuberoot-platform-values
  - --registry-secret=kube-system/kuberoot-registry-credentials
  - --image-policy=enforce
  - --webhook-namespace=kube-system
  - --webhook-service=kubepkg-webhook
  - '{{if eq .Store.Kind "etcd"}}--leader-elect{{end}}'
So braucht der Paketmanager keinen funktionierenden Cluster, um hochzukommen, und kann sogar das CNI-Plugin installieren, ohne das die Nodes NotReady bleiben und gewöhnliche Pods nicht starten können. In einem hochverfügbaren Cluster läuft der Operator auf jedem Control-Plane-Node, aber nur einer davon handelt, bestimmt über die Leader Election von Kubernetes (ein Lease-Objekt). Auch der Webhook der Image-Policy lebt auf dem Node, und der API-Server erreicht ihn über einen Service ohne Selector, dem jeder Control-Plane-Node seine eigene Adresse hinzufügt.
Als Nächstes lässt kinit den Cluster ein Repository abonnieren. Die CRDs von kubepkg stecken im System-Image, zusammen mit dem öffentlichen Schlüssel des öffentlichen Repositorys, der beim Build hinzugefügt wird. Beim ersten Boot wendet kinit die Repository-Ressource und das erste Paket an, CoreDNS, das die DNS-Service-IP genau dieses Clusters braucht:
apiVersion: kubepkg.dev/v1
kind: Repository
metadata:
  name: main
spec:
  url: https://kuberoot-dev.github.io/kubepkg-recipes/index.yaml
  publicKeys:
    - |
      -----BEGIN PUBLIC KEY-----
      ...
---
apiVersion: kubepkg.dev/v1
kind: Package
metadata:
  name: coredns
spec:
  version: "~1.14"
  components:
    coredns:
      values:
        service:
          clusterIP: "10.96.0.10"
URL und Schlüssel des Repositorys lassen sich über Kernel-Parameter überschreiben, wenn ein Unternehmen ein eigenes Paket-Repository betreibt. Danach führt kinit kubepkg install kuberoot-<distribution> --yes aus und wiederholt den Befehl, bis der Operator ihn annimmt. Alles Weitere erledigt der Operator.
kuberoot-Distributionen im Repository
Jede kuberoot-Distribution ist im Repository als Paket beschrieben, das größtenteils aus Anforderungen besteht, und die Zusammensetzung einer Distribution lässt sich direkt an ihrem Rezept ablesen. Die Basis-Distribution edge verlangt nur CoreDNS, metrics-server und lokalen Storage. Die Observability-Distribution baut auf edge auf:
apiVersion: kubepkg.dev/v1
kind: Recipe
metadata:
  name: kuberoot-observability
spec:
  package:
    variants:
      - name: default
        requires:
          - {package: kuberoot-edge, version: "~0.2"}
          - {package: victoria-metrics, version: "~1.153"}
          - {package: victoria-logs, version: "~1.53"}
          - {package: perses-operator, version: "~0.5"}
Auch die KI-Distribution baut auf edge auf und überlässt GPU-Unterstützung, Inferenz, Training und Vektordatenbanken separaten Metapaketen, ai-gpu, ai-inference, ai-training und ai-rag, die je nach Bedarf des Clusters installiert werden, denn der eine Cluster braucht nur Inferenz, der andere den ganzen Satz. Auch die vollständige Plattform mit DRBD-Storage, Policies und Backups ist ein Metapaket, kuberoot-platform-full, und lässt sich mit einem einzigen Befehl auf jeder Distribution installieren, die Pods ausführt.
Was ein Paket über den Node wissen muss
Ein kuberoot-Node ist keine gewöhnliche Linux-Kiste: Es gibt kein systemd, kein udev und kein D-Bus, und Kernel-Module werden beim Boot geladen, danach ist das Laden von Modulen deaktiviert. Das Piraeus-Chart setzt standardmäßig all das voraus, und ohne Hinweis kommen seine LINSTOR-Satelliten auf den Nodes schlicht nicht hoch. Der Hinweis steht in den Plattform-Values, einem einzigen Secret, das kinit in den Cluster legt:
linstorNode:
  drbdLoaded: true
  systemd: false
  hostNetwork: true
Der Operator legt diese Values unter die Values jedes Pakets. Im öffentlichen Repository gibt es ein einziges Piraeus-Paket für alle Cluster: Auf einem gewöhnlichen Cluster läuft es mit seinen Standardwerten, auf kuberoot sieht es die Plattform-Values und baut die Satelliten-Konfiguration für Nodes ohne systemd von selbst, ohne DRBD ein zweites Mal zu laden.
Was kuberoot in kubepkg gefunden hat
Das Nützlichste, was kuberoot kubepkg gegeben hat, waren drei Runden Feedback, und fast alles davon kam nicht aus den eigenen Tests von kubepkg, sondern von Distributionen, die echte Arbeit verrichten.
Ein Operator, der auf einem Node läuft, kann die Datei mit Registry-Zugangsdaten auf dem Rechner eines Administrators nicht lesen, deshalb kommen die Zugangsdaten jetzt aus einem Secret im Cluster. Und weil eine Distribution dieses Secret nicht vorab anlegen kann, ohne beim nächsten Boot fremde Daten zu überschreiben, bedeutet ein fehlendes Secret jetzt “keine Zugangsdaten” statt eines Fehlers. Die Image-Policy im Modus warn gab ihre Warnungen an den zurück, der den Pod erstellt hatte, also an den ReplicaSet-Controller, sodass sie nie jemand zu sehen bekam; jetzt legt der Webhook zusätzlich ein Event am Eigentümer des Pods an. Ein Cilium, das mit reinem helm install installiert worden war, bevor es das Paket gab, blieb früher außerhalb der Verwaltung von kubepkg und ließ sein Release im Zustand failed zurück. Wurde einem Control-Plane-Node mitten in einer Installation der Strom abgeschaltet, blieb das Release früher für immer in pending-install hängen; jetzt schließt es die Installation ein paar Minuten nach dem Boot von selbst ab. Und abhängige Pakete brauchten früher lange, um zu bemerken, dass eine Anforderung schon bereit war, weil der Operator Pakete eines nach dem anderen verarbeitete.
Der interessanteste Fund kam aus den Kubernetes-Konformitätstests. Der Operator setzte das Label der Image-Policy auf jeden Namespace, in den er Pakete installierte, und CoreDNS und metrics-server landen in kube-system. Der Test, der die Preemption von Pods durch einen kritischen Pod prüft, scheiterte so:
admission webhook "pods.images.kubepkg.dev" denied the request: no installed package pins
registry.k8s.io/pause:3.10.2; namespace kube-system runs only images packages pin
Seitdem lässt die Policy System-Namespaces in Ruhe, und der Operator schaltet eine Policy, die ein Administrator deaktiviert hat, nicht mehr wieder ein. Auch das Filtern der Plattform-Values nach dem Schema des Charts stammt aus dieser Serie: Die strikten Schemas von MLflow und JupyterHub lehnten den Schlüssel linstorNode ab, mit dem sie nichts anfangen können, und die Rezepte mussten dafür Patches mitschleppen. Jetzt nicht mehr.
Die letzten beiden Rückmeldungen sind in Version 1.3 eingeflossen. Die Observability-Distribution braucht kein Grafana: Ihre Dashboards laufen auf Perses, und Grafana wäre der schwerste Pod auf dem Node gewesen. Ein Metapaket konnte früher VictoriaMetrics verlangen, aber nicht konfigurieren, und der einzige Weg, Grafana abzuschalten, war eine zweite Variante des Rezepts. Jetzt trägt eine Anforderung Values für die Abhängigkeit mit:
requires:
  - package: victoria-metrics
    version: "~1.153"
    components:
      victoria-metrics:
        values:
          grafana: {enabled: false}
Die Values eines Metapakets kommen über die Plattform-Values, und Values, die der Nutzer im Paket selbst gesetzt hat, schlagen sie alle. Verlangen zwei Metapakete von derselben Abhängigkeit Unterschiedliches, wendet der Operator nichts an und nennt beide Pakete, statt stillschweigend einen Gewinner zu küren. Die zweite Rückmeldung betraf fehlgeschlagene Installationen: Sie blieben früher fehlgeschlagen, selbst wenn im Repository schon ein reparierter Build lag, und in einem Cluster, den niemand beobachtet, und genau das sind kuberoot-Cluster, blieb das Paket einfach kaputt. Jetzt versucht der Operator eine fehlgeschlagene Revision mit wachsender Pause erneut, von dreißig Sekunden bis zu zehn Minuten, und wendet einen neuen Build aus dem Index sofort an.
Wie es weitergeht
kubepkg ist ein MVP, und mir ist sehr bewusst, dass der Weg von einer ersten Version bis zu einem Werkzeug, dem eine große Bank ihre Produktion anvertraut, ein langer ist. Das öffentliche Repository pflege ich vorerst selbst, und der eigentliche Wert eines Repositorys liegt in den Menschen, die es kuratieren. Das Vertrauensmodell hat noch kein externes Audit durchlaufen. Manche Szenarien wurden auf Testclustern getestet, nicht in jahrelangem Betrieb.
Trotzdem glaube ich, dass das Wichtigste gelungen ist. Man kann eine Paketschicht für Kubernetes bauen, ohne ein neues Format zu erfinden oder bestehende Werkzeuge zu brechen, und sie lässt sich über Plattformen hinweg teilen, statt jedes Mal neu geschrieben zu werden. Alles ist Open Source unter der Apache License 2.0: der Paketmanager in kuberoot-dev/kubepkg, die Rezepte des öffentlichen Repositorys in kuberoot-dev/kubepkg-recipes und die Dokumentation unter kuberoot-dev.github.io/kubepkg. Wenn Sie Ihre eigene Plattform bauen und in diesem Beitrag Ihre eigenen Probleme wiedererkennen, bringen Sie Feedback, Pakete und Einwände mit. Wie der Austausch mit Duggan gezeigt hat, bringt nichts solche Dinge so gut in Bewegung wie ein Streit.