Auf einen Blick
- Projekt: kuberoot, Apache 2.0, github.com/kuberoot-dev
- Distributionen: Edge, Router, Hypervisor, KI, Echtzeit, IoT, Observability, Workstation
- Node-Verwaltung: Ressourcen in node.kuberoot.dev über API-Aggregation, ohne Shell, ohne SSH
- Upgrades: A/B-Slots, signierte Bundles, automatischer Rollback nach fehlgeschlagenem Boot
- Konformität: 462 von 462 Tests auf Kubernetes 1.37 (noch nicht zur Zertifizierung eingereicht)
- Paketmanager: kubepkg: unveränderte Helm-Charts plus Deskriptor, Abhängigkeiten nach Capabilities, TUF und cosign
Am Anfang dieser Serie stand ein einfaches Gedankenexperiment: Was wäre, wenn wir Kubernetes so behandelten wie den Linux-Kernel? Was wäre, wenn Ingenieure Vanilla-Kubernetes nicht mehr Komponente für Komponente in Form bringen müssten, sondern einfach zu einer fertigen Distribution greifen könnten? Alles, was folgt, ist aus dieser Frage gewachsen. Eine Vorbemerkung gleich zu Beginn: Der Code zu dieser Serie ist eine Sammlung von Experimenten, und ich bezweifle, dass sich jemand beeilen wird, ihn in Produktion zu nehmen. Aber ich glaube, dass solche Ideen es verdienen, dass man über sie streitet und sie von allen Seiten betrachtet. Gespräche dieser Art bringen eine Branche voran, und durch sie sehen wir Vertrautes in einem neuen, manchmal unerwarteten Licht.
Die Technik dahinter ist noch ziemlich roh, und ich würde mich ehrlich freuen, wenn Menschen, denen die Idee selbst gefällt, zum Projekt stoßen und helfen, daraus etwas technisch weit Ernsthafteres zu machen.
Warum ich das mache
kuberoot ist nicht mein erstes Experiment mit der Frage, was Kubernetes sein könnte, und es lohnt sich wohl zu erklären, woher es kommt, denn von außen sahen die früheren Experimente eher wie Scherze aus.
Zuerst kam Sheeternetes, ein Container-Orchestrator, der seinen Zustand statt in etcd in einem Tabellenblatt von Google Sheets ablegt und seine Reconciliation-Schleife statt in einem herkömmlichen Controller in Apps Script ausführt. Danach haben wir ihn unter Last getestet, einen Operator dafür geschrieben, eine Container-Registry gebaut, die in Tabellenzellen lebt, zwei Cluster über ein gemeinsames Blatt föderiert und am Ende den kompletten kube-scheduler in eine einzige Tabellenformel verlegt. Dann kam Tatarnetes, ein Fork von Kubernetes, Talos und dem Kubernetes Dashboard, der Tatarisch spricht. Und dann Paleocomputing, wo wir Kubernetes auf Project Oberon betrieben haben, auf RISC5, dem Prozessor, den Niklaus Wirth für sein eigenes Betriebssystem entworfen hat.
Sie sahen aus wie Scherze, und sie sollten auch Spaß machen, aber für mich war jedes davon eine Möglichkeit, die Linie zu finden, an der der Vertrag von Kubernetes endet und die Implementierung beginnt: was an Kubernetes wesentlich ist und was bloß Zufall einer bestimmten Codebasis. Wenn ein Orchestrator weiterläuft, nachdem man seinen Datenspeicher durch eine Tabelle und seinen Scheduler durch eine Formel ersetzt hat, dann liegt das Wesen von Kubernetes nicht in etcd oder im Code des Schedulers, sondern im Ressourcenmodell und in der Reconciliation-Schleife. Aus diesen Experimenten ist kuberoot hervorgegangen. Diesmal lautete die Frage nicht, wie weit man sich von dem Kubernetes entfernen kann, das wir kennen, sondern was sich bauen lässt, wenn man es als Kernel ernst nimmt.
Danken möchte ich auch meinen Kollegen bei Ænix. In Gesprächen mit ihnen und beim Zusehen, wie sie arbeiten, haben die Ideen dieses Artikels Gestalt angenommen.
Wie alles anfing
Im Herbst 2023 stand Tim Hockin, einer der Ingenieure, die Kubernetes ins Leben gerufen haben, auf der KubeCon in Chicago auf der Bühne und sprach darüber, dass Kubernetes mit jedem Release komplexer wird und dass diese Komplexität nicht umsonst ist. Jedes Feature, das nur ein einziger Nutzer braucht, wird zu einem Gewicht, das alle anderen mittragen müssen; den Entwicklern des Projekts selbst fällt es immer schwerer, das Ganze im Kopf zu behalten, und den Ingenieuren, die es betreiben, immer schwerer, sich in all seinen Stellschrauben zurechtzufinden. Hockin schlug vor, Komplexität als Budget zu betrachten: Das Projekt hat eines, es darf es ausgeben, aber jeden Posten nur einmal, und deshalb muss es lernen, Nein zu sagen zu allem, was dieses Budget aufzehren würde, ohne genug zurückzugeben.
Die Idee ließ mich nicht los, weil in ihr eine Folgerung zu stecken schien, die niemand laut ausgesprochen hatte. Wenn die Komplexität, die maschinelles Lernen, Netzwerkgeräte oder Industriesteuerungen brauchen, nicht ins Budget des Projektkerns passt, muss sie trotzdem irgendwo leben, am besten dort, wo sie niemand anderem zur Last fällt. Die Linux-Welt hat diesen Ort längst gefunden. Der Kernel bleibt ein Kernel, etwas, das nur wenige wirklich genau kennen, geschweige denn direkt daran arbeiten, und alles Spezifische wandert in Distributionen. Niemand erwartet, dass sich Linus Torvalds persönlich um Router, medizinische Scanner und Spielkonsolen kümmert. Im Dezember 2024 habe ich darüber in „Die unausweichliche Zukunft von Kubernetes“ geschrieben und argumentiert, dass Kubernetes früher oder später dem Weg des Linux-Kernels folgen wird und dass um es herum spezialisierte Distributionen wachsen werden, jede mit eigenem Build-System, eigenen Voreinstellungen und eigenem Paketmanager.
Zu meiner Überraschung bekam der Artikel durchdachte Antworten, und zwar von Leuten, deren Meinung ich sehr schätze. Mathew Duggan schrieb einen Beitrag mit dem Titel Kubernetes as a Distro, in dem er mir zustimmte, dass das Problem real ist, meiner Diagnose aber widersprach. “I understand the idea,” schrieb er, “but I think the root cause of all of this is simply a lack of a meaningful package management system for Kubernetes.” Helm, so seine Worte, “has done the best it can,” während Operators “are proving too complicated for normal people to write,” und was wir bräuchten, sei “something between the very easy to use but easy to mess up Helm and the highly bespoke and complex to write Operator concept.” Er zählte acht Dinge auf, die ein solches System leisten sollte, und auf diese Liste komme ich noch zurück. Und Tim Hockin, dessen Vortrag den Artikel überhaupt erst angestoßen hatte, schaltete sich in die Diskussion auf Reddit ein und schrieb eine Antwort, die ich seitdem viele Male wieder gelesen habe.
I am a vocal proponent of treating Kubernetes as the “kernel” of an OS, but it’s hard to be dogmatic for a number of reasons.
People expect it to have in-the-box solutions to many problems, partly because it has had those in the past and partly because the world of kube is vastly different than that of Linux. The latter was originally aimed at hobbyists, which gave rise to many distributions. Kube is much more business focused. How many Linux distributions really cater to businesses? 2 or 3.
We, perhaps mistakenly, ship in-the-box solutions for things like networking (kube-proxy) and service discovery (DNS) and cluster lifecycle (kubeadm). Even the scheduler is more user-space than kernel.
We, again mistakenly, ship binary builds. The Linux kernel is built by distribution builders.
I don’t know that the kernel analogy works when it comes to things like compile time options. It makes sense for the kernel much more than for kube, I think. Perhaps the analog there is more like “use a simpler scheduler” than compile-flags.
Anyway, I will keep pressing for building new things ON kube rather than IN kube.
Bei den „2 or 3“ würde ich widersprechen, und ich werde Punkt für Punkt auf diese Antwort zurückkommen, denn fast jeder ihrer Punkte ist am Ende zu einer der Entscheidungen geworden, die ich weiter unten beschreibe.
Im Sommer 2025 griff Duggan das Thema in einem neuen Beitrag wieder auf, What would a Kubernetes 2.0 look like, und ging noch weiter. Seine Wunschliste: “Ditch YAML for HCL”; “Allow etcd swap-out” für kleinere Cluster; “Beyond Helm” mit einem nativen Paketmanager, den er KubePkg nannte, “because if there’s one thing the Kubernetes ecosystem needs, it’s another abbreviated name with a ‘K’ in it”; und IPv6 als Standard. Der Paketmanager in diesem Projekt trägt denselben Namen.
Im Nachhinein ist das Interessanteste an diesem Austausch, dass Duggan und ich beide recht hatten; wir haben nur von entgegengesetzten Enden auf dasselbe Problem geschaut. Eine Distribution ohne Paketmanager wird zu einem weiteren Monolithen, der sich nicht Stück für Stück aktualisieren lässt, und ein Paketmanager ohne Distribution ist ein Werkzeug, mit dem es nichts zusammenzubauen gibt. Debian ist drei Dinge zugleich: apt, das Archiv und das Urteil darüber, was hineinkommt. Keines davon überlebt ohne die anderen. Statt die Debatte in Kommentarspalten fortzusetzen, beschloss ich, das zu bauen, worüber wir gesprochen hatten, und zu sehen, was übrig bleibt, wenn aus Theorie Code werden muss.
Was daraus geworden ist
Herausgekommen ist ein Projekt namens kuberoot. Es ist ein Baukasten für Kubernetes-Distributionen, nach dem Vorbild dessen, was Buildroot für Embedded-Linux leistet. Sie beschreiben die Distribution, die Sie haben wollen, und der Baukasten macht aus dieser Beschreibung ein bootfähiges Image mit eigenem Linux-Kernel, eigenem Init-System und eigenem Kubernetes, bereit zur Installation auf Bare Metal oder in einer virtuellen Maschine. Daneben ist kubepkg entstanden, ein Paketmanager, der unser früheres cozypkg ablöst und in weiten Teilen von Duggans Anforderungsliste geprägt wurde, samt einem Paketarchiv dafür. Dieses Dreieck aus Builder, Paketmanager und Paketarchiv halte ich für das wichtigste Ergebnis der Arbeit; alles andere folgt daraus.
Um herauszufinden, ob die Idee den Kontakt mit der Wirklichkeit übersteht, habe ich mit dem Baukasten acht Distributionen gebaut und sie bewusst so verschieden gemacht, wie es nur ging. Da ist ein gewöhnlicher Allzweck-Cluster, ein Netzwerk-Router ohne einen einzigen Container, ein Hypervisor, der virtuelle Maschinen im laufenden Betrieb zwischen Nodes verschiebt, eine Plattform für Sprachmodelle mit eingebautem GPU-Treiber, ein Echtzeit-Node für industrielle Workloads, ein Gateway für Industriesensoren, ein externer Monitoring-Cluster und eine Workstation, die im Cluster lebt. Wäre die Idee falsch gewesen, hätte sich das spätestens bei der zweiten oder dritten Distribution gezeigt, weil dann jede neue verlangt hätte, das Fundament umzuschreiben. Das ist nie passiert. Nach den ersten beiden brauchte jede neue Distribution etwa einen Tag, bis sie bootete, denn jedes Mal musste ich nur ein Profil schreiben und das, was wirklich neu war, meist ein einzelnes Programm auf dem Node.
Im Folgenden zeige ich, wie das alles funktioniert, welche Entscheidungen wir getroffen haben und warum, worin es sich von dem unterscheidet, was die Branche heute hat, und wo ich Nutzen und Risiken sehe. Der Artikel ist lang, weil er als Landkarte für den Rest der Serie gedacht ist, in der jeder größere Teil einen eigenen Artikel mit Live-Demonstrationen bekommt.
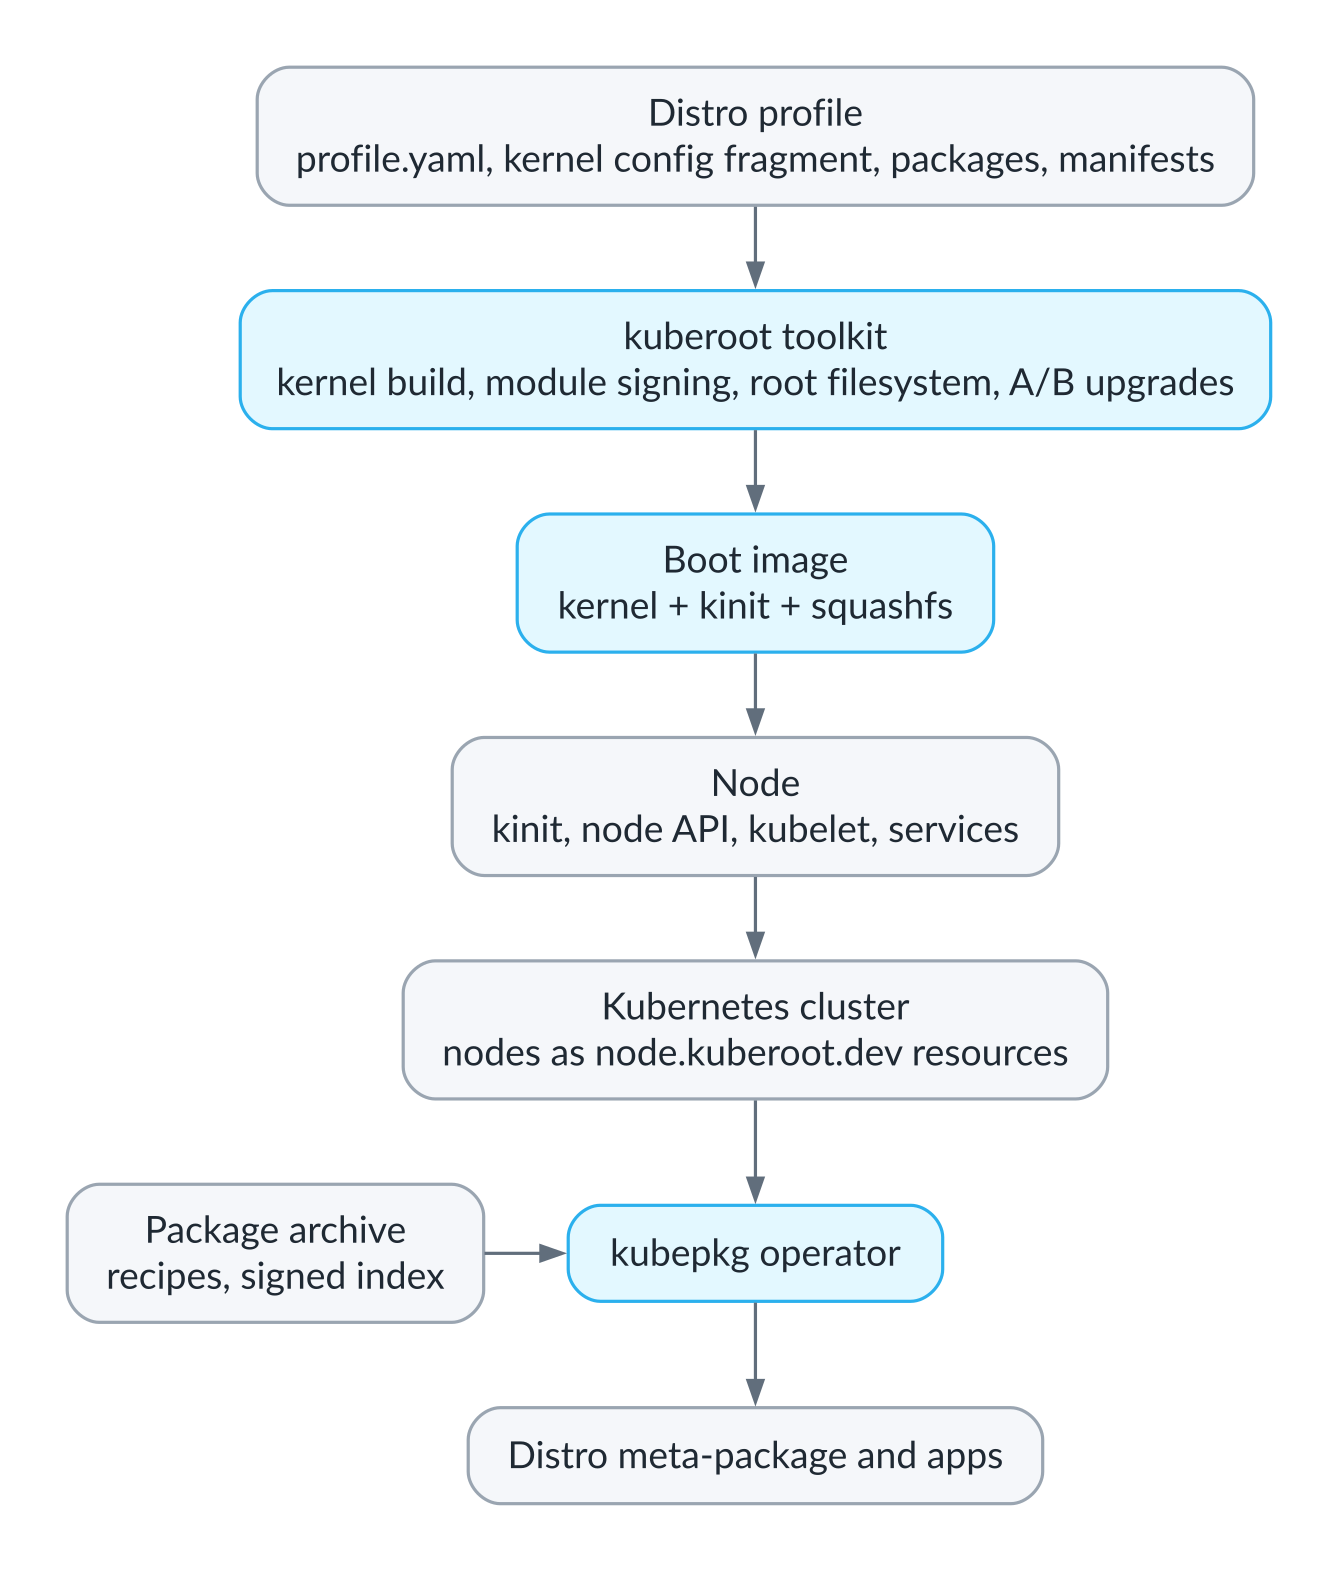
Die drei Teile des Projekts: Der Baukasten baut das Image, der Node bringt den Cluster hoch, kubepkg installiert alles Weitere
Warum Kubernetes einen eigenen Kernel braucht
So landet Kubernetes üblicherweise auf einer Maschine. Zuerst wird ein Allzweck-Betriebssystem installiert, dann Kubernetes darauf, und von diesem Moment an führen die beiden Systeme ein Parallelleben. Das Betriebssystem wird von seinem eigenen Paketmanager aktualisiert und per SSH oder über ein Konfigurationsmanagement-Werkzeug eingerichtet, während Kubernetes so tut, als gäbe es darunter nichts und hätte es nie etwas gegeben. Solange alles läuft, ist diese Anordnung völlig bequem, aber an der Nahtstelle zwischen beiden geht ständig etwas schief. Ein Kernelmodul für den Storage lässt sich nicht gegen den neuen Kernel bauen, der mit einem routinemäßigen Sicherheitsupdate gekommen ist. Der GPU-Treiber läuft den Bibliotheken im Container davon. Ein Kernel-Parameter, den ein Programm braucht, kommt einem anderen in die Quere. Ein OS-Update startet einen Node genau in dem Moment neu, in dem darauf gerade eine Datenbankmigration zu Ende lief. Und in solchen Momenten stellt sich heraus, dass die Nahtstelle niemandem gehört: Der OS-Administrator hält sie für ein Kubernetes-Problem, und Kubernetes weiß schlicht nicht, dass es sie gibt.
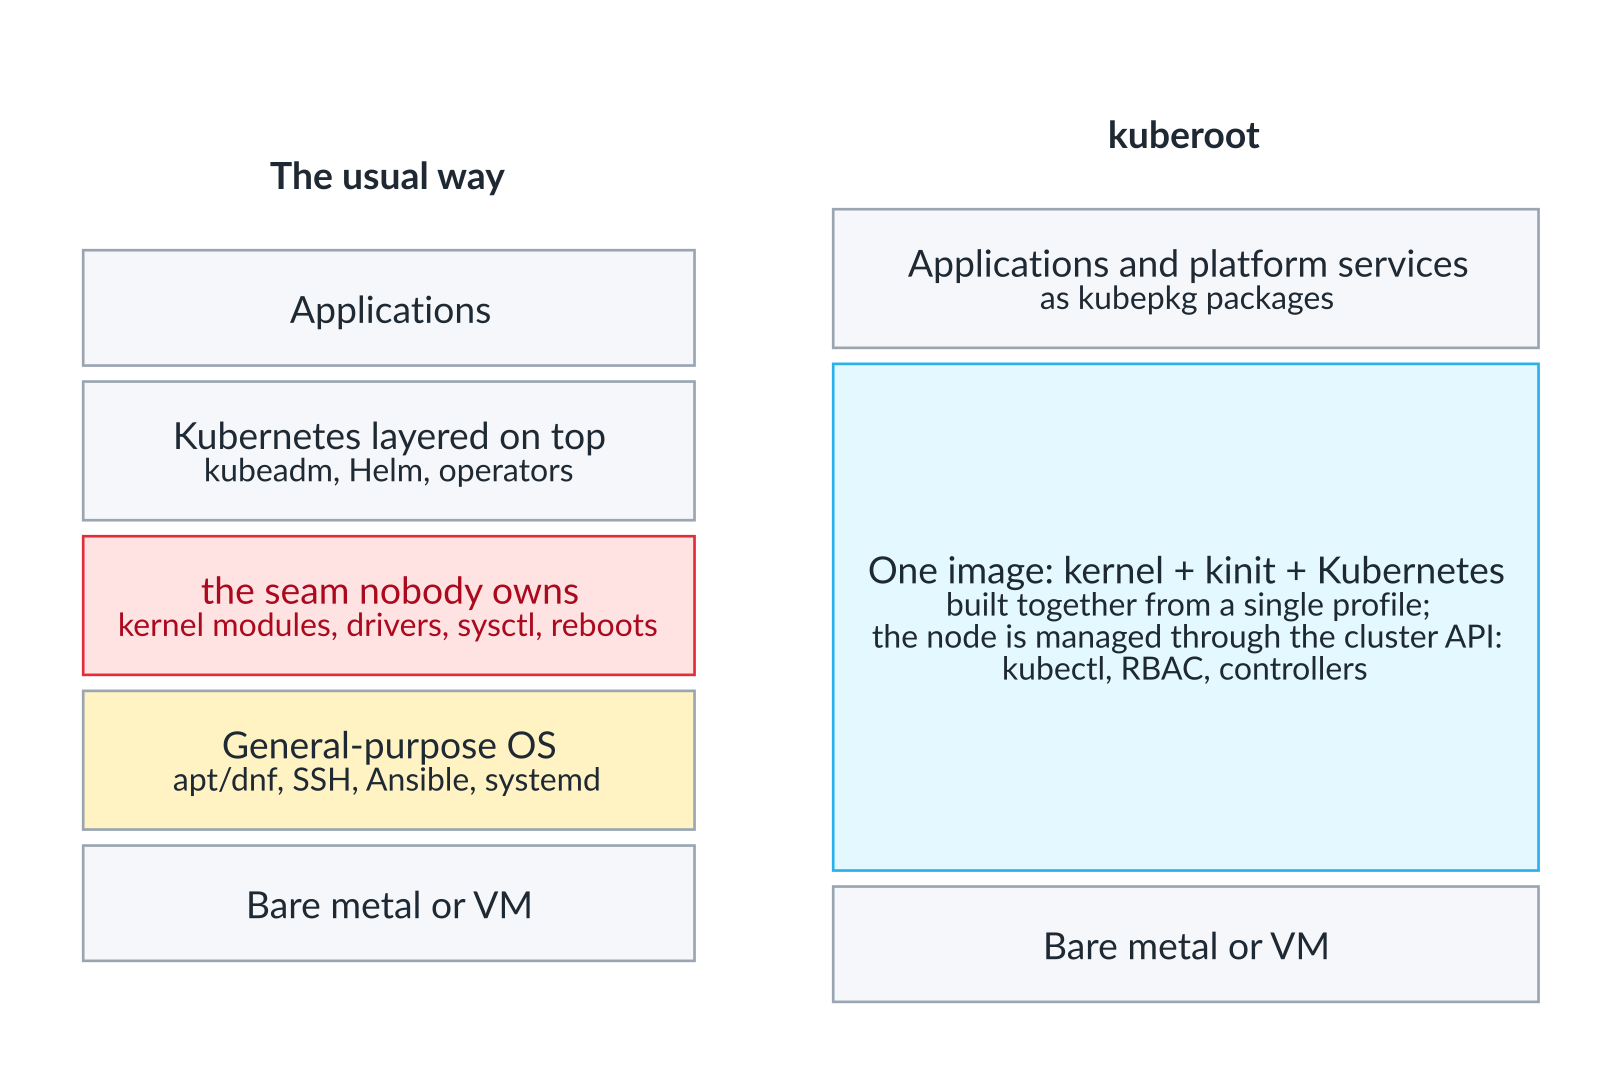
Links der übliche Stack mit einer Nahtstelle, die niemandem gehört; rechts ein Image, gebaut aus einem Profil
Talos Linux hat bereits einen sehr wichtigen Schritt in die richtige Richtung getan und gezeigt, dass ein Betriebssystem für Kubernetes unveränderlich sein kann, ohne Shell auskommt und über eine API verwaltet wird. Wir sind ihm in vielem gefolgt und haben viel von ihm gelernt. Aber Talos hat eine eigene API und ein eigenes Werkzeug zur Verwaltung der Nodes, die Grenze zwischen Node und Cluster ist also noch da; sie ist nur aufgeräumter und sicherer geworden. Ich wollte sehen, was passiert, wenn diese Grenze ganz verschwindet, sodass der Node über dieselbe API verwaltet wird wie der Cluster, mit demselben kubectl, demselben RBAC und denselben Controllern.
Es gibt einen zweiten Grund, und mir ist er sogar wichtiger als der erste. Sobald Kernel, Systemdienste und Kubernetes gemeinsam gebaut werden, in einem Build und aus einer Beschreibung, kann man Dinge tun, die auf gewöhnlichem Linux entweder unmöglich oder mühsam sind. Man kann ein Kubernetes ganz ohne Container bauen, dessen API nur als Bedienfeld einer Maschine dient, wie in unserem Router. Man kann einen Echtzeit-Kernel bauen und die vom kubelet reservierten Kerne mit denen in Deckung bringen, die der Kernel für den Scheduler-Tick und Verwaltungsaufgaben vorhält, sodass das kubelet die übrigen, isolierten Kerne exklusiv an Pods vergibt. Man kann den GPU-Treiber zum Teil des Betriebssystems machen, signiert mit dem eigenen Schlüssel des Kernels, statt ihn über einen privilegierten Container zu installieren, der direkt auf dem Node ein Kernelmodul kompiliert. Für solche Dinge wurde das Projekt eigentlich begonnen. Dass sich Nodes über die Cluster-API verwalten lassen, hat sich als glücklicher Nebeneffekt erwiesen.
Im Inneren des Nodes
Das Image und der Bootvorgang
Jede kuberoot-Distribution wird zu einem einzigen bootfähigen Image gebaut. Es enthält einen aus den Quellen gebauten Linux-Kernel; kinit, ein kleines Init, das statt systemd als PID 1 läuft; und ein unveränderliches squashfs-Root-Dateisystem mit Kubernetes, containerd, dem Datenspeicher des Clusters, unseren eigenen Programmen und dem absoluten Minimum an Systemwerkzeugen, das diese Programme brauchen. Es gibt keine Shell, keinen Paketmanager und kein SSH. Der Kernel wird als EFI-Stub gebaut und bootet direkt aus der UEFI-Firmware. Auf einer installierten Festplatte sitzt systemd-boot davor, nur um zwischen den beiden Systemslots zu wählen und die Bootversuche zu zählen.
Beim Booten mountet kinit die Systemdateisysteme, liest seine Parameter aus der Kernel-Kommandozeile, bringt das Netzwerk anhand dieser Parameter oder per DHCP hoch, setzt die Kernel-Parameter, die Kubernetes und die jeweilige Distribution brauchen, und lädt die im Profil aufgeführten Kernelmodule. Dann schreibt es 1 nach /proc/sys/kernel/modules_disabled, und bis zum nächsten Neustart kann kein Prozess auf dem Node, nicht einmal einer mit Root-Rechten, ein weiteres Modul laden. Und weil der Kernel Modulsignaturen erzwingt und nur einem Schlüssel vertraut, der für genau diesen einen Build erzeugt wurde, nimmt er schon vorher kein Modul außer seinen eigenen an. Der Signaturschlüssel ist kurzlebig: Er wird für einen einzigen Build erzeugt und danach weggeworfen, sodass nicht einmal wir ein Modul für einen bereits ausgelieferten Kernel signieren können.
Als Nächstes ermittelt kinit die Rolle des Nodes. Bringt der Node seinen eigenen Cluster hoch, erzeugt er die Zertifizierungsstelle des Clusters, Zertifikate für jede Komponente, den Signaturschlüssel für Service Accounts sowie die Konfiguration von kubelet und Container-Runtime. Tritt er einem fremden Cluster bei, holt er sich alles Nötige aus einem Join-Ticket, zu dem ich gleich komme. Dann startet er die im Profil der Distribution aufgeführten Dienste, jeden in seiner eigenen cgroup, mit Abhängigkeiten wie „kubelet erst starten, wenn der API-Server antwortet“, mit Zustandsüberwachung und mit Neustarts für alles, was umfällt.
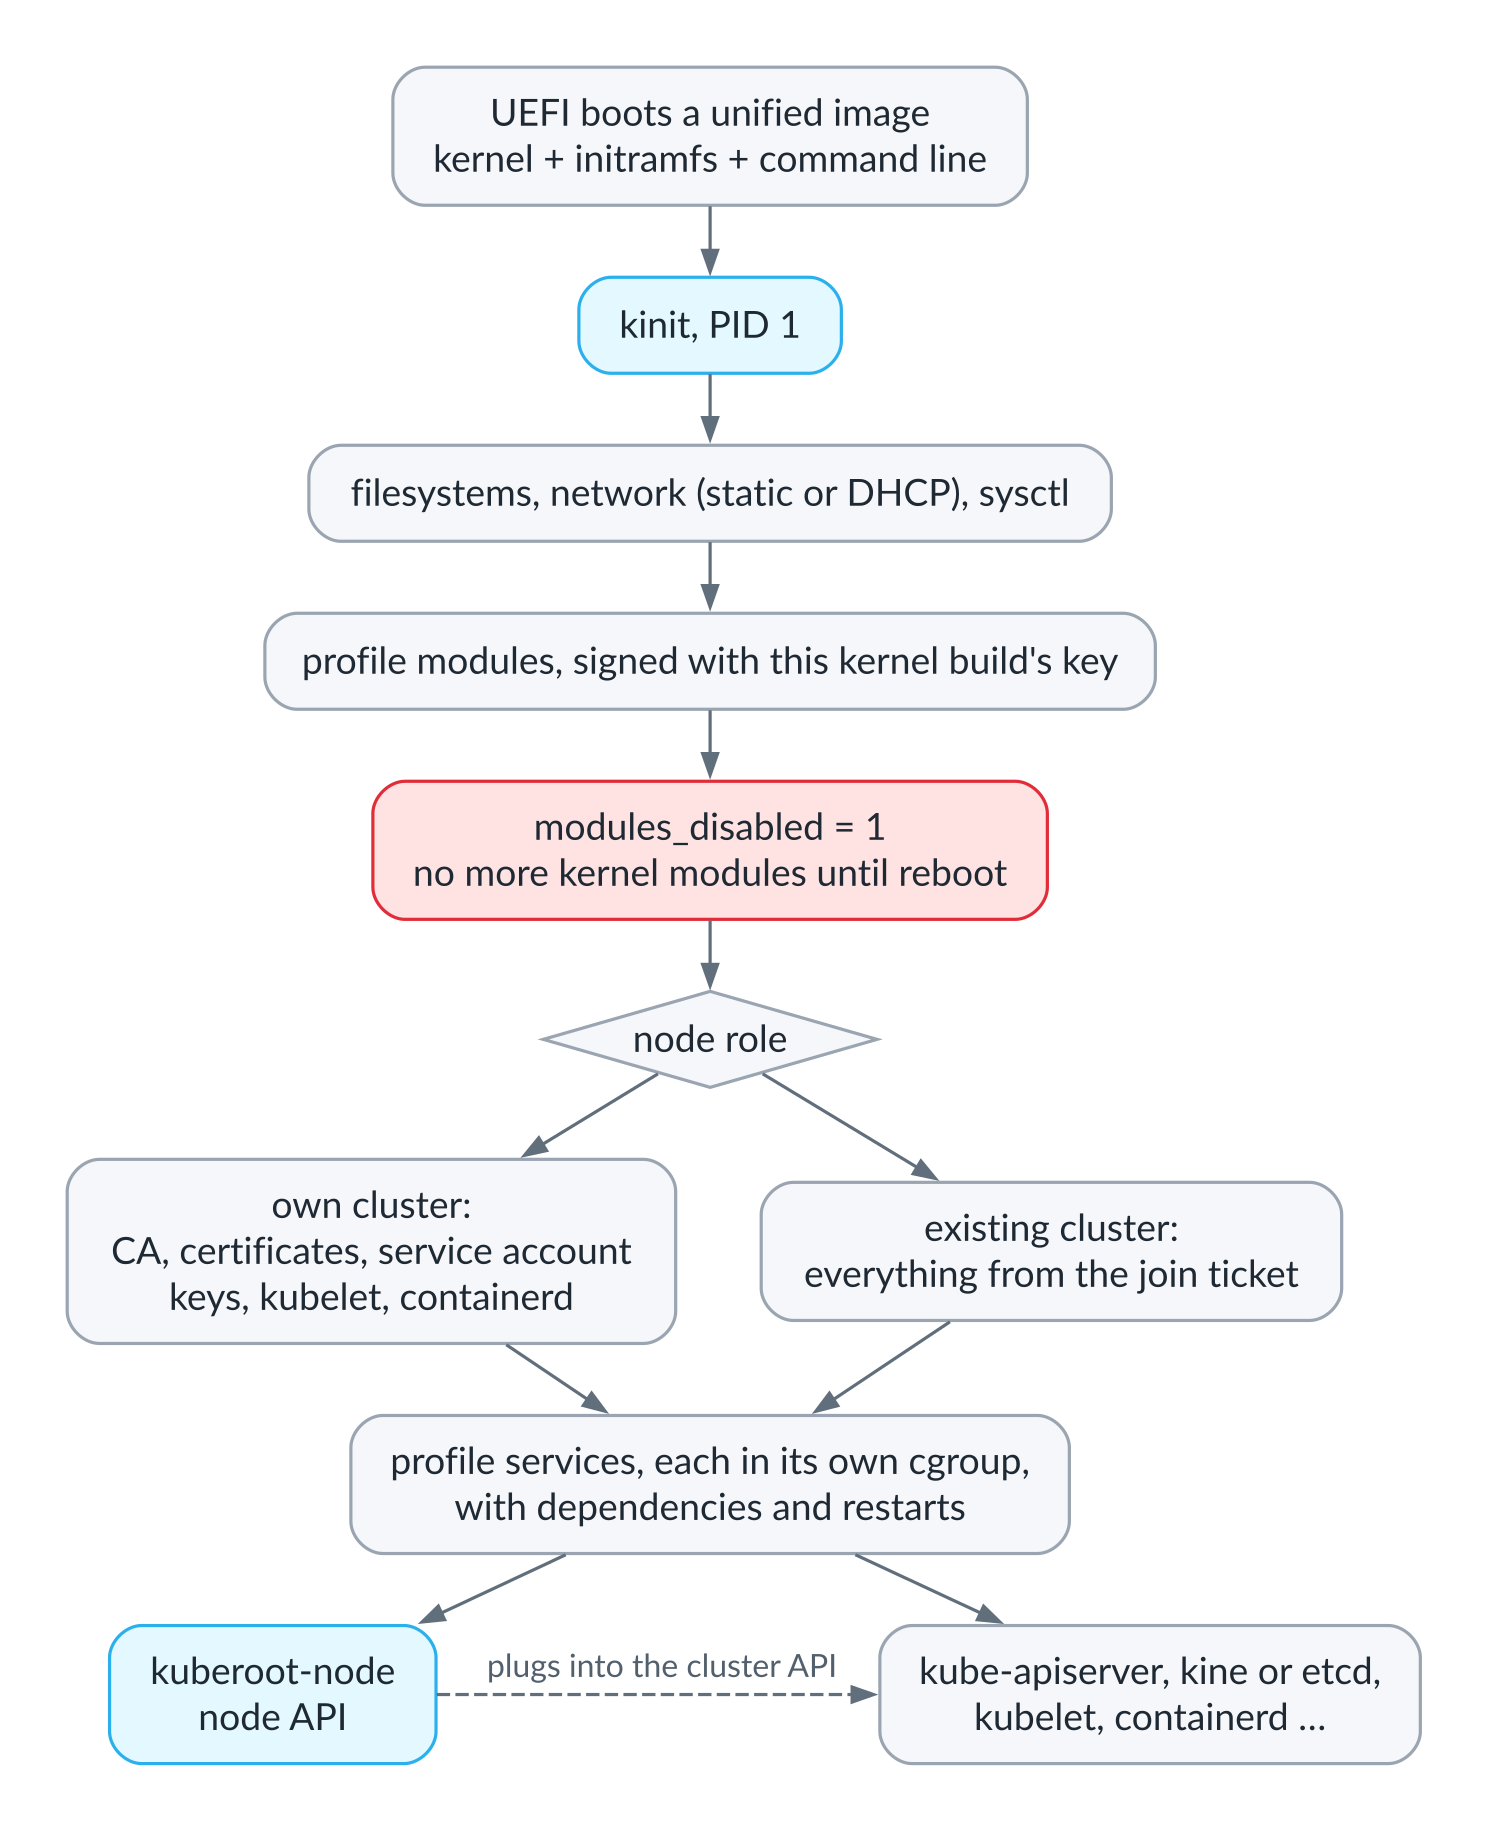
Bootvorgang des Nodes: von UEFI bis zu den Diensten des Profils
Die Node-API
Einer dieser Dienste, kuberoot-node, stellt eine kleine Node-API bereit, und das ist der Teil, den ich am liebsten bauen wollte. Sie basiert auf k8s.io/apiserver, derselben Bibliothek wie kube-apiserver selbst, und wird über den API Aggregation Layer im Cluster registriert, denselben Mechanismus, den metrics-server und andere Erweiterungen nutzen. Für einen Administrator wird der Node so zu einer Reihe gewöhnlicher Kubernetes-Ressourcen in der Gruppe node.kuberoot.dev: Man kann sie lesen, ändern, beobachten und den Zugriff darauf mit RBAC regeln, genau wie bei Pods oder Services.
| Ressource | Was sie tut |
|---|---|
| osconfigs | die Betriebssystem-Einstellungen des Nodes und was der Node über sich selbst meldet |
| nodeservices | die Dienste, die kinit ausführt, mit Zustand, Neustarts und Logs |
| disks | Blockgeräte |
| installations | Installation des Systems vom Bootmedium auf die Festplatte |
| bootentries | die beiden Bootslots und welcher davon gebootet ist |
| upgrades | Schreiben eines signierten Updates in den inaktiven Slot |
| memberships, jointickets | Beitritt von Nodes zu einem Cluster |
| statebackups | Backups des Zustands eines Control-Plane-Nodes |
Die Autorisierung funktioniert wie bei jeder aggregierten API: Eine Anfrage kommt über den API-Server des Clusters, der für die Identität des Nutzers bürgt, und die Node-API fragt den Cluster per SubjectAccessReview, ob dieser Nutzer tun darf, was er verlangt. Solange es noch keinen Cluster gibt oder solange er ausgefallen ist, stellt der Node seine API selbstständig bereit, mit einer eigenen Zertifizierungsstelle, sodass ein Administrator einen Node reparieren kann, dessen Cluster gestorben ist. Auf einem Control-Plane-Node sammelt die API die Ressourcen aller Nodes des Clusters ein und präsentiert sie unter Namen der Form <node>.<name>, wobei sie jeden Node über die Adresse in seinem Node-Objekt findet. Den kubelet-Dienst auf dem dritten Node sieht man also mit einem einzigen Befehl, ohne sich dort anzumelden und ohne auch nur seine Adresse zu kennen.
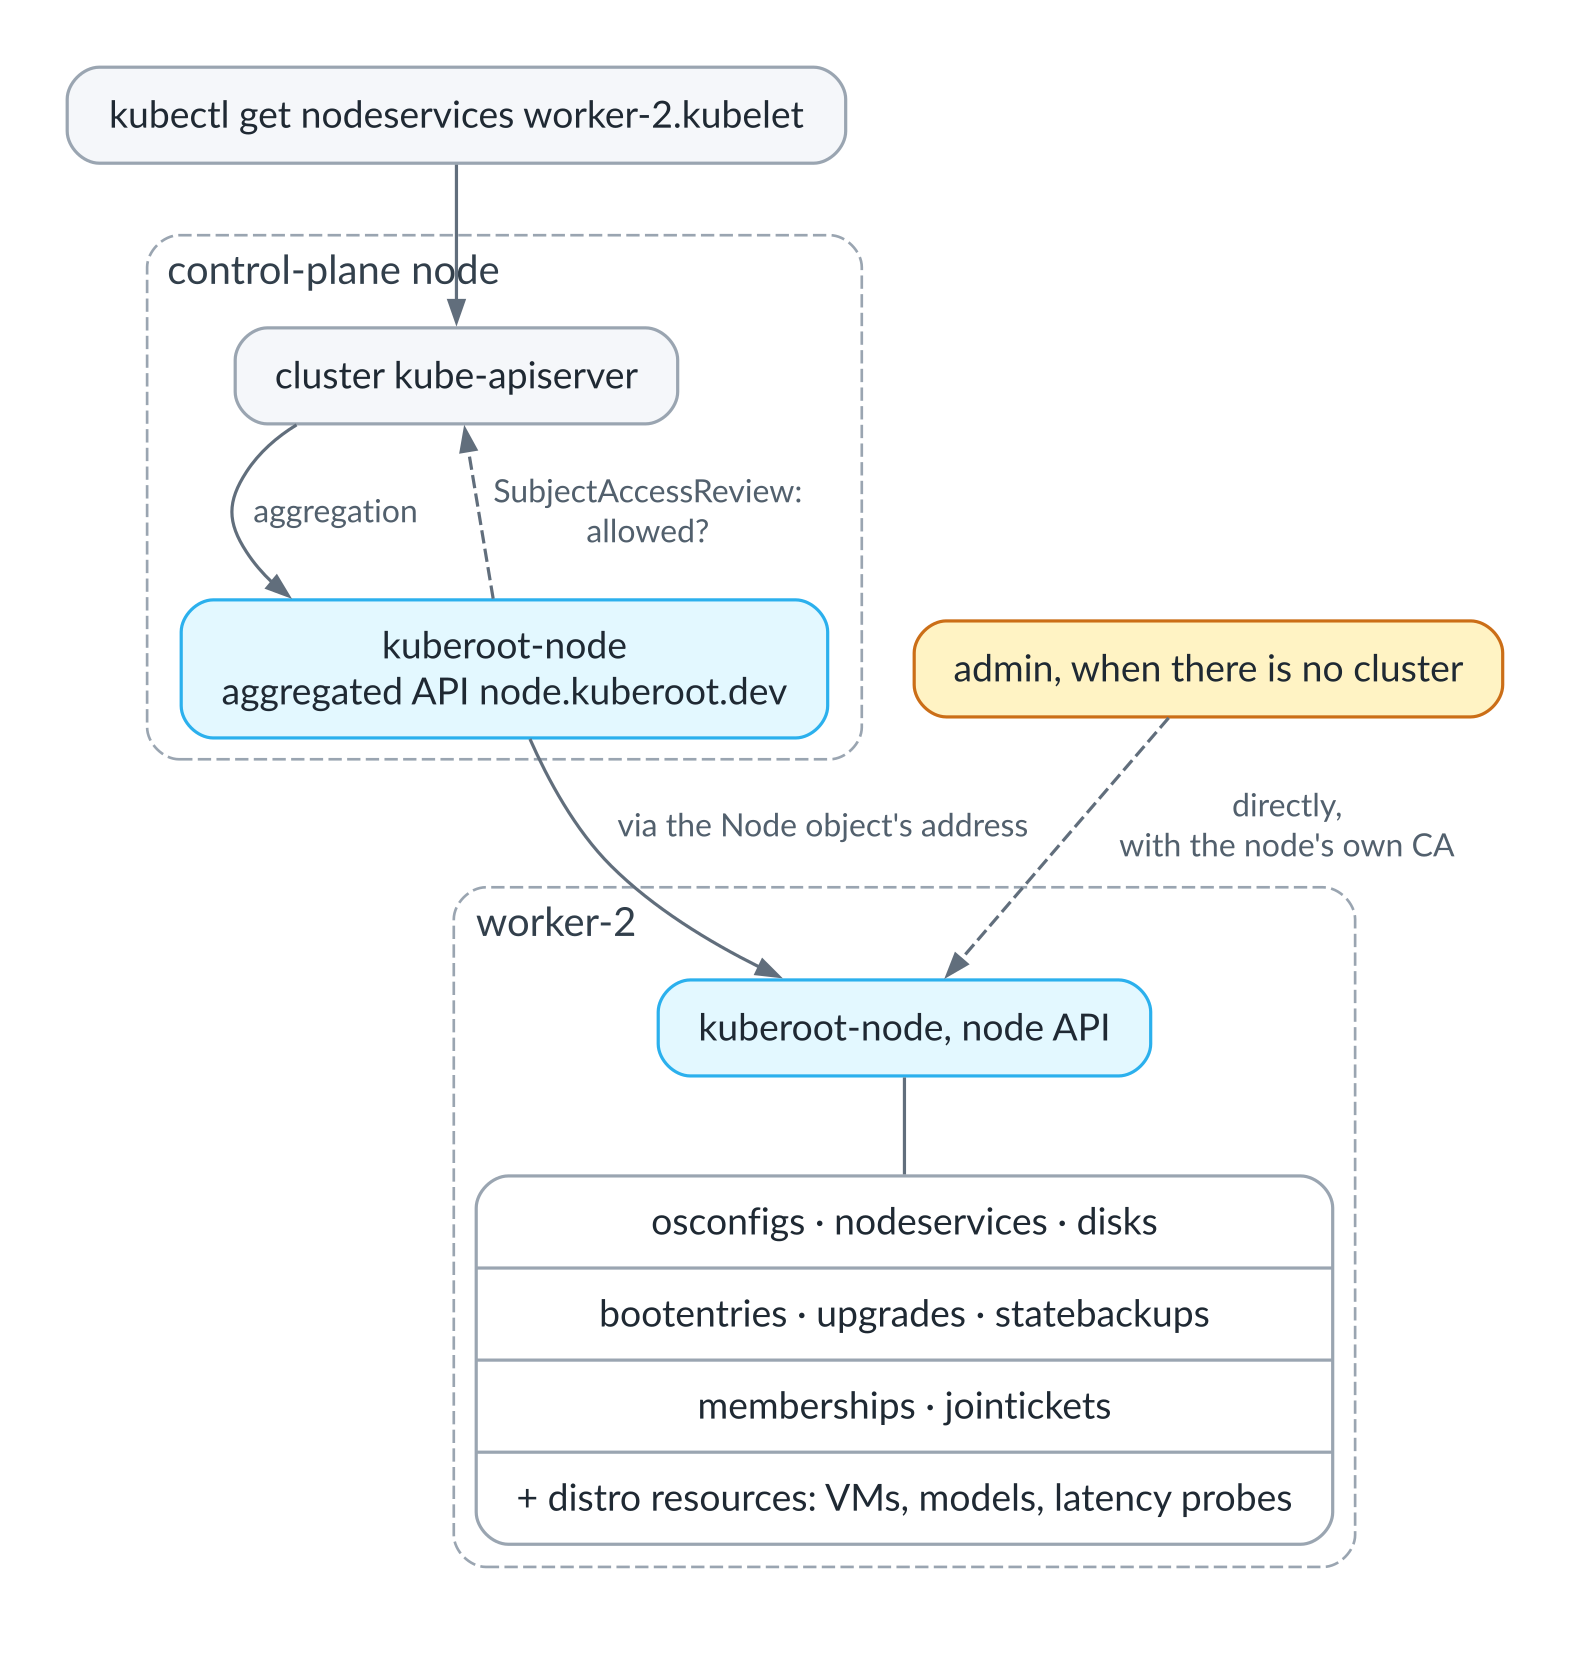
Eine Anfrage nach einem Dienst auf einem Worker-Node läuft über die Cluster-API; gibt es keinen Cluster, antwortet die Node-API selbst
$ kubectl get nodeservices
NAME                      STATE     PID   RESTARTS   MEMORY   CPU   AGE
containerd                Running   202   0          104Mi    0s    2m7s
kine                      Running   201   0          82Mi     2s    2m7s
kube-apiserver            Running   198   0          309Mi    7s    2m7s
kube-controller-manager   Running   282   0          135Mi    2s    2m2s
kubelet                   Running   280   0          112Mi    1s    2m2s
kuberoot-node             Running   204   0          127Mi    1s    2m7s
Distributionen ergänzen diese API um eigene Ressourcen. Der Hypervisor fügt Volumes und virtuelle Maschinen hinzu, die KI-Distribution Model-Server, die Echtzeit-Distribution Latenztests, und zu allen komme ich weiter unten.
Upgrades und Rollback
Upgrades funktionieren so wie bei modernen Smartphones und Autos. Die Installation auf Festplatte legt eine Boot-Partition an, zwei Systempartitionen von je einem Gigabyte und eine Zustandspartition mit allem Veränderlichen: Zertifikate, die Cluster-Datenbank, die Daten von kubelet und containerd sowie die Einstellungen des Nodes. Ein neues Release, signiert mit dem Schlüssel des Projekts, kommt als Upgrade-Ressource mit einer URL und einem Hash an. Es wird geprüft und in den inaktiven Slot geschrieben, und der Node startet auf Bewährung neu, mit einer begrenzten Zahl von Versuchen. Kommt das System nach dem Neustart hoch und laufen seine Dienste, wird der Slot als gut markiert und zum Standard. Wenn nicht, fällt der Node von selbst auf das vorherige Release zurück, ohne dass ein Mensch eingreift, allerdings nur auf ein Release, das seinerseits einmal als gut bestätigt wurde.
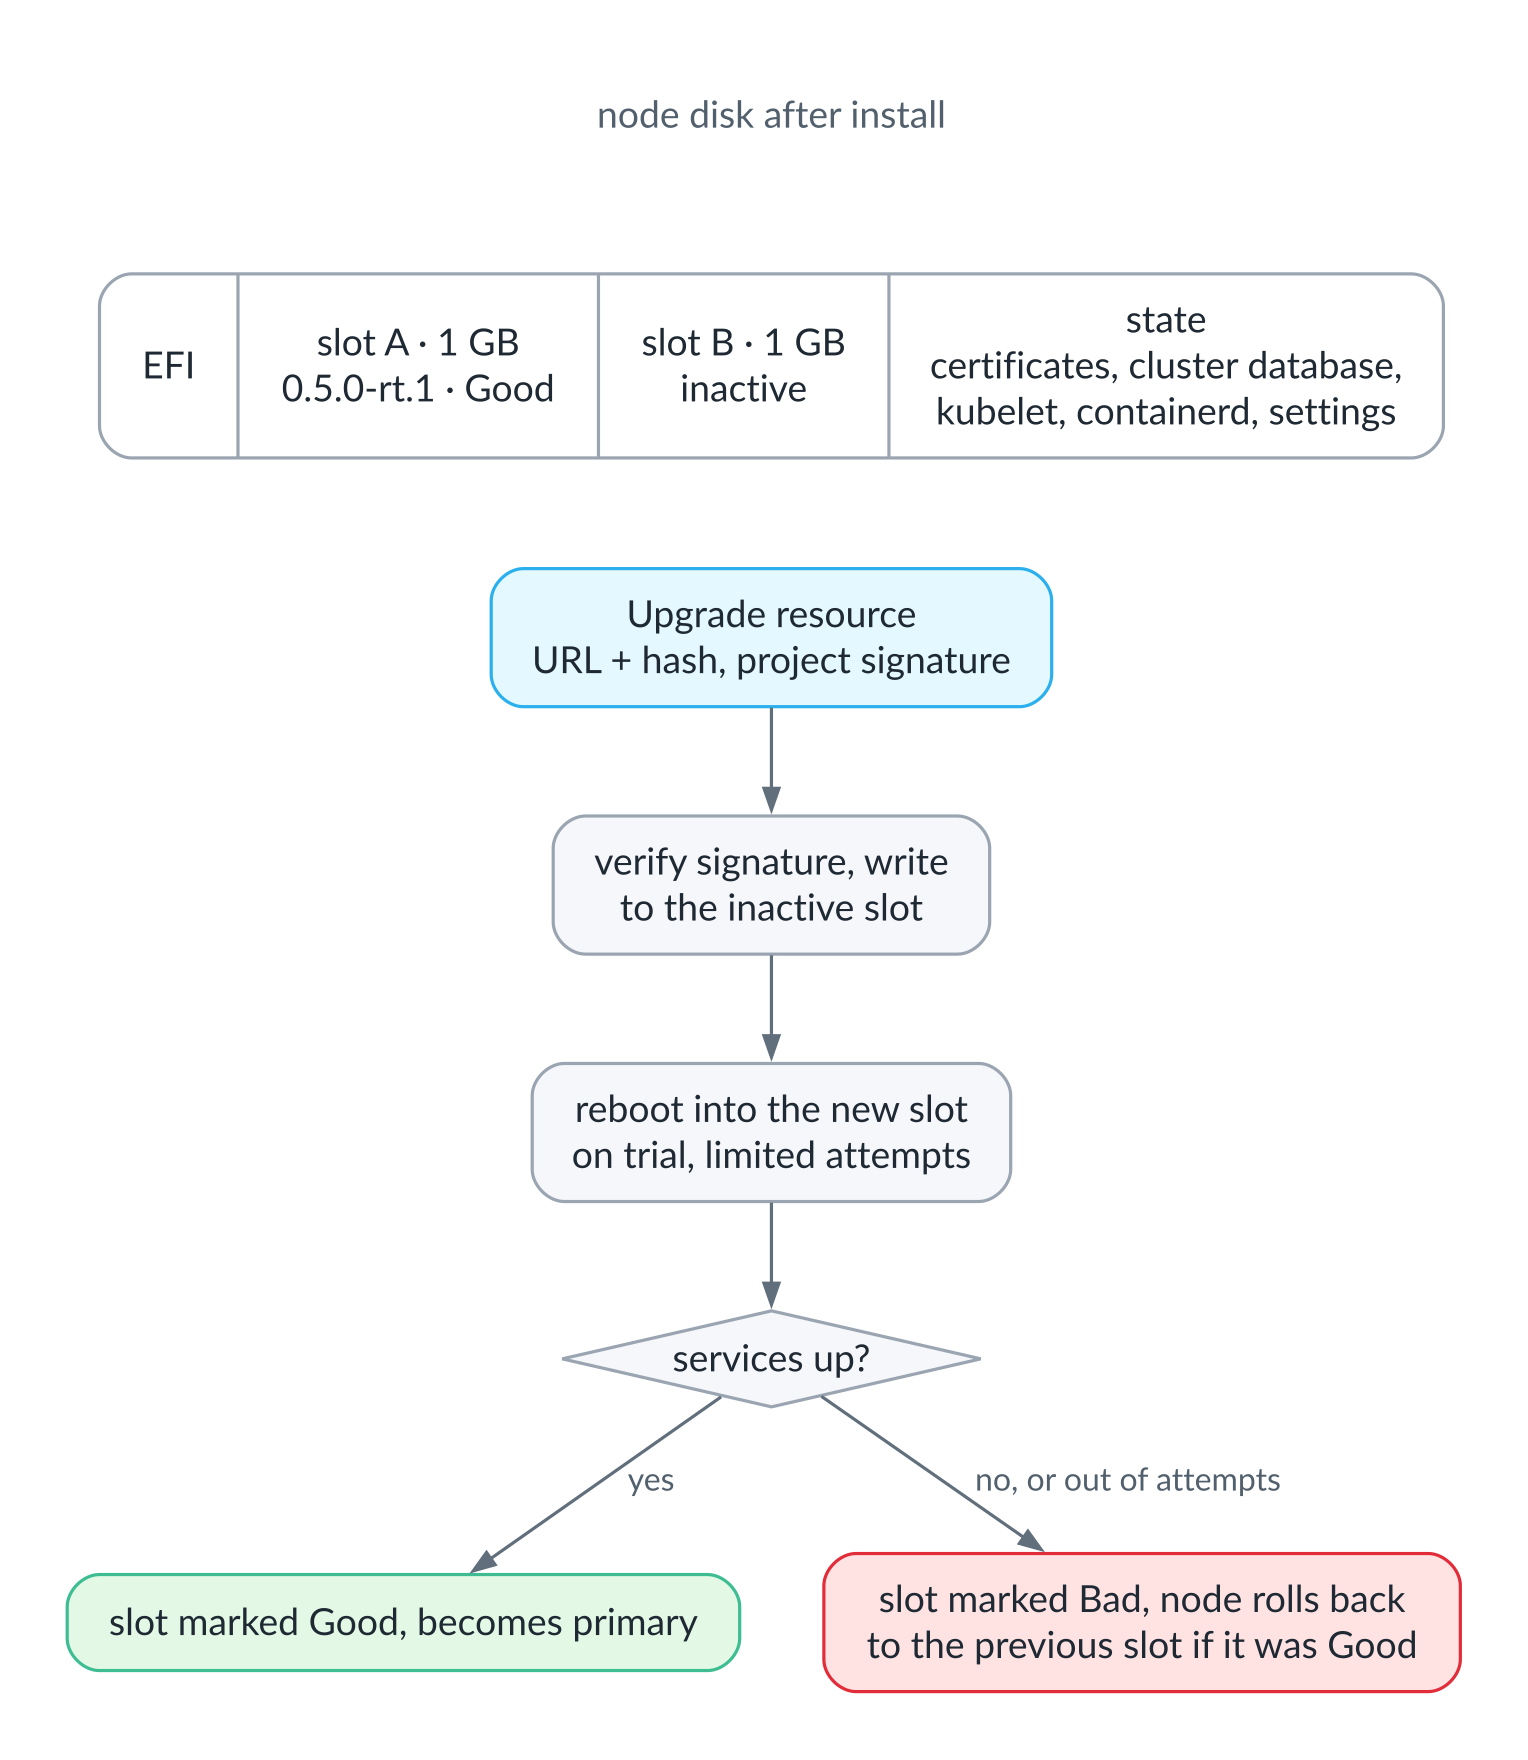
Festplattenaufteilung und Upgrade-Pfad: Ein neues Release muss zuerst seine Probezeit bestehen
$ kubectl get bootentries
NAME     RELEASE      STATE   TRIES LEFT   BOOTED   DEFAULT
slot-a   0.5.0-rt.1   Good    0            false    true
slot-b   0.5.0-rt.2   Bad     0            true     false
Diese Ausgabe entstand, als ein neues Release der Echtzeit-Distribution das kubelet nicht starten konnte. Der statische Memory Manager des kubelet hatte das Speicherlayout gesichert, das er unter dem vorherigen Kernel gesehen hatte. Unter dem neuen Kernel war etwas weniger Speicher nutzbar, der Checkpoint passte nicht mehr, und das kubelet verweigerte den Start, bis jemand seine Zustandsdatei von Hand löschte. Der Node erklärte den Slot für schlecht und rollte selbstständig zurück, und mir blieb nur, die Ursache zu finden und kinit beizubringen, die Checkpoints von CPU- und Memory Manager beim Booten zu löschen, wenn noch keine Container laufen und die Checkpoints nichts beschreiben.
Beitritt, Backups und Netzwerk
Ein neuer Node tritt über dieselbe API bei. Auf einem Control-Plane-Node erzeugt man ein Join-Token, eine vertraute Idee aus kubeadm, k3s oder Docker Swarm, nur ist unseres keine einzelne Zeichenkette, sondern ein Bündel von Zugangsdaten, im Geist einer Talos-Maschinenkonfiguration ähnlich. Eine JoinTicket-Ressource wird für genau einen Node ausgestellt, läuft innerhalb eines Tages ab und enthält die Adresse des Clusters, seine Zertifizierungsstelle, ein einmal verwendbares Bootstrap-Token für das kubelet und das Zertifikat, mit dem der Cluster der API des neuen Nodes vertrauen wird. Das Ticket wird dem neuen Node als Membership-Ressource in seiner eigenen API übergeben. Der Node konfiguriert sich für seine neue Rolle um und bezieht seine Zertifikate, das kubelet registriert sich beim Cluster, und die Anfragen des kubelet nach Serving-Zertifikaten werden automatisch genehmigt, allerdings nur für Adressen außerhalb der Pod- und Service-Netze, damit ein Node kein Zertifikat für eine Adresse bekommen kann, die ihm nicht gehört.
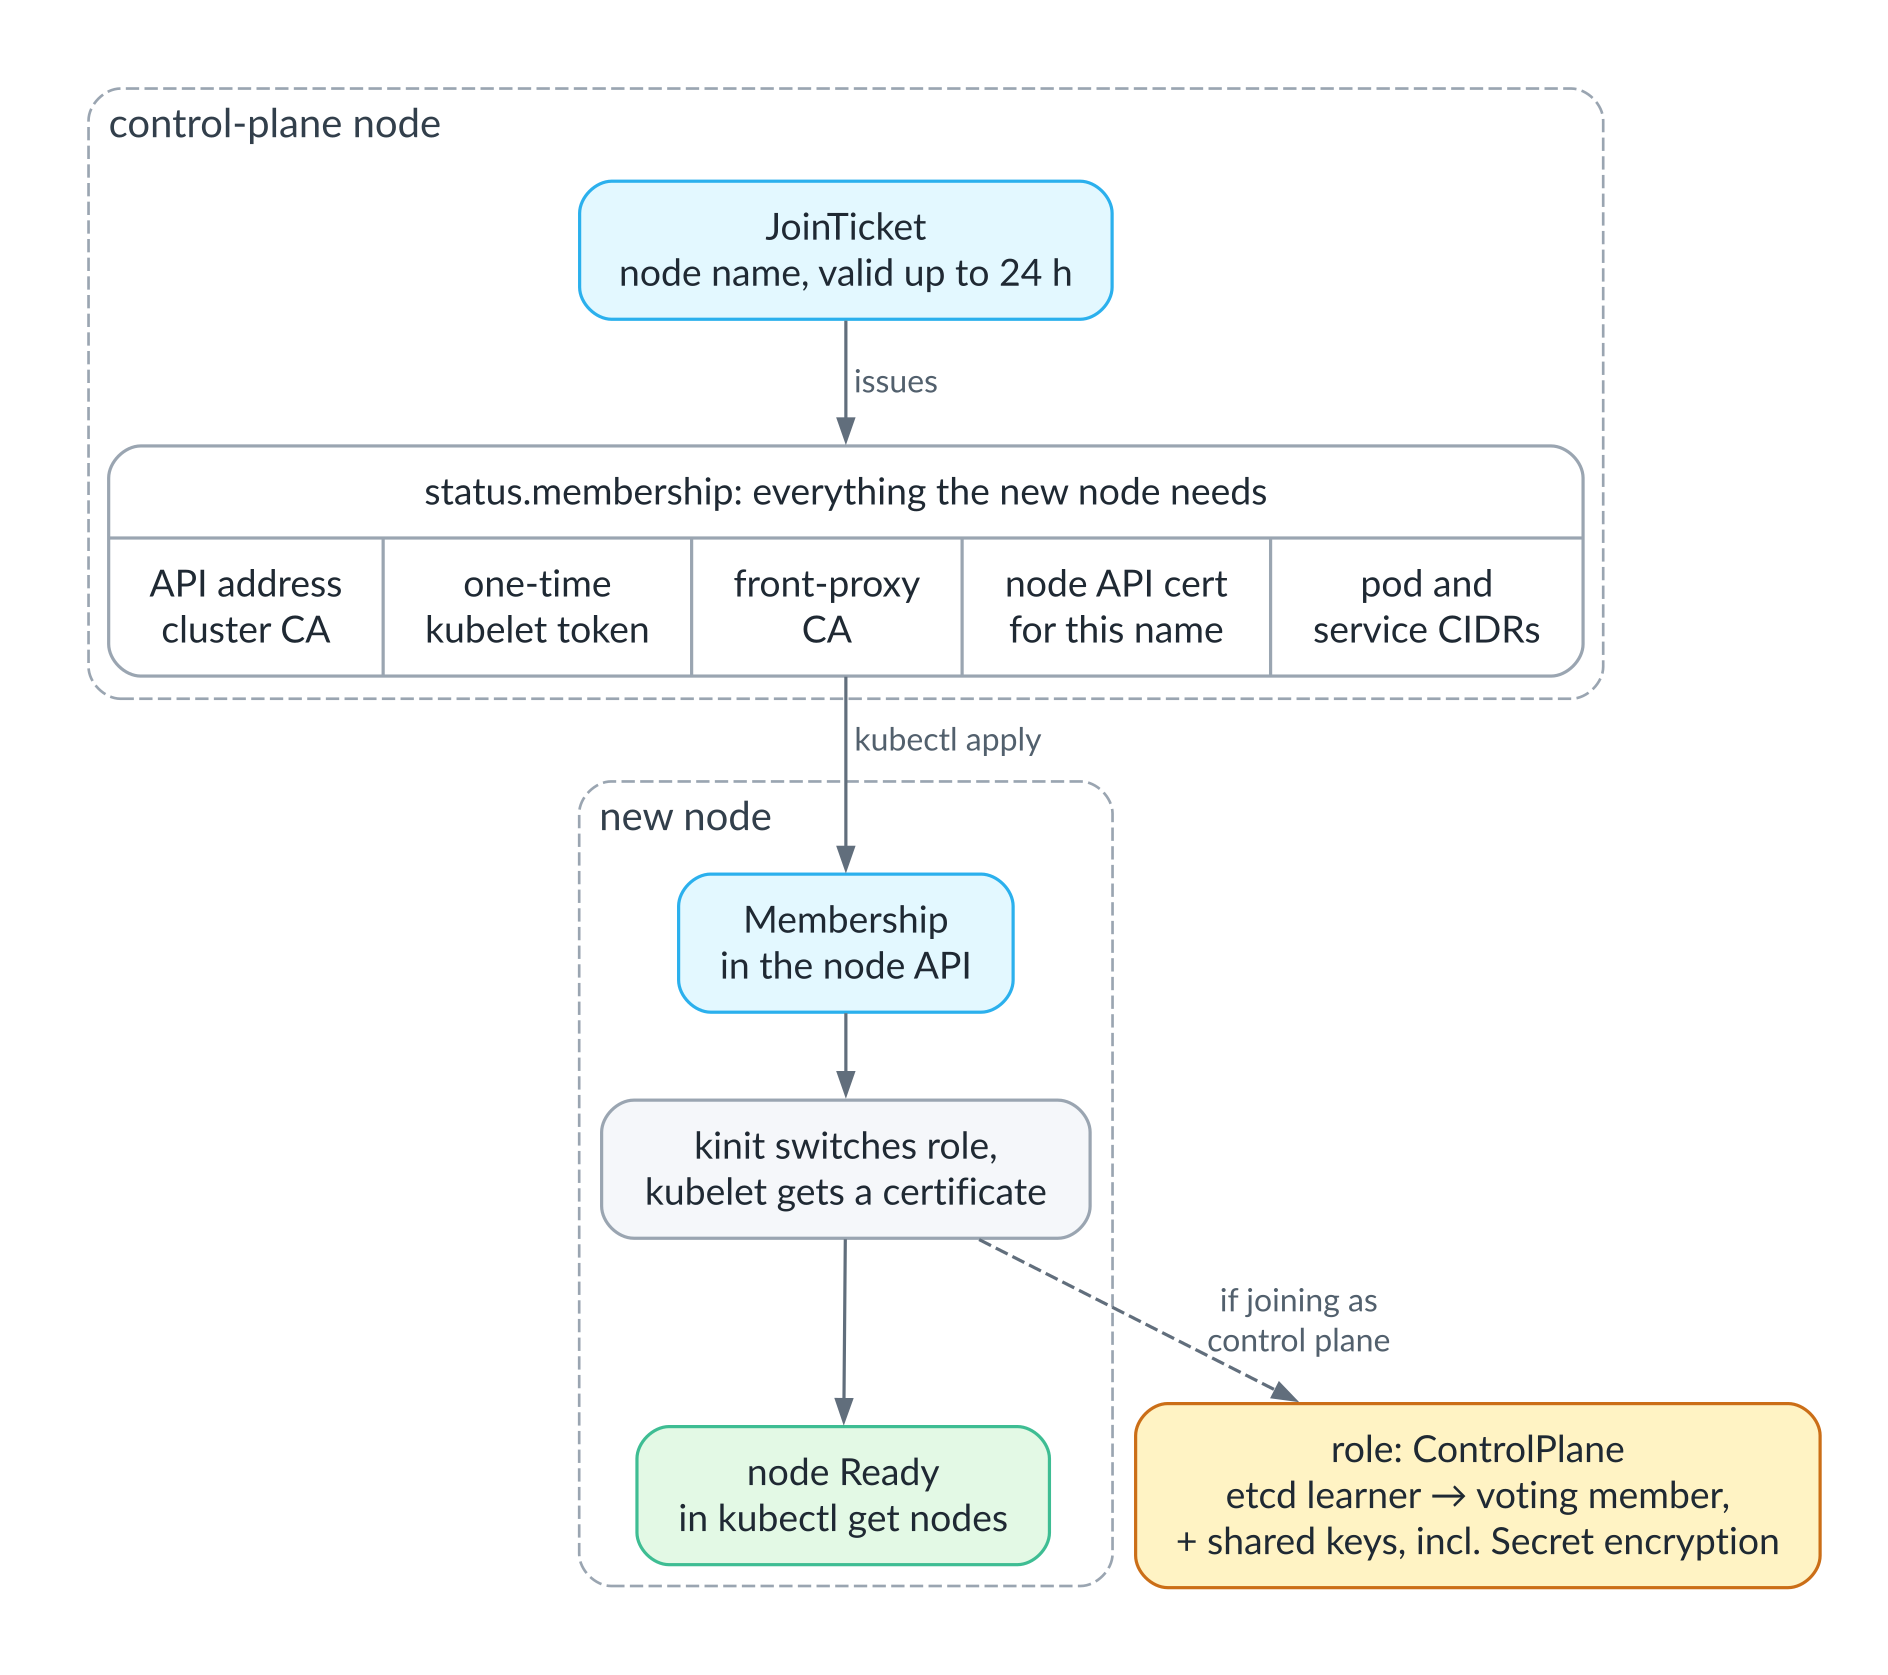
Das Join-Ticket: was darin steckt und wie ein Node dem Cluster beitritt
Backups des Zustands eines Control-Plane-Nodes entstehen nach Zeitplan oder auf Anforderung über eine StateBackup-Ressource. Ein Backup enthält genau das, was auch der Installer mitnimmt: die Zertifizierungsstellen und Zertifikate, die Identität des Nodes, die Zertifikate des kubelet und einen konsistenten Snapshot der Cluster-Datenbank. Es wird mit age verschlüsselt und in einen Object Storage übertragen. Bei der Installation des Systems auf einer neuen Maschine kann man auf ein Backup verweisen, aus dem wiederhergestellt werden soll, und der Cluster kehrt mit seinen alten Zertifikaten und alten Daten zurück, sodass die Worker-Nodes nicht einmal neu beitreten müssen.
Standardmäßig baut der Node-Dienst das Pod-Netz selbst über VXLAN auf, ohne externe Komponenten, und wenn alle Nodes in einem gemeinsamen Layer-2-Segment liegen, gibt es einen Modus mit direktem Routing ganz ohne Kapselung. Wer etwas Ernsthafteres braucht, kann das eingebaute Netzwerk abschalten und Cilium als Paket installieren; beim Storage ist es genauso, dort wird Piraeus als Paket auf DRBD installiert, dessen Kernelmodul bereits signiert im Image liegt.
Sicherheit oberhalb des Nodes
Der Paketmanager kann verlangen, dass in den Namespaces der Pakete nur Images laufen dürfen, die in einem Paket per Digest festgelegt sind, und die Distributionen tun standardmäßig genau das. Für Anwendungen gibt es typisierte Intents. Ein Nutzer beschreibt eine Anwendung mit einer High-Level-Ressource, und ein Controller entfaltet sie zu einem Deployment, einem Service und den übrigen Primitiven in einem versiegelten Namespace, in dem eine Admission Policy nur diesem Controller Änderungen erlaubt; nicht einmal der Cluster-Administrator kann sie ändern, solange er die Policy nicht entfernt. Das ist unsere Antwort auf Duggans Vorschlag, YAML durch eine typisierte Sprache zu ersetzen: Statt die Sprache zu wechseln, haben wir verkleinert, was ein Mensch überhaupt von Hand schreiben muss.
Datenspeicher und Konformität
Standardmäßig liegt der Zustand des Clusters nicht in etcd, sondern in kine auf SQLite, genau wie Duggan es für kleinere Cluster vorgeschlagen hat. Für einen einzelnen Control-Plane-Node ist das spürbar leichter und einfacher zu betreiben, und für eine hochverfügbare Control Plane verwenden wir etcd auf drei Nodes. Die Wahl fällt einmal, beim Anlegen des Clusters. Der zweite und dritte Control-Plane-Node treten mit demselben Join-Ticket bei, nur eben mit der Control-Plane-Rolle: Der Node tritt etcd als Learner bei, als Mitglied ohne Stimmrecht, holt den Rückstand zu den anderen auf und wird erst dann zum stimmberechtigten Mitglied befördert. Zusammen mit dem Ticket erhält er die gemeinsamen Schlüssel des Clusters, darunter den Signaturschlüssel für Service Accounts und den Schlüssel, mit dem Secrets at rest verschlüsselt werden; ohne Letzteren, das haben wir beim Testen herausgefunden, konnte ein neuer API-Server kein einziges Secret lesen. Der etcd-Cluster hat eine eigene Zertifizierungsstelle, getrennt von der des Clusters. Worker-Nodes erreichen die API-Server über einen im Node selbst eingebauten Load Balancer, ohne virtuelle IP und ohne externen Load Balancer, sodass das Setup in jedem Netzwerk funktioniert.
Um das zu testen, habe ich dem Node, der in diesem Moment etcd-Leader war, den Strom abgedreht. Während vier Minuten Beobachtung hörte die API, so wie die Worker sie über ihren Load Balancer sahen, nie auf zu antworten, und ein Dienst auf einem Worker-Node bemerkte überhaupt nichts: Die Führung ging an einen Nachbarn über, und vierzig Sekunden nachdem der Strom zurück war, trat der abgeschaltete Node von selbst wieder bei. Ein Node, der endgültig weg ist, lässt sich ersetzen: Er wird über die Node-API aus der Mitgliederliste von etcd entfernt, und sein Nachfolger tritt als neues Mitglied bei. Auf einem solchen Cluster ist der Datenbankteil eines Backups schlicht ein etcd-Snapshot.
Unterwegs haben wir etwas Subtiles über kine gelernt. Der Kubernetes-API-Server erwartet, dass sein Datenspeicher die Historie alle fünf Minuten kompaktiert, kine kompaktiert aber nach eigenem Zeitplan und behält standardmäßig immer die letzten tausend Revisionen, und ein kleiner, ruhiger Cluster kann Stunden brauchen, bis tausend Änderungen zusammenkommen. Alte Objektversionen lebten stundenlang, und einer der Konformitätstests für paginierte Listen, der darauf wartet, dass die Revision hinter einem Continue-Token wegkompaktiert wird, und vom Server die Antwort 410 Gone erwartet, lief immer wieder in den Timeout. Die Lösung war ein einziger Parameter; die Ursache zu finden kostete einen halben Tag und mehrere falsche Fährten.
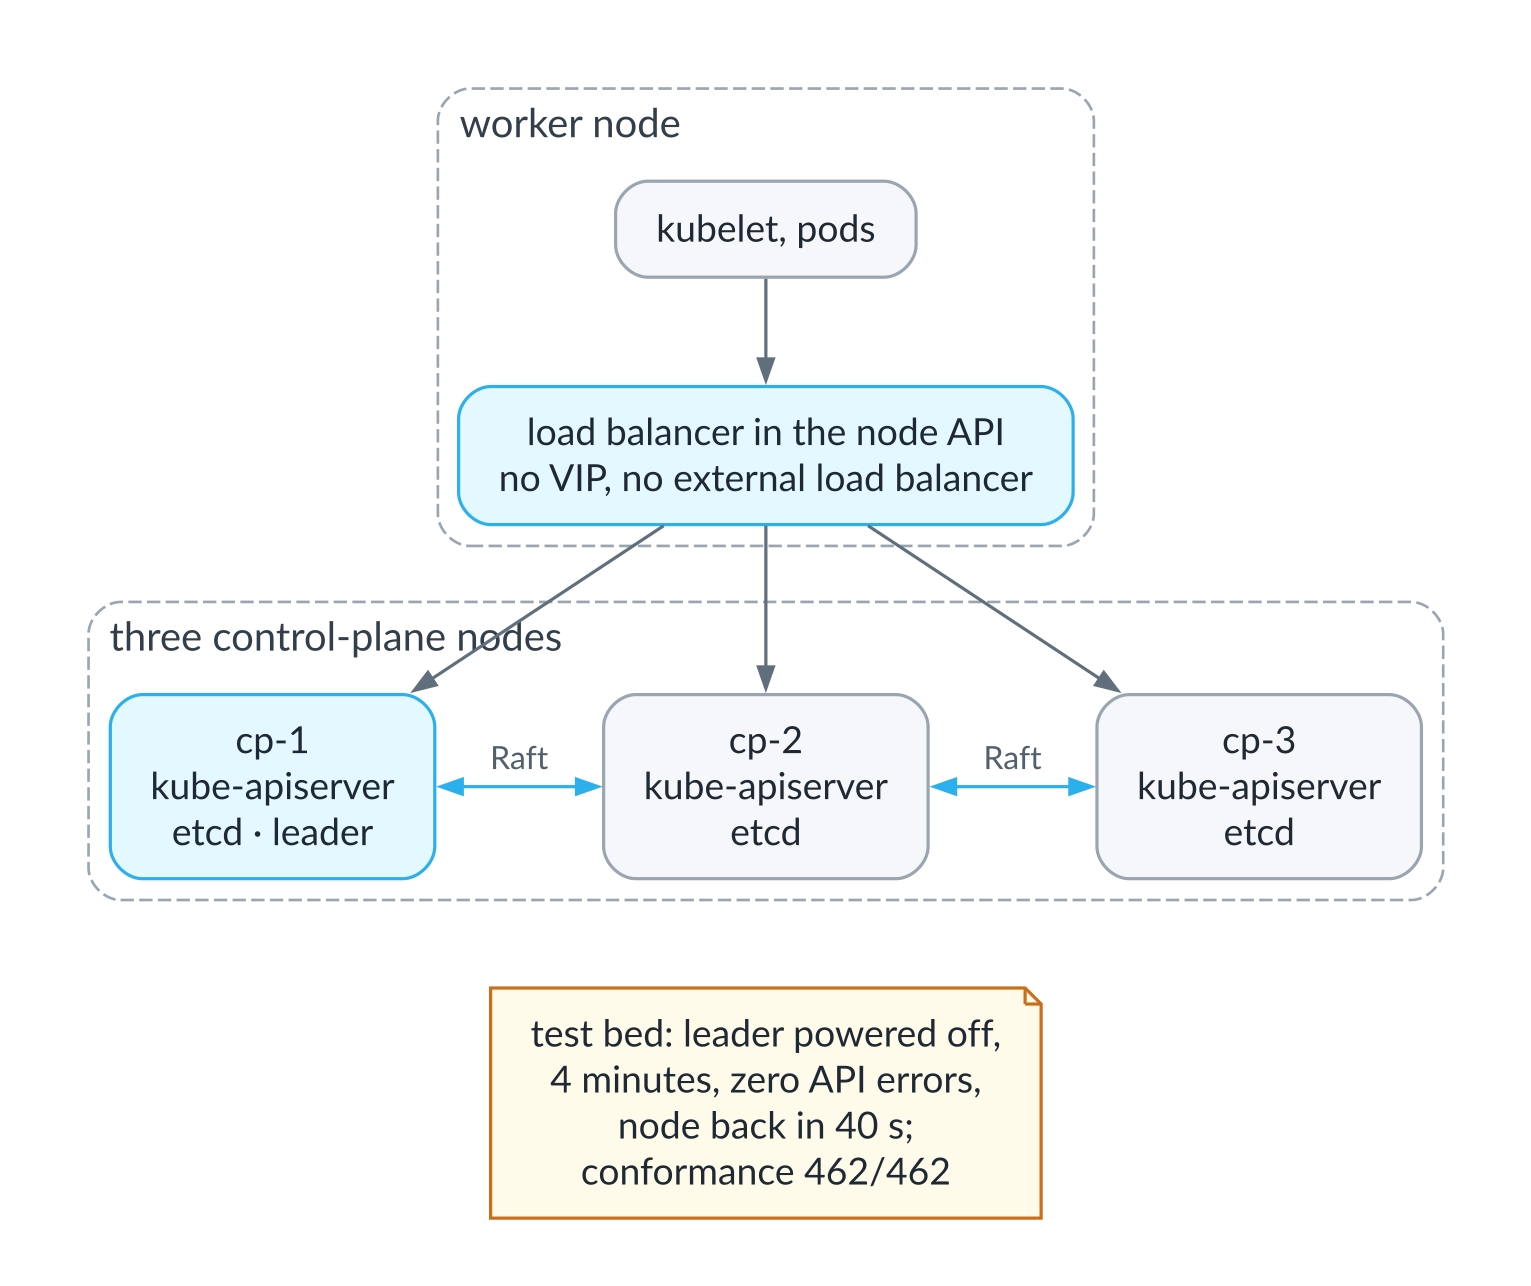
Eine hochverfügbare Control Plane: drei etcd-Nodes und ein Load Balancer auf jedem Worker
Schließlich bestehen die Distributionen, die Pods ausführen, die offizielle Kubernetes-Konformitätstestsuite. Es ist dieselbe Suite, mit der das Zertifizierungsprogramm der CNCF prüft, ob eine Distribution wirklich Kubernetes ist und nicht bloß etwas, das so aussieht. Sie besteht aus den Tests im Hauptrepository des Projekts, die als Conformance markiert sind; sie laufen gegen einen lebenden Cluster und prüfen das Verhalten von API, Scheduler, Netzwerk, DNS, Storage und allem anderen, worauf sich Nutzer verlassen dürfen. Die Ergebnisse zertifizierter Distributionen werden im Repository k8s-conformance veröffentlicht, und ausgeführt werden die Tests mit Werkzeugen wie Sonobuoy oder hydrophone; wir haben hydrophone verwendet. Auf einem frischen Drei-Node-Cluster mit Kubernetes 1.37 hat die KI-Distribution alle 462 Tests bestanden, und zwar nicht in abgespeckter Form, sondern mit allem, was dazugehört: Modellen, dem Agenten und dem GPU-Treiber im Image. Ein hochverfügbarer Cluster mit drei etcd-Control-Plane-Nodes hat ebenfalls alle 462 bestanden. Zur Zertifizierung bei der CNCF haben wir die Ergebnisse noch nicht eingereicht. Das war mir vom ersten Tag an wichtig: Nichts von allem anderen bedeutet etwas, wenn unter der Haube nicht echtes Kubernetes steckt, sondern eine Imitation davon.
Das Innenleben des Nodes, vom Bootvorgang über Upgrades und Backups bis zu den Gründen, warum er keine Shell hat, bekommt einen eigenen ausführlichen Artikel.
Wie eine Distribution entsteht
Eine Distribution beschreiben
Nun zu dem Grund, aus dem das alles begonnen wurde. Eine kuberoot-Distribution wird durch eine einzige Profildatei und ein kleines Verzeichnis daneben beschrieben, und diese Beschreibung möchte ich etwas genauer durchgehen, denn sie beantwortet die Frage, ob man ein eigenes Kubernetes für einen eigenen Zweck bauen kann, ohne alles von Grund auf neu zu schreiben und ohne einen Fork eines Betriebssystems zu pflegen.
Das Profil legt fest, welche Kernelmodule beim Start mit welchen Parametern geladen werden, welche Kernel-Parameter gesetzt werden, welche Dienste auf Control-Plane- und Worker-Nodes laufen, mit welchen Argumenten und in welcher Reihenfolge, was zur kubelet-Konfiguration hinzukommt, welche Ressourcen beim ersten Start auf den Cluster angewendet werden und ob Pakete installiert werden sollen. Dienstargumente werden als Templates geschrieben, in die kinit die Adresse des Nodes, die Pfade zu den Zertifikaten und die Netzwerkeinstellungen einsetzt, sodass dasselbe Profil auf jedem Node funktioniert. So deklariert zum Beispiel das Profil der KI-Distribution die Module des NVIDIA-Treibers und den Dienst, der die Modelle des Clusters verwaltet.
apiVersion: kuberoot.dev/v1alpha1
kind: Distribution
metadata:
  name: ai
spec:
  modules:
  - name: drbd
    params: usermode_helper=disabled
  - name: nvidia
  - name: nvidia_uvm
  roles:
    controlPlane:
      generators: [node, cluster, containers, kubelet]
      addons: true
      packages: true
      services:
      - name: kuberoot-aictl
        after: apiserver
        args:
        - /usr/bin/kuberoot-aictl
        - --kubeconfig={{kube "admin.kubeconfig"}}
        - --listen=:8000
Die kubelet-Einstellungen, die eine Distribution zu den Basiseinstellungen hinzufügt, stehen ebenfalls im Profil, und kinit lässt ein Profil nichts überschreiben, ohne das der Node nicht leben kann, etwa Authentifizierung und Zertifikate. Hier schaltet zum Beispiel die Echtzeit-Distribution die statischen Policies für CPU- und Memory Manager ein und reserviert die ersten beiden Kerne für das System.
Neben dem Profil kann ein Fragment der Kernel-Konfiguration liegen, falls die Distribution einen eigenen Kernel braucht; eine Liste zusätzlicher Systemprogramme für das Image; ein Skript, das dem Image hinzufügt, was Pakete nicht liefern können, etwa den NVIDIA-Treiber oder den Hypervisor; und Manifeste, die beim Start auf den Cluster angewendet werden, zum Beispiel die eigenen Ressourcendefinitionen der Distribution und die RBAC-Regeln dafür.
Der Build
Der Build durchläuft mehrere Schritte, und alle sind für jede Distribution dieselben. Zuerst wird der Kernel aus der Basiskonfiguration plus dem Fragment der Distribution gebaut, falls es eines gibt, und jede Kernel-Variante entsteht in ihrem eigenen Verzeichnis, damit die Echtzeit-Distribution mit ihrem PREEMPT_RT-Kernel niemandem in die Quere kommt. Dann werden Module von Drittanbietern gegen diesen Kernel gebaut, etwa DRBD für replizierte Festplatten oder die offenen GPU-Kernelmodule von NVIDIA, und mit dem Schlüssel signiert, der beim Kernel-Build erzeugt wurde. Danach kommen unsere eigenen Programme. Zusammen mit Kubernetes, containerd, dem Datenspeicher, einem minimalen Satz an Systemwerkzeugen und den Zutaten der Distribution wandern sie ins Root-Dateisystem, und zuletzt wird die initramfs gebaut. Das fertige System wird in ein signiertes Update-Bundle gepackt, das Nodes vor der Installation prüfen, und in Bootmedien für die Erstinstallation.
Die Versionen von allem, was von außen kommt, von Kubernetes und containerd bis zum NVIDIA-Treiber und der Inferenz-Engine, sind in einer einzigen Datei festgelegt, und alles, was aus den Quellen gebaut wird, entsteht aus festgelegten Tags, sodass zwei Builds desselben Commits funktional identische Systeme ergeben (nicht bitgenau identisch, weil jeder Kernel-Build einen frischen Signaturschlüssel bekommt). Schwere Builds wie der Kernel oder der GPU-Build der Inferenz-Engine laufen auf einer Build-Maschine statt auf dem Laptop eines Entwicklers.
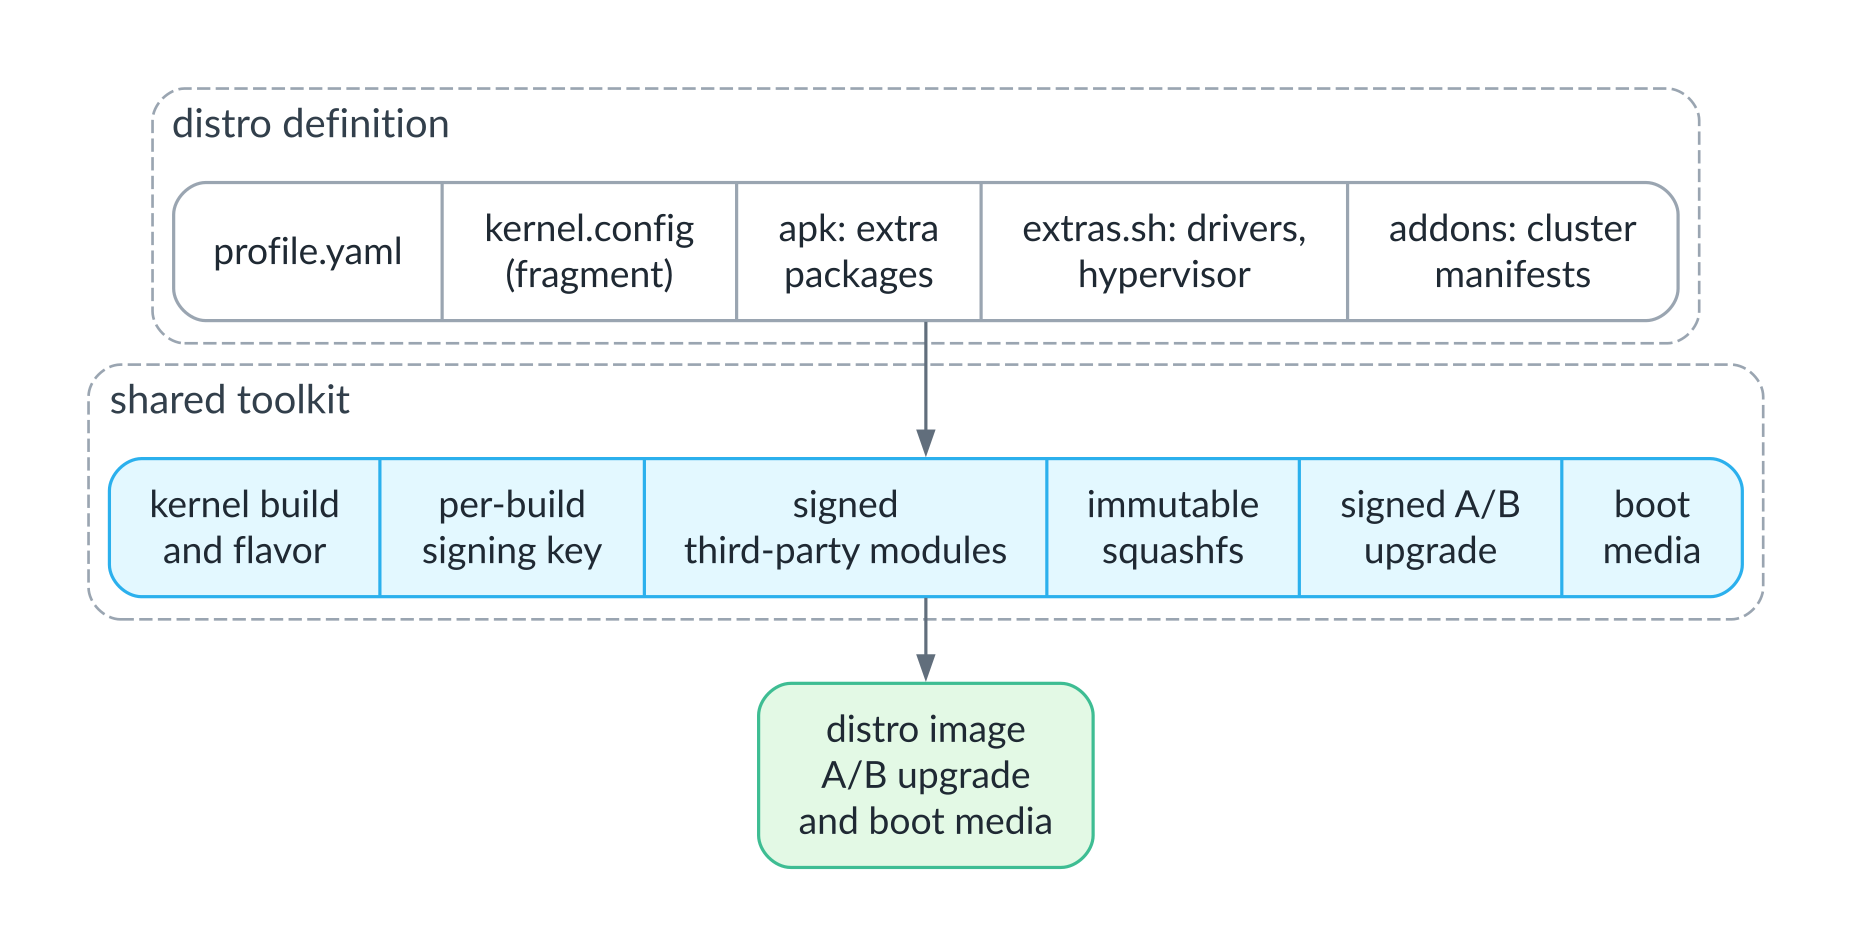
Woraus eine Distribution gebaut wird: ihre eigene Beschreibung plus der gemeinsame Baukasten
Alles andere gibt es gratis dazu. Installation auf Festplatte, Upgrades mit Probezeit und Rollback, Backup und Wiederherstellung, der Beitritt von Nodes zum Cluster, die Verwaltung von Nodes per kubectl, der Paketmanager und die Konformitätstests sind für jede Distribution dieselben, und wer eine neue schreibt, muss über nichts davon nachdenken.
Eine neue Art von Objekt, an zwei Stellen
Braucht eine Distribution ein Objekt, das Kubernetes nicht hat, etwa eine virtuelle Maschine, ein Sprachmodell, einen Industriesensor oder eine Netzwerkschnittstelle, wird es an zwei Stellen ergänzt. Auf dem Node erscheint eine neue Ressource in der Node-API, hinter der ein gewöhnlicher Prozess steht, der weiß, was dieses Objekt braucht, sei es einen Hypervisor zu betreiben, ein Modell auszuliefern, einen Sensor abzufragen oder Routing-Tabellen zu programmieren. Auf der Control Plane erscheint ein Controller mit eigener CustomResourceDefinition; er entscheidet, welcher Node was ausführen soll, übergibt jedem Node seinen Anteil über dessen API und sammelt den Zustand wieder ein.
Das ist genau das Muster, mit dem Kubernetes seit Jahren erweitert wird, nur eine Schicht tiefer geschoben, auf die Maschine selbst, und deshalb kamen neue Distributionen so schnell zusammen. Mit der Zeit begannen die Distributionen, Teile zu teilen. Der Mechanismus, der Änderungen auf Probe setzt und automatisch zurückrollt und zuerst im Router auftauchte, wanderte später in ein gemeinsames Paket und wird heute auch vom Sensor-Gateway und vom Monitoring-Cluster genutzt. Ebenso teilen sich virtuelle Maschinen und Model-Server die Schleife, die jede Node-Ressource unabhängig abgleicht, sodass eine lange Operation an einem Objekt die übrigen nicht aufhalten kann.
Eine ausführliche Tour durch den Builder, mit einem durchgehenden Beispiel, in dem wir Schritt für Schritt eine kleine Distribution von Grund auf bauen, wird ein eigener Artikel.
Der Paketmanager und Duggans Liste
Woher er kommt
Der Paketmanager kubepkg ist aus cozypkg hervorgegangen, dem Paketierungswerkzeug, das wir für die Plattform Cozystack gebaut haben, als wir sie auf eine paketbasierte Architektur umgestellt haben. In Cozystack löste es ein sehr spezifisches Problem dieser Plattform; für kuberoot musste es zu einem eigenständigen Projekt umgebaut werden, das auf jedem Kubernetes-Cluster läuft, nicht nur auf unserem, und sich über Konfiguration statt über Forks in eine Plattform einfügt. Unterwegs hat es eine Abhängigkeitsauflösung nach Capabilities bekommen, einen Dry-Run-Plan der Änderungen, bevor irgendetwas installiert wird, Signaturen und Vertrauen pro Repository, Air-Gap-Installationen, die Fähigkeit, bereits installierte Komponenten zu übernehmen, eine Admission Policy für Images, SBOMs und Schwachstellenscans und vieles mehr, worüber ich in einem eigenen Artikel schreiben werde.
Was ein Paket ist
Ein Paket in kubepkg ist ein gewöhnliches, unverändertes Helm-Chart plus ein kleiner Deskriptor daneben, der angibt, was das Paket bereitstellt und was es benötigt, womit es kollidiert, welche CRDs ihm gehören, welche Berechtigungen es im Cluster braucht, ob ein Rollback auf die vorherige Version sicher ist und woran man erkennt, dass jeder seiner Teile gesund ist. Das war eine bewusste Entscheidung. Es gab reichlich Versuche, Kubernetes ein eigenes Paketformat zu geben, und alle sind an derselben Tatsache gescheitert: Hersteller veröffentlichen bereits Helm-Charts und werden sie einem neuen Standard zuliebe nicht neu paketieren. Fertige Pakete bleiben gewöhnliche Charts in OCI-Registries, lassen sich also auch ohne kubepkg installieren, über Flux, Argo CD oder Helm selbst, und kubepkg kann sie entweder selbst installieren oder an Flux oder Argo CD übergeben.
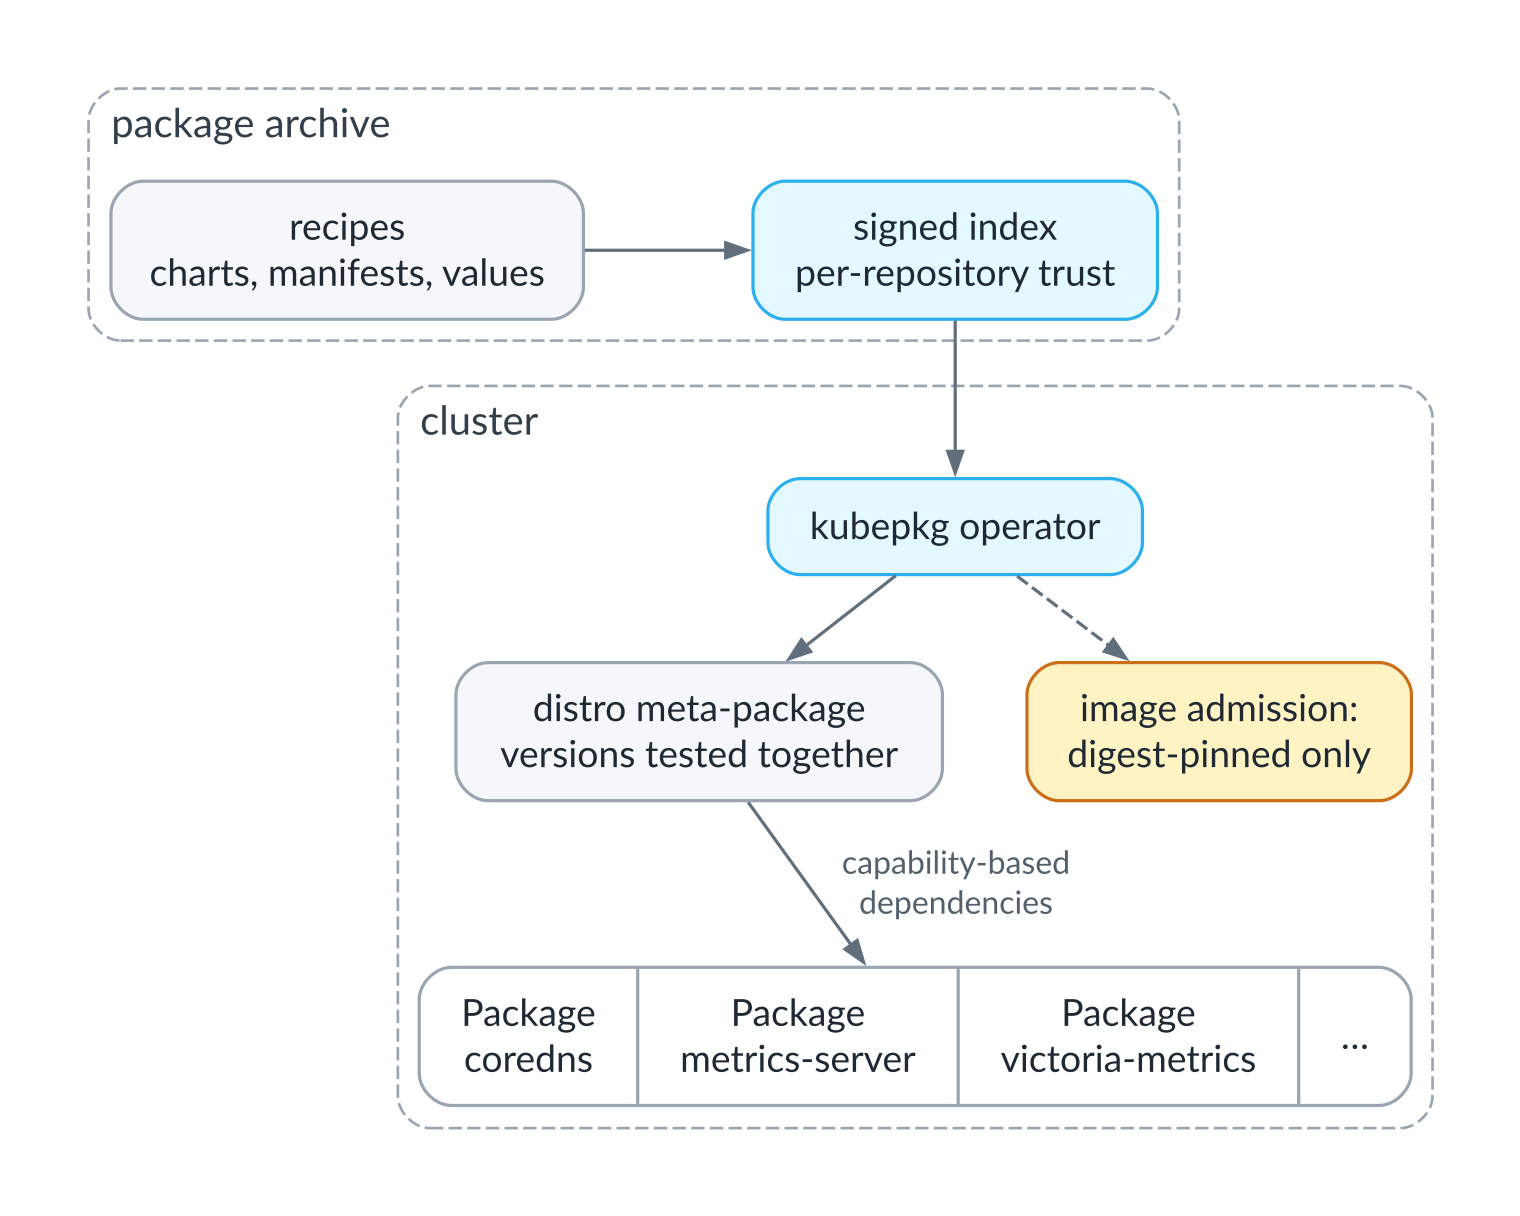
Vom Rezept im Archiv zum Paket im Cluster
Eine Distribution funktioniert in diesem Modell wie eine Linux-Distribution: eine Basis plus ein Metapaket, das die Versionen eines getesteten Satzes festlegt und ihn als Ganzes hereinholt. Wenn ein Node mit einer Distribution einen Cluster hochbringt, installiert kinit das Metapaket dieser Distribution von selbst, und von da an holt sich der Nutzer, was er braucht. Für die KI-Distribution etwa hält das Archiv fertige Konfigurationen für Inferenz, für Dokumentensuche und für Training bereit, jede davon ebenfalls ein Metapaket, und insgesamt umfasst das Archiv derzeit mehr als vierzig Pakete, von Netzwerk und Storage bis zu Job-Queues und Vektordatenbanken.
Duggans acht Punkte
In vielem waren Duggan und ich uns einig, in manchem nicht, und ich finde, es lohnt sich, seine acht Punkte durchzugehen, denn hinter jeder Meinungsverschiedenheit steht eine Entscheidung, die wir bewusst getroffen haben.
Centralized State Management. Duggan wünschte sich “a robust, centralized state store for all deployed resources, akin to a package database.” Wir kamen zu dem Schluss, dass Kubernetes einen solchen Speicher bereits hat, seinen eigenen API-Server, und dass eine zweite Datenbank daneben unweigerlich von den lebenden Objekten wegdriftet, wie es bei Helm und seinen Release-Secrets heute schon geschieht. Deshalb hält kubepkg seinen Zustand in eigenen Cluster-Ressourcen und leitet alles Übrige aus den lebenden Objekten ab.
Advanced Dependency Resolution. apt, pip und npm haben alle einen Mechanismus, der Bedingungen wie „dieses Paket braucht Version 2.3 oder neuer einer bestimmten Bibliothek“ entgegennimmt und eine Kombination von Versionen ausrechnet, die alle Pakete gleichzeitig zufriedenstellt. Das Problem: Ein Solver liefert bereitwillig eine Kombination, die formal gültig ist, aber nie als Ganzes gelaufen ist, und Distributionen funktionieren nicht dank cleveren Auflösens, sondern weil sie Sätze ausliefern, die zusammen getestet wurden. Deshalb löst kubepkg Abhängigkeiten nach Capabilities auf, also nach APIs, CRDs und benannten Fähigkeiten wie Ingress, hält Versionsbedingungen auf einem Minimum und überlässt die genauen Versionen der Distribution, die sie in ihrem Metapaket festlegt.
Granular Resource Lifecycle Control. Hier sind wir uns völlig einig, mit einer Einschränkung. Eine Reihenfolge bei der Installation hilft nur, wenn jeder Teil eines Pakets selbst festlegt, was gesund für ihn bedeutet; deshalb sind Health Checks Teil des Pakets und nicht etwas, das man später anschraubt.
Secure Packaging Standards. Signaturen ja, ein einziges “centralized trust system” nein. Vertrauen ist in kubepkg pro Repository organisiert, so wie Debian-Archive funktionieren, jedes mit eigenen Schlüsseln; Artefakte werden mit cosign aus dem Sigstore-Projekt signiert, und die Repository-Metadaten folgen The Update Framework (TUF). Obendrein kann ein Cluster verlangen, dass in den Namespaces der Pakete nur Images laufen, die in einem Paket per Digest festgelegt sind.
Native Support for Multi-Cluster Management. Das haben wir bewusst außen vor gelassen. Flotten von Clustern zu verwalten ist bereits die Aufgabe von Argo CD, Flux, OCM und Karmada, und kubepkg versucht, eine Sache in einem Cluster gut zu machen und sich leicht aus diesen Werkzeugen heraus steuern zu lassen.
Rollback Mechanisms. Ein Snapshot von Cluster-Objekten rollt keine Daten zurück: Volumes, Datenbankschemata nach einer Migration, CRDs, nachdem eine ihrer Versionen entfernt wurde. Selbst apt verspricht bei Downgrades nichts. Deshalb wird in kubepkg die Rollback-Sicherheit als Eigenschaft jeder Paketversion deklariert; automatisch zurückgerollt wird nur, was als sicher deklariert ist, und für alles andere wird vor dem Upgrade ein Backup angelegt.
Declarative and Immutable Design. Beim Deklarativen einverstanden, bei Templates weniger: Ein Paket ist nach wie vor ein Helm-Chart, weil Hersteller nun einmal das ausliefern. Aber der gewünschte Zustand lebt in Cluster-Ressourcen, und der Änderungsplan lässt sich in der CI aus denselben Ressourcen berechnen, die in Git liegen, bevor sich im Cluster irgendetwas ändert.
Integration with Kubernetes APIs. Einverstanden, mit einer wichtigen Ergänzung, die in der Liste fehlt. Der schwierigste Teil sind hier die CRDs. Sie gehören dem ganzen Cluster, sie überleben das Release, das sie installiert hat, und das Löschen einer CRD löscht jedes Objekt dieses Typs; deshalb ist die Eigentümerschaft an CRDs in einem kubepkg-Paket ein eigenes Konzept.
Was Kubernetes 2.0 angeht, so wie Duggan es sich vorstellt, haben wir auch einen Teil dieses Weges zurückgelegt, wenn auch nicht immer so, wie er es vorgeschlagen hat. Der Standard-Datenspeicher unserer Distributionen ist leichtgewichtig, wie er es angeregt hat. Statt YAML durch HCL zu ersetzen, haben wir mit typisierten Intents verkleinert, was von Hand geschrieben werden muss. Es gibt einen Paketmanager, allerdings nicht in Kubernetes eingebaut, sondern daneben. Was wir noch nicht haben, ist IPv6 als Standard.
Zurück zu Tim Hockins Antwort
Hockin hatte Zweifel an der Analogie zum Linux-Kernel, und es ist nur fair, sie genauso zu behandeln wie Duggans Punkte, denn in vielerlei Hinsicht hat sich die Arbeit an kuberoot als Prüfstein für jeden einzelnen davon erwiesen.
Kubernetes ist auf Unternehmen ausgerichtet, und Unternehmen brauchen nur eine Handvoll Distributionen. Dagegen lässt sich schwer etwas sagen, wenn man an Allzweck-Distributionen denkt; Unternehmen wählen tatsächlich zwischen zwei oder drei. Aber Unternehmen verbrauchen eine riesige Zahl spezialisierter Linux-Distributionen; sie nennen sie nur nicht so. In der Firmware eines Routers, eines Speichersystems, eines Hypervisors, einer Industriesteuerung, eines Medizingeräts, eines Fernsehers oder eines Autos lebt eine Linux-Distribution, die für genau eine Aufgabe gebaut wurde, und fast keiner ihrer Besitzer weiß, was darin steckt. Diese Klasse hatte ich im Sinn, nicht ein weiteres Ubuntu, und deshalb sind unsere Distributionen ein Router, ein Hypervisor, eine Echtzeitsteuerung und ein Gateway geworden und nicht drei konkurrierende Allzweck-Cluster.
Zu vieles wird mitgeliefert (kube-proxy, DNS, kubeadm), und selbst der Scheduler gehört eher in den User Space. Hier sind Hockin und ich uns vollkommen einig, und kuberoot denkt den Gedanken bis zu Ende. Welche Kubernetes-Komponenten laufen, entscheidet das Profil der Distribution. Router und Sensor-Gateway haben kein kubelet, keinen Scheduler, kein kube-proxy und keine Container-Runtime; der Hypervisor behält das kubelet nur, damit der Cluster seine Nodes sieht und bemerkt, wenn einer ausfällt, und führt keine Pods aus; DNS wird als Paket installiert; und der Lebenszyklus des Clusters liegt vollständig in kinit und der Node-API, kubeadm wird also gar nicht gebraucht. In unserer Lesart besteht der Kernel von Kubernetes demnach aus API-Server, Datenspeicher und Controllern, und alles andere wird zu einer Entscheidung der Distribution.
Kubernetes liefert Binär-Builds aus, während der Linux-Kernel von den Distributionsbauern gebaut wird. Hier sind wir vorerst auf halbem Weg stehen geblieben. Den Linux-Kernel bauen wir selbst, samt Drittanbietermodulen und Signierung, für Kubernetes selbst verwenden wir dagegen die offiziellen Binär-Releases des Projekts, per Version festgelegt, weil uns das Bauen aus den Quellen für unsere Zwecke bisher nichts eingebracht hat. Die Architektur erlaubt es aber, und sollte eine Distribution je ein eigenes kubelet oder einen eigenen API-Server brauchen, kann sie diese genauso bauen, wie sie heute den Kernel baut.
Compile-Zeit-Optionen ergeben für Kubernetes weniger Sinn als für den Kernel, die Entsprechung ist eher „einen einfacheren Scheduler verwenden“. Das hat sich als genau richtig erwiesen. In kuberoot übernimmt das Profil der Distribution die Rolle der Compile-Zeit-Optionen: Es entscheidet, welche Komponenten mit welchen Einstellungen laufen, welcher Datenspeicher verwendet wird und ob es überhaupt Pods geben soll. Compile-Flags brauchten wir wirklich nicht, aber die Möglichkeit, eine Komponente wegzulassen oder durch eine einfachere zu ersetzen, wurde in jeder einzelnen Distribution gebraucht.
Neues AUF Kubernetes bauen statt IN Kubernetes. Und das ist vielleicht die beste Beschreibung dessen, was herausgekommen ist. Keine einzige Fähigkeit von kuberoot hat eine Änderung an Kubernetes erfordert. Die Node-API wird per Aggregation eingebunden; virtuelle Maschinen, Modelle, Sensoren und Routing-Regeln werden durch eigene Ressourcen mit eigenen Controllern beschrieben; Pakete installiert ein Operator; und der Agent-Operator wird durch eine ValidatingAdmissionPolicy eingeschränkt, die Kubernetes von Haus aus mitbringt. All das ist auf Kubernetes gebaut, und nichts davon in Kubernetes hinein.
Acht Distributionen
Nachdem klar ist, woraus sie gebaut werden, können wir die Distributionen selbst durchgehen. Jede bekommt einen eigenen Artikel mit Details und Demonstrationen; hier versuche ich zu zeigen, was jede von ihnen interessant macht und wie sie innen funktioniert.
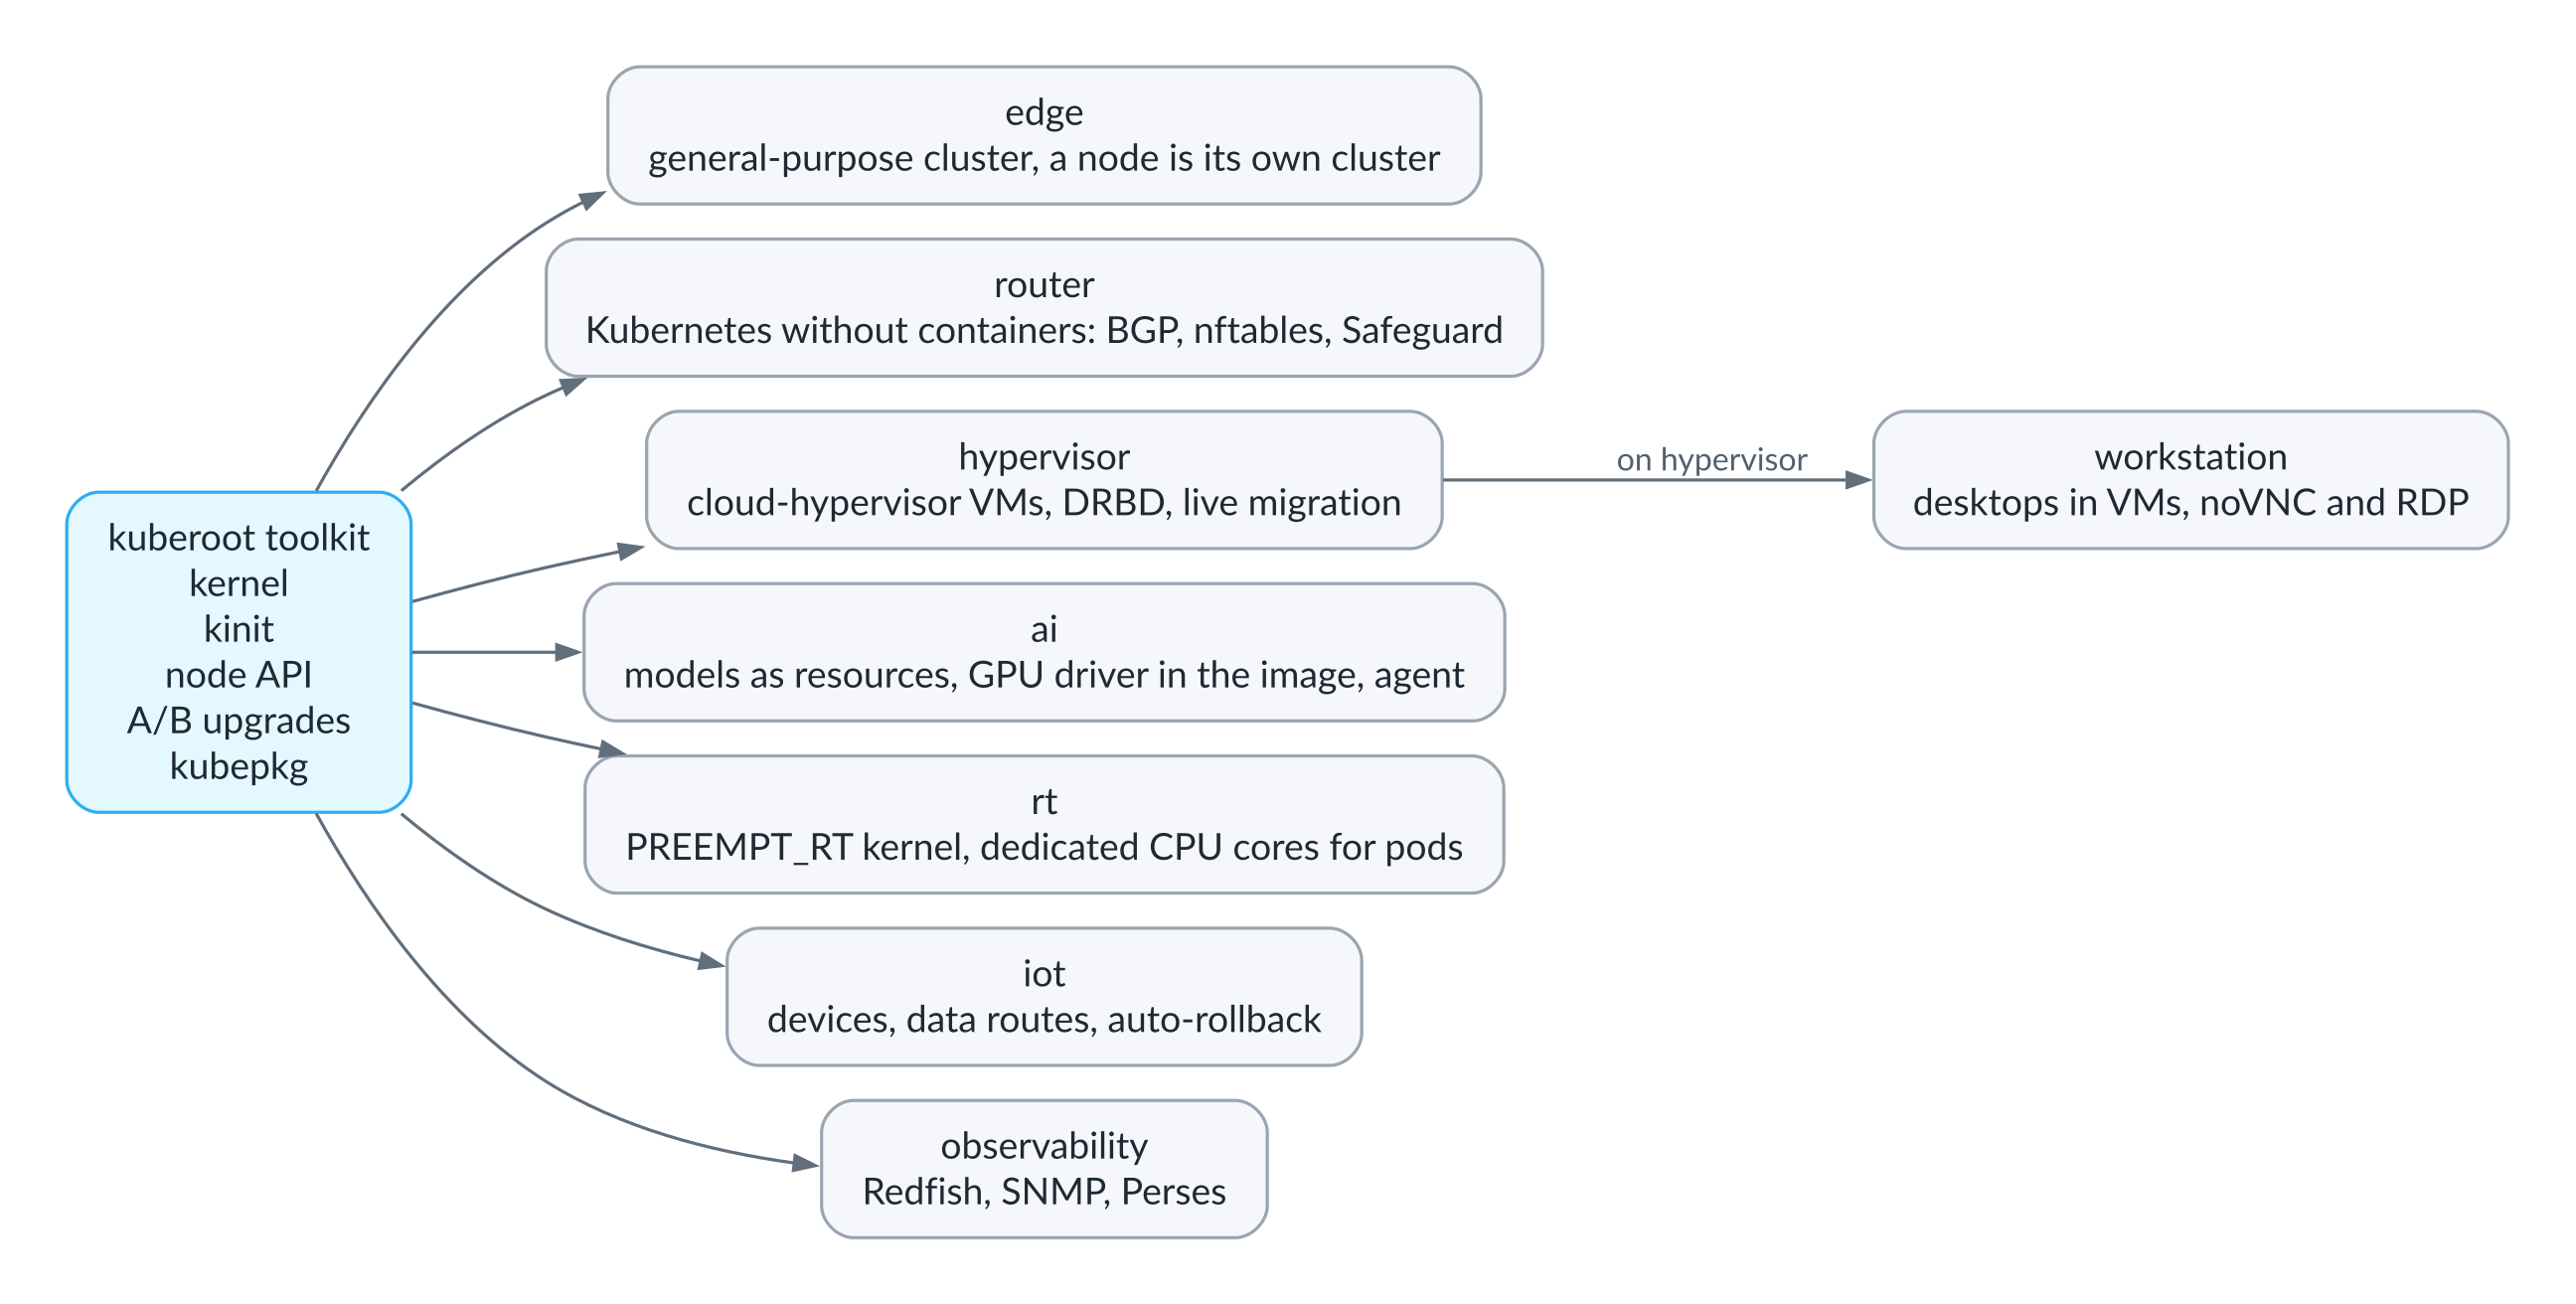
Acht Distributionen auf einem Baukasten
Edge
Hier hat alles angefangen, und hier wurde alles andere getestet. Es ist ein Allzweck-Cluster aus einem oder mehreren Nodes, und schon ein einzelner Node kann für sich allein ein Cluster sein, ein vollständiger mit API-Server, Scheduler und Paketmanager, während weitere Nodes ihm per Join-Ticket beitreten. Ein solcher Node ist überall dort praktisch, wo es keinen Ingenieur gibt, aber ein paar Dienste gebraucht werden: in einem Laden, einem Lager, einer Fabrikhalle, einer Filiale, an einem Mobilfunkmast. Der Node wird von einem USB-Stick installiert, aktualisiert sich selbst mit automatischem Rollback im Fehlerfall, sichert seinen eigenen Zustand und stellt ihn aus diesen Backups wieder her, und alles oberhalb der Basis kommt als Pakete.
Für die Edge-Distribution gibt es ein Metapaket für die komplette Plattform, das einen kleinen Cluster in einen autarken Standort verwandelt, mit Storage auf DRBD über Piraeus, Monitoring und Logs auf VictoriaMetrics und VictoriaLogs, Anwendungs-Backups über Velero, Policies über Kyverno, einem Load Balancer für Services und Ingress. Auf dieser Distribution haben wir die Konformitätstests gefahren und geprüft: Rollback nach einem Upgrade, plötzlichen Stromausfall am Control-Plane-Node, Netzwerkpartitionen zwischen Nodes, den Umzug von Anwendungen in einen anderen Cluster über ein Backup und Lasttests. Hier haben wir die meisten Bugs gefunden, was uns die Suche danach in den anderen Distributionen erspart hat. Einer davon war besonders lehrreich. Nach einem plötzlichen Stromausfall blieb der Datenspeicher des Clusters manchmal gesperrt, und wir mussten ihm beibringen, auf die Sperre zu warten, statt abzustürzen.
Router
Das ist ein Kubernetes ohne einen einzigen Container, und für mich ist es der deutlichste Beweis, dass die Kubernetes-API einfach ein bequemes Bedienfeld für eine Maschine sein kann. Das Profil dieser Distribution enthält kein kubelet, kein containerd, keinen Scheduler und kein kube-proxy: Der API-Server verwahrt schlicht die Konfiguration des Routers, mit RBAC, Audit und Watch. Netzwerkschnittstellen und VLANs, Routen, NAT, Firewall-Zonen und -Regeln, ein DHCP-Server, ein BGP-Speaker und seine Peers werden allesamt durch Ressourcen in der Gruppe router.kuberoot.dev beschrieben und von einem Programm auf dem Node umgesetzt, das direkt mit dem Netzwerkstack des Kernels spricht, eine eigene nftables-Tabelle pflegt, den DHCP-Server und den BGP-Daemon betreibt und seine Routen mit einer eigenen Routing-Protokoll-ID markiert, damit es nie Routen anfasst, die etwas anderes installiert hat.
Das Beste an dieser Distribution ist, dass sie Sie vor sich selbst schützt. Mit einer aktivierten Safeguard-Ressource geht jede Änderung zuerst auf Probe, im Geist von commit confirmed bei Junos. Der Node wendet sie an und wartet auf eine Bestätigung, und wenn Sie sich versehentlich den eigenen Zugang abgeschnitten und die Änderung nicht rechtzeitig bestätigt haben, rollt er von selbst auf die letzte bestätigte Konfiguration zurück, und dieser Rollback übersteht auch einen Neustart des Nodes. Und damit Sie sich nicht auf besonders erfinderische Weise aussperren, werden Port-Forwarding-Regeln abgelehnt, wenn sie die Adressen und Ports abfangen würden, über die der Node verwaltet wird. Wer je mitten in der Nacht in den Serverraum fahren musste, weil eine einzige falsche Zeile in den Firewall-Regeln stand, wird das besser zu schätzen wissen, als ich es beschreiben kann.
Hypervisor
Der Hypervisor führt virtuelle Maschinen direkt auf KVM mit Cloud Hypervisor aus, ohne Pods, ohne libvirt und ohne zwischengeschaltete Verwaltungsschicht. Eine Maschine wird durch eine VirtualMachine-Ressource beschrieben, die CPUs, Arbeitsspeicher, Festplattengröße, das Image, aus dem die Festplatte geschrieben wird, und die Zahl der Festplattenreplikate festlegt, und ein Controller auf dem Control-Plane-Node entscheidet, wo die Maschine laufen und wo die Kopien ihrer Festplatte liegen sollen.
Die Festplatten der Maschinen sind DRBD-9-Volumes, die auf Dateien in den Nodes liegen und synchron repliziert werden, sodass jeder Schreibvorgang die anderen Kopien erreicht, bevor er als erledigt gilt. Das DRBD-Quorum ist aktiviert, ein Node, der von der Mehrheit der Kopien abgeschnitten ist, schreibt also überhaupt nicht mehr auf die Festplatte, und genau das bewahrt vor Split-Brain: Eine Maschine, die nach einem Ausfall auf einem anderen Node gestartet wird, teilt ihre Festplatte nie mit einer veralteten Kopie. Maschinen auf verschiedenen Nodes leben in einem Netz: Eine Bridge auf jedem Node ist über VXLAN mit den anderen verbunden, und ein Gateway auf dem Control-Plane-Node vergibt Adressen und gibt den Maschinen eine Route nach draußen.
Ziehen Sie einem Node den Stecker, erklärt ihn der Controller nach einer halben Minute für tot und startet die Maschine auf einem Node mit aktueller Kopie der Festplatte; nach weniger als zwei Minuten läuft die Maschine dort mit derselben Festplatte und derselben Adresse. Kommt der alte Node zurück, holt seine Kopie der Festplatte zu den anderen auf, und der Node selbst startet die Maschine nicht ein zweites Mal. Wir haben das sowohl durch Abschalten des Stroms als auch durch Kappen des Netzwerks getestet, und es gab kein einziges Split-Brain.
Für Wartungsarbeiten lässt sich eine Maschine per Live-Migration auf einen anderen Node verschieben, ohne das Gastsystem neu zu starten. Für die Dauer des Umzugs läuft das Volume im Dual-Primary-Modus von DRBD, auf zwei Nodes gleichzeitig beschreibbar; auf dem Ziel-Node wird eine Cloud-Hypervisor-Instanz gestartet, die auf die Maschine wartet; der Quell-Node streamt den Arbeitsspeicher der laufenden Maschine dorthin; und nach dem Umzug ist die Festplatte wieder nur auf einem Node beschreibbar. Ein Umzug beginnt nur, wenn alle Kopien der Festplatte verbunden sind, und er wird zurückgerollt, wenn er nicht rechtzeitig fertig wird oder unterwegs ein Node verschwindet.
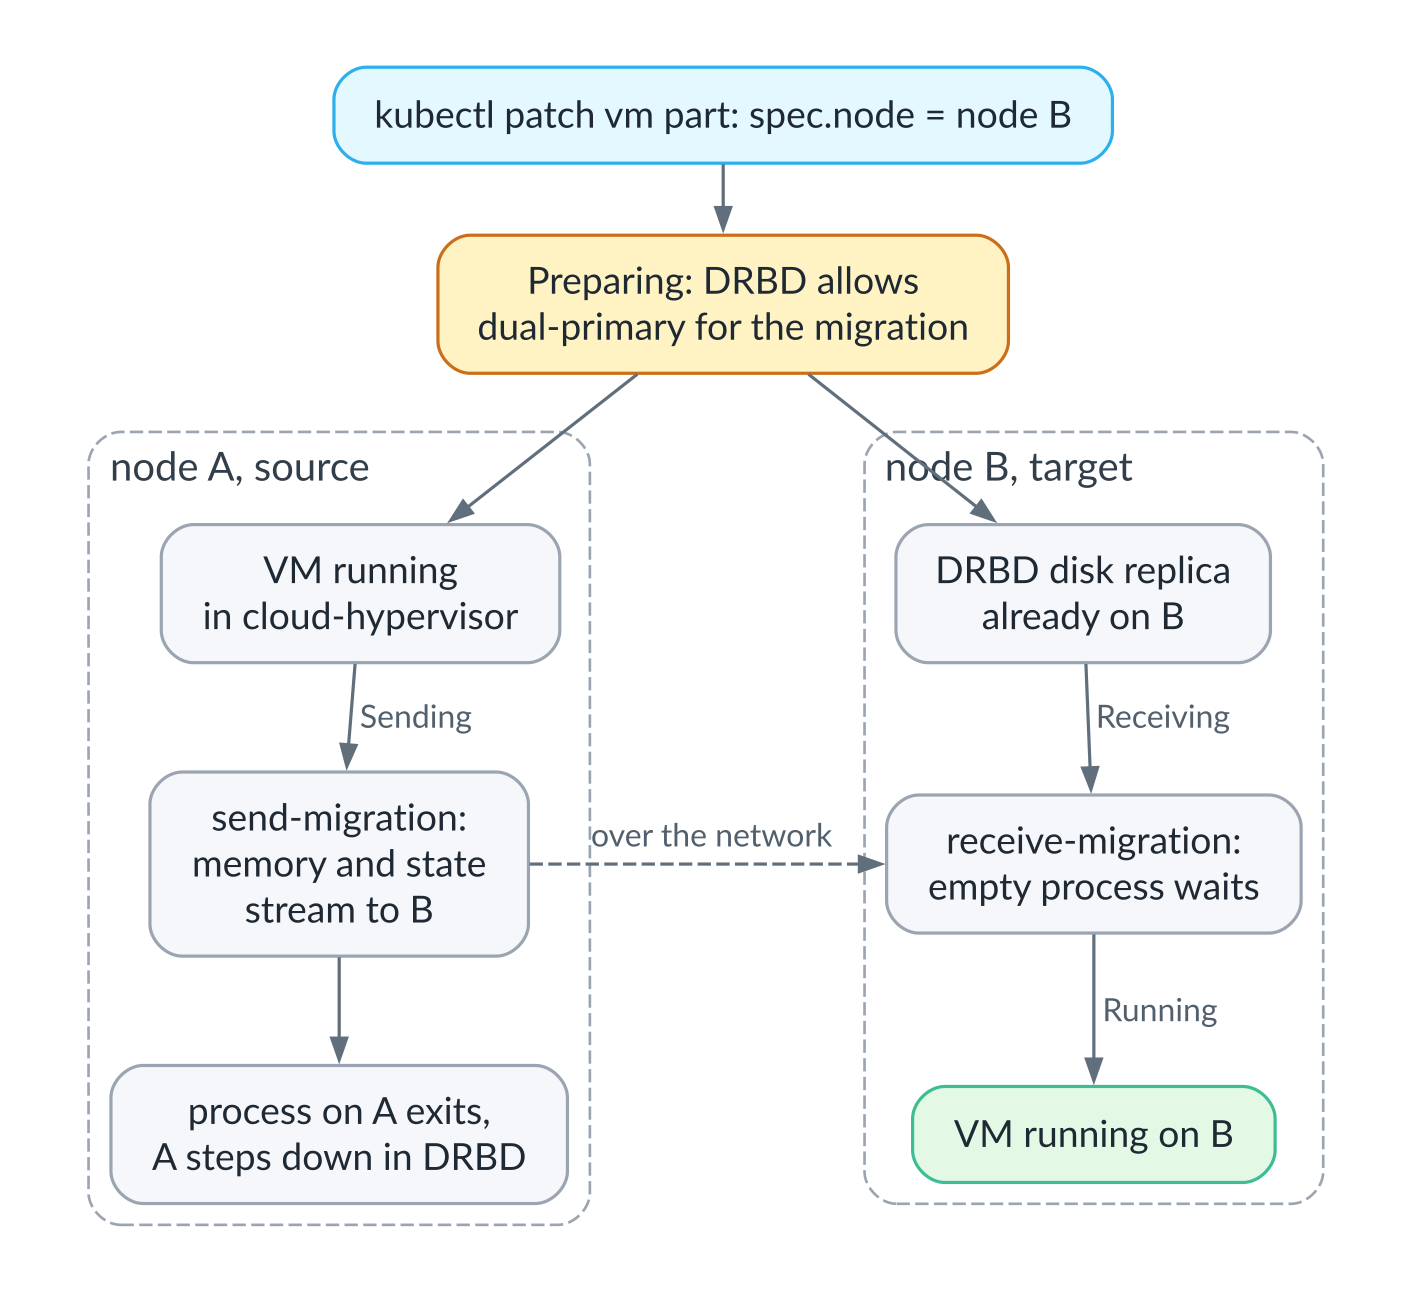
Live-Migration einer virtuellen Maschine zwischen Nodes
$ kubectl patch vm part --type merge -p '{"spec":{"node":"kuberoot-af49e9"}}'
11:22:46 Migrating  kuberoot-221a17  Preparing  moving alive from kuberoot-221a17 to kuberoot-af49e9
11:22:53 Migrating  kuberoot-221a17  Receiving
11:23:00 Migrating  kuberoot-221a17  Sending
11:23:06 Running    kuberoot-af49e9             moved alive from kuberoot-221a17
In unserem Labor dauerte ein solcher Umzug etwa fünfundzwanzig Sekunden. Das ist Live-Migration, das Feature, für das viele Teams einst vSphere gekauft haben, gebaut als gewöhnliche Kubernetes-Ressource, mit demselben RBAC und derselben Automatisierung wie alles andere.
KI
Die KI-Distribution ist die Edge-Distribution plus zwei eigene Mechanismen, und jeder davon verdient einen genaueren Blick.
Der erste sind Sprachmodelle als Cluster-Ressource. Sie beschreiben ein Modell mit einer Model-Ressource: woher die Gewichte kommen und wie ihr Hash lautet, wie viele Replikate Sie wollen, die Kontextgröße und wie viele Anfragen gleichzeitig bedient werden sollen, und den Rest erledigt der Cluster. Der Controller wählt die Nodes aus und versucht dabei, Modelle nicht auf den Control-Plane-Node zu legen, solange Worker verfügbar sind; die Nodes laden die Gewichte herunter, prüfen sie gegen den Hash, starten den Model-Server als gewöhnlichen Node-Prozess und stellen das Modell über einen gemeinsamen OpenAI-kompatiblen Endpunkt bereit, der Anfragen anhand des Modellnamens weiterleitet, reihum auf die bereiten Replikate dieses Modells verteilt und Streaming-Antworten direkt durchreicht.
Am interessantesten ist, wie eine neue Version ausgerollt wird, nämlich als Canary-Release. Die neue Version wird zuerst auf einem Node installiert, und sobald sie dort bereit ist, bekommt sie eine Probeanfrage. Nur wenn sie antwortet, wechseln die übrigen Nodes zu ihr, einer nach dem anderen, jeder erst, nachdem der vorherige begonnen hat, die neue Version auszuliefern, und vor dem Wechsel wird jeder Node geleert: Er wird aus dem Routing genommen und beendet die Anfragen, die er gerade bedient. Startet die neue Version nicht, wird sie nicht innerhalb von fünfzehn Minuten bereit oder beantwortet sie die Probeanfrage nicht, kehrt der Cluster von selbst zur vorherigen Version zurück und merkt sich, diese Version nicht noch einmal zu versuchen, bis sie sich ändert. In unseren Tests wurde eine absichtlich kaputte Version in elf Sekunden zurückgerollt, ohne dass die beiden anderen Replikate des Modells sie überhaupt berührt hätten, und ein Versionswechsel unter der Last von vier parallelen Clients mit langen Streaming-Antworten ging ohne eine einzige abgebrochene Antwort durch.
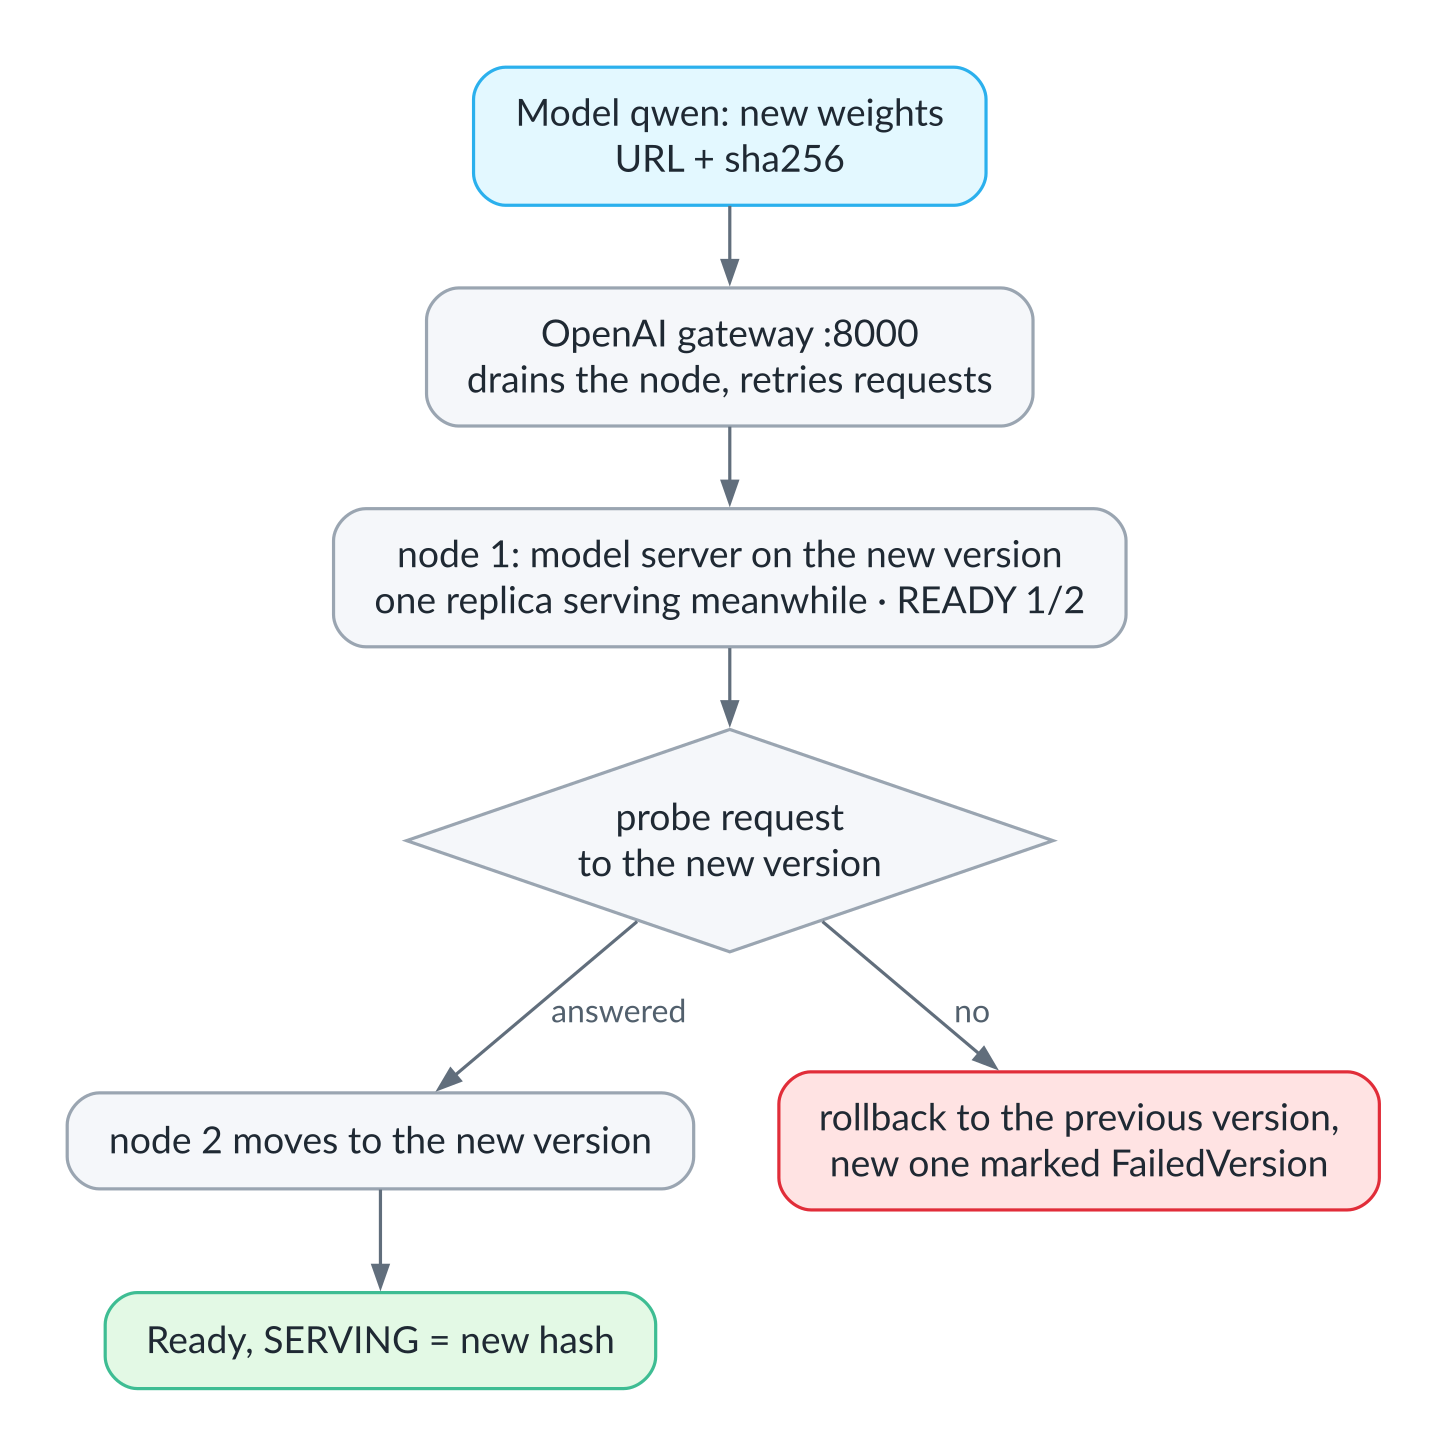
Canary-Rollout einer neuen Modellversion
$ kubectl patch model qwen --type merge -p '{"spec":{"source":{"url":".../qwen2.5-0.5b-q5_k_m.gguf","sha256":"041474…"}}}'
$ kubectl get model qwen -w
NAME   READY   PHASE        SERVING   MESSAGE
qwen   2/2     RollingOut   74a4da…   trying the new version on kuberoot-05b48c
qwen   1/2     RollingOut   74a4da…   trying the new version on kuberoot-05b48c
qwen   2/2     RollingOut   74a4da…   moving to the new version
qwen   2/2     Ready        041474…
Zwischen der ersten und der letzten Zeile vergingen etwa dreißig Sekunden. Die zweite Zeile zeigt den ersten Node außer Dienst, während er die Version wechselt, und das Modell antwortet aus einem einzigen Replikat; in der dritten hat die neue Version die Probeanfrage bereits beantwortet, und der zweite Node wechselt zu ihr.
Model-Server leben auf dem Node in einer eigenen cgroup mit Speicherlimit, und auch das ist eine Lektion, die wir auf die harte Tour gelernt haben. Ein Modell, dem versehentlich ein Kontext von zwei Millionen Tokens gegeben worden war, begann, sich nach und nach Speicher zu nehmen, und statt dass der Server einfach beendet wurde, versank der Node, ausgerechnet der Control-Plane-Node, in endlosem Thrashing. Heute können Model-Server nicht an den für das System reservierten Speicher, und ein frisch gestarteter Server bekommt einen hohen OOM-Score, ist also der erste Kandidat des Kernels, wenn der Speicher ausgeht, damit benachbarte Modelle, die bereits laufen, nicht darunter leiden.
In dieser Distribution ist der NVIDIA-Treiber Teil des Betriebssystems. Die offenen Kernelmodule werden für unseren Kernel gebaut und mit dessen Schlüssel signiert, und die Treiberbibliotheken, das Werkzeug nvidia-smi und die Firmware liegen daneben. Da es auf dem Node kein udev gibt, legt der Node die Gerätedateien selbst an und beschreibt die GPUs der Container-Runtime über CDI. Pods bekommen GPUs auf dem üblichen Weg, über ein Device-Plugin, und der Loader-Cache im Container wird für die injizierten Bibliotheken aktualisiert. Nodes mit GPUs tragen ein Label, über das GPU-Pakete sie finden, und die Modelle des Clusters können auch direkt auf GPUs laufen: Der Node gibt jedem Model-Server Karten, die kein anderer Model-Server hält, und protokolliert die Zuordnung, wobei das Device-Plugin von diesen Karten noch nichts weiß; die GPUs eines Nodes sollten deshalb vorerst entweder an Pods oder an Modelle gehen, nicht an beide. All das wurde bisher ohne physische GPUs erprobt, wie der Abschnitt über Risiken erklärt.
Das Programm, das ein Modell auf einer GPU ausliefert, mit eingebauten CUDA-Bibliotheken für jede Kartengeneration, wiegt etwa ein Gigabyte und passte schlicht nicht in den Ein-Gigabyte-Systemslot. Das hat uns zu einem Design geführt, das ich für besser halte: Die Inferenz-Engine ist jetzt Teil der Modellversion, gleichberechtigt mit den Gewichten. Sie wird von den Nodes heruntergeladen, die sie ausführen, gegen ihren Hash geprüft, und ein Wechsel der Engine wird genauso vorsichtig ausgerollt wie neue Gewichte, über einen Probe-Node und mit Rollback. Das System-Image bleibt klein, und die Engine lässt sich aktualisieren, ohne das OS zu aktualisieren.
Der Rest des Ökosystems wird als Pakete installiert: die Job-Queue Kueue und der Batch-Scheduler Volcano, die Inferenz-Engines vLLM und Ollama, das Gateway LiteLLM und die Oberfläche Open WebUI, Training über KubeRay und Kubeflow Trainer, JupyterHub und MLflow, die Vektordatenbanken Qdrant und Milvus, PostgreSQL mit pgvector, Object Storage für Datensätze und GPU-Pakete, darunter die gemeinsame Nutzung einer Karte durch mehrere Pods mit HAMi. Die meisten davon haben wir live auf unserem Testcluster installiert und getestet.
Der zweite Mechanismus ist der Agent-Operator, über den ich ganz sicher noch gesondert schreiben werde, weil wir hier, wie ich finde, zur interessantesten Architektur im ganzen Projekt gekommen sind. Der Agent ist ein Sprachmodell, das den Cluster beobachtet, Probleme findet, etwa Nodes, die nicht bereit sind, Dienste, die ständig neu starten, oder abgestürzte Model-Server, ihre Logs liest und vorschlägt, was zu tun ist. Selbst tun kann er aber nichts. Er kann lediglich eine Remedy-Ressource anlegen, einen Vorschlag, der auf fünf mögliche Aktionen beschränkt ist: einen Node-Dienst neu starten, einen Model-Server neu starten, ein Modell auf die vorherige Version zurückrollen, einen Node neu starten oder die Frage an einen Menschen übergeben. Und er wählt nur die Aktion, und nur aus denen, die für dieses Problem erlaubt sind, weil seine Ausgabe durch ein JSON-Schema eingeschränkt ist. Worauf die Aktion angewendet wird, ergibt sich aus dem Problem selbst, nicht aus der Antwort des Modells.
Ausgeführt wird ein Vorschlag von gewöhnlichem Code, und erst nachdem ein Mensch ihn genehmigt hat oder eine Policy ihn ausdrücklich erlaubt, und nicht öfter als eine festgelegte Zahl von Malen pro Stunde. Selbst eine genehmigte Aktion wird verweigert, wenn sie an sich gefährlich ist, etwa der Neustart eines Control-Plane-Nodes oder der Neustart eines Nodes, während bereits ein anderer ausgefallen ist. Der Agent hat eine eigene Identität mit der Berechtigung, nur zu lesen und Vorschläge anzulegen, und die Regel, dass er seine eigenen Vorschläge weder genehmigen noch ändern darf, setzt nicht der Agent durch, sondern der Kubernetes-API-Server selbst, über eine ValidatingAdmissionPolicy.
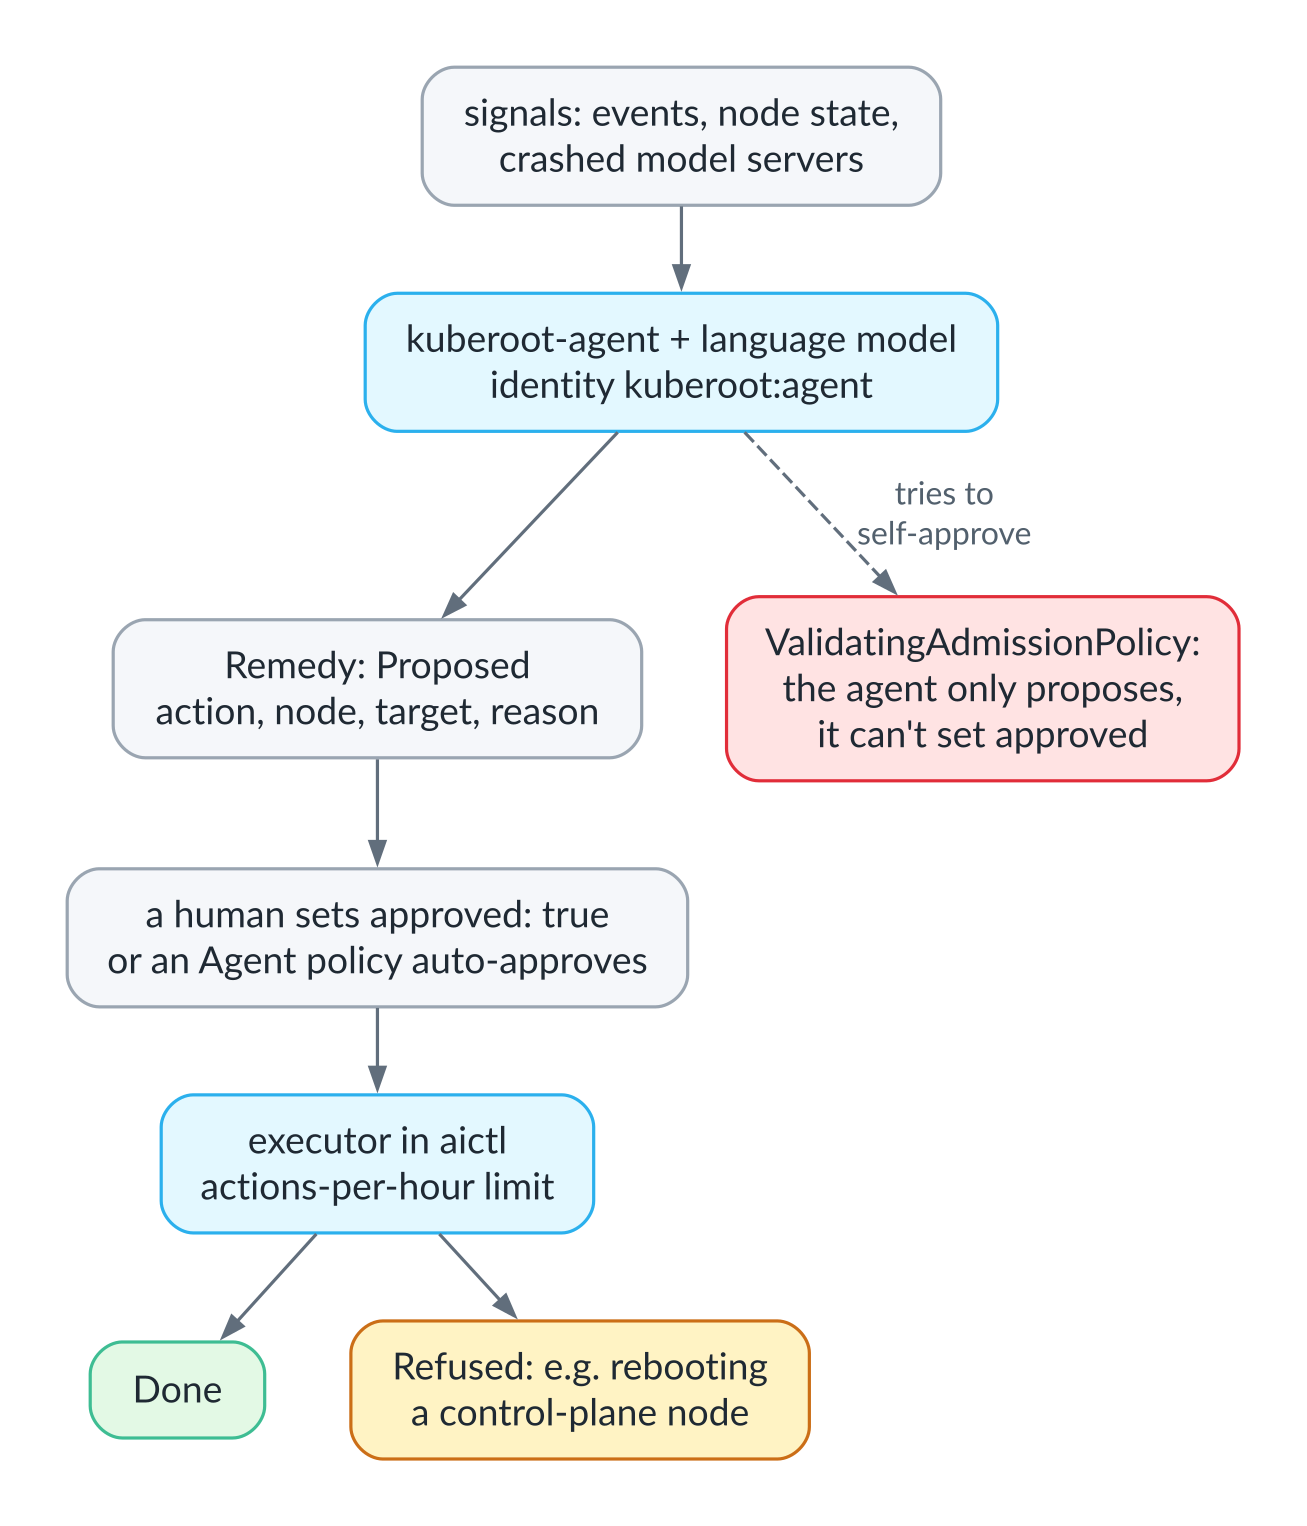
Der Agent schlägt nur vor; ein Mensch oder eine vorab festgelegte Policy entscheidet
$ kubectl get remedies
NAME                       ACTION               NODE              TARGET   PHASE      REASON
restartmodelserver-xdv9t   RestartModelServer   kuberoot-05b48c   huge     Proposed   The server of model huge on node kuberoot-05b48c failed, and the logs indicate a possible training context overflow...
reboot-cp                  RebootNode           kuberoot-71a85e            Refused    node kuberoot-71a85e runs the control plane
Diese Ausgabe zeigt Stärke und Schwäche des Ansatzes zugleich. Ein kleines Modell mit einer halben Milliarde Parametern hat im Log vom Kontextüberlauf gelesen und trotzdem einen Neustart vorgeschlagen, obwohl der richtige Zug gewesen wäre, die Frage an einen Menschen zu übergeben, und genau deshalb läuft standardmäßig nichts ohne Genehmigung. Mir schien es wichtig, diese Architektur jetzt zu etablieren, bevor Modelle so überzeugend werden, dass wir in Versuchung geraten, sie an einer längeren Leine laufen zu lassen, als sie verdienen.
RT
Die Echtzeit-Distribution ist für Industriesteuerungen und andere Aufgaben gebaut, bei denen es nicht nur darauf ankommt, zu rechnen, sondern rechtzeitig zu rechnen. Der Kernel wird hier mit PREEMPT_RT und einem 1.000-Hz-Timer gebaut; jeder CPU-Kern ab dem dritten läuft tickless, RCU-Callbacks und Verwaltungsaufgaben des Kernels sind von ihm wegverlagert, und Interrupts sind an die ersten beiden gebunden. Das kubelet mit seinen statischen Policies für CPU- und Memory Manager gibt die isolierten Kerne exklusiv an Pods, zusammen mit Speicher aus demselben NUMA-Knoten, sodass ein Pod mit einer Echtzeitaufgabe seine Kerne für sich allein hat und mit Echtzeitpriorität laufen kann.
Die Latenz, die ein Node tatsächlich liefert, wird ebenfalls über die Node-API gemessen. Eine LatencyTest-Ressource führt eine Messung nach Art von cyclictest mit Echtzeitpriorität auf den isolierten Kernen durch und liefert für jeden Kern minimale, mittlere und maximale Latenz sowie Perzentile, sodass sich ein Node vor der Inbetriebnahme mit einem gewöhnlichen kubectl-Befehl prüfen lässt.
$ kubectl logs -n rt-demo rt-probe2
Cpus_allowed_list:	2-3
policy	: 1
prio	: 19
Dieser Pod hat die Kerne 2 und 3 für sich allein bekommen und läuft mit der Scheduling-Policy SCHED_FIFO.
IoT
Das Gateway für Industriegeräte kommt ebenfalls ohne Container aus. Geräte, etwa die Steuerung einer Presse, die Modbus TCP spricht, werden durch Device-Ressourcen mit einer Liste von Datenpunkten beschrieben, also Registern mit ihren Typen, ihrer Skalierung und ihrem Abfrageintervall, und Route-Ressourcen beschreiben, unter welcher Bedingung die Daten wohin gehen. Bedingungen werden in CEL geschrieben, derselben Sprache, die Kubernetes für Validierungsregeln verwendet, und sie sind flankengesteuert: Ein Alarm geht einmal hinaus, in dem Moment, in dem die Bedingung wahr wird, nicht bei jeder Abfrage. Das Programm auf dem Node hält eine Verbindung zu jedem Gerät und zu jedem MQTT-Broker und kommt mit fünfunddreißig Megabyte Arbeitsspeicher aus.
Auch hier gibt es einen Schutz gegen schlechte Konfiguration, und er ist sogar noch klüger als der des Routers. Eine Änderung rollt sich selbst zurück, wenn danach etwas nicht mehr funktioniert, das vorher funktioniert hat, etwa wenn ein Gerät nicht mehr antwortet oder ein Broker keine Nachrichten mehr annimmt. Und wenn die Probezeit gut verläuft, bestätigt sich die Änderung selbst, ohne dass ein Mensch eingreift.
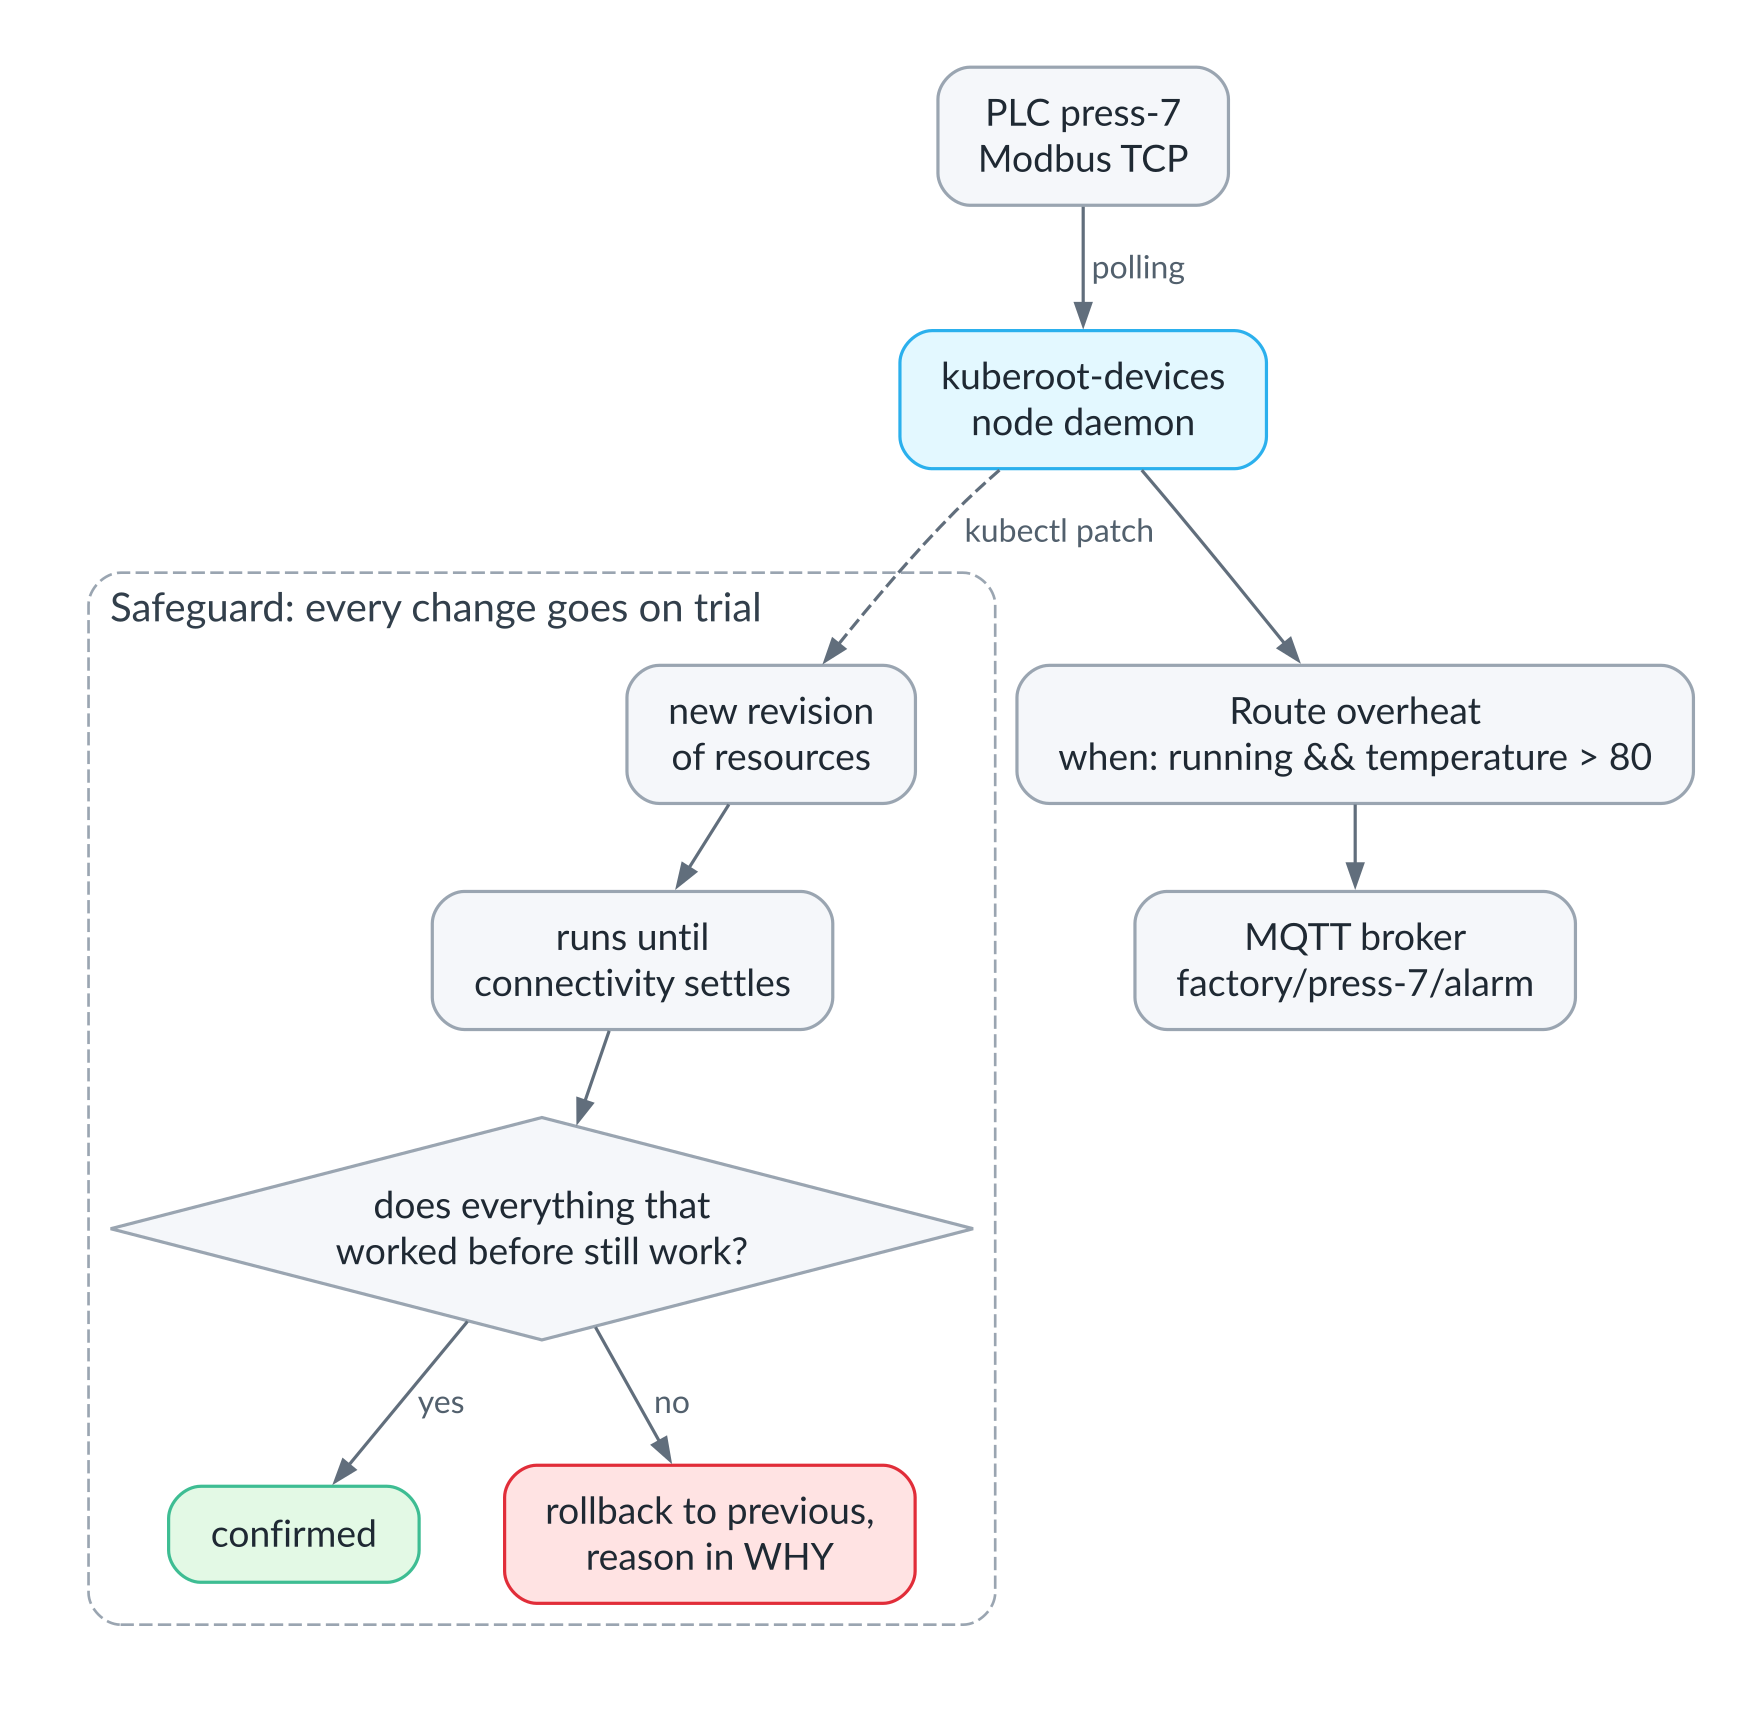
Ein Gerät, eine Datenroute und ein Safeguard, der Änderungen automatisch zurückrollt, die Funktionierendes kaputt gemacht haben
$ kubectl get devices,routes,safeguards
NAME      PROTOCOL     ADDRESS              CONNECTED   VALUES
press-7   modbus-tcp   10.244.156.46:5020   true        temperature=91.2C cycles=42 running=true

NAME       DEVICE    WHEN                          SENT
overheat   press-7   running && temperature > 80   2

NAME      RUNNING        ROLLEDBACK     WHY
default   17b81762470b   80bcbf1eab69   the change broke what worked before it: route overheat stopped working

$ mosquitto_sub -t 'factory/#'
factory/press-7/alarm {"device":"press-7","values":{"temperature":91.2},"when":"running && temperature > 80"}
Die letzte Safeguard-Zeile zeigt, dass eine der jüngsten Änderungen, die Alarme an einen nicht existierenden Broker schickte, automatisch zurückgerollt wurde, und die Spalte WHY sagt, warum.
Ein Gateway-Node passt in eine virtuelle Maschine mit 1,25 Gigabyte Arbeitsspeicher, und kurioserweise geht der größte Teil davon nicht an unseren Code, sondern an den Kubernetes-API-Server selbst. Der nächste Schritt ist hier ein Node ohne eigenen API-Server, der aus einem zentralen Cluster verwaltet wird, für wirklich winzige Geräte, dazu die Protokolle OPC UA und Modbus RTU.
Observability
Die siebte Distribution ist als externer Monitoring-Cluster gedacht, der die Hard- und Software um sich herum beobachtet und so gebaut ist, dass er überlebt, was immer er beobachtet. Wenn ein Rechenzentrum ausfällt, fällt ein Monitoring, das im selben Rechenzentrum und auf derselben Plattform lebt, mit ihm aus, und zwar genau in dem Moment, in dem man es am dringendsten braucht. Deshalb wird der Monitoring-Cluster auf einem, zwei oder drei kleinen Servern mit eigenem Betriebssystem, eigenen Upgrades und repliziertem Storage installiert und hängt von keinem der Systeme ab, die er beobachtet.
Server und ihre BMCs, Switches, Stromverteiler und USVs werden durch dieselben Device-Ressourcen beschrieben wie die Industriesensoren, nur mit anderen Protokollen. Das Programm auf dem Node fragt BMCs über Redfish ab, durchläuft Systeme, Chassis und Manager und sammelt deren Zustand, Temperaturen, Lüfterdrehzahlen, Leistungsaufnahme und Logeinträge; es fragt Netzwerkhardware über SNMP ab, einschließlich SNMPv3; und es prüft die Erreichbarkeit von Diensten von außen mit HTTP-, TCP- und ICMP-Proben, wobei ein unerreichbarer Dienst als Messwert zählt und nicht als Fehler. Alles Gesammelte stellt das Programm als Metriken bereit und meldet sich selbst zum Scraping an, ein Sammelsurium einzelner Exporter ist also nicht nötig, und eine Änderung, die die Abfrage von Zielen kaputt macht, die vorher funktionierten, wird automatisch zurückgerollt, genau wie im Gateway. In unserem Labor wurde eine falsche BMC-Adresse in anderthalb Minuten zurückgerollt, und das Programm selbst belegte etwa vierzig Megabyte.
Die Daten landen in VictoriaMetrics und VictoriaLogs. Dashboards werden in Perses gebaut, das aus beiden liest, und als Kubernetes-Ressourcen beschrieben, sodass man sie in Git wie Code reviewen kann. Es gibt auch einen Totmannschalter, die Heartbeat-Ressource, die in einem festgelegten Intervall eine externe Adresse aufruft, aber nur, solange das Monitoring selbst frische Daten sieht. Ein Cluster, der keine Metriken mehr sammelt, verstummt genauso wie einer, der abgestürzt ist, und der externe Empfänger erfährt es sofort. Der übelste Ausfall ist schließlich der, über den das Monitoring schweigt, weil es zuerst gestorben ist.
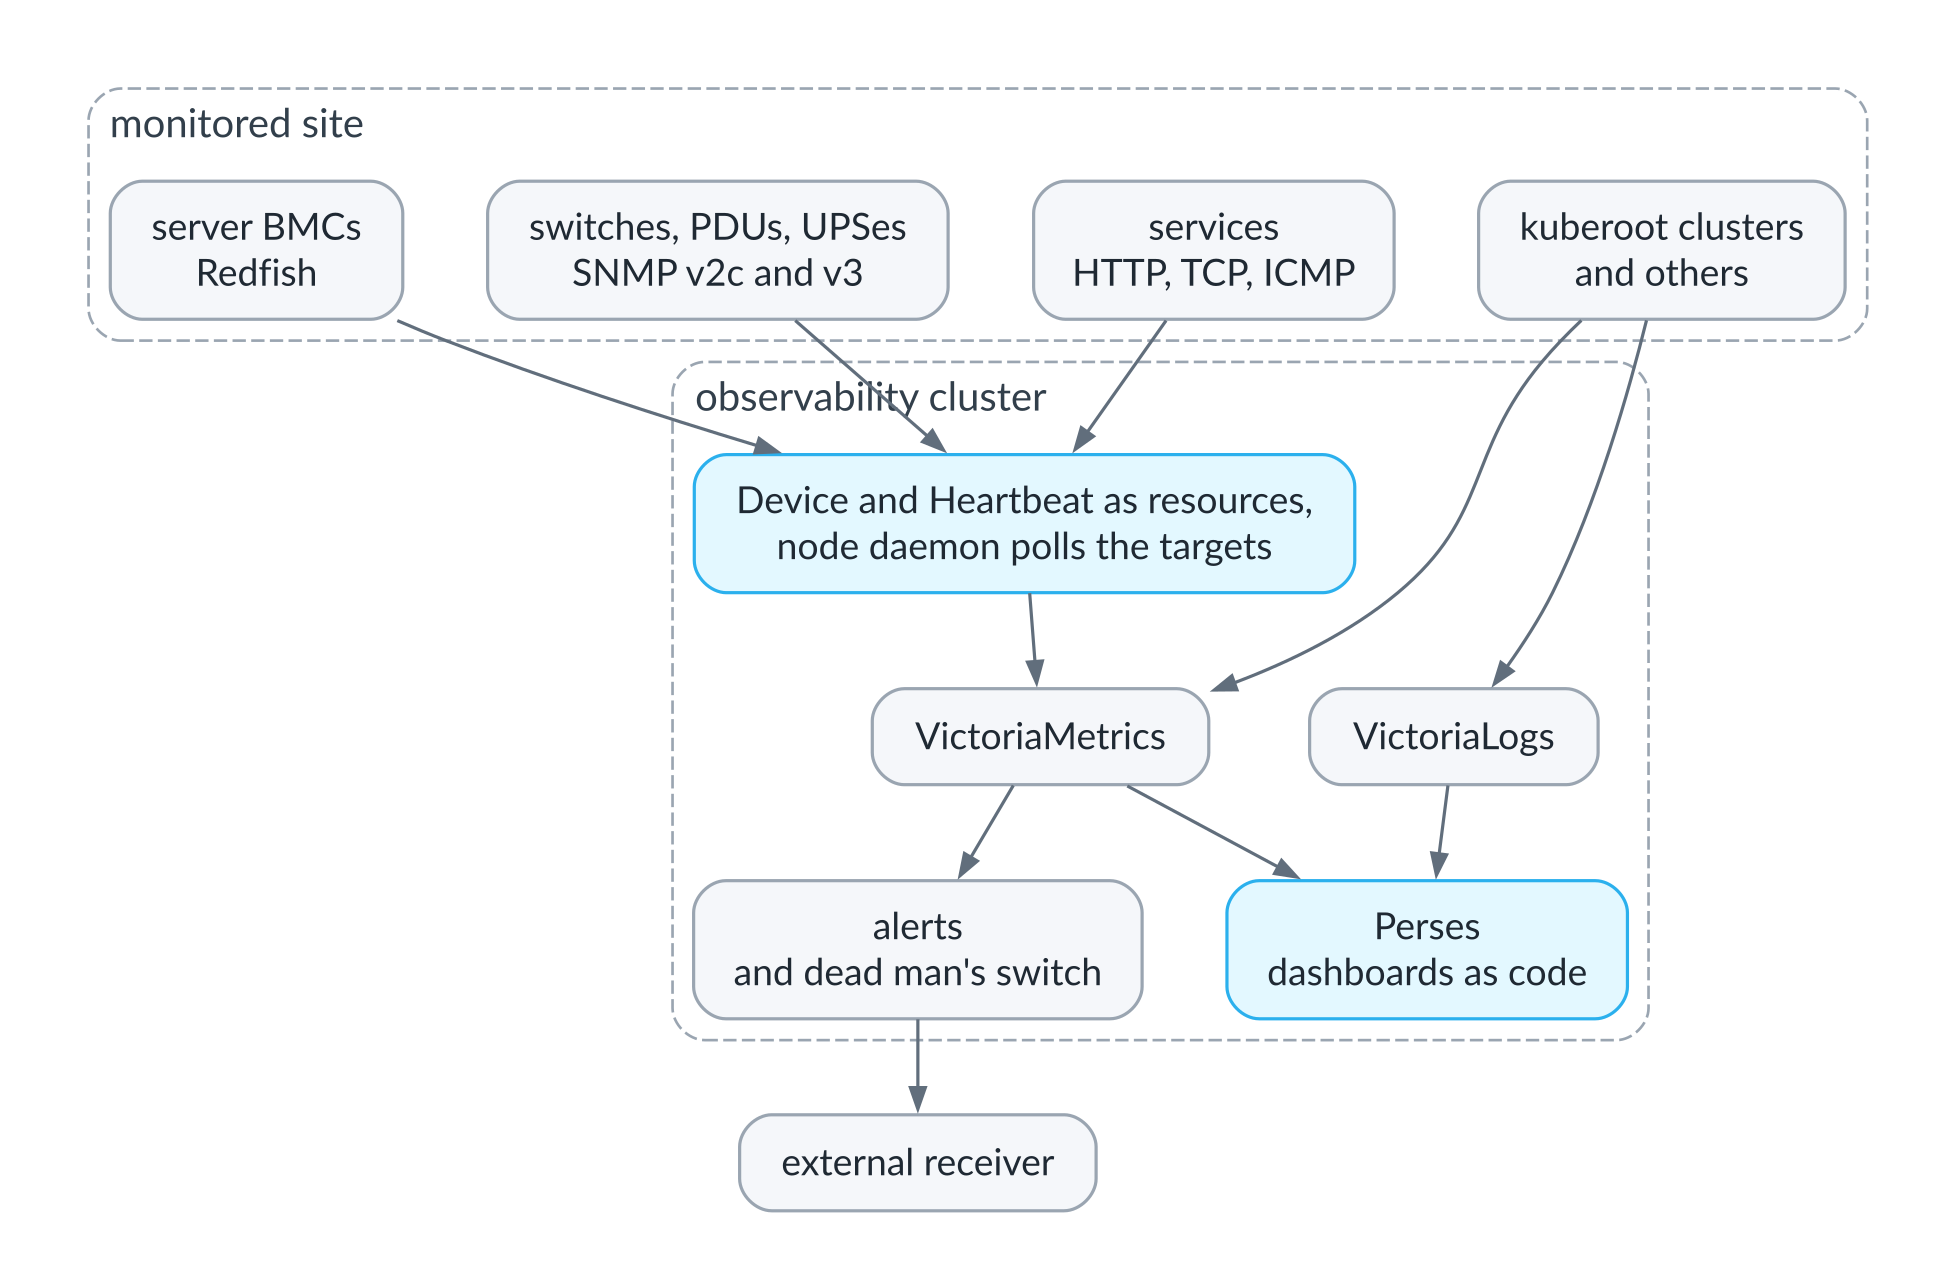
Der externe Monitoring-Cluster: was er beobachtet und wohin er die Daten schickt
Workstation
Die achte Distribution beantwortet die Frage, ob Ihr Desktop im Cluster leben kann. Der Desktop ist hier eine virtuelle Maschine des Hypervisors, beschrieben durch eine Workspace-Ressource, mit replizierter Festplatte, und er läuft weiter, wenn sein Besitzer den Laptop zuklappt, und öffnet sich in jedem Browser oder RDP-Client. Cloud Hypervisor hat keine grafische Konsole, deshalb bringt das Gastsystem den Desktop selbst hoch, eingerichtet beim ersten Boot über cloud-init, dessen Daten der Hypervisor jeder Maschine über das Netzwerk ausliefert, nachdem er ihre Quelladresse geprüft hat. Das Gateway, über das der Browser den Desktop erreicht, läuft als Prozess auf dem Control-Plane-Node, ohne Pods, wie der Rest des Hypervisors, und lässt nur mit dem Token des Workspace herein.
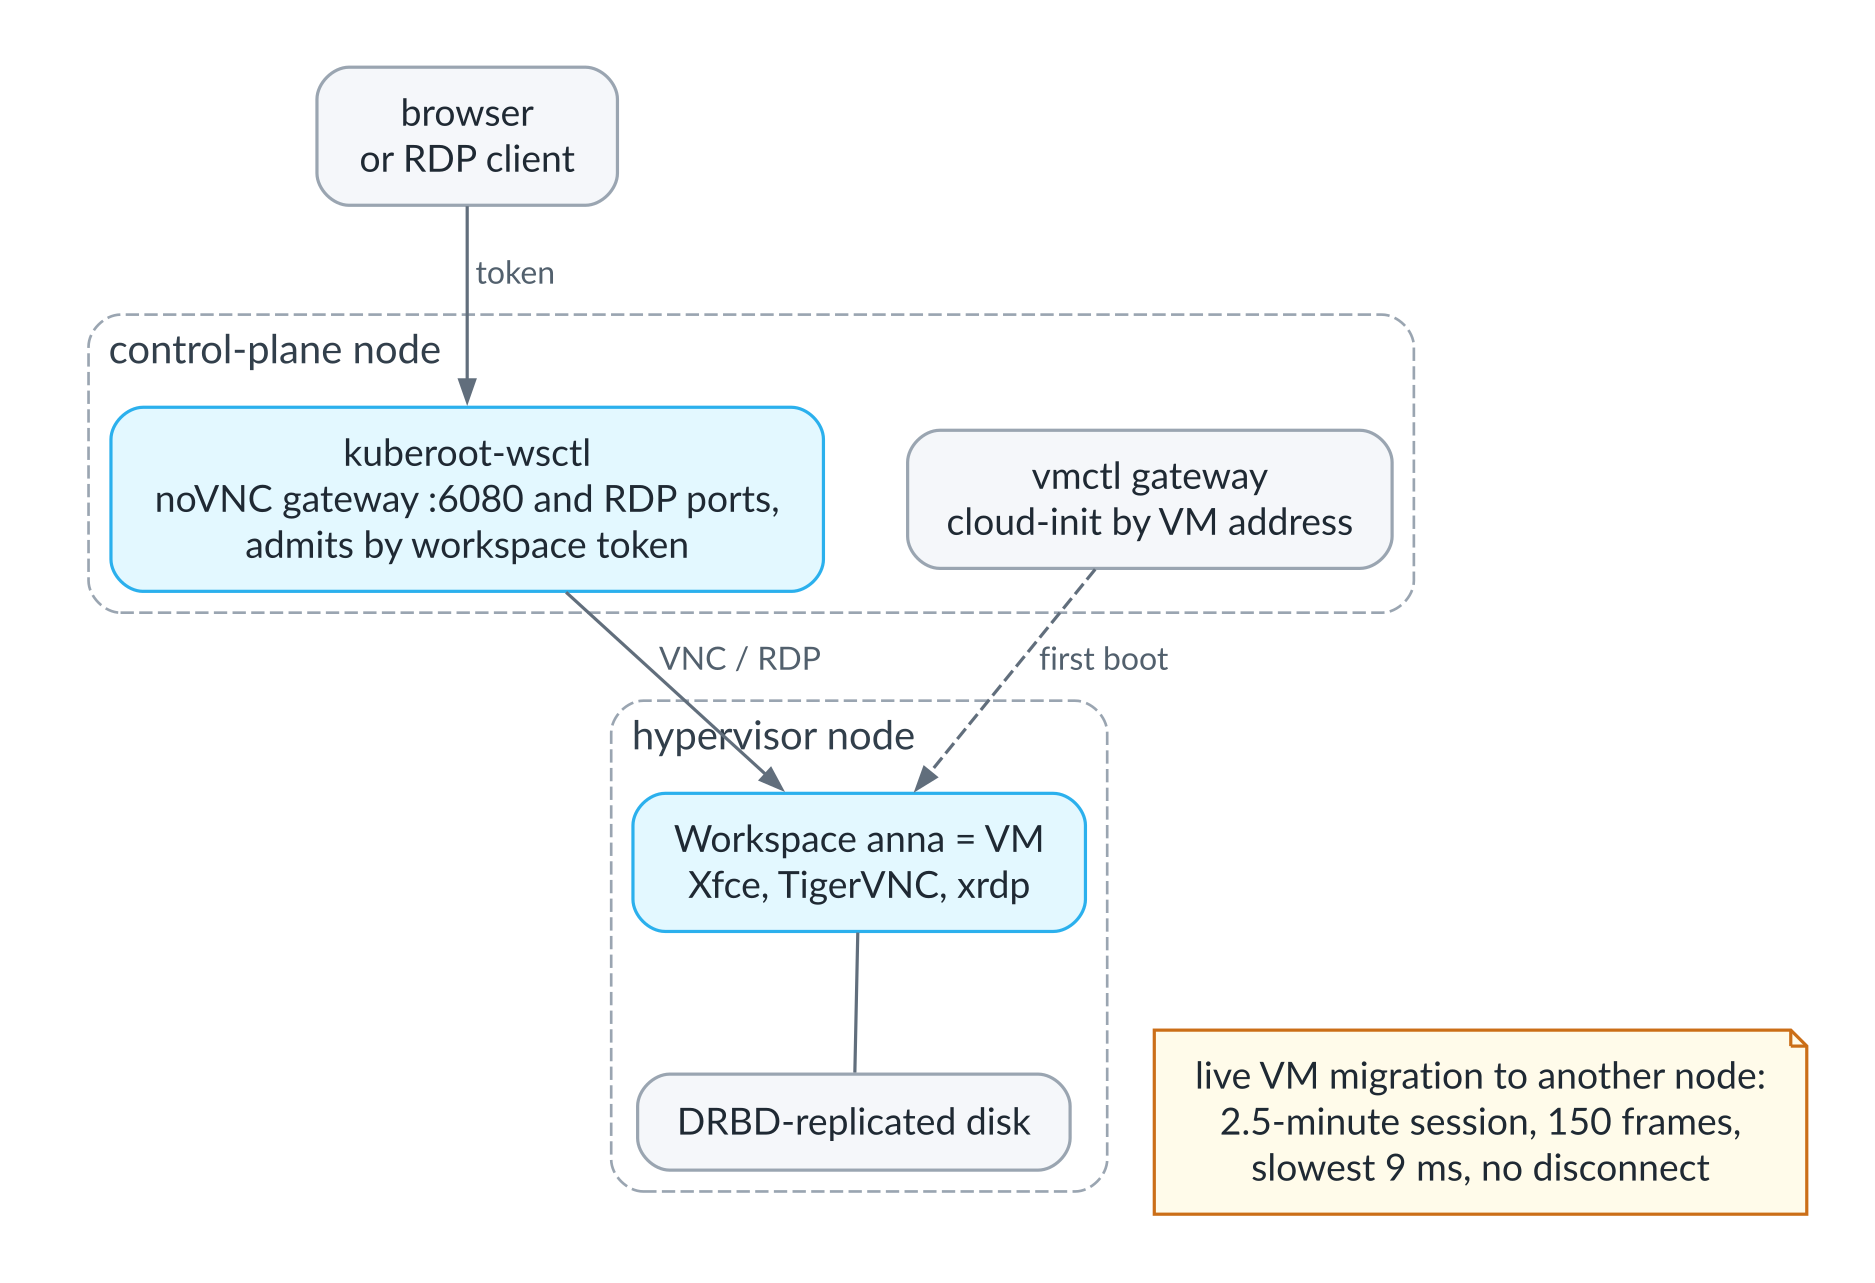
Ein Workspace im Cluster: vom Browser zur virtuellen Maschine
Das Beste an dieser Distribution ist vom Hypervisor geerbt. Eine im Browser geöffnete Sitzung hat eine Live-Migration der virtuellen Maschine auf einen anderen Node überstanden, und während zweieinhalb Minuten Beobachtung ging kein einziger Desktop-Frame verloren; der langsamste brauchte neun Millisekunden. Was man bekommt, ist der Kern von VDI ohne Citrix oder VMware Horizon, wenn auch noch ohne dessen Enterprise-Zubehör: Das Gateway terminiert kein TLS, es gibt kein Single Sign-on gegen ein Benutzerverzeichnis, und Windows-Desktops existieren vorerst nur auf dem Papier, weil die Lizenzierung im Weg steht.
Die Entscheidungen, die wir getroffen haben, und warum
Kocht man alles oben Gesagte auf eine Handvoll Entscheidungen ein, ergibt sich ungefähr folgende Liste, und jeder Punkt darauf verdient, wie ich finde, eine eigene Debatte.
Wir haben entschieden, dass ein Node über dieselbe API verwaltet werden soll wie der Cluster und nicht über ein separates Werkzeug. Das gibt uns ein RBAC-Modell, ein Audit-Log und die Möglichkeit, Nodes mit denselben Controllern zu automatisieren wie alles andere. Der Preis: Die Node-API muss auch funktionieren, wenn es noch keinen oder keinen Cluster mehr gibt, deshalb kann der Node seine API selbstständig bereitstellen, mit eigener Zertifizierungsstelle.
Der Kernel ist unser eigener: Er lädt nur Module, die mit seinem eigenen Schlüssel signiert sind, und verbietet das Laden von Modulen ganz, sobald das System gebootet hat. Das schließt eine ganze Klasse von Angriffen aus und beendet das Auseinanderdriften der Versionen von Treibern und Kernel, bedeutet aber, dass jedes Drittanbietermodul, ob für Storage oder für eine GPU, zusammen mit dem Kernel gebaut werden muss und dass die Verantwortung für die Sicherheitsupdates des Kernels jetzt bei uns liegt.
Das System ist unveränderlich und wird als Ganzes in einen Reserveslot aktualisiert, auf Bewährung. Das gibt uns Rollback ohne menschliches Zutun und identische Nodes, verlangt aber, dass der gesamte veränderliche Zustand separat lebt und sorgfältig von einem Release ins nächste getragen wird, und wir haben schon erlebt, dass ein von einem Release gespeicherter Zustand ein anderes am Booten hinderte.
Eine Distribution ist ein Profil plus ein Metapaket, und alles Gemeinsame lebt im Baukasten. Das macht neue Distributionen billig, verlangt aber Disziplin, damit im Baukasten keine Sonderfälle für einzelne Distributionen wuchern.
Ein Paket ist ein unverändertes Helm-Chart plus Deskriptor, kein neues Format. So können wir alles nutzen, was bereits veröffentlicht ist, aber wo Helm an seine Grenzen stößt, stoßen wir auch daran.
Container bleiben dort draußen, wo sie nicht gebraucht werden. Router und Sensor-Gateway laufen ohne Container-Runtime, und der Hypervisor führt keine Pods aus, was sie einfacher, leichter und berechenbarer macht, aber bedeutet, dass jedes solche Objekt ein eigenes Programm auf dem Node braucht.
Schwere Daten, ob Modellgewichte oder Inferenz-Engines, leben nicht im System-Image, sondern werden von den Nodes heruntergeladen, die sie brauchen, gegen ihren Hash geprüft und mit derselben Sorgfalt ausgerollt wie alles andere.
Und wir haben entschieden, dass maschinelle Intelligenz in der Infrastruktur nur vorschlagen darf und dass Genehmigung, Audit und Verbote in die Architektur eingebaut und vom API-Server durchgesetzt werden müssen, statt eine Einstellung zu bleiben, die jemand einzuschalten vergessen kann.
Worin sich das vom Bestehenden unterscheidet
Der nächste Verwandte von kuberoot ist Talos Linux, und den Unterschied habe ich schon beschrieben: Unser Node wird von Kubernetes selbst verwaltet statt über eine eigene API und ein eigenes Werkzeug, und wir haben einen Baukasten für viele verschiedene Distributionen, während Talos eine einzelne Distribution mit einem Erweiterungsmechanismus ist. Bottlerocket und Flatcar teilen das unveränderliche Design mit A/B-Upgrades, und Kairos baut ebenfalls Images und steuert Upgrades aus dem Cluster, aber meines Wissens stellt keines davon den Node selbst als Kubernetes-Ressourcen dar oder behandelt den gesamten Stack als Familie zweckgebauter Distributionen. Von k3s und k0s unterscheidet uns, dass sie Kubernetes-Distributionen sind, die auf ein fremdes Betriebssystem installiert werden, während wir das Betriebssystem zusammen mit Kubernetes bauen. Von Ubuntu plus kubeadm plus Konfigurationsmanagement unterscheidet uns das Fehlen der Nahtstelle, von der ich am Anfang gesprochen habe. Und von OpenShift und ähnlichen Plattformen unterscheidet uns, dass wir nicht eine große Plattform für alle bauen, sondern es Ihnen ermöglichen, eine kleine zu bauen, spezialisiert auf Ihre eigene Aufgabe.
Dann gibt es Produkte, mit denen sich einzelne Distributionen vergleichen lassen: VyOS fürs Routing, vSphere und Proxmox für Virtualisierung, EdgeX und Node-RED für Industrie-Gateways, KubeEdge für die Verwaltung von Geräten am Rand des Netzes. Mit keinem davon konkurrieren wir bei der Zahl der Features, denn da würden wir verlieren. Was wir zeigen, ist, dass sich dieselbe Aufgabe innerhalb eines gemeinsamen Verwaltungsmodells erledigen lässt, in dem Router, Hypervisor, Modelle und Sensoren in einer API leben, mit einem RBAC-Modell, einem Audit-Log und einem Satz an Automatisierungswerkzeugen.
Ein Wort zu Cozystack, das wir bei Ænix entwickeln. kuberoot soll es nicht ersetzen. Es ist vielmehr eine Erkundung dessen, wie die nächste Schicht unter Plattformen wie dieser aussehen könnte, und vieles, was dabei herauskommt, könnte irgendwann dort landen, wenn die Community des Projekts es für nützlich hält.
Was das bringt
Wer Cluster betreibt, bekommt Nodes, die nicht getrennt vom Cluster verwaltet werden müssen, Upgrades, die sich selbst zurückrollen, und ein Betriebssystem, das nicht driften kann, weil es keine Shell hat, keinen Paketmanager und keine Möglichkeit, ein fremdes Modul in den Kernel zu laden. Einen Control-Plane-Node zu sichern und auf einer anderen Maschine wiederherzustellen, läuft auf zwei Ressourcen hinaus statt auf ein mehrseitiges Runbook.
Wer Plattformen und Produkte auf Kubernetes baut, bekommt einen Weg, eine Distribution für die eigene Nische zu bauen, sei es ein Netzwerkgerät, ein Speichersystem, eine Industriesteuerung, ein Inferenz-Cluster oder ein Edge-Gerät, ohne bei null anzufangen und ohne einen Fork eines Betriebssystems zu pflegen. Und einen Paketmanager, in dem getestete Sätze von Komponenten als ein Ganzes ausgeliefert werden statt als Haufen einzelner Charts, deren Verträglichkeit jeder selbst prüfen muss.
Wer Infrastrukturprodukte kauft, bekommt ein Verwaltungsmodell dort, wo es heute mehrere gibt: Router, Hypervisoren, Cluster und Sensoren werden alle auf dieselbe Weise konfiguriert, mit einem RBAC-Modell und einem Audit-Log, sodass ein Team Netzwerk, Hypervisoren und Cluster betreiben kann, ohne für jedes eine eigene Werkzeugkette.
Und der Branche als Ganzes bietet es, um es einmal großspurig zu sagen, ein funktionierendes Modell, in dem Kubernetes wirklich zum Kernel wird und das Spezifische in Distributionen wandert. Dann wird das Komplexitätsbudget, von dem Tim Hockin sprach, nicht im Kern des Projekts ausgegeben, sondern dort, wo diese Komplexität tatsächlich gebraucht wird, und dort wird sie auch bezahlt.
Wo die Risiken liegen
Risiken gibt es reichlich, und es lohnt sich, sie gleich zu benennen.
Das wichtigste: Es ist noch immer ein kleines Projekt, entwickelt in unserer Freizeit von einem sehr kleinen Team, und alles darin wurde in unserem eigenen Labor getestet, nicht in der Produktion von jemand anderem. Die hochverfügbare Control Plane ist sehr neu, und obwohl sie den Verlust ihres Leaders überstanden und die Konformitätstests bestanden hat, wurde sie bisher nur im Labor getestet, und die etcd-Zertifikate werden, wie die übrige PKI, noch nicht automatisch rotiert. Der Datenspeicher kine auf SQLite passt gut zu einem einzelnen Node und kleinen Clustern, aber wir haben darin schon nicht offensichtliche Dinge gefunden, etwa dass er auf ruhigen Clustern standardmäßig die Historie nicht kompaktiert, und wir werden sicher noch mehr finden.
Ein eigener Kernel bedeutet eigene Verantwortung für seine Sicherheit. Heute haben wir festgelegte Versionen und Neubauten, aber keinen eingespielten Prozess, der innerhalb weniger Tage nach Veröffentlichung einer Schwachstelle im Kernel oder in irgendeiner Komponente des Images ein Update ausliefert, und den werden wir aufbauen müssen, bevor jemand kuberoot irgendwo einsetzt, wo es darauf ankommt.
Die Hardwareunterstützung ist noch schmal. Die Hauptarchitektur ist amd64, auf arm64 ist einiges noch nicht fertig. Der GPU-Treiber ist gebaut und signiert, wurde aber noch nicht auf echten GPUs getestet, und die Latenzwerte der Echtzeit-Distribution wurden nur in virtuellen Maschinen gemessen, wo sie mehr über den Hypervisor des Hosts aussagen als über unseren Kernel.
Keine Shell auf dem Node zu haben ist nicht nur ein Schutz, sondern bei der Fehlersuche auch eine Unbequemlichkeit, und wir müssen erst noch beweisen, dass die Ressourcen der Node-API ausreichen, um jedem Ausfall um drei Uhr nachts auf den Grund zu gehen. Ein unabhängiges Sicherheitsaudit hat es nicht gegeben.
Und schließlich stößt der Paketmanager auf dasselbe Problem, über das jedes ähnliche Projekt vor ihm gestolpert ist. Der Wert von Debian liegt nicht in apt, sondern in seinem Paketarchiv und den Menschen, die es pflegen, und ohne eine Community, die bereit ist, die Pflege von Rezepten zu übernehmen, wird das Archiv klein bleiben, wie gut der Manager selbst auch entworfen sein mag.
Machen Sie mit
Alles, was ich beschrieben habe, ist Open Source unter der Lizenz Apache 2.0 und liegt in der Organisation kuberoot-dev auf GitHub: der Builder und die Distributionen im Repository kuberoot, der Paketmanager in kubepkg und das Paketarchiv in kubepkg-recipes. Ich würde das viel lieber mit anderen weiterbauen als allein.
Derzeit hat das Projekt einen Maintainer, und die Entscheidungen treffe ich, aber das ist ein Ausgangspunkt, kein Ziel. Die Beschreibung, wie das Projekt geführt wird, erklärt, wie Verantwortung an diejenigen übergeht, die beständig beitragen, und wie Entscheidungen gemeinsam getroffen werden, sobald es drei oder mehr Maintainer gibt.
Jede Art von Hilfe ist willkommen. Sie können eine Distribution für Ihre eigene Aufgabe bauen und uns erzählen, wo Ihnen der Baukasten im Weg stand. Sie können testen, was wir selbst nicht testen konnten: auf echten GPUs, auf arm64, auf Echtzeit-Hardware. Sie können Paketrezepte für die Komponenten übernehmen, die Sie selbst verwenden, und das ist vielleicht die wertvollste Hilfe überhaupt. Sie können sich Code und Architektur kritisch ansehen, vor allem die Sicherheit. Oder Sie steigen einfach in die Diskussion ein und sagen mir, dass ich falschliege, denn genau mit dieser Art von Gespräch hat dieses Projekt begonnen.
In den nächsten Artikeln der Serie erkläre ich ausführlich, wie ein per kubectl verwalteter Node funktioniert, wie man mit unserem Baukasten eine eigene Distribution baut und wie der Paketmanager arbeitet und worin er sich von seinen Vorgängern unterscheidet; danach gehe ich jede Distribution einzeln durch, mit Live-Demonstrationen, und schreibe gesondert über den Agent-Operator und unsere Arbeit am Datenspeicher. Und wenn die Serie erschienen ist, würde ich gern das Gespräch wieder aufnehmen, mit dem das alles vor fast zwei Jahren begonnen hat, und sehen, was sich seitdem verändert hat, in der Branche wie in den Ansichten der Beteiligten. Der Code ist bereits geschrieben; bleibt zu erklären, wie er gebaut ist und wie er funktioniert.