Auf einen Blick
- Sprache und System: Oberon-07 auf Niklaus Wirths RISC5-Maschine, Project Oberon 2013
- Umfang: Rund 1.400 Zeilen; davon die Control Plane rund 800
- Netzwerk: nRF24L01+-Funk, ein 32-Byte-Frame pro Nachricht, 24 Bytes Nutzdaten
- Protokoll: Level-triggered Heartbeats und Zuweisungen, Signatur mit HalfSipHash-2-4, 16-Bit-Zähler gegen Replays
- Wiederherstellung: Ein ausgefallener Node kostet rund 8 s; 20 s Funkausfall verschieben keinen einzigen Pod
- Wo es läuft: Browser (WebAssembly), QEMU, KubeVirt, Cozystack (OberonKube)
Quelle: Messungen in impl/kube/README.md auf github.com/tym83/paleocomputing
Stellen Sie sich einen Kubernetes-Cluster ohne eine einzige Netzwerkkarte vor. Seine Nodes wissen nichts von TCP/IP, nicht einmal von Ethernet; sie rufen sich über Funk in kurzen 32-Byte-Paketen zu, wie Poliere mit Walkie-Talkies auf einer Baustelle. Die Control Plane ist in einer Sprache aus den späten Achtzigern geschrieben und kommt samt Netzwerkprotokoll auf rund 1.250 Zeilen. Um einen Pod zu starten, wird nichts heruntergeladen: Der Node lädt einfach ein Modul und ruft darin eine Prozedur auf. Und das Beste: Das Ganze öffnet sich in einem Browser-Tab, in dem Sie einem Node den Stecker ziehen, den Funk stören, dem Cluster einen gefälschten Befehl unterschieben und zusehen können, was passiert.
Diesen Cluster habe ich in den letzten Wochen gebaut und Kube genannt. Es ist eine Kubernetes Control Plane, geschrieben in Oberon, der Sprache von Niklaus Wirth, und sie läuft auf Oberon-Maschinen, also auf dem Prozessor und dem Betriebssystem, die Wirth selbst entworfen hat, von der Schaltung bis zu den Fenstern auf dem Bildschirm. Auch Kubes Nodes sind Oberon-Maschinen, und sie kommunizieren über ein Funknetz aus demselben Buch: Wirth hat dieses Netzwerk schon Ende der Achtziger für seine Workstations geschrieben, und die Neuauflage des Projekts hat es auf ein billiges Funkmodul verlegt.
Lassen Sie mich gleich sagen, warum ich das mache, denn bei Geschichten wie dieser kommt diese Frage immer zuerst, meist mit einem Schmunzeln. Für mich ist das kein Projekt zum Spaß und auch kein Versuch, eine hübsche alte Technik ans Licht zu zerren, damit man sie bewundert und weitergeht. Es ist vor allem Forschung. Ich möchte verstehen, was aus der Infrastruktur der Vergangenheit hätte werden können, wenn die Ideen, die wir heute Kubernetes nennen, in den Jahren aufgekommen wären, als ein Computer klein war, von einem einzelnen Menschen vollständig verstanden werden konnte und mit seinen Nachbarn über das verbunden war, was gerade zur Hand war. Welche interessanten Prinzipien die vergessenen Technologien in sich trugen und was wir mit ihnen weggeworfen haben. Was diesen Technologien fehlte und warum man sie aufgegeben hat. Und wenn man beides ehrlich sortiert, kann man versuchen, in die Zukunft zu blicken und sich eine Infrastruktur vorzustellen, in der die Komplexität nicht schneller wachsen muss als der Nutzen.
Kubernetes ist dafür ein bequemer Bezugspunkt. Seine Kernidee passt in einen Satz: Man sagt dem System nicht, was es tun soll, sondern beschreibt, was existieren soll, und eine Reihe unabhängiger Schleifen vergleicht immer wieder Soll und Ist und schließt die Lücke Schritt für Schritt. Diese Idee weiß nichts von Go, Containern, etcd oder Clouds, und sie lässt sich auf jede Maschine übertragen. Wirths Maschine eignet sich dafür besser als jede andere, weil man sie vollständig lesen kann, von den Registern des Prozessors bis zum Pod-Scheduler, ohne dass sich etwas unter einem Framework versteckt. Wenn man ein großes System in ein so kleines verpflanzt, wird sofort klar, was daran Wesen und was Ablagerung ist, welche Entscheidungen erzwungen waren und welche bloße Gewohnheit.
Dies ist der zweite Teil meiner Serie über Paleocomputing. Im ersten Teil habe ich erzählt, wie ich Wirths Prozessor im Browser, in QEMU, in Kubernetes und in Cozystack zum Laufen gebracht habe, wo sich eine Oberon-Maschine inzwischen mit einem Klick aus dem Katalog installieren lässt. Sie müssen ihn nicht gelesen haben: Alles, was Oberon und Wirths Maschine betrifft, erkläre ich unterwegs, und Kubernetes kennen Sie vermutlich so gut wie ich. Der Artikel ist wieder lang geworden. Zuerst erzähle ich, wie Kube aufgebaut ist und wie es funktioniert, dann von den Prinzipien, die die Sprache und das Betriebssystem Oberon ihm aufgezwungen haben, worin es sich von echtem Kubernetes unterscheidet, wo es besser und wo es spürbar schlechter geworden ist. Danach folgen sechs Labs, die Sie direkt im Browser durchspielen können, eine Anleitung für alle, die das Ganze selbst installieren wollen, und zum Schluss meine Gedanken dazu, was solche Experimente denjenigen beibringen können, die heute Infrastruktur bauen.
Wenn Sie lieber zuerst anfassen und dann lesen, öffnen Sie das Cluster-Lab. Installieren müssen Sie nichts. Innerhalb einer halben Minute booten drei Maschinen, die Control Plane startet Kube, die Nodes treten bei, und rechts erscheint eine Cluster-Tabelle, die die Seite allein durch Mithören auf dem Funkkanal aufbaut. Quellcode, Dokumentation und sämtliche Messungen liegen im Repository github.com/tym83/paleocomputing.
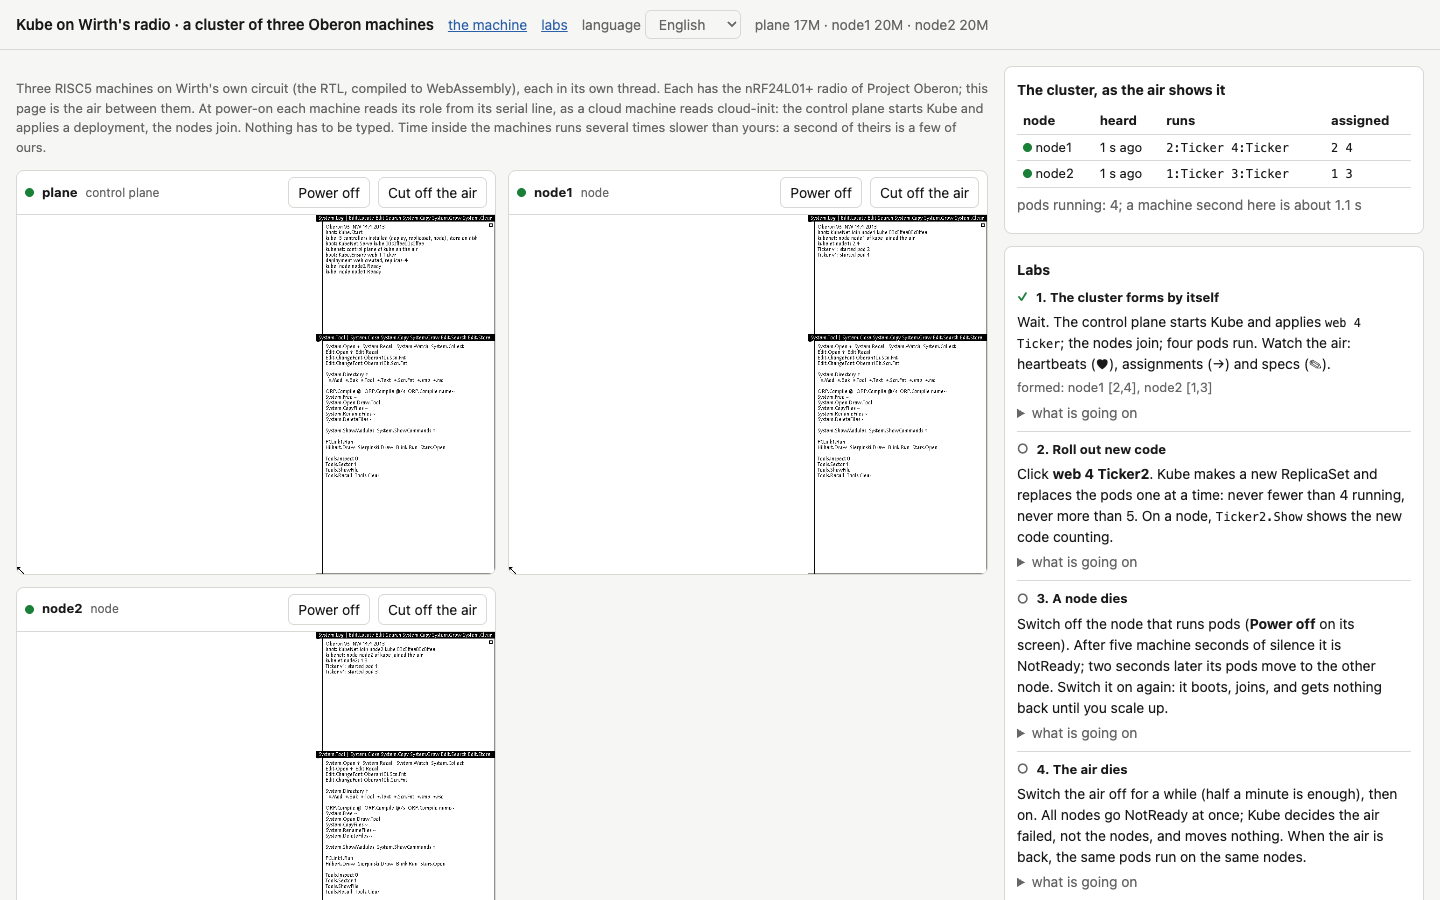
Drei Oberon-Maschinen in einem Browser-Tab. Links ihre Bildschirme, rechts die aus dem Funkverkehr aufgebaute Cluster-Tabelle und die Labs, die sich selbst prüfen
Wie Kube aufgebaut ist
Oberon und Wirths Maschine in Kürze
Oberon ist zugleich eine Programmiersprache und ein Betriebssystem. Entwickelt haben beides Mitte der Achtziger an der ETH Zürich Niklaus Wirth, der Autor von Pascal und Modula-2, und Jürg Gutknecht. Die Sprache ist winzig: Module, Records, Arrays, Pointer, Garbage Collection und strenge Typisierung, dagegen keine Exceptions, keine Generics und nicht einmal vorzeichenlose Ganzzahlen. Das System passt zur Sprache. Es hat keine Prozesse, keine Threads und keinen Speicherschutz. Ganz unten dreht sich eine einzige Schleife, Oberon.Loop: Sie fragt Maus und Tastatur ab, ruft Kommandos nacheinander auf und ruft in den Pausen zwischen Eingabeereignissen Hintergrund-Tasks auf, Oberon.Task. Ein Task kann nicht unterbrochen werden, also muss er sein Stück Arbeit schnell erledigen und zurückkehren. Multitasking ist hier mit anderen Worten kooperativ und beruht auf den guten Manieren aller Beteiligten.
2013 veröffentlichte Wirth eine Neuauflage des Buchs Project Oberon und ergänzte das System um seinen eigenen Prozessor, RISC5, beschrieben in Verilog. In ein FPGA geladen, lief er auf einem Board mit einem Megabyte Speicher bei 25 MHz. Das ist Wirths Maschine. Bei uns lebt sie in drei Gestalten: Im Browser läuft Wirths tatsächliche Schaltung, nach C++ übersetzt und zu WebAssembly kompiliert; in QEMU läuft unser eigenes Modell der Maschine; und in Kubernetes läuft dasselbe QEMU-Modell innerhalb von KubeVirt.
Wie alles anfing
Die erste Version von Kube war ein reines Spielzeug, und das habe ich in einer eigenen Folge der Serie auch ehrlich gesagt. Sie bestand aus einem einzigen Oberon-Modul mit einem Objekt-Store und drei Controllern, für Deployments, ReplicaSets und Nodes. Die Nodes waren drei Namen, node-a, node-b und node-c, und ein Pod galt nur deshalb als laufend, weil ein Controller den Namen eines Nodes in ihn eingetragen hatte. Nirgends lief irgendetwas. Doch schon diese Version zeigte sehr deutlich, dass das Herz von Kubernetes nicht Container sind, sondern Reconcile-Loops, und dass diese Schleifen wunderbar zu Oberon passen.
Sie passen, weil Oberon bereits alles mitbringt, was eine Control Plane braucht, nämlich eine zentrale Schleife, die Hintergrundarbeit aufruft. Kube.Start installiert die drei Controller als drei Oberon.Tasks mit einer Periode von 50 Millisekunden, im selben Ring, in dem auch der Garbage Collector des Systems läuft, und von da an ruft Oberon.Loop sie auf, wann immer der Benutzer gerade nicht tippt oder die Maus bewegt. Die Controller rufen sich nicht gegenseitig auf und schicken sich nichts. Jeder betrachtet nur Objekte seiner eigenen Art und ändert nur, was ihm gehört, und das Ergebnis seines Durchlaufs wird beim nächsten Durchlauf zur Eingabe eines Nachbarn. Genau so interagieren auch die Controller des echten Kubernetes: über gemeinsamen Zustand, nicht über Nachrichten.
Um das Ganze einen Cluster nennen zu können, fehlten zwei Dinge. Erstens Nodes, also mehrere Maschinen und eine Möglichkeit, miteinander zu sprechen. Zweitens Rollouts, bei denen eine Version einer Anwendung eine andere ohne Downtime ablöst. Bei den Nodes dachte ich zuerst, ich sei in eine Sackgasse geraten, denn Wirths Maschine hat kein Netzwerk. Dann habe ich das Buch noch einmal gelesen und darin den Funk gefunden.
Wirths Funk
Die Oberon-Workstations an der ETH waren immer vernetzt. Wirth schrieb dieses Netzwerk schon Ende der Achtziger für die kabelgebundene Ceres-Workstation, und in der Ausgabe von 2013 verlegte Paul Reed, der mit ihm an der neuen Version des Projekts arbeitete, es auf Funk. Auf dem Board sitzt ein nRF24L01+-Transceiver, ein billiger Chip, den man bis heute in kabellosen Tastaturen und Bastelgeräten findet, und der Prozessor spricht mit ihm über SPI, einen einfachen seriellen Bus. Der Chip ist sehr bescheiden. Er sendet jeweils einen Frame von höchstens 32 Bytes, empfangene Frames warten in einem Puffer mit drei Plätzen, alle Stationen auf einem Kanal hören einander, und eine Kollisionsvermeidung gibt es überhaupt nicht: Sprechen zwei Stationen gleichzeitig, bekommt der Empfänger entweder Müll oder gar nichts.
Der Treiber des Chips, das Modul SCC, umfasst rund zweihundert Zeilen. Jedes seiner Pakete beginnt mit einem acht Byte langen Header mit Adressen, Typ und Länge, und ein langes Paket wird in mehrere 32-Byte-Frames zerlegt. Auf SCC sitzt das Modul Net, ein kleines Protokoll, mit dem sich Stationen Nachrichten und Dateien schicken. Wenn ich im Folgenden von Wirths Funk spreche, meine ich genau dieses Paar, und mit dem Funkkanal alles, was die Stationen auf einem Kanal hören.
Warum Funk und kein gewöhnliches Netzwerk? Weil Wirths Maschine schlicht kein anderes hat. Sie besitzt weder Ethernet noch einen TCP/IP-Stack, und die zu schreiben hieße, ein kleines Linux auf Oberon zu bauen. Der Funk dagegen ist im selben Buch beschrieben, und ich war neugierig, was für ein System herauskommt, wenn ich die Grenzen der Maschine ehrlich akzeptiere, statt ihr ein modernes Netzwerk überzustülpen.
Eine virtuelle Maschine hat natürlich keinen echten Funk. Deshalb emuliert unser QEMU-Modell den gesamten nRF24L01+-Chip samt Registern und Warteschlangen und verpackt jeden gesendeten Frame in ein UDP-Datagramm. Die Datagramme fließen zu einem Relay, einem kleinen Programm, das jeden Frame an alle anderen Maschinen weiterreicht. Das ist der Funkkanal. Das Relay kann einen vorgegebenen Anteil der Frames verlieren, und wenn man es anhält, ist der Funkkanal ganz weg. In Cozystack, unserer offenen Plattform auf Basis von Kubernetes, wurde das Relay zu einer Katalog-Anwendung, OberonAir, und im Browser spielt die Seite selbst den Funkkanal.
Drei Nachrichten, jede in einem Frame
Das Protokoll, das ich KubeNet genannt habe, kennt nur drei Nachrichten. Jede geht an alle gleichzeitig, denn ein Funkgerät kann ohnehin keinen Empfänger auswählen, und jede passt in einen einzigen Frame.
Ein Node sendet einmal pro Sekunde seinen Heartbeat mit seinem Namen und den IDs der Pods, die gerade tatsächlich auf ihm laufen. Die Control Plane sendet jedem lebenden Node einmal pro Sekunde eine Zuweisung mit den Pods, die an diesen Node gebunden sind. Die dritte Nachricht, eine Spec, kommt ebenfalls von der Control Plane und teilt mit, welches Image der Pod mit einer bestimmten ID hat. Specs gehen eine pro Tick hinaus, noch nicht gestartete Pods zuerst.
Warum ein Frame und nicht eine Nachricht beliebiger Länge? SCC kann Pakete bis zu einem halben Kilobyte senden, indem es sie in Frames zerlegt, aber der Funkkanal hat keine Kollisionsvermeidung. Beginnen zwei Stationen gleichzeitig, lange Pakete zu senden, werden ihre Frames bei jedem Empfänger ineinander verschachtelt, und der Empfänger kann nicht mehr erkennen, welcher Frame zu wem gehört. Man könnte eine Arbitrierung für den Funkkanal erfinden, Warteschlangen und Neuübertragungen, aber genau auf diesem Weg sind Netzwerke bei der Komplexität angekommen, der ich entkommen wollte. Also passt jede Nachricht in einen Frame, und nach dem SCC-Header bleiben 24 Bytes Nutzdaten.
In einem Heartbeat und einer Zuweisung sind diese Bytes so aufgeteilt: das Cluster-Tag, sechs Bytes Node-Name, die Anzahl der Pods, bis zu zehn Pod-IDs zu je einem Byte, zwei Bytes Zähler und vier Bytes Signatur. Genau vierundzwanzig. Daher kommen alle seltsamen Grenzen von Kube: Ein Node-Name hat höchstens sechs Zeichen, eine Pod-ID belegt ein Byte, und ein Node betreibt höchstens zehn Pods, weil nicht mehr in einen Heartbeat passen und der Scheduler auch nicht mehr bindet.
Die wichtigste Eigenschaft des Protokolls ist, dass es level-triggered ist wie die Controller von Kubernetes, nur nicht innerhalb der Control Plane, sondern im Netzwerk selbst. Ein Node betreibt genau das, was seine letzte Zuweisung sagt, und nicht eine Folge von „start“- und „stop“-Befehlen. Geht eine Zuweisung verloren, kommt eine Sekunde später eine mit demselben Inhalt, es gibt also nichts zu reparieren. Geht ein Heartbeat verloren, wartet die Control Plane auf den nächsten. Es gibt keine Bestätigungen, keine Neuübertragungen und keine Sequenznummern für die Zuverlässigkeit: Die gesamte Zuverlässigkeit entsteht daraus, dass jede Nachricht den vollständigen Zustand trägt und nicht eine Änderung. Selbst auf einem Funkkanal, der 30 Prozent seiner Pakete verliert, hat sich in einer Minute kein einziger Pod bewegt, und das habe ich geprüft.
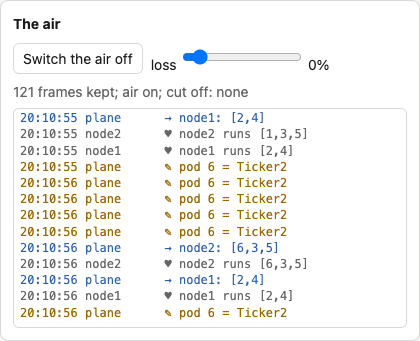
Der Funkkanal im Lab. Herzen sind Heartbeats der Nodes, Pfeile Zuweisungen der Control Plane, der Stift markiert Pod-Specs. Gerade läuft ein Rollout, und die Control Plane teilt den Nodes neue Pods mit dem Image Ticker2 mit
Ein Pod ist ein Modul
Im echten Kubernetes ist das Image eines Pods ein Dateisystem-Archiv mit einem Programm darin: Das Kubelet holt es aus einer Registry und startet es in einem isolierten Container. Oberon hat nichts dergleichen, aber es hat einen Mechanismus, der ähnlich und viel schneller funktioniert. Das Image eines Pods ist in Kube einfach der Name eines Oberon-Moduls auf dem Node.
Erfährt das Kubelet von einem neuen Pod, ruft es Modules.Load mit dem Namen des Images auf. Ist das Modul noch nicht geladen, sucht das System seine kompilierte Datei auf der Festplatte, lädt sie in den Speicher, bindet sie mit allen Modulen, die sie importiert, prüft die Schlüssel ihrer Schnittstellen und führt den Rumpf des Moduls aus. Ein Schlüssel ist eine Art Prüfsumme der Schnittstelle, die der Compiler in jedes Modul schreibt. Hat sich eine Schnittstelle geändert, weigert sich das System, Module zu laden, die gegen die alte Version kompiliert wurden. Dann sucht das Kubelet das Kommando Start des Moduls und ruft es auf, und wenn der Pod verschwinden soll, ruft es das Kommando Stop desselben Moduls auf.
Ein Kommando ist in Oberon jede exportierte Prozedur ohne Parameter. Man führt es aus, indem man mit der mittleren Maustaste auf den Text Module.Procedure in einem beliebigen Fenster klickt, und braucht es Parameter, liest es sie selbst aus dem Text hinter seinem Namen. Die ID eines Pods lässt sich also nicht direkt übergeben, und dafür gibt es ein winziges Modul, Pods, mit zwei Variablen, der ID und dem Image. Das Kubelet füllt sie vor dem Aufruf, und das Workload-Modul liest sie. Nicht die eleganteste Lösung, aber ganz im Geiste von Oberon: Eine globale Variable eines Moduls ist hier ein legitimer Weg, Kontext weiterzugeben, denn zu jedem Zeitpunkt läuft nur ein Kommando, und Race Conditions können gar nicht entstehen.
Den Lehr-Workload gibt es in zwei Versionen, Ticker und Ticker2. Für jeden gestarteten Pod führt er einen Sekundenzähler, und das Kommando Ticker.Show zeigt an, welche Pods auf dieser Maschine laufen und wie viele Sekunden jeder schon lebt. So lassen sich Rollouts gut beobachten: Im Log des Nodes sieht man, wie die Pods der ersten Version stoppen und die der zweiten starten.
Gibt es auf dem Node kein Modul dieses Namens, lässt sich Start nicht aufrufen, und das Kubelet lässt den Pod einfach aus seinem Heartbeat weg. Die Control Plane sieht, dass der Pod zugewiesen ist, aber nicht läuft, und er bleibt Pending. In Kubernetes sieht ein Pod genau so aus, dessen Image nicht gezogen werden konnte.
Der Store auf der Festplatte
In Kubernetes liegt der gesamte Zustand des Clusters in etcd, und eine neu gestartete Control Plane liest ihn von dort. In Kube übernimmt ein Array aus 256 Einträgen im Speicher der Control-Plane-Maschine die Rolle von etcd, und damit es einen Neustart übersteht, schreibt ein Hintergrund-Task es bei jeder Änderung auf die Festplatte.
Geschrieben wird abwechselnd in zwei Dateien, Kube.Store0 und Kube.Store1, jede mit einer Generationsnummer und einer Prüfsumme. Fällt mitten im Schreiben der Strom aus, ist nur eine Datei beschädigt, und die andere, aus der vorherigen Generation, bleibt erhalten. Beim Start liest Kube.Start beide und nimmt die neuere der unbeschädigten. Die Dateien werden an Ort und Stelle überschrieben statt neu angelegt, und auch das verlangt Oberon: Sein Dateisystem gibt den Platz ersetzter Dateien erst beim nächsten Booten frei, und würde man für jede Änderung eine neue Datei anlegen, liefe einem viel beschäftigten Cluster schlicht die Festplatte voll.
Nach einem Neustart gibt die Control Plane den Nodes ein Heartbeat-Timeout Zeit, sich zu melden, und beginnt erst danach, sie als NotReady zu zählen. Kubernetes macht es nach einem Neustart seines Node-Controllers genauso. Den Beginn dieses Timeouts musste ich übrigens verschieben, vom Moment, in dem der Store gelesen ist, auf den Moment, in dem die Control Plane anfängt, den Funkkanal abzuhören. In der Cloud hatte jemand es geschafft, zwischen diesen beiden Befehlen etwas über VNC einzutippen, das Timeout lief ab, und alle Pods zogen um, obwohl keiner gestoppt war.
Rollouts und zwei Bugs, die Kubernetes gut kennt
Das Kommando Kube.Apply web 6 Ticker2, abgesetzt auf ein laufendes web 6 Ticker, ändert das Image. Der Deployment-Controller legt ein neues ReplicaSet an und beginnt, Pods einen nach dem anderen umzuziehen. Zuerst kommt ein Pod mit dem neuen Image hinzu. Sobald sein Kubelet meldet, dass er läuft, gibt es einen Pod mehr als gewünscht, und das alte ReplicaSet entfernt einen der eigenen. Das wiederholt sich, bis das alte ReplicaSet leer ist, dann wird es gelöscht.
Das klingt einfach, aber unterwegs tauchten zwei Bugs auf, und beide erwiesen sich als alte Bekannte von Kubernetes.
Der erste betrifft das Stoppen eines Pods. Löscht die Control Plane einen Pod aus dem Store, läuft der Pod auf seinem Node weiter, bis das Kubelet die nächste Zuweisung hört, und das kann bis zu einer Sekunde dauern. Bis dahin sieht der Controller schon einen Pod weniger und fügt einen neuen hinzu. So liefen für einen Moment acht Pods, wo sieben erlaubt waren. Das echte Kubernetes verhält sich genauso, und erst kürzlich hat das Deployment das Feld podReplacementPolicy bekommen, mit dem es wartet, bis alte Pods vollständig gestoppt sind, und auch das ist noch Alpha, hinter einem Feature Gate. In Kube habe ich das zum einzigen Verhalten gemacht: Pods, die die Nodes noch melden, die aber nicht mehr im Store stehen, gelten als stoppend, und solange es welche gibt, kommt kein neuer Pod hinzu.
Der zweite Bug betrifft die Pod-IDs. Ein Node kennt einen Pod nur an seiner Ein-Byte-ID. Anfangs bekam ein neuer Pod die niedrigste freie ID, und das war oft genau die ID des alten Pods, den er gerade ersetzt hatte. Das Kubelet sah in der Zuweisung eine bekannte ID und schloss, es habe sich nichts geändert. Der Store behauptete, Ticker2 laufe, während auf dem Node weiter Ticker lief. Genau deshalb verwendet Kubernetes die UID eines Pods niemals wieder. Kubes IDs werden jetzt reihum vergeben, und die Prüfung nach jedem Rollout verlangt, dass keine ID eines alten Pods mehr läuft.
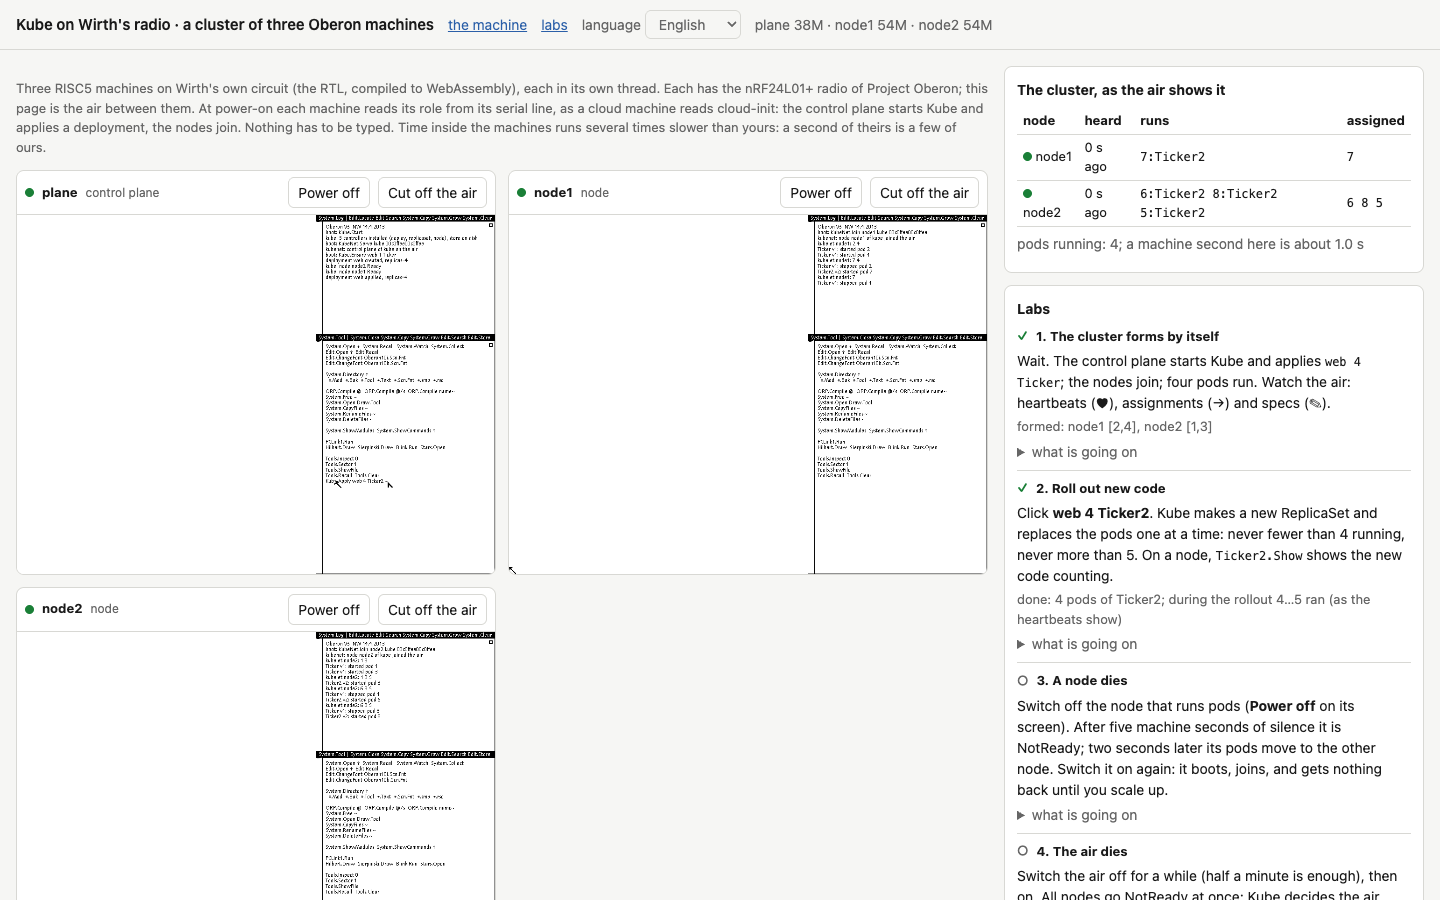
Der Rollout ist abgeschlossen: Alle vier Pods laufen mit dem neuen Image, und während des Rollouts gab es nie weniger als vier und nie mehr als fünf Pods. Gezählt hat das die Seite anhand der Heartbeats, nicht anhand dessen, was die Control Plane sagt
Die Ausfälle, für die es Cluster gibt
Ein Cluster existiert, um Ausfälle zu überstehen, und ich wollte das so testen, wie ich einen echten testen würde. Ein eigener Test startet eine Control Plane und zwei Nodes und beurteilt sie ausschließlich anhand des Funkkanals. Dafür tritt dem Relay ein passiver Lauscher bei: Er sendet nichts, sondern zeichnet nur jeden Heartbeat und jede Zuweisung auf und prüft ihre Signaturen. Kube selbst fragt der Test fast nichts: Nur das Ergebnis eines Rollouts wird mit dem verglichen, was Kube auf die Festplatte geschrieben hat, und alles andere wird danach beurteilt, was tatsächlich auf dem Funkkanal passiert ist.
Schaltet man einen Node ab, markiert die Control Plane ihn nach fünf Sekunden Funkstille als NotReady und verschiebt zwei Sekunden später seine Pods auf einen anderen Node, sodass das Ganze rund acht Sekunden dauert. Schaltet man die Control Plane ab, betreiben die Nodes weiter ihre letzte Zuweisung, weil niemand ihnen etwas anderes sagt. Bootet sie wieder, kommt der Store von der Festplatte zurück, und keine einzige Zuweisung ändert sich. Fehlt den Nodes das Modul, bleiben die Pods Pending. Und gehen eine ganze Minute lang 30 Prozent der Pakete verloren, bewegt sich kein einziger Pod.
Anfangs lag das Timeout bei drei Sekunden. Auf einem Funkkanal mit 30 Prozent Verlust fielen mehrmals pro Minute drei Heartbeats in Folge aus, und die Control Plane hielt den Node für tot und verschob Pods, die nie irgendwohin verschwunden waren. Mit fünf Sekunden wurden Fehlalarme dutzendfach seltener, und der Preis war eine langsamere Erholung von einem echten Ausfall. Kubernetes geht denselben Handel in einem anderen Maßstab ein: Das Kubelet meldet sich alle zehn Sekunden, und die Control Plane wartet vierzig bis fünfzig.
Am lehrreichsten war der Verlust des Funkkanals. Verstummt das Relay für zwanzig Sekunden, verstummen alle Nodes auf einmal. Eine Control Plane, die einfach ihren Timeouts vertraut, schließt daraus, dass die Nodes gestorben sind, und versucht, jeden Pod zu verschieben, obwohl es nirgendwohin zu verschieben gibt. Und wenn der Funkkanal zurückkommt, erwachen die Nodes einer nach dem anderen: Der erste, der zurück ist, bekommt die Pods aller anderen, der zweite holt sich einen Teil davon zurück und so weiter. In der ersten Version änderten zwanzig Sekunden Ausfall 74 Zuweisungen. Die Nodes arbeiteten die ganze Zeit weiter und bemerkten nichts, während der Cluster sich selbst eine Katastrophe inszenierte.
Kubernetes kennt diese Falle: Werden alle Nodes einer Zone gleichzeitig NotReady, versetzt der Node-Controller die Zone in den Zustand FullDisruption und hört auf, Pods zu evicten, mit der Überlegung, dass alle Nodes im selben Moment weit seltener sterben, als eine Verbindung abreißt. Kube macht dasselbe, wenn alle Nodes NotReady werden oder, bei drei und mehr, mindestens 55 Prozent. Auf Anhieb funktionierte es aber nicht: Es brauchte zwei Details, die erst bei einer fehlgeschlagenen Prüfung ans Licht kamen.
Erstens werden Nodes nicht im selben Moment NotReady; ihre Heartbeats liegen bis zu einer Sekunde auseinander. Der erste verstummte Node verlor also seine Pods, bevor die anderen verstummten und klar wurde, dass es sich um einen Ausfall handelte. Jetzt ziehen die Pods eines Nodes erst um, wenn er zwei Sekunden lang NotReady ist, und bis dahin sind auch alle anderen verstummt. Kubernetes wartet darauf standardmäßig fünf Minuten. Zweitens kommen Nodes auch einzeln zurück, und schon der erste zurückgekehrte holte den Cluster aus diesem Zustand, bevor die anderen sich gemeldet hatten, sodass deren Pods sofort umzogen. Jetzt bekommen die stummen Nodes nach dem Verlassen des Zustands noch ein weiteres Timeout, um sich zu melden, wie es auch Kubernetes macht, das die Timer der Nodes zurücksetzt, wenn eine Zone FullDisruption verlässt. Mit diesen beiden Korrekturen ändern zwanzig Sekunden Ausfall keine einzige Zuweisung.
Fremde auf dem Funkkanal
Einmal landeten in der Sandbox zwei Cluster auf demselben Funkkanal, und beide hatten einen Node gleichen Namens. Ein Node des einen Clusters startete und stoppte ständig seine Pods, weil er abwechselnd den Zuweisungen beider Control Planes gehorchte. Also kam an den Anfang jeder Nachricht ein Cluster-Tag, ein aus dem Namen des Clusters berechnetes Byte, und ein Node begann, Nachrichten mit fremdem Tag zu ignorieren.
Doch ein Tag beweist nichts; senden kann es jeder, also kam als Nächstes eine Signatur. Jede Nachricht trägt einen Authentifizierungscode, einen MAC, berechnet aus der Nachricht selbst und dem geheimen Schlüssel des Clusters, und ohne den Schlüssel lässt sich der richtige Code nicht erraten. Berechnet wird er mit HalfSipHash-2-4, einer reduzierten Variante von SipHash, die mit 32-Bit-Wörtern arbeitet und ein 32-Bit-Ergebnis liefert. HMAC-SHA256 kommt hier nicht in Frage: Wirths Prozessor ist 32-bittig und läuft mit 25 MHz, und von den 24 Bytes der Nachricht darf die Signatur höchstens vier belegen. HalfSipHash wurde genau für solche kleinen Geräte entwickelt und umfasst in Oberon rund dreißig Zeilen. Zweiunddreißig Bit sind für ernsthafte Kryptografie etwas knapp, aber für einen Lehr-Cluster ein ehrlicher Kompromiss.
Eine Signatur verhindert nicht, dass eine aufgezeichnete echte Nachricht erneut eingespielt wird, deshalb trägt jede Nachricht auch einen 16-Bit-Zähler, und der Empfänger verwirft alles, was nicht neuer ist als die letzte vom selben Absender angenommene Nachricht. Auch das prüft der Ausfalltest. Direkt nach einer echten Zuweisung schickt er dem Node im Namen eines Fremden „nichts betreiben“, und zwar auf drei Arten: mit dem Tag eines anderen Clusters, mit dem falschen Schlüssel signiert und als früher aufgezeichnete echte Zuweisung. Der Node ignoriert alle drei. Derselben Nachricht, ehrlich mit dem Schlüssel und einem frischen Zähler signiert, gehorcht er, und das ist der Kontrollfall, ohne den die Prüfung nichts beweisen würde.
Was es aushält
Ein eigener Lasttest startet eine Control Plane und zwei bis acht Nodes mit drei Pods pro Node und misst anhand des Funkkanals, wie schnell der Cluster konvergiert und wie schnell er sich vom Verlust eines Nodes erholt. Bei jeder Größe konvergiert er in rund drei Sekunden, und der Verlust eines Nodes kostet rund acht: fünf Sekunden Timeout, zwei Sekunden Pause vor der Eviction und bis zu einer Sekunde bis zur nächsten Zuweisung. Ein falsches NotReady gab es nie.
Eine Obergrenze hat der Cluster dennoch, und sie liegt nicht im Funk selbst, sondern in Wirths Treiber. Vor jedem Senden wartet SCC 50 Millisekunden, damit die Bestätigung eines anderen zu Ende gehen kann, und die Maschine tut währenddessen nichts anderes. Eine Station kann also höchstens zwanzig Nachrichten pro Sekunde senden. Die Control Plane braucht jede Sekunde eine Zuweisung pro Node, mit acht Nodes verbringt sie also fast die Hälfte ihrer Zeit mit Warten, während sich empfangene Frames im Puffer mit drei Plätzen stauen und die überzähligen verloren gehen. Während eines Rollouts kommen zu den Zuweisungen noch Specs hinzu, eine pro Tick, und das Warten nimmt fast die gesamte Zeit ein. Nach meiner Rechnung trägt das Protokoll im Leerlauf rund zwanzig Nodes und während eines Rollouts rund zehn. Das ist eine Rechnung anhand des Codes, keine Messung. Außerdem belegt jede Oberon-Maschine einen ganzen Kern des Hosts, weil ihre Schleife nie untätig ist, und acht Nodes auf einer Maschine belasten eher diese Maschine als den Funkkanal.
Zwei Bugs in unserem QEMU
Damit all das funktioniert, mussten zwei Bugs behoben werden, nicht in Kube, sondern in unserem Maschinenmodell für QEMU, und ohne den Cluster hätte ich keinen davon gefunden. Die Operation MOD nach einer Multiplikation lieferte manchmal die falsche Hälfte des Produkts, sodass die Prüfsumme des Stores immer null ergab. Der Hintergrund-Task sah darin keine Änderungen, und der Store wurde kein einziges Mal geschrieben. Und eine Maschine, die einmal ihr Relay verloren hatte, hörte den Funkkanal für immer nicht mehr, weil der UDP-Kanal von QEMU nach einem fehlgeschlagenen Lesen stillschweigend seinen Leser fallen ließ. Beide Funde sind im Repository beschrieben, und sie sind ein gutes Beispiel dafür, warum ich es so mag, echte Programme auf einem Emulator laufen zu lassen: Das Booten des Systems hat keinen der beiden Bugs ausgelöst.
Befehle beim Start und OberonKube
Der letzte Schritt diente dem Komfort, aber ohne ihn hätte alles andere seinen Sinn verloren. Niemand startet einen Cluster ein zweites Mal, wenn auf jeder Maschine Befehle über VNC eingetippt werden müssen. Jede Maschine sollte beim Start wissen, wer sie ist, so wie eine Cloud-VM ihre Rolle aus cloud-init erfährt.
QEMU nimmt jetzt eine Zeichenkette mit Befehlen entgegen, die die Maschine beim Start ausführen soll, und speist sie in die serielle Schnittstelle ein, als wären sie an einer Konsole getippt worden. Ein kleines Modul, Boot, liest die Zeichenkette und führt die Befehle nacheinander aus, jeden mit seinen Parametern. Aufgerufen wird es ganz am Ende des Rumpfs von System, dem Modul, das beim Systemstart geladen wird. System selbst wird aus den Quellen des Images mit genau dieser einen zusätzlichen Zeile neu gebaut, sodass seine Schnittstelle und der Schlüssel, den jedes andere Modul prüft, gleich geblieben sind.
Hier hat mir der Cluster noch eine Lektion erteilt. Die Befehle beim Start laufen bei jedem Booten, nicht nur beim ersten. Steht Kube.Apply web 4 Ticker darunter, kehrt das Deployment nach einem Neustart der Control Plane zu dem zurück, was die Befehle sagen, und ein inzwischen von Hand durchgeführter Rollout wird stillschweigend rückgängig gemacht. Ob das gut oder schlecht ist, hängt davon ab, was man als Source of Truth betrachtet. In der Cloud ist es das Bestellformular, und dorthin zurückzukehren ist dort genau das richtige Verhalten. Im Browser-Lab dagegen, wo ein Mensch eine neue Version von Hand ausrollt, war es ein Bug, und gefunden hat ihn übrigens das Lab selbst, nicht die QEMU-Tests. Für solche Fälle gibt es jetzt das Kommando Kube.Ensure, das ein Deployment nur anlegt, wenn es noch keines gibt.
In Cozystack kam all das in einer einzigen Katalog-Anwendung zusammen, OberonKube. Ein Benutzer gibt an, wie viele Nodes er braucht, den Cluster-Schlüssel und eine Liste von Deployments, und der Katalog legt den Funkkanal, die Control-Plane-Maschine und die Nodes an und gibt jeder Maschine die Befehle für ihre Rolle. Der Cluster bildet sich von selbst. Das Formular ist hier die Source of Truth: Eine geänderte Liste von Deployments greift beim nächsten Neustart der Control Plane. Die Maschinen eines Funkkanals versuchen außerdem, auf verschiedenen Hosts zu landen, damit der Verlust eines Hosts so wenige Nodes wie möglich kostet.
Was Oberon erzwungen hat
Wenn man Kubernetes in Go für Linux schreibt, kann fast jede Entscheidung in jede Richtung fallen. Braucht man eine Queue, sind Channels zur Hand; braucht man eine Datenbank, gibt es etcd; braucht man ein Netzwerk, gibt es gRPC über TCP; braucht man Isolation, gibt es Kernel-Namespaces. Es gibt immer eine Wahl, und deshalb fallen Entscheidungen oft aus Gewohnheit. Bei Oberon gibt es fast nichts zu wählen, und das ist der interessanteste Teil: Jede Grenze der Sprache und des Systems hat eine ganz bestimmte Entscheidung erzwungen, und diese Entscheidungen zeigen deutlich, welche Eigenschaften von Kubernetes aus seiner Idee selbst folgen und welche aus dem, worauf es gebaut wurde.
Ich teile die Grenzen in solche, die von der Sprache kamen, und solche, die vom Betriebssystem und der Maschine kamen, obwohl die Grenze dazwischen bei Wirth eine Konvention ist: Alles stammt aus einer Hand.
Was die Sprache erzwungen hat
Größen sind vorab bekannt. In Oberon-07 ist die Größe eines Arrays fast immer zur Compile-Zeit bekannt, und dynamischer Speicher wird nur für Records angelegt, die über Pointer erreicht werden. Ein Programm, in dem alles nach Bedarf wächst, ist in einer solchen Sprache umständlich zu schreiben, und ich habe es gar nicht erst versucht. Kubes Store ist ein Array aus 256 Objekten, ein Node hat höchstens zehn Pods, ein Node-Name höchstens sechs Zeichen, ein Image-Name höchstens fünfzehn, eine Pod-ID belegt ein Byte. Jede dieser Zahlen hat einen Grund, und alle stehen in zwei Konstantenblöcken am Anfang der Module Kube und KubeNet. Dadurch allokiert Kube in seiner Arbeitsschleife keinen Speicher, kann ihn bei einer Flut von Objekten nicht erschöpfen und verhält sich an seinen Grenzen vorhersehbar: Ein überzähliger Pod wird schlicht nicht angelegt. Auch das echte Kubernetes lebt mit Grenzen, etwa standardmäßig 110 Pods pro Node oder anderthalb Megabyte pro Objekt in etcd, aber dort sind sie über die Dokumentation verstreut, während sie sich hier nicht verstecken lassen.
Ganzzahlen sind 32-bittig, und nur Bytes sind vorzeichenlos. HalfSipHash arbeitet mit genau 32-Bit-Wörtern und erzeugt eine 32-Bit-Signatur, die in den Frame passt. Daher auch die Zählerarithmetik modulo 65.536 mit einer sorgfältigen Prüfung „ist diese Zahl neuer“, die auch nach einem Überlauf korrekt bleibt. Daher auch die Prüfsumme des Stores, die so berechnet wird, dass sie nicht vom Vorzeichen abhängt. Eine Kleinigkeit, aber genau dort ist der Bug mit MOD in unserem QEMU aufgetaucht.
Kommandos ohne Parameter. Eine exportierte Prozedur ohne Parameter gilt als Kommando, eine mit Parametern nicht. Das Kubelet kann also nicht Start(pod) aufrufen: Es legt die ID des Pods im Modul Pods ab und ruft Start ohne Argumente auf. In jeder anderen Sprache gälte das als schlechter Stil, aber hier gibt es keinen anderen Weg, und es ist sicher, weil immer nur ein Kommando läuft.
Module mit Schlüsseln. Jedes kompilierte Modul trägt den Schlüssel seiner Schnittstelle, und beim Laden prüft das System ihn gegen das, womit die importierenden Module kompiliert wurden. Das Image eines Pods ist in Kube also nicht nur ein Name, sondern ein Name mit eingebauter Kompatibilitätsprüfung. Wurde ein Workload-Modul gegen eine alte Version von Pods kompiliert, weigert sich das System, es zu laden, und der Pod bleibt Pending, statt mitten in der Arbeit abzustürzen. In der Container-Welt kommt dem ein gepinnter Image-Digest am nächsten, aber der garantiert nur, dass man genau diese Bytes bekommen hat, keineswegs, dass sie zu ihrer Umgebung passen.
Die Sprache ist klein. Das klingt nach einem Nachteil, diszipliniert in der Praxis aber mehr als alles andere. Oberon hat keine generischen Collections, keine Exceptions, keine Interfaces, keine Goroutinen und keine Reflection, also ist ganz Kube als schlichte Schleifen über Arrays geschrieben und als Prozeduren, die einen Wahrheitswert zurückgeben, statt etwas zu werfen. Es liest sich fast wie Pseudocode, und genau so wollte ich es haben.
Was das System und die Maschine erzwungen haben
Eine Schleife und kooperative Tasks. Das ist die wichtigste Grenze. Oberon hat keine Threads, also laufen Kubes Controller als Tasks in der zentralen Schleife, und auch das Kubelet auf einem Node ist ein Task. Jeder Task erledigt ein kurzes Stück Arbeit und kehrt zurück, und daraus folgen sofort drei Dinge. Erstens hat Kube keinen einzigen Lock, keinen Mutex und keinen Channel, denn Race Conditions können nicht entstehen: Solange ein Controller läuft, stehen die anderen still. Zweitens ist das Verhalten deterministisch: Bei gleicher Eingabe tun die Controller dasselbe in derselben Reihenfolge, und ein solches System ist weitaus leichter zu debuggen. Drittens, und das ist ein Minus, friert jeder Task, der lange nachdenkt, die ganze Maschine ein, Kubelet und Funk inklusive. Ein Pod, dessen Kommando Start in eine Endlosschleife gerät, legt den gesamten Node lahm.
Kein Speicherschutz. Alle Module leben in einem Adressraum, und das Einzige, was ein Modul davon abhält, den Speicher eines anderen zu beschädigen, ist eine streng typisierte Sprache mit Prüfung der Array-Grenzen. Für Kube bedeutet das, dass Pods in keiner Weise isoliert sind, weder voneinander noch vom Kubelet. Das ist der gravierendste Unterschied zum echten Kubernetes, und ich komme darauf zurück, wenn es darum geht, was Oberon fehlte.
Die Oberfläche ist Text. In Oberon ist jede Zeile der Form Module.Command in jedem Fenster ein Kommando. Kube hat deshalb keinen API-Server, kein YAML und kein kubectl. Seine API besteht aus Kommandos wie Kube.Apply web 6 Ticker2, Kube.Get und Kube.DeletePod, die ein Mensch in ein beliebiges Fenster schreibt und mit einem Mittelklick ausführt, das Ergebnis liest er im Systemlog. Dasselbe Prinzip hat die Befehle beim Start möglich gemacht: Die Rolle einer Maschine wird durch eine gewöhnliche Befehlszeile festgelegt, die QEMU in die serielle Schnittstelle einspeist, und das Modul Boot führt sie genau so aus, wie es ein Mensch täte. Ein spezielles Konfigurationsformat war nicht nötig; die Konfiguration einer Maschine wurde zum Text ihrer Befehle.
Ein Dateisystem alter Schule. Oberon gibt den Platz ersetzter Dateien erst beim nächsten Booten frei. Deshalb wird Kubes Store an Ort und Stelle überschrieben, abwechselnd in zwei Dateien, statt bei jeder Änderung neu angelegt, und das hat ihn zugleich gegen einen Stromausfall mitten im Schreiben geschützt. Eine Lösung, zu der Datenbanken vor Jahrzehnten gekommen sind, ergab sich hier von selbst, aus einer Beschränkung des Dateisystems.
Funk statt Netzwerk. Das habe ich schon ausführlich behandelt: ein 32-Byte-Frame, Broadcast an alle, keine Kollisionsvermeidung. Daraus folgt ein Protokoll aus Nachrichten mit je einem Frame, vollständiger Zustand statt Bestätigungen, ein Cluster-Tag und eine Signatur in jeder Nachricht. Und daraus folgt auch die unerwartetste Eigenschaft des ganzen Systems, um die es im nächsten Abschnitt geht: Alles, was der Cluster weiß, ist auf dem Funkkanal zu hören.
Fünfundzwanzig Megahertz. Die Geschwindigkeit der Maschine hat die Perioden bestimmt: Controller laufen alle 50 Millisekunden, das Kubelet alle 100, ein Heartbeat geht einmal pro Sekunde hinaus. Die Control Plane braucht sehr wenig echte Rechenarbeit, und fast ihre gesamte Zeit geht ins Warten. Doch leider ist auch das Warten nicht umsonst: Vor jedem Senden dreht der Funktreiber fünfzig Millisekunden lang eine Schleife, und genau dieses Warten, nicht die Rechenarbeit, begrenzt die Größe des Clusters.
Worin sich Kube von echtem Kubernetes unterscheidet
Damit keine Illusionen entstehen, hier ein kurzer Vergleich. Kube verkörpert die Idee von Kubernetes, nicht Kubernetes selbst, und der Unterschied zwischen beiden ist gewaltig.
| Kubernetes | Kube | |
|---|---|---|
| Umfang | Millionen Zeilen Go | rund 1.400 Zeilen Oberon, davon rund 800 für die Control Plane |
| Store | etcd, verteilt und per Raft konsistent gehalten | ein Array aus 256 Objekten im Speicher einer Maschine und zwei Dateien auf ihrer Festplatte |
| API | API-Server, REST, YAML, kubectl, RBAC | Oberon-Kommandos, die ein Mensch in ein Fenster schreibt |
| Objektarten | Dutzende, plus eigene über CRDs | vier: Deployment, ReplicaSet, Pod und Node |
| Netzwerk zwischen Nodes | TCP/IP, meist mit separatem Pod-Netzwerk | Funk-Broadcast, 32-Byte-Frames |
| Pod-Image | ein Container-Image aus einer Registry | ein Oberon-Modul auf der Festplatte des Nodes |
| Pod-Isolation | Namespaces und cgroups des Linux-Kernels | keine, alle Pods teilen sich einen Adressraum mit dem Kubelet |
| Ressourcen | Requests und Limits für CPU und Speicher | nur die Anzahl der Pods pro Node, höchstens zehn |
| Scheduler | Filter, Bewertung, Affinity, Prioritäten | der am wenigsten ausgelastete Node |
| Netzwerk für Anwendungen | Service, DNS, Ingress | keines |
| Speicher für Anwendungen | PersistentVolume | keiner |
| Verfügbarkeit der Control Plane | mehrere Replikas von API-Server und etcd | eine Maschine; nach einem Neustart wird der Zustand von der Festplatte gelesen |
| Bereitschaft | Readiness- und Liveness-Probes | ein Pod ist bereit, sobald sein Kommando Start zurückkehrt |
| Sicherheit des Protokolls | TLS mit gegenseitiger Zertifikatsprüfung | eine 32-Bit-Signatur mit gemeinsamem Schlüssel und einem Zähler gegen Replays |
| Skalierung | Tausende Nodes | getestet mit bis zu acht Nodes, alle auf einem Funkkanal |
Diese Tabelle zeigt, dass Kube für nichts taugt, wofür Kubernetes taugt. Sie zeigt aber noch etwas anderes: Die gesamte Logik, für die es Kubernetes gibt, also der Sollzustand, unabhängige Reconcile-Loops, Rollouts ohne Downtime, Erholung vom Verlust eines Nodes und Vorsicht bei einer abgerissenen Verbindung, passt in ein kleines System, das fast nichts von dem hat, was in der mittleren Spalte steht. Alles andere in Kubernetes ist dazu da, dass diese Logik auf Tausenden Maschinen funktioniert, für Tausende Benutzer und für Anwendungen, denen niemand vertraut. Sehr wichtige Dinge, aber nicht das Fundament.
Wo Kube besser wurde und wo Oberon versagte
Einen Spielzeug-Cluster auf Funk mit dem Kubernetes zu vergleichen, auf dem das halbe Internet läuft, wirkt unfair, und ich werde nicht behaupten, Kube sei besser. Mich interessiert etwas anderes: welche Qualitäten in Kube ganz von selbst entstanden sind, ohne jede Mühe, einfach weil es auf Oberon herangewachsen ist. Ich meine die Eigenschaften, die dem gewöhnlichen Kubernetes entweder fehlen oder für die es viel zu viel bezahlt. Ich habe sechs gezählt.
Der ganze Cluster lässt sich an einem Abend lesen
Die Control Plane umfasst rund achthundert Zeilen, das Netzwerkmodul mit Kubelet und Signaturen rund vierhundert, und mit dem Lehr-Workload und dem Modul für die Befehle beim Start kommt man auf rund vierzehnhundert. Darunter liegt nur noch das Oberon-System, das sich ebenfalls vollständig lesen lässt, und Wirths Prozessor in Verilog, für den ein paar Abende genügen. Der ganze Weg von „Ich will sechs Replikas von Ticker2“ bis zum Register des Funkchips, über das eine Zuweisung zu einem Node hinausfliegt, lässt sich also mit bloßem Auge verfolgen, ohne ein einziges Mal auf eine Bibliothek zu stoßen, die nie jemand gelesen hat.
Mit Kubernetes ist das schon lange nicht mehr möglich, und zwar nicht, weil es schlecht geschrieben wäre: Es löst eine riesige Zahl von Problemen, die Kube schlicht nicht hat. Am Ende weiß aber selbst ein erfahrener Engineer, der es seit Jahren betreibt, meist, wie es sich verhält, aber nicht, warum, und erfährt es erst während eines Ausfalls. In Kube steht die Antwort auf jedes „Warum“ in einer einzigen Prozedur.
Der Funkkanal ist die Observability
Diese Eigenschaft habe ich nicht geplant; sie ist von selbst entstanden, und sie gefällt mir am besten. Weil jede Nachricht an alle geht und den vollständigen Zustand statt einer Änderung trägt, ist auf dem Funkkanal in jedem Moment alles zu hören, was der Cluster über sich weiß: welche Nodes leben, was auf jedem läuft, was an jeden gebunden ist und welches Image jeder Pod hat. Ein passiver Lauscher, der nichts sendet, rekonstruiert das ganze Bild des Clusters, ohne ihm eine einzige Frage zu stellen.
Alle meine Prüfungen funktionieren so. Weder der Ausfalltest noch der Lasttest noch die Browser-Labs fragen jemals die Control Plane, was los ist. Sie hören den Funkkanal ab und vergleichen, was tatsächlich auf den Nodes lief, mit dem, was ihnen zugewiesen war. Ein Bug in Kube selbst kann eine solche Prüfung nicht täuschen, denn sie schaut nicht auf Kubes Berichte, sondern auf das Verhalten der Nodes. Im gewöhnlichen Kubernetes braucht man dafür Metriken, Logs, Audit, Exporter und ein eigenes System, das all das einsammelt, und trotzdem sieht man nur, was die Komponenten über sich selbst erzählen wollten.
Ein Pod startet im Handumdrehen
In Kubernetes heißt einen Pod starten: ein Image ziehen, Layer entpacken, Namespaces anlegen und einen Prozess starten, und das dauert Sekunden, bei kaltem Cache und großem Image sogar Minuten. In Kube heißt einen Pod starten: ein Oberon-Modul laden, falls es noch nicht geladen ist, und sein Kommando aufrufen, und ist das Modul bereits im Speicher, reduziert sich der Start eines Pods auf einen Prozeduraufruf. Der ganze Cluster konvergiert in drei Sekunden, und fast diese ganze Zeit geht ins Warten auf den nächsten Heartbeat, nicht in Arbeit.
Diese Geschwindigkeit wurde natürlich mit der Isolation bezahlt, der Vergleich ist also unfair. Aber er zeigt, wohin die Zeit tatsächlich geht. Wenn heute von Kaltstarts, von WebAssembly auf dem Server oder von V8-Isolates die Rede ist, geht es genau um diese Frage: Lässt sich eine Deployment-Einheit so klein und so modulartig machen, dass ihr Start so viel kostet wie ein Funktionsaufruf, ohne auf Isolation zu verzichten?
Kompatibilität wird beim Laden geprüft
Darüber habe ich im Abschnitt über die Prinzipien schon geschrieben, aber es lohnt sich, es zu wiederholen, denn es ist eine starke Idee. Das Image eines Pods ist in Kube ein Modul mit einem Schnittstellenschlüssel, und das System weigert sich, es zu laden, wenn es gegen eine inkompatible Version dessen kompiliert wurde, was es importiert. Ein Pod mit inkompatiblem Image stürzt nicht nach einer Stunde Arbeit bei einem unerwarteten Aufruf ab: Er startet einfach nicht, bleibt Pending, und das sieht man sofort. In der Container-Welt prüft niemand die Kompatibilität eines Images mit seiner Umgebung außer Ihren Tests, und die Kompatibilität von Images, die einander aufrufen, prüft bestenfalls ein API-Schema, und auch nur, wenn Sie eines haben.
Keine Locks und daher keine Race Conditions
Kubes Code hat keine Mutexe, keine Channels und keine atomaren Operationen. Controller, Kubelet, das Schreiben des Stores auf die Festplatte und der Empfang von Funkpaketen laufen alle als Tasks einer Schleife und werden streng nacheinander ausgeführt. Data Races, Deadlocks und Bugs, die einmal in tausend Durchläufen auftreten, können in Kube also gar nicht entstehen. Das Verhalten ist deterministisch: Führt man dasselbe Szenario zweimal aus, tun die Controller dasselbe in derselben Reihenfolge.
Die Kehrseite kommt etwas weiter unten, aber schon der Gedanke, dass eine Control Plane nicht multithreaded sein muss, scheint mir unterschätzt. Die Control Plane von acht Nodes braucht sehr wenig Rechenarbeit. Die Control Plane von tausend Nodes braucht natürlich mehr, aber auch dort geht der größte Teil der Zeit nicht ins Rechnen, sondern ins Warten auf Netzwerk und Festplatte, und Single-Threaded-Event-Loops haben längst bewiesen, dass sich solches Warten ohne Threads bedienen lässt.
Sicherheit ab der ersten Nachricht
Das frühe Kubernetes ließ standardmäßig vieles offen; das Kubelet etwa akzeptierte lange Zeit anonyme Anfragen, und solche Löcher zu schließen dauerte Jahre. In Kube kamen Signatur und Replay-Schutz, bevor der Cluster überhaupt etwas Nützliches konnte, einfach weil der Funk keine Wahl ließ: Auf dem Funkkanal kann jeder alles sagen, und das ist vom ersten Tag an offensichtlich. Die Signatur ist 32-bittig, was für die reale Welt zu wenig ist, aber architektonisch ist das Protokoll richtig: Jede Nachricht ist authentisch und gehört zu ihrem Cluster, und die Prüfung kostet rund dreißig Zeilen.
Der ganze Cluster in einem Browser-Tab
Und die letzte, nicht über die Architektur, sondern über das, was aus ihr folgt. Eine Oberon-Maschine ist so klein, dass drei von ihnen samt Funkkanal in einen Browser-Tab passen. Alles, was ich beschreibe, lässt sich also nicht nur lesen, sondern ohne jede Installation nachvollziehen: einen Node abschalten, den Funk stören, eine gefälschte Zuweisung einschleusen. Für Kubernetes gibt es gute Lern-Sandboxes, aber das ist immer jemandes Cluster irgendwo in einer Cloud, während der Cluster hier auf Ihrem Rechner lebt und sich nach Belieben kaputtmachen lässt, ohne jemanden zu stören.
Was Oberon fehlte
Nun dazu, wo Oberon zu eng war und warum solche Systeme höchstwahrscheinlich verloren haben. Für die Forschung ist dieser Teil nicht weniger wichtig.
Isolation. Das ist der Hauptpunkt. In Oberon leben alle Module in einem Adressraum und vertrauen einander. Ein Pod, der über SYSTEM.PUT Speicher beschädigt, beschädigt damit auch das Kubelet, den Funk und alles andere. Ein Pod, der in eine Endlosschleife gerät, friert den ganzen Node ein, weil ein kooperativer Task, der nicht zurückkehrt, das gesamte System anhält. Solange auf der Maschine Code eines einzigen Autors läuft, der diesem Code vertraut, ist alles gut, und genau so hat Wirth sein System entworfen: für einen Menschen an einem Computer. Ein Cluster existiert aber gerade dazu, fremden Code auszuführen, und ohne Isolation ist das unmöglich. Kubernetes auf Linux bekommt die Isolation vom Kernel, Oberon dagegen bräuchte dafür Speicherschutz im Prozessor, präemptives Multitasking und Ressourcen-Accounting, müsste also ein ganz anderes System werden.
Präemption. Neben der Isolation kann die Control Plane weder einen Pod unterbrechen, der zu lange rechnet, noch die Prozessorzeit unter den Pods aufteilen. Keine Quotas, keine Prioritäten, keine Limits, nur gute Manieren. Einem Lehr-Workload, der einmal pro Sekunde einen Zähler um eins erhöht, ist das egal, aber jeder echte Workload stolpert sofort darüber.
Ein Netzwerk. Funk mit 32-Byte-Frames eignet sich hervorragend zur Steuerung, aber für Anwendungsdaten ist darin kein Platz. Kubes Pods haben keine Adressen, keine Services und keine Möglichkeit, miteinander zu sprechen. Über Wirths Funk lassen sich Dateien verschicken, aber das wäre eher ein USB-Stick als ein Netzwerk.
Flexible Größen. Die Grenzen, die ich für ihre Vorhersehbarkeit gelobt habe, werden zur Obergrenze: zehn Pods pro Node, 256 Objekte im Store, sechs Zeichen pro Name und zwanzig Nachrichten pro Sekunde und Station. Jede dieser Obergrenzen lässt sich anheben, aber nicht beliebig, denn alle folgen aus dem 24-Byte-Frame, statischen Arrays und einem einfachen Treiber. Kubernetes hat dafür, keine solchen Obergrenzen zu haben, mit enormer Komplexität bezahlt, und mit Blick auf Kube versteht man, dass dieser Preis bewusst gezahlt wurde.
Eine hochverfügbare Control Plane. Kube hat eine einzige Control-Plane-Maschine. Stirbt sie endgültig samt ihrer Festplatte, steht der Cluster ohne Master da. Die Nodes betreiben weiter ihre letzte Zuweisung, was eine gute Eigenschaft ist, aber die Control Plane lässt sich nicht durch eine andere Maschine ersetzen, weil es keinen konsistenten Store über mehrere Maschinen gibt. Raft lässt sich in Oberon schreiben, aber über einen Funk ohne Zustellgarantien und mit 32-Byte-Frames wäre das ein großes Forschungsvorhaben für sich.
Mehrere Benutzer. Oberon hat einen Benutzer, Kube einen Schlüssel pro Cluster. Keine Namespaces, keine Rollen, keine Rechtetrennung, und wer den Schlüssel kennt, kann alles. Kubernetes verwendet den größten Teil seiner Komplexität genau darauf, dass viele Menschen und Teams sich einen Cluster sicher teilen können, während Kube eine solche Schicht überhaupt nicht hat.
Nimmt man all diese Punkte zusammen, wird klar, dass Oberon nicht verloren hat, weil es schlecht entworfen war, sondern weil es für eine andere Welt entworfen wurde, in der ein Computer einem Menschen gehört, der gesamte Code darauf von diesem Menschen oder von Leuten seines Vertrauens geschrieben ist und ein Netzwerk eine Möglichkeit ist, dem Nachbarn eine Datei zu geben. Sobald Computer geteilt wurden und Code fremd wurde, brauchte man Isolation, Präemption und Rechte, und einfache Systeme mussten komplexen weichen.
Sechs Labs in Ihrem Browser
Anfangs bezweifelte ich, dass sich der Cluster überhaupt im Browser betreiben lässt. Die Oberon-Maschine aus den Labs des vorigen Artikels lief bereits in einem Tab: Es ist Wirths tatsächliche Schaltung, nach C++ übersetzt und zu WebAssembly kompiliert. Aber sie hatte keinen Funk, und ein Cluster braucht drei Maschinen, die einander hören. Also bekam die Browser-Maschine dasselbe Modell des nRF24L01+-Transceivers wie die QEMU-Maschine und lernte, die von ihr gesendeten Frames nach außen zu geben und die Frames anderer Maschinen entgegenzunehmen. Jede Maschine läuft in einem eigenen Hintergrund-Thread, und die Seite nimmt ihre Frames und reicht sie an die anderen weiter, die Seite selbst ist also der Funkkanal. Sie kann außerdem einen vorgegebenen Anteil der Frames verlieren, eine einzelne Maschine vom Funkkanal trennen und Kubes Nachrichten samt Prüfung ihrer Signaturen lesen, weshalb rechts eine aus dem Funkverkehr aufgebaute Cluster-Tabelle erscheint.
Auch eine serielle Schnittstelle war nötig, damit die Maschinen ihre Rollen beim Einschalten erfahren, wie in der Cloud. Die Control Plane erhält die Befehle Kube.Start, KubeNet.Serve kube 00c0ffee00c0ffee und Kube.Ensure web 4 Ticker, die Nodes KubeNet.Join mit ihren Namen, sodass nichts eingetippt werden muss. Kube.Ensure steht dort nicht zufällig, aber dazu mehr im sechsten Lab.
Die Geschwindigkeit wurde zu einer eigenen Aufgabe. In WebAssembly führt Wirths Schaltung weniger als eine Million Instruktionen pro Sekunde und Maschine aus, also dutzendfach langsamer als das 25-MHz-Board. Kube zählt die Zeit dagegen in Maschinensekunden: ein Heartbeat pro Sekunde, ein Timeout von fünf. Hätte ich die Uhren der Maschinen ehrlich gehen lassen, bräuchte der Cluster mehrere Minuten, um sich zu bilden, und das Lab mit einem abgeschalteten Node dauerte rund fünf Minuten. Deshalb lässt die Seite die Uhren der Maschinen zehnmal schneller laufen als ihre Instruktionen, und die Maschinen glauben, sie liefen mit 2,5 MHz. Ihre Sekunden vergehen in einem Tempo, dem das Auge folgen kann, und dem Protokoll ist es egal: Es hat keine Ahnung, wie viele Instruktionen in eine Sekunde passen.
Hintergrund-Tabs hielten eine weitere unerwartete Falle bereit: Der Browser bremst Timer dort stark aus, und der Cluster fror fast ein. Deshalb drehen die Maschinen jetzt ihre eigene Schleife und hängen nicht von den Timern der Seite ab. Die letzte Falle war die Eingabe. Die Seite tippt einen Befehl mit Tasten und Mausklicks in eine Maschine, und anfangs tat sie das in einem Rutsch. Das sind rund elf Millionen Instruktionen, mit der schnellen Uhr also über vier Sekunden Maschinenzeit, in denen die Maschine den Funkkanal nicht hört. Nach jedem Tastendruck erklärte die Control Plane beide Nodes für NotReady, und gerettet hat sie nur, dass Evictions in FullDisruption ausgesetzt werden. Jetzt geht die Eingabe in kleinen Portionen hinein, abwechselnd mit der Arbeit der Maschine, und dazwischen wird der Funkverkehr zugestellt.
Jedes Lab prüft sich selbst und zeigt einen Haken, wenn das Beschriebene tatsächlich auf dem Funkkanal passiert ist. Einen Knopf zu drücken und einen Haken zu bekommen, funktioniert nicht: Die Prüfung schaut auf Heartbeats und Zuweisungen, nicht darauf, was Sie getan haben.
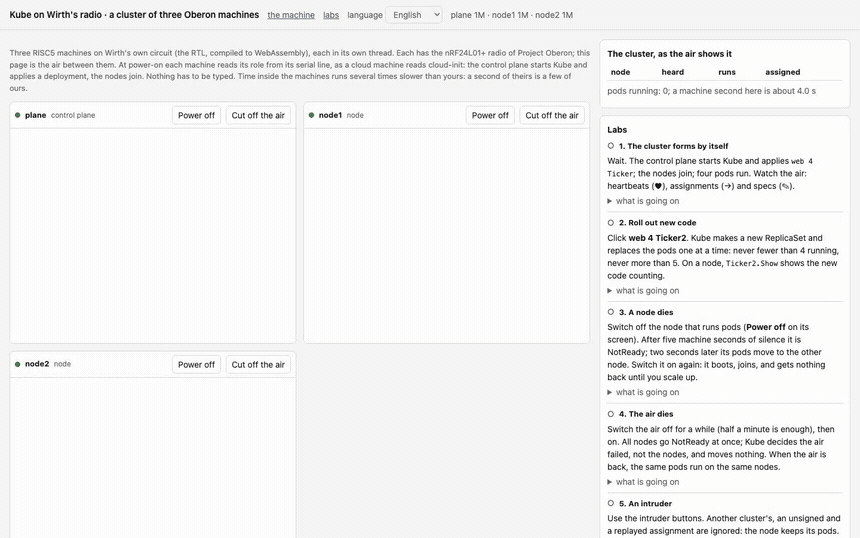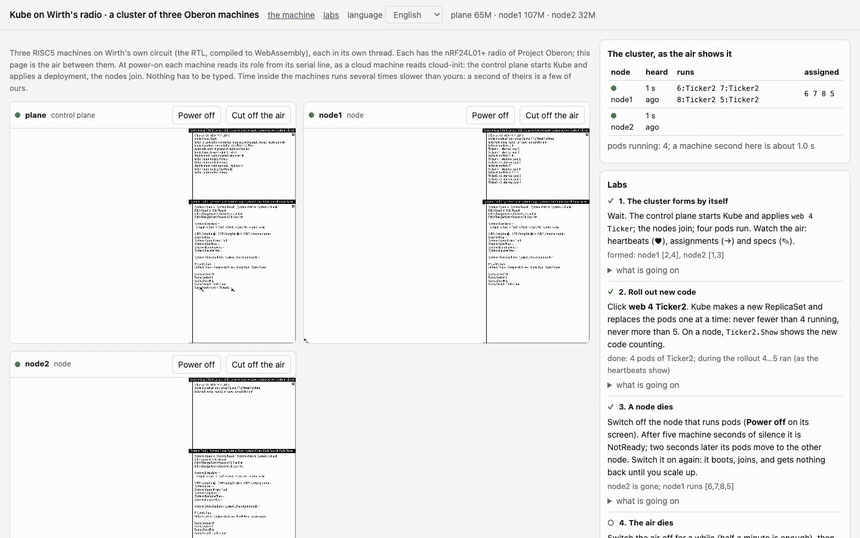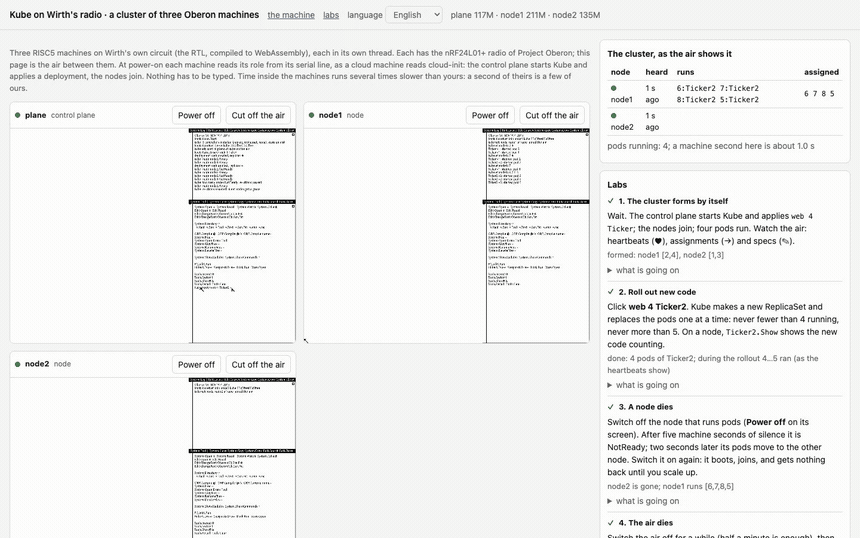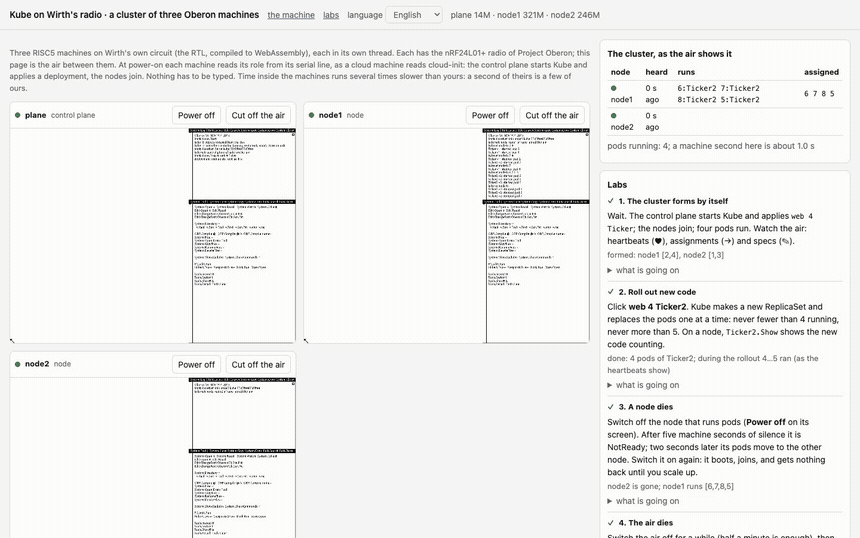
Alle sechs Labs hintereinander, achtfach beschleunigt. Der Cluster bildet sich, neuer Code wird ausgerollt, ein Node wird abgeschaltet, der Funk wird gestört, ein Eindringling versucht es auf vier Arten, die Control Plane wird neu gestartet
1. Der Cluster bildet sich von selbst
Nichts zu tun außer warten. Die Maschinen booten, und auf dem Bildschirm der Control Plane sieht man, wie das Modul Boot die Befehle ausführt, die über die serielle Schnittstelle gekommen sind. Kube installiert drei Controller, beginnt den Funkkanal abzuhören und legt das Deployment web mit vier Pods an, und ein paar Sekunden später erscheinen im Log die Zeilen „node node1 Ready“ und „node node2 Ready“.
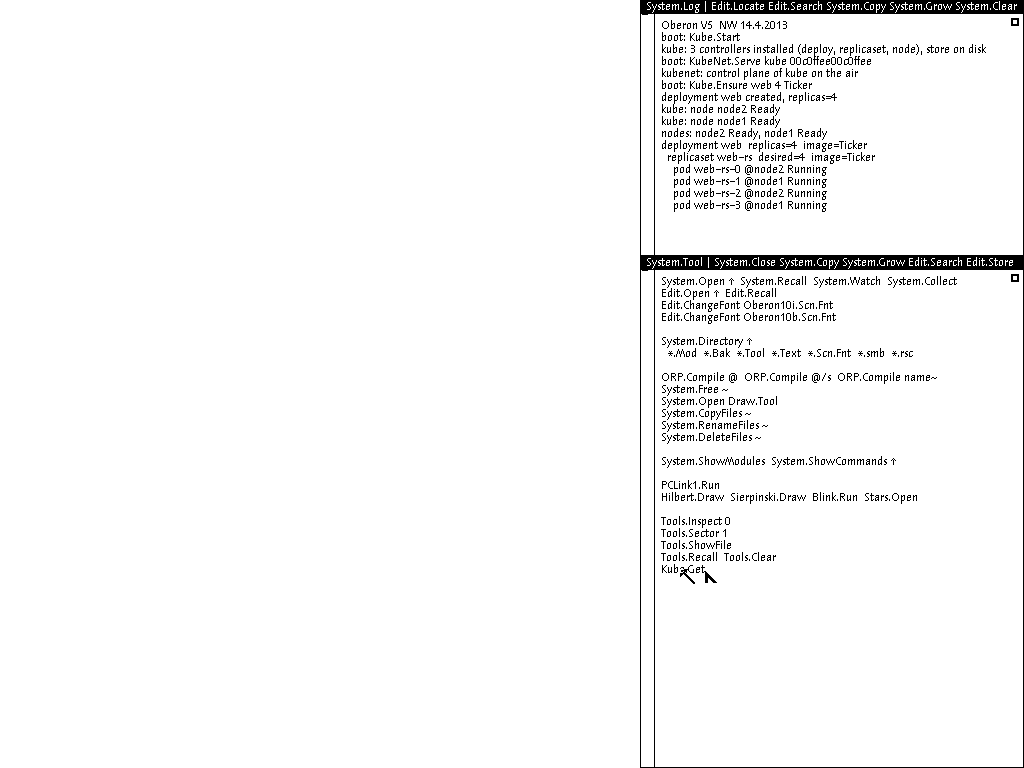
Der Bildschirm der Control Plane. Alles im Log unterhalb der Versionszeile des Systems haben die Befehle beim Start erledigt; niemand hat eine einzige Taste gedrückt
Unterdessen zeigen die Nodes, wie das Kubelet seine Zuweisung empfängt und die Pods des Moduls Ticker startet.
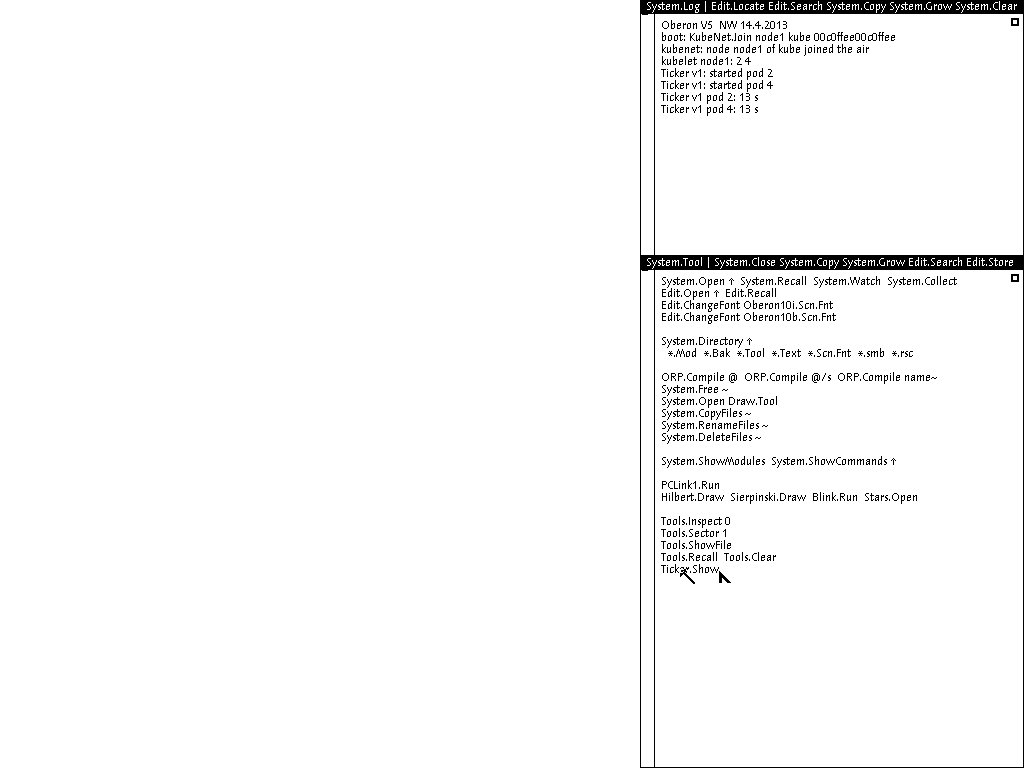
Der Bildschirm von node1. Das Kubelet ist dem Funkkanal beigetreten, hat eine Zuweisung mit zwei Pods empfangen, das Modul Ticker geladen und für jeden Pod dessen Start aufgerufen. Die letzten Zeilen sind die Ausgabe von Ticker.Show: wie viele Sekunden jeder Pod schon lebt
Rechts auf der Seite füllt sich die Cluster-Tabelle. Für jeden Node zeigt sie, wann er zuletzt gehört wurde, welche Pods er nach eigener Aussage betreibt und welche an ihn gebunden sind. Unterscheiden sich diese beiden Spalten, ist der Cluster noch nicht konvergiert, oder etwas ist schiefgegangen.
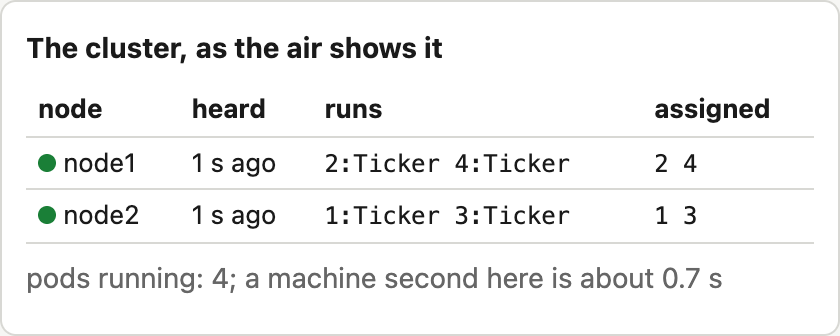
Die aus dem Funkverkehr aufgebaute Cluster-Tabelle. Die Seite fragt Kube nichts; sie hört nur Heartbeats und Zuweisungen mit
2. Neuen Code ausrollen
Drücken Sie den Knopf web 4 Ticker2. Die Seite tippt Kube.Apply web 4 Ticker2 ~ auf der Control Plane und führt es mit einem Mittelklick aus, wie es ein Mensch täte. Kube legt ein neues ReplicaSet an und beginnt, Pods einen nach dem anderen umzuziehen. Die Prüfung lässt den Rollout gelten, wenn jeder Pod das neue Image betreibt, und nur dann, wenn die Zahl der Pods während der ganzen Zeit nie unter vier fiel und nie über fünf stieg. Gezählt wird anhand der Heartbeats, also anhand dessen, was die Nodes tatsächlich betrieben haben.
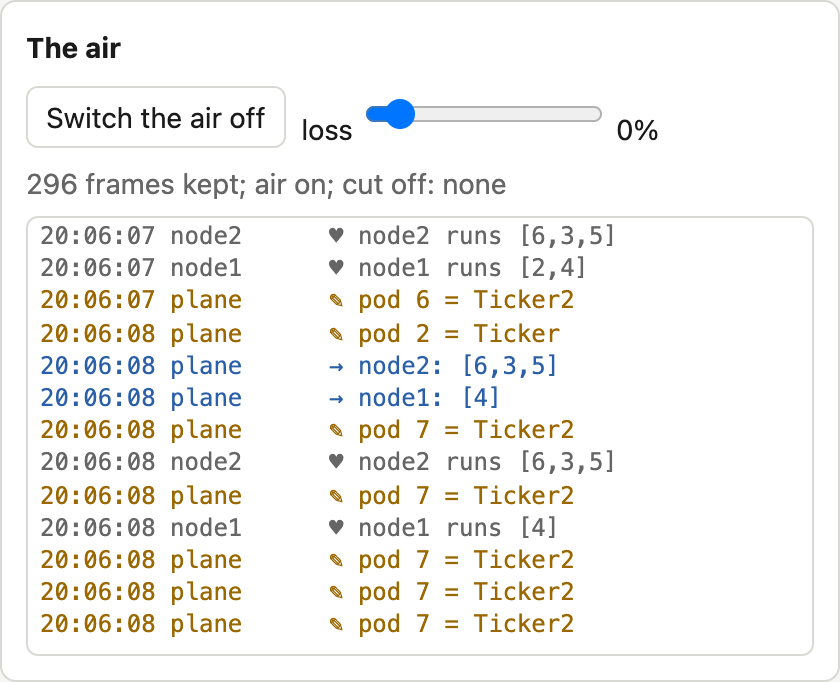
Der Funkkanal während des Rollouts. Die Control Plane sendet die Specs neuer Pods mit dem Image Ticker2, und die Nodes melden in ihren Heartbeats, dass sie sie gestartet haben
Ist der Rollout abgeschlossen, drücken Sie auf einem Node Ticker2.Show, und er zeigt die neue Version beim Zählen. Die ganze Geschichte steht im Log des Nodes: Die Pods von Ticker v1 wurden gestoppt, die von Ticker v2 gestartet, und die neuen Pods haben andere IDs als die alten.
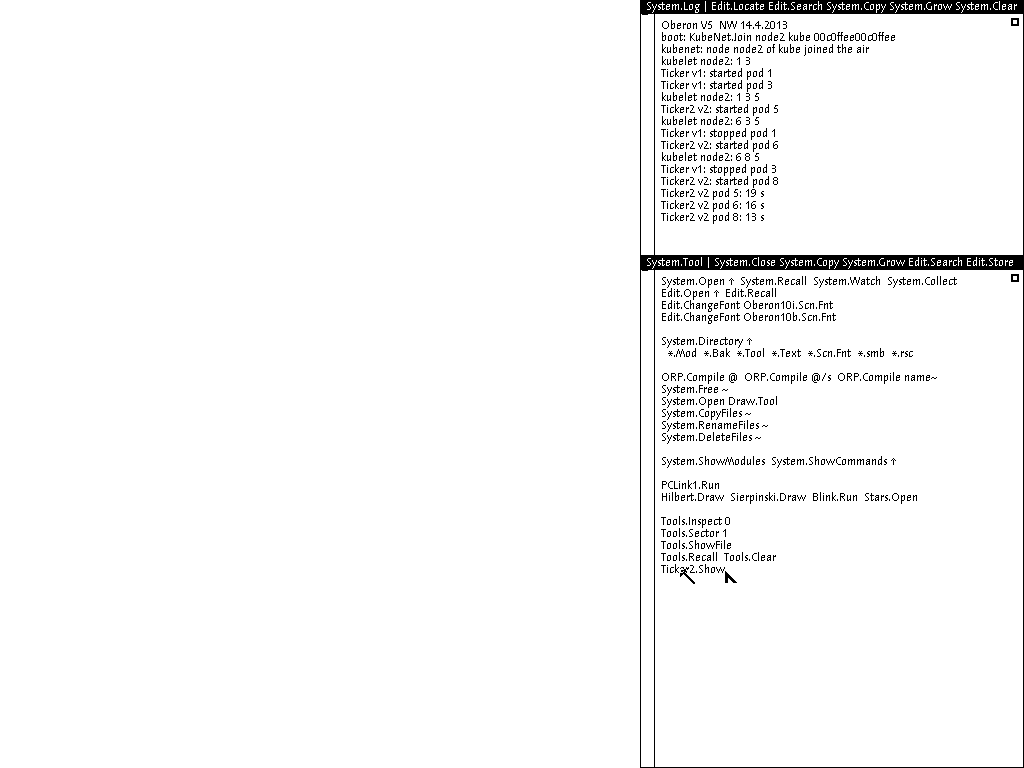
Der Bildschirm eines Nodes nach dem Rollout. Jeder alte Pod hat Stop bekommen, jeder neue Start, und Ticker2.Show listet die neuen Pods auf
3. Ein Node stirbt
Drücken Sie Power off über dem Bildschirm eines Nodes, der Pods betreibt. Sein Bildschirm wird dunkel, seine Heartbeats verstummen, und nach fünf Maschinensekunden markiert die Control Plane den Node als NotReady und verschiebt zwei Sekunden später seine Pods auf den verbliebenen. Schalten Sie den Node wieder ein, bootet er, tritt dem Funkkanal bei und wird Ready, aber seine Pods gibt ihm niemand zurück: Wie der echte Scheduler verschiebt Kube laufende Pods nicht auf einen Node, der später hinzugekommen ist. Neue Pods aus einem Hochskalieren landen dagegen auf ihm, als dem am wenigsten ausgelasteten Node.
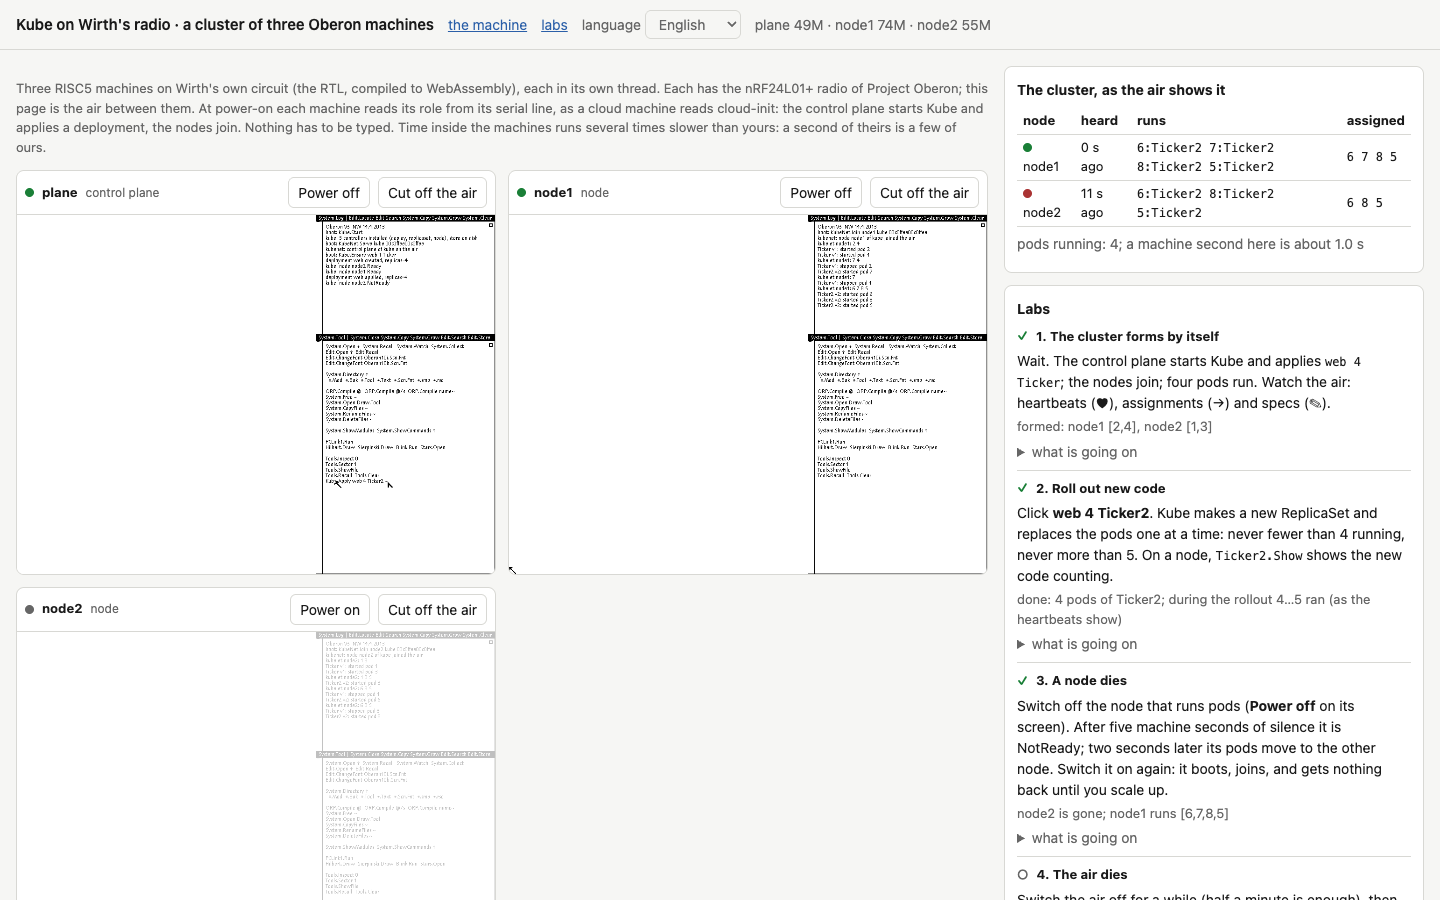
Der Node ist aus. In der Tabelle ist er rot und schon eine Weile nicht mehr gehört worden, und alle Pods laufen bereits auf dem zweiten Node
4. Der Funkkanal stirbt
Drücken Sie Switch the air off und warten Sie eine halbe Minute. Alle Nodes werden gleichzeitig NotReady, aber Kube schließt daraus, dass die Verbindung abgerissen ist und nicht die Nodes ausgefallen sind, und verschiebt nichts. Schalten Sie den Funkkanal wieder ein, und ein paar Sekunden später laufen dieselben Pods auf denselben Nodes. Das Lab gilt nur als bestanden, wenn sich während des Ausfalls und danach keine einzige Zuweisung geändert hat.
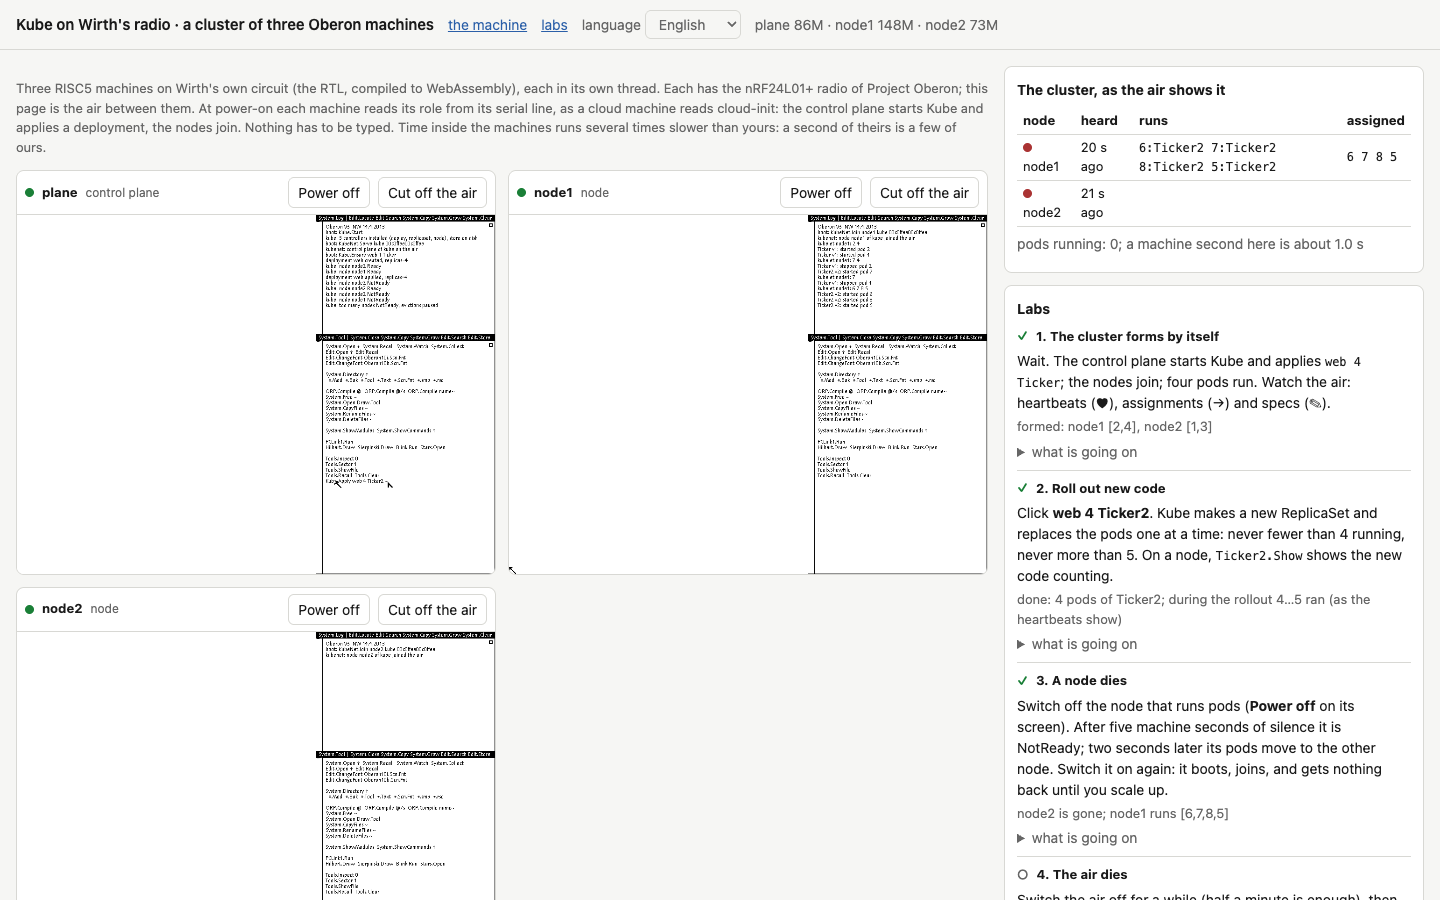
Der Funkkanal ist aus. Beide Nodes sind NotReady, aber die Zuweisungen sind unverändert: Kube hat verstanden, dass die Verbindung abgerissen ist
Am interessantesten ist es hier, unter dem Lab „what is going on“ aufzuklappen und von den 74 Neuzuweisungen zu lesen, die die erste Version in zwanzig Sekunden Ausfall vorgenommen hat. Und wenn Sie mögen, schalten Sie den Funkkanal für ein paar Sekunden ab, kürzer als das Timeout, und sehen Sie, dass überhaupt nichts passiert.
5. Ein Eindringling
Der Abschnitt „An intruder on the air“ hat vier Knöpfe. Jeder schickt im Namen eines Fremden die Zuweisung „nichts betreiben“ an den Node, der Pods betreibt, und zwar direkt nach einer echten Zuweisung der Control Plane, damit die Fälschung das Letzte ist, was der Node gehört hat. Der erste Knopf versieht sie mit dem Tag eines anderen Clusters, der zweite signiert sie mit dem falschen Schlüssel, der dritte spielt eine früher aufgezeichnete echte Zuweisung erneut ein. Der Node ignoriert alle drei und betreibt seine Pods weiter.
Der vierte Knopf signiert die Fälschung mit dem echten Cluster-Schlüssel und einem frischen Zähler. Das ist der Kontrollfall, und der Node gehorcht und stoppt seine Pods. Ohne ihn würde das Lab nichts beweisen: Vielleicht hört der Node ja einfach auf niemanden außer der Control Plane? Eine Sekunde später sendet die Control Plane ihre nächste Zuweisung, und die Pods kommen zurück, weil das Protokoll den vollständigen Zustand trägt und keine Befehle.
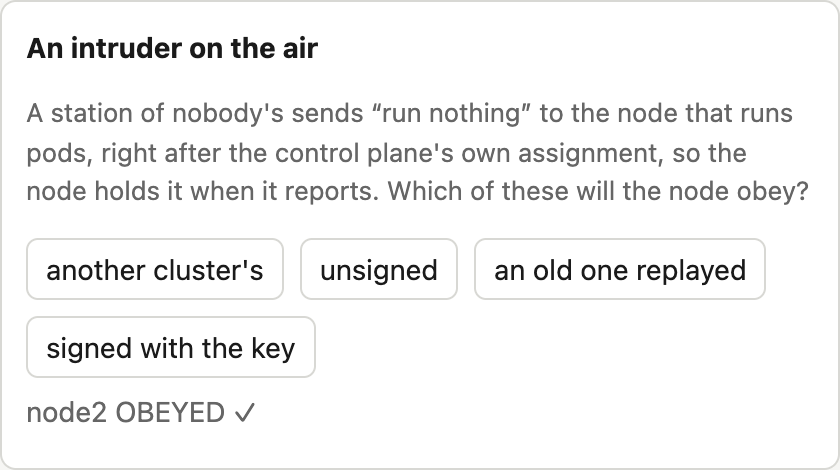
Das Eindringlings-Panel nach dem vierten Versuch: Der Node hat der mit dem Schlüssel signierten Zuweisung gehorcht. Die drei Fälschungen davor hat er ignoriert, und jedes Mal hat die Seite das genau hier angezeigt
Die Fälschungen sind übrigens auch im Funk-Log zu sehen: Die Seite prüft die Signaturen selbst und markiert Nachrichten mit fremdem Tag oder ungültiger Signatur.
6. Die Control Plane startet neu
Schalten Sie die Control Plane ab und ein paar Sekunden später wieder ein. Sie bootet, führt ihre Befehle erneut aus, liest ihren Store von der Festplatte, und kein einziger Pod bewegt sich. Die Nodes haben die ganze Zeit ihre letzte Zuweisung betrieben, und die zurückgekehrte Control Plane hat ihnen ein Timeout Zeit gegeben, sich zu melden, und das haben sie alle getan.
Genau dieses Lab hat den letzten Bug vor der Veröffentlichung gefunden. In den Befehlen beim Start stand zuerst Kube.Apply web 4 Ticker, und nach einem Neustart kehrte das Deployment zu Ticker zurück und machte den Rollout aus dem zweiten Lab rückgängig. Die QEMU-Tests haben das nicht bemerkt, weil sie die Control Plane vor jedem Rollout neu gestartet haben. Hier, wo ein Mensch eine neue Version von Hand ausrollt, ist es richtig, das Getane zu bewahren, deshalb steht in den Befehlen jetzt Kube.Ensure, das ein Deployment nur anlegt, wenn es noch keines gibt. In der Cloud ist dagegen das Bestellformular die Source of Truth, und dort ist Kube.Apply geblieben.
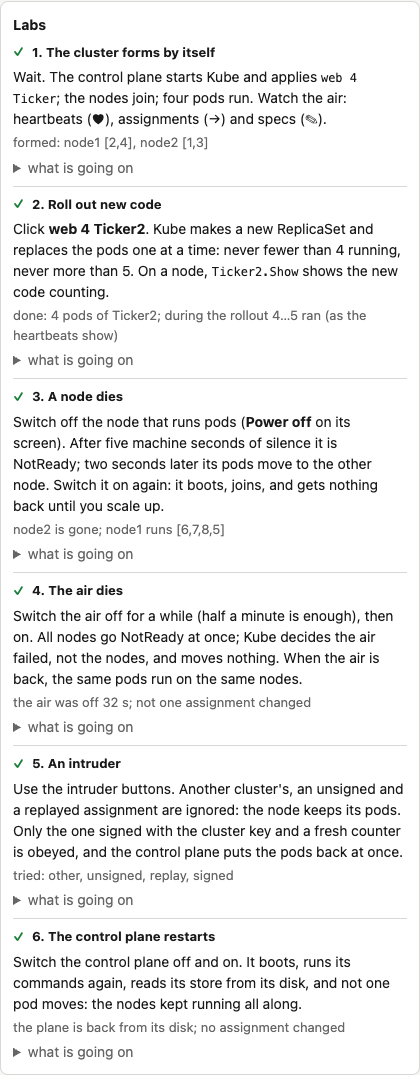
Alle sechs Labs erledigt
Was Sie sonst noch ausprobieren können
Die Seite kann mehr als die Labs. Mit dem Verlust-Schieberegler können Sie den Funkkanal verschlechtern, etwa 30 Prozent der Frames verlieren lassen, und sehen, dass die Pods sich nirgendwohin bewegen. Treiben Sie die Verluste deutlich höher, fallen früher oder später fünf Heartbeats in Folge aus, und Kube hält einen lebenden Node für tot; das ist der Preis eines Timeouts. Cut off the air isoliert eine Maschine, ohne sie abzuschalten, und Sie können zusehen, wie der abgeschnittene Node seine Pods weiter betreibt, obwohl die Control Plane sie bereits anderen übergeben hat. Das ist genau der Fall eines Pods, der an zwei Orten läuft, und Kubernetes lebt damit auf genau dieselbe Weise. Im Befehlsfeld können Sie jedes Oberon-Kommando eingeben, zum Beispiel Kube.Apply api 2 Ticker ~, um ein zweites Deployment anzulegen, oder Sie klicken direkt in den Bildschirm einer Maschine und arbeiten darin von Hand. Die mittlere Maustaste ist dort ein Klick mit Alt.
So probieren Sie es selbst aus
Es gibt vier Wege, vom ganz einfachen, bei dem nichts installiert werden muss, bis zur eigenen Cloud. Alles Folgende ist offen: Der Quellcode liegt im Repository tym83/paleocomputing, Kubes Code im Ordner impl/kube, eine ausführliche Beschreibung mit Messungen in impl/kube/README.md.
Im Browser
Öffnen Sie das Cluster-Lab und warten Sie eine halbe Minute. Installieren müssen Sie nichts: Alles läuft im Tab, der Server liefert nur Dateien aus. Am wohlsten fühlt sich die Seite in einem aktuellen Chrome oder Firefox auf einem Rechner mit mehreren Kernen, denn jede der drei Maschinen belegt einen eigenen Kern. Lassen Sie den Tab im Vordergrund: Im Hintergrund bremst der Browser ihn aus, und der Cluster bleibt zwar nicht stehen, lebt aber spürbar langsamer.
Um dieselbe Seite lokal zu betreiben, klonen Sie das Repository, starten im Ordner impl/web einen beliebigen statischen Server, zum Beispiel python3 -m http.server 8765, und öffnen http://127.0.0.1:8765/kube.html. Und wenn Sie gar keinen Browser brauchen, läuft derselbe Cluster aus drei Maschinen in Node.js mit node impl/web/kube-test.mjs. Er bootet drei Maschinen auf Wirths tatsächlicher Schaltung, wartet, bis sich der Cluster gebildet hat, und prüft anhand des Funkkanals, dass alle Pods laufen und alle Signaturen gültig sind. Die Uhren der Maschinen gehen hier ehrlich, deshalb dauert es rund eine Minute.
In QEMU auf Ihrem Rechner
Sie brauchen Docker, git und make. Bauen Sie zuerst unser Maschinenmodell für QEMU. Der Build läuft in einem Container, sodass die Abhängigkeiten von QEMU Ihrem System fernbleiben, dauert aber rund zehn Minuten:
git clone https://github.com/tym83/paleocomputing
cd paleocomputing
make -C qemu build
Die Systemplatte, auf der Kube, KubeNet, der Lehr-Workload und das Modul für die Befehle beim Start bereits kompiliert liegen, nehmen Sie am einfachsten aus dem veröffentlichten Image. Jede Maschine braucht ihre eigene Kopie der Platte, vergrößert auf acht Megabyte, damit das System Platz hat, seinen Store zu schreiben:
docker create --name payload ghcr.io/tym83/paleocomputing/oberon-run:v0.1.21
docker cp payload:/opt/oberon/payload/prom.bin .
docker cp payload:/opt/oberon/payload/oberon.dsk .
docker rm payload
for m in plane node1 node2; do cp oberon.dsk $m.dsk; truncate -s 8M $m.dsk; done
Als Nächstes brauchen Sie den Funkkanal, also ein Docker-Netzwerk mit einem Relay darin:
docker network create kube-air
docker run -d --name relay --network kube-air -v "$PWD/qemu/radio:/r" \
  qemu-build:risc5 'python3 -u /r/relay.py'
Und schließlich drei Maschinen, jede mit ihren Befehlen beim Start. Die Zeichenkette nach commands= ist genau das, was die Maschine nach dem Booten ausführt, die Befehle durch Semikolons getrennt:
run() {
  docker run -d --name $1 --network kube-air -p 127.0.0.1:$2:5900 \
    -v "$PWD/.qemu-work:/src:ro" -v "$PWD:/w" -w /w qemu-build:risc5 \
    "/src/build/qemu-system-risc5 -machine 'oberon,radio=air,commands=$3' \
     -bios prom.bin -drive if=none,id=sd0,file=$1.dsk,format=raw -vnc :0 \
     -chardev udp,id=air,host=relay,port=7524,localaddr=0.0.0.0,localport=7524"
}
KEY=00c0ffee00c0ffee
run plane 5900 "Kube.Start;KubeNet.Serve kube $KEY;Kube.Apply web 4 Ticker"
run node1 5901 "KubeNet.Join node1 kube $KEY"
run node2 5902 "KubeNet.Join node2 kube $KEY"
Hier steht Kube.Apply und nicht Kube.Ensure wie im Browser-Lab: Release v0.1.21 kennt Kube.Ensure noch nicht. Der Unterschied zeigt sich nur, wenn Sie eine neue Version von Hand ausrollen und die Control Plane neu starten: Mit Kube.Apply kehrt das Deployment zu dem zurück, was die Befehle sagen.
Die Bildschirme der Maschinen liegen auf den VNC-Ports 5900, 5901 und 5902. Das Booten in Software-Emulation dauert bis zu einer Minute, danach zeigt das Log der Control Plane Zeilen über bereite Nodes und die Logs der Nodes Zeilen über gestartete Pods. Die Maus von Oberon hat drei Tasten, und die mittlere führt das Kommando aus, auf das sie zeigt. Kube.Get in einem beliebigen Fenster der Control Plane zeigt also alle Objekte, und Ticker.Show auf einem Node zeigt seine Pods. Um eine neue Version auszurollen, schreiben Sie Kube.Apply web 4 Ticker2 ~ auf der Control Plane und klicken mit der mittleren Taste auf diese Zeile.
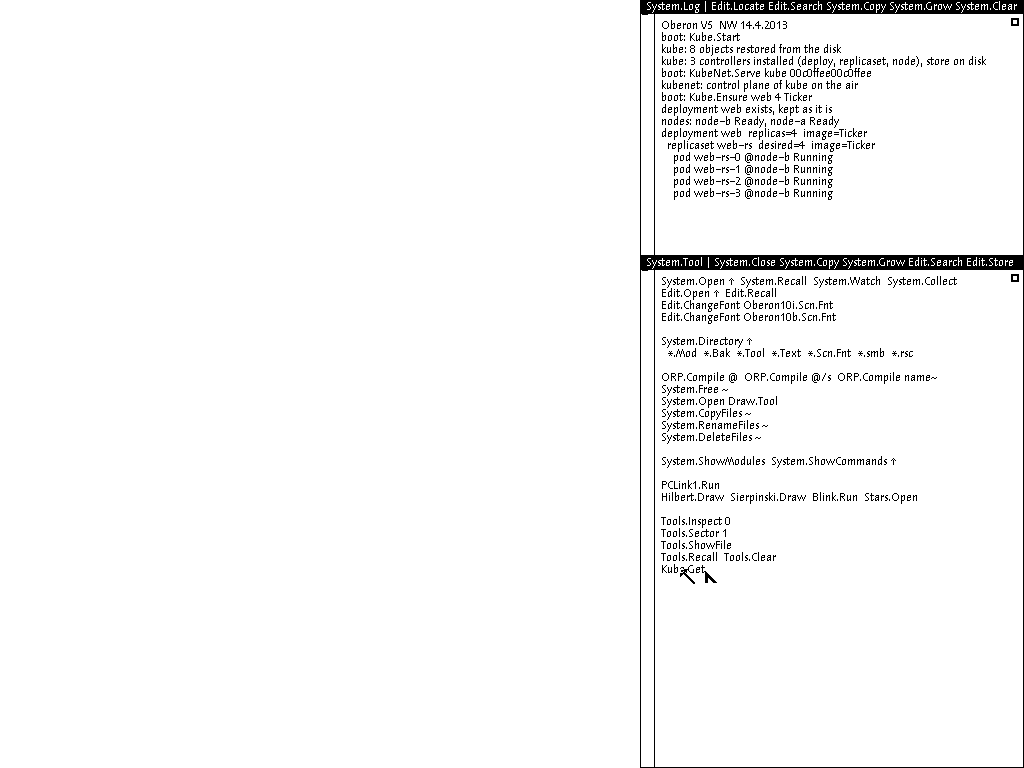
Die Control Plane in QEMU nach einem Neustart. Der Store ist von der Festplatte zurückgekommen, und Kube.Get zeigt dieselben Pods auf demselben Node. Die Aufnahme stammt von einer automatisierten Prüfung, deren Befehle beim Start Kube.Ensure enthalten, weshalb das Log zeigt, dass es das bestehende Deployment in Ruhe gelassen hat
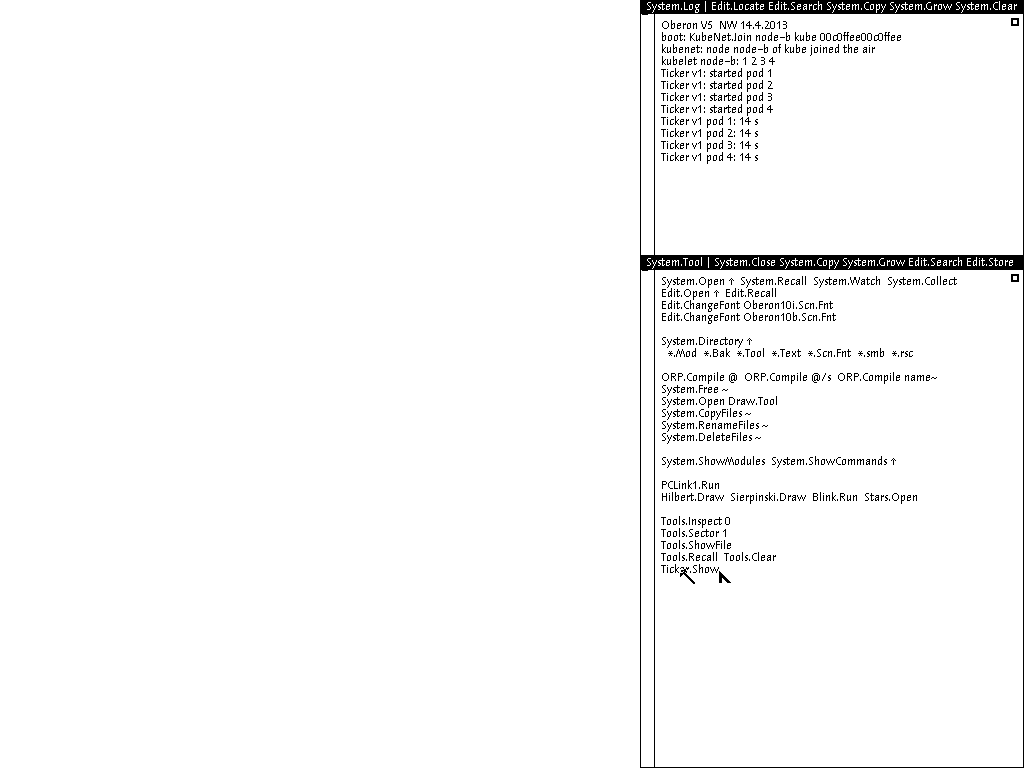
Node node-b in QEMU. Er ist als Erster beigetreten und hat alle vier Pods bekommen: Wie der echte Scheduler verschiebt Kube laufende Pods nicht auf einen Node, der später hinzugekommen ist
Den Funkkanal können Sie von der Seite abhören, so wie es die Tests tun. Der Lauscher tritt dem Relay als weitere Maschine bei, sendet nichts und gibt mit --json jeden Heartbeat und jede Zuweisung aus, samt der Angabe, ob die Signatur gültig ist:
docker run --rm -it --network kube-air -v "$PWD/qemu/radio:/r" \
  qemu-build:risc5 'python3 -u /r/listen.py relay --json --key 00c0ffee00c0ffee'
Und dann können Sie Dinge kaputtmachen. docker stop node2 schaltet einen Node ab, docker stop relay legt den Funkkanal lahm, und docker start bringt beides zurück. Bekommt das Relay nach einem Neustart eine andere Adresse, finden die Maschinen es selbst: Nach einem fehlgeschlagenen Senden löst unser Modell die Adresse erneut über den Namen auf. Im selben Ordner liegt inject.py, das den Eindringling spielen kann.
Die Prüfungen im Repository starten den Cluster genau auf diese Weise, nur automatisch. Nachdem Sie QEMU und die Werkzeuge mit make -C impl tools gebaut haben, können Sie sie selbst ausführen: python3 qemu/test/kube_dr_check.py prüft alle oben besprochenen Ausfälle (ihre Tabelle steht in impl/kube/README.md), python3 qemu/test/kube_boot_check.py prüft, dass sich der Cluster allein aus den Befehlen beim Start bildet, und python3 qemu/test/kube_load_check.py --nodes 4 misst die Last. Diese Prüfungen bauen die Platte aus den Quellen, haben also bereits Kube.Ensure. Bedenken Sie, dass jede Oberon-Maschine einen ganzen Kern belegt, weil ihre Schleife nie untätig ist, und acht Nodes auf einem Laptop eher den Laptop messen als den Cluster.
Wenn Sie fertig sind, entfernen Sie die Container mit docker rm -f plane node1 node2 relay und das Netzwerk mit docker network rm kube-air.
In Ihrem eigenen KubeVirt
Eine Oberon-Maschine läuft auch in einfachem KubeVirt, ohne Cozystack. Sie braucht dafür unser virt-launcher-Image, das die Architektur RISC5 kennt, und die eingeschaltete Fähigkeit von KubeVirt, Hooks an virtuelle Maschinen anzuhängen. Wie das geht, beschreibt ausführlich der Guide, der auch eine Beispiel-VirtualMachine enthält. Ein Cluster braucht drei solcher Maschinen, ein Relay als gewöhnlichen Pod mit einem UDP-Service und die Befehle beim Start in der Annotation der Maschine, die der Hook an QEMU weiterreicht. Genau das erledigt der Cozystack-Katalog für Sie, ohne Cozystack ist es daher am einfachsten, sich anzusehen, was seine Charts im Ordner marketplace anlegen.
In Cozystack
Wenn Sie Cozystack haben, binden Sie unseren Katalog einmalig mit cozypkg ein:
cozypkg tap oci://ghcr.io/tym83/paleocomputing/machines:v0.1.21
cozypkg add paleocomputing.machines
Der Cluster-Administrator muss dafür zwei Dinge tun: das Feature Gate Sidecar in KubeVirt einschalten und unser virt-launcher-Image für Ihre KubeVirt-Version installieren. Die Details stehen auf der Projektseite.
Danach sehen Benutzer im Dashboard einen Abschnitt Paleocomputing, darin unter anderem OberonVM, OberonAir und OberonKube. Ein Kube-Cluster wird mit einem Formular oder einer Ressource bestellt:
apiVersion: apps.cozystack.io/v1alpha1
kind: OberonKube
metadata:
  name: farm
spec:
  nodes: 3
  key: 00c0ffee00c0ffee
  deployments: web 4 Ticker; api 2 Ticker2
Aus dieser Bestellung legt der Katalog einen Funkkanal, eine Control-Plane-Maschine und drei Nodes an, und der Cluster bildet sich von selbst. Den Bildschirm jeder Maschine öffnen Sie mit virtctl vnc unter den eigenen Rechten des Tenants, und die Namen der Maschinen stehen im Dashboard. Source of Truth ist hier das Formular: Seine Deployments werden bei jedem Start der Control Plane angewendet, ein geändertes Formular greift also nach einem Neustart, und eine über VNC vorgenommene Änderung hält nur bis dahin. Wird die Bestellung gelöscht, werden auch alle ihre Bestandteile gelöscht.
Sie können einen Cluster auch von Hand aus einzelnen Maschinen bauen. Legen Sie dann einen OberonAir an und tragen Sie in jeder OberonVM diesen Funkkanal im Feld air ein, die Rolle in kubeRole (plane für die Control Plane und node für die Nodes), den Node-Namen in kubeNode und denselben Schlüssel in kubeKey. Die Deployments der Control Plane gehören ins Feld commands, und der Cluster-Name, falls er nicht kube sein soll, in kubeCluster. Das macht mehr Spaß, wenn Sie zum Beispiel zwei Cluster mit unterschiedlichen Schlüsseln auf einen Funkkanal setzen und zusehen wollen, wie sie einander nicht in die Quere kommen.
Was all das über die Infrastruktur von morgen sagt
Am Anfang habe ich erwähnt, dass dies auch Forschung ist und nicht nur ein Scherz, also will ich versuchen, in Worte zu fassen, was mich der Cluster auf Wirths Funk gelehrt hat. Nicht in dem Sinne, dass alle Kubernetes in Oberon neu schreiben sollten, sondern in dem Sinne, welche Ideen es wert sind, aus diesem kleinen System in ein großes mitgenommen zu werden.
Zustand statt Ereignisse. Innerhalb seiner Control Plane arbeitet Kubernetes schon lange nach dem level-triggered Prinzip, aber zwischen den Komponenten gibt es nach wie vor Events, Watches, Änderungsströme und langlebige Verbindungen. Kube ist weiter gegangen, schlicht weil der Funk ihm keine Wahl ließ: Jede Nachricht trägt den vollständigen Zustand, und das Protokoll braucht keine Bestätigungen, keine Wiederholungen und keine Wiederherstellung nach einer abgebrochenen Verbindung. Ich glaube, dieser Ansatz ist weit breiter anwendbar, als gemeinhin angenommen wird. Überall dort, wo sich der Zustand knapp genug beschreiben lässt und das Netzwerk unzuverlässig ist, ob Edge-Netze, Satellitenverbindungen, Industrienetze oder Cluster aus Tausenden kleiner Geräte, erweist sich ein Protokoll, in dem jede Nachricht für sich steht, als zugleich einfacher und zuverlässiger.
Observability als Eigenschaft des Protokolls. Weil auf dem Funkkanal alles zu hören ist, was der Cluster über sich weiß, musste ich keine Observability bauen. In einem großen System kann man natürlich nicht alles an alle senden, aber schon der Gedanke, dass man die Nachrichten zwischen den Komponenten beobachten sollte und nicht die Berichte der Komponenten über sich selbst, scheint mir interessant. Eine Prüfung, die auf das Verhalten der Nodes schaut und nicht darauf, was die Control Plane über sie denkt, fängt die eigenen Bugs der Control Plane ein, und so wurden fast alle Bugs von Kube gefunden.
Eine Deployment-Einheit in Modulgröße. Ein Oberon-Modul mit Schnittstellenschlüssel kommt dem sehr nahe, wohin sich WebAssembly gerade mit seinem Komponentenmodell bewegt: ein kleines Stück Code mit explizit beschriebener Schnittstelle, das sich schnell laden und vor der Ausführung auf Kompatibilität prüfen lässt. Oberon fehlte die Isolation, und WebAssembly liefert sie ohne separaten Prozess oder Kernel. Bringt man beides zusammen, erhält man einen Pod, der startet wie ein Funktionsaufruf, isoliert ist wie ein Container und dessen Kompatibilität beim Laden geprüft wird, wie in Oberon. Ich halte es für gut möglich, dass die Infrastruktur von morgen auf solchen Prinzipien aufgebaut wird.
Grenzen, die im Code stehen. Alle Obergrenzen von Kube stehen in zwei Konstantenblöcken, und jede hat einen Grund. Auch Kubernetes hat Grenzen, aber sie sind über Flags, Dokumentation und Betriebserfahrung verstreut, und von vielen erfährt man erst, wenn man an sie stößt. Ich wünschte mir, große Systeme würden ihre Grenzen und deren Gründe ehrlicher deklarieren, statt so zu tun, als gäbe es keine.
Einfachheit, die in einen Kopf passt. Kube lässt sich an einem Abend lesen, und das ist keine Zierde, sondern eine Arbeitseigenschaft: Wenn etwas schiefging, fand ich die Ursache, indem ich eine Prozedur las, nicht indem ich Issues in einem Tracker durchging. So wird Kubernetes nie wieder sein, aber neue Systeme lassen sich so entwerfen, dass ihr Kern, der Teil, der für die Hauptidee zuständig ist, überschaubar bleibt und alles andere in Schichten darum herum gebaut wird, die man nicht lesen muss.
Sicherheit schon in der ersten Version. Der Funk hat erzwungen, Nachrichten von Anfang an zu signieren, und das hat rund dreißig Zeilen gekostet. Systeme, die mit einem vertrauenswürdigen Netzwerk begannen und Schutz später nachrüsteten, haben dafür mehr bezahlt. Die Lehre ist banal, aber Oberon illustriert sie gut: Ist die Umgebung vom ersten Tag an feindlich, entsteht die richtige Architektur von selbst.
Und gesondert dazu, was man nicht tun sollte. Kube zeigt deutlich, dass Isolation, Präemption und Rechtetrennung keine überflüssige Komplexität sind, die man um der Einfachheit willen über Bord werfen sollte, sondern das, ohne das ein geteilter Computer nicht möglich ist. Genau hier hat Oberon verloren, und jedes System, das zugleich einfach und geteilt sein will, wird einen Weg finden müssen, Isolation zu bekommen, ohne die Überschaubarkeit zu verlieren. Mir scheint, dass es heute zum ersten Mal passende Bausteine dafür gibt, von WebAssembly bis zu kleinen verifizierbaren Kerneln, und die einzige Frage ist, ob jemand daraus ein System bauen will, das sich wieder vollständig lesen lässt.
Statt eines Fazits
Ich wollte prüfen, ob die Idee von Kubernetes in eine Maschine passt, die von Anfang bis Ende von einem einzigen Menschen entworfen wurde. Sie passt, samt Rollouts, Disaster Recovery, einem signierten Protokoll und einem Store auf der Festplatte, in rund vierzehnhundert Zeilen einer Sprache aus den späten Achtzigern. Unterwegs stellte sich heraus, dass die Grenzen der Maschine nicht nur im Weg standen, sondern auch Lösungen nahelegten, und manche davon erwiesen sich als besser als die, an die wir gewöhnt sind. Klar wurde auch, wo genau solche Systeme an ihre Decke stoßen, und das ist vielleicht der wertvollste Teil, weil es erklärt, warum die Welt einen anderen Weg eingeschlagen hat.
Als Nächstes stehen auf der Liste eine Bereitschaftsprüfung, die der Workload selbst beantwortet, damit ein Rollout wartet, bis neuer Code wirklich bereit und nicht bloß gestartet ist, und eine Möglichkeit, Deployments von außerhalb der Control Plane ohne VNC anzuwenden. Und vielleicht Isolation, zumindest teilweise, um zu sehen, wie viel Einfachheit sie kosten würde.
Das Projekt ist offen. Der Quellcode liegt im Repository; unser Code steht unter der Lizenz Apache-2.0, das QEMU-Maschinenmodell wie QEMU selbst unter der GPL. Das Cluster-Lab finden Sie unter tym83.github.io/paleocomputing/oberon/kube.html, die übrigen Labs der Serie und die Seite zum Cozystack-Katalog auf der Projektseite. Über Cozystack selbst können Sie auf cozystack.io lesen. Ich freue mich, wenn jemand im Lab den Funkkanal nicht für eine halbe Minute, sondern auf eine raffiniertere Weise abschaltet und herausfindet, wo Kube bricht. Solche Funde gab es in dieser Geschichte schon viele, und jeder hat etwas gelehrt.
Im nächsten Teil der Paleocomputing-Serie bauen wir anhand der Spezifikationen und der Ausschreibungsunterlagen Adas Rivalen nach: die Programmiersprachen, die am Wettbewerb des US-Verteidigungsministeriums teilnahmen, ihn aber nicht gewannen.
Häufig gestellte Fragen
Was ist Kube?
Warum Funk statt TCP/IP?
Worin unterscheidet sich Kube von echtem Kubernetes?
Kann ich es ausprobieren, ohne etwas zu installieren?
Wie betreibe ich Kube in Cozystack?
Testen Sie sich: Kubernetes über Wirths Funk
5 questions · ~2 min