Auf einen Blick
- Sprachen: RED (Intermetrics) und GREEN (CII-Honeywell-Bull), die Finalisten des DoD-Wettbewerbs 1977–1979
- Quellen: Das RED-Handbuch und das Rationale (DTIC AD-A219453, iment.com); das Preliminary Ada Reference Manual und das Green Rationale (DTIC-Scans)
- Compiler: Rund 11.000 Zeilen RED und 14.000 Zeilen GREEN; beide übersetzen nach C und reproduzieren sich Byte für Byte selbst
- Programme von 1979: Alle 20 Lösungen der Vertragsaufgaben laufen; keine ließ sich so übersetzen, wie sie gedruckt war
- Systeme: PAIRS (Prozesspaare nach Tandem), THE, Kubernetes auf Mailboxen und ein API-Server als Prozesspaar
- Wo es läuft: Browser (WebAssembly), jeder Rechner mit C-Compiler und make, Cozystack (Image ada-colors-run)
Quelle: impl/ada-colors auf github.com/tym83/paleocomputing
Am 2. Mai 1979 stimmte eine kleine Arbeitsgruppe im US-Verteidigungsministerium für eine Sprache, die noch am selben Abend den Namen Ada erhielt. Die Ausschreibung selbst lief vier Jahre und brachte rund fünfzehn Vorschläge hervor, doch nur zwei schafften es ins Finale, und bis zur Bekanntgabe des Siegers liefen sie unter Codenamen: Green und Red. Green gewann; seine Spezifikation stammte vom französisch-amerikanischen Team um Jean Ichbiah, und genau GREEN wurde als Ada bekannt. Red, die Arbeit der Bostoner Firma Intermetrics, verlor und geriet fast völlig in Vergessenheit. Dabei hatte Red bereits einen funktionierenden Übersetzer, der, wie sich seine Autoren erinnern, pünktlich fertig war. Nach den Vertragsbedingungen wurde er bei der Auswahl nicht berücksichtigt, und außer seinen Autoren hat ihn nie jemand zu Gesicht bekommen.
Eine Serie über Paleocomputing konnte an dieser Ausschreibung natürlich nicht vorbeigehen. Ich wollte die eingereichten Spezifikationen ausgraben und die Programmiersprachen, die es nie gab, endlich bauen, in jeder einen Compiler schreiben, der sich selbst übersetzt, und sehen, was diese Sprachen können. In RED habe ich sogar ein kleines Betriebssystem und so etwas wie eine Kubernetes Control Plane geschrieben. Als Vorbild für das Betriebssystem diente Tandem NonStop, die Rechner, die Banken und Börsen ab 1976 kauften, weil sie nie stillstanden. Eine Variante meiner Control Plane funktioniert wie deren Prozesspaare: ein Primärprozess und ein Backup, ohne etcd und ohne Quorum, und sie übersteht den Tod des API-Servers mitten im Rollout einer Anwendung. Der lehrreichste Fund lag aber nicht im Code: Die siegreiche Ada hat danach Jahrzehnte damit verbracht, langsam und teuer umzusetzen, was das unterlegene RED von Anfang an hatte.
Dies ist der dritte Teil meiner Serie über Paleocomputing. Im ersten habe ich Niklaus Wirths Prozessor im Browser, in QEMU und in Kubernetes zum Laufen gebracht, im zweiten Kubernetes auf Oberon-Maschinen gebaut, die sich per Funk verständigen. Sie müssen sie nicht vorher lesen; diese Geschichte steht ganz für sich.
Mich interessieren die Ideen, die in unterlegenen Technologien steckten: was wir mit ihnen verloren haben und welches Verlorene später in anderen Technologien zurückkam. Ada erwies sich dafür als besonders gutes Beispiel. Ihre Anforderungen wurden über Jahre öffentlich von der ganzen Welt geschrieben, Dutzende Gutachterteams nahmen die Finalisten auseinander, und die ganze Geschichte ist sehr gut dokumentiert.
Der Artikel ist natürlich lang geworden. Zuerst schauen wir kurz, wie diese Ausschreibung zustande kam und warum die Grünen gewannen, dann, was von den unterlegenen Sprachen tatsächlich übrig ist. Danach geht es um beide Sprachen und ihre Compiler und darum, wie ein Programm von 1979 zum ersten Mal lief. Dann folgen die Betriebssysteme, Kubernetes, ein Vergleich von RED mit dem klassischen Ada und ein wenig Spekulation mit Aluhut: was aus unserer Branche hätte werden können, wenn die Experten im Mai 1979 einen anderen Sieger gewählt hätten. Und am Ende gibt es Labs. Die beiden anderen Bewerber, Blue und Yellow, sind ebenfalls gut dokumentiert, schieden aber schon 1978 aus und bekommen deshalb einen eigenen Text.
Alle Quellen, Notizen und Anleitungen liegen im Repository github.com/tym83/paleocomputing unter impl/ada-colors, verfügbar unter der Lizenz Apache 2.0.
Wie das Pentagon eine Sprache auswählte
Mitte der Siebziger hatte das US-Verteidigungsministerium ein Problem, das wir heute einen Technologie-Zoo nennen würden. Eingebettete Software für Flugzeuge, Schiffe und Führungssysteme wurde in Hunderten von Sprachen und Dialekten geschrieben, jeder Auftragnehmer brachte seine eigene mit, und die Pflege dieser ganzen Menagerie kostete Milliarden. Im Januar 1975 wurde die High Order Language Working Group, HOLWG, gegründet, und ihr Vorsitzender, Oberstleutnant William Whitaker von der Air Force, schlug etwas für eine Militärbehörde Seltsames vor: sich zuerst öffentlich auf die Anforderungen an die Sprache zu einigen und erst dann nach der Sprache zu suchen.
Das Schreiben der Anforderungen dauerte mehrere Jahre, und an den Namen der Revisionen sieht man, wie sie immer präziser, ja härter wurden: Strawman im April 1975, dann ein hölzerner Woodenman, ein blecherner Tinman, ein eiserner Ironman und schließlich Steelman im Juni 1978. Tinman ging an tausend Menschen in Industrie und Wissenschaft, und schon früher, zu Strawman, schickten Dijkstra, Hoare und Wirth ihre Kommentare. Dreiundzwanzig existierende Sprachen wurden an den Anforderungen gemessen, und keine passte. Die neue Sprache, so wurde beschlossen, sollte auf einer der drei aufbauen, die am nächsten herankamen: Pascal, PL/I oder Algol 68. Ein amüsantes Detail aus Whitakers Erinnerungen: Auch C war zur Bewertung eingeladen, doch die Bell Labs, wo es entstanden war, baten selbst darum, C von der Liste zu nehmen, und die Gruppe kam der Bitte nach.
Im Frühjahr 1977 wurde der Wettbewerb ausgeschrieben. Vierzehn Vorschläge gingen ein, und im August wurden vier Teams finanziert. Damit die Gutachter nach der Sache und nicht nach Markennamen urteilten, wurden die Entwürfe mit Farben anonymisiert: Green ging an CII-Honeywell-Bull, Red an Intermetrics, Blue an SofTech und Yellow an SRI International. Laut Whitaker hatten die Farben keine verborgene Bedeutung.
Im Februar 1978 gingen die vier vorläufigen Entwürfe zur Bewertung hinaus, und rund achtzig Teams aus militärischen und zivilen Organisationen brüteten über ihnen. Dijkstra verbrachte einen ganzen Monat damit und schrieb zu jedem ein Gutachten. Yellow nannte er ein hoffnungsloses Durcheinander, an Blue bemängelte er ein 160-seitiges Kapitel über Typen, sein Gutachten zu Green schloss er mit einer Wendung über „technische Inkompetenz, vermutlich verstärkt durch Unredlichkeit“, und bei Red gestand er seine Ratlosigkeit: Der Entwurf sei zugleich fortschrittlich und rückständig, und er sehe nicht, wie beides zusammenpasse. Er riet Whitaker, keinen der vier zu wählen. Der Rat wurde nicht befolgt: Im April 1978 kamen Green und Red in die zweite Runde.
Die zweite Runde dauerte ein Jahr. Und hier liegt das Wichtigste für diese Geschichte. Das Team Red warf seinen ersten Entwurf vollständig über Bord. Der Chefdesigner John Nestor schrieb die Sprache von Grund auf neu, sodass es eigentlich zwei rote Sprachen gibt. Die erste, REDL, baute auf Hoares Monitoren auf, Modulen mit gemeinsamen Daten, die immer nur ein Prozess betreten kann, und auf Ereignissen. Die zweite, RED, die es ins Finale schaffte, stützte sich auf Mailboxen und kritische Abschnitte, die der Rundgang durch RED ausführlich behandelt. Geleitet wurde das Projekt Red von Ben Brosgol, entworfen wurde die Sprache von Nestor. Zu den Beratern von Red gehörten Barbara Liskov, William Wulf, Paul Abrahams und Robert Dewar, der spätere Leiter des Projekts GNAT, des freien Ada-Compilers. Am 15. März 1979 gaben beide Teams eine vollständige Spezifikation ab, eine Begründung des Entwurfs, Lösungen derselben zehn Vertragsaufgaben, kleiner Übungen, die das US-Verteidigungsministerium jedem Team stellte, vom Ringpuffer bis zum Scheduler, und einen Testübersetzer.
Der Übersetzer von Red funktionierte. Gebaut hat ihn die Gruppe von Mark Davis, und in den Erinnerungen von Mary Van Deusen, Mitautorin des RED-Handbuchs, erscheint er als kleine Heldentat: ein Compiler für eine Sprache, die sich unter ihm ständig veränderte, pünktlich fertig. Doch im Vertrag der zweiten Runde stand, dass der Übersetzer bei der Auswahl nicht berücksichtigt werde. Whitaker seinerseits erklärt es anders: Beide Übersetzer seien zu unvollständig und womöglich zu langsam gewesen, um die Bewertung zu beeinflussen.
Am 2. Mai 1979 wählte die Gruppe GREEN. Noch am selben Tag verschickte Whitaker dreitausend grüne Postkarten mit der Aufschrift „Green is Ada!“. Die Abstimmung war einstimmig, wie jede Abstimmung, die diese Gruppe je durchführte: Whitaker räumt ein, dass er eine Frage erst dann zur Abstimmung stellte, wenn ohnehin alle einverstanden waren. Van Deusen erzählt von der Seite der Verlierer eine Geschichte über einen jungen Vertreter der Air Force, der angewiesen worden sei, für Green zu stimmen, nichts zu diskutieren und seine Meinung nicht zu ändern. Eine Bestätigung dafür habe ich nicht gefunden, also bleibe es eine historische Anekdote (auch wenn es sehr danach aussieht, wie in solchen Fällen Entscheidungen fallen).
Warum Green gewann, steht in den verfügbaren Dokumenten vor allem zwischen den Zeilen. Die Gutachten zum Finale sind online nicht erhalten. Die Analysen der ersten Runde dagegen haben, wie sich herausstellte, überlebt, und sie bekommen den nächsten Artikel. Tucker Taft, der 1980 zu Intermetrics kam und später den Entwurf von Ada 95 leitete, sagt, Green habe Stabilität und Vollständigkeit früher erreicht als die anderen, und Ichbiah habe es den Gutachtern bemerkenswert gut zu präsentieren gewusst. Van Deusen erinnert sich, das Team Green habe vom ersten Tag an ein sehr feines Gespür für Politik gehabt, und seine erste Designentscheidung sei die Länge der Beschreibung gewesen. Und ein populäres Time-Life-Buch über Programmiersprachen von 1986 enthält den meiner Meinung nach treffendsten Satz von allen, einem der Wettbewerber in den Mund gelegt: Im Finale hätten sich beide Sprachen verändert, Red sei kühner geworden und Green konservativer.
Dann begann eine lange Phase des Feinschliffs. Das Preliminary Ada Reference Manual erschien im Juni 1979 in den SIGPLAN Notices; es wurde auseinandergenommen und überarbeitet, und erst im Februar 1983 erschien der Standard ANSI/MIL-STD-1815A, den wir heute Ada 83 nennen. Die Nummer des Standards ist das Geburtsjahr von Ada Lovelace. Intermetrics begrub die rote Sprache schnell und, so Van Deusen, vollständig. Doch diese Geschichte hat eine Fortsetzung, auf die ich noch zurückkomme.
Was von den Verlierern übrig blieb
Als ich mich dieser Geschichte zum ersten Mal zuwandte, war ich sicher, dass von der roten Sprache fast nichts erhalten ist. Das Gegenteil war der Fall, und das ist im Paleocomputing eine häufige Geschichte: „Nichts ist erhalten“ stimmt fast nie. Was erhalten ist, liegt einfach woanders, als man sucht.
Das RED-Handbuch vom 8. März 1979 hat Mary Van Deusen, seine Mitautorin, zum dreißigsten Jahrestag des Wettbewerbs vollständig als HTML abgetippt. Daneben liegt die komplette Rationale mit der Diskussion verworfener Alternativen, den Lösungen der zehn Vertragsaufgaben und dem Beispiel einer Bibliothekskapsel, wie RED ein Modul nennt. Van Deusen schreibt, nach dem Wettbewerb seien diese Dokumente der Öffentlichkeit nicht zugänglich gewesen. Für 1979 bis 1990 stimmt das, doch im März 1990 ging das Handbuch in das Archiv des Defense Technical Information Center, DTIC, mit dem Vermerk „zur Veröffentlichung freigegeben“, und dort liegt es noch heute unter der Nummer AD-A219453.
Die Syntax von RED ist im Handbuch nicht als Text angegeben, sondern als Diagramme, und jedes davon ist ein Bild. Die dreiundachtzig Sprachdiagramme und zwölf lexikalischen Diagramme mussten nachgezeichnet werden, um eine gewöhnliche Grammatik zu erhalten, und nebenbei waren 105 Codebeispiele abzuschreiben, ebenfalls Bilder. Dabei kamen Widersprüche innerhalb des Handbuchs selbst zutage. So setzt das Diagramm nach einer Sprungmarke für goto ein Semikolon, während die Tabelle der Sonderzeichen und die Beispiele einen Doppelpunkt verwenden.
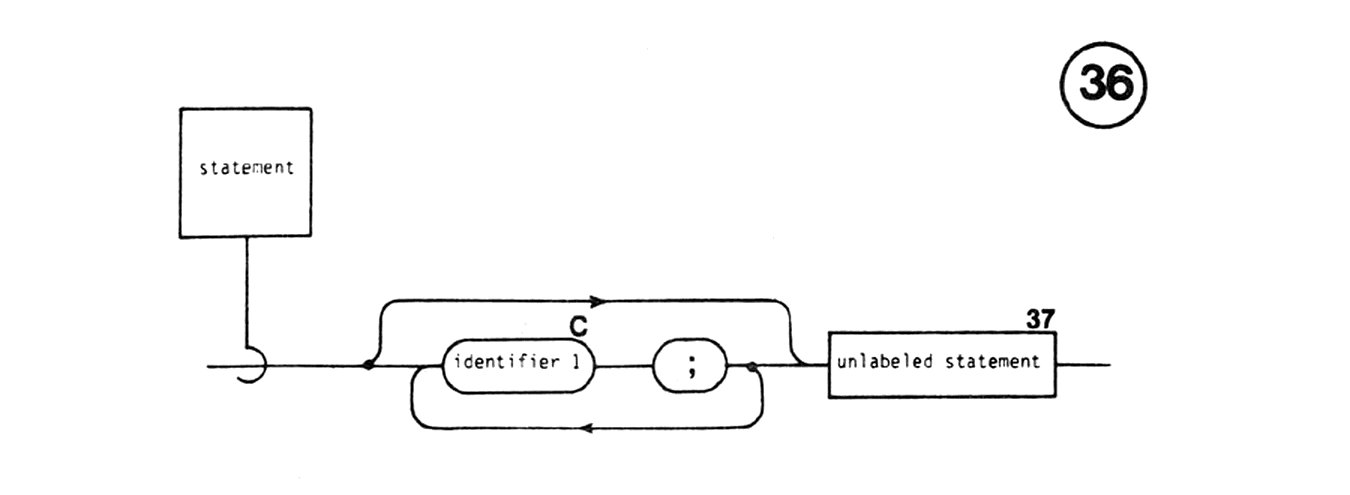
Diagramm 36 aus dem RED-Handbuch (Intermetrics, 1979), nachgedruckt auf iment.com: eine Anweisung mit goto-Marke. Das Diagramm setzt nach dem Bezeichner der Marke ein Semikolon, die Tabelle der Sonderzeichen und die Beispiele verlangen einen Doppelpunkt
Bei der grünen Sprache erwartete ich das Gegenteil: Da Ada (eben jenes GREEN) gewonnen hat, müsste seine Dokumentation leicht zu beschaffen sein. Doch Ada 83 ist überall, während die grüne Sprache in ihrem Stand vom Frühjahr 1979, vor all den Überarbeitungen, schwerer zu finden war. Rettung brachte der DTIC-Spiegel im Internet Archive. Dort fanden sich die „Informal Introduction to the Green Language“, ihre formale Definition, Lösungen derselben Vertragsaufgaben und, am wertvollsten, zwei Dokumente: das „Preliminary Ada Reference Manual“ vom Mai 1979 mit einem beigefügten Schreiben des stellvertretenden Verteidigungsministers vom 14. Mai, das die Wahl der Sprache bekannt gibt, und die vollständige Rationale des Green-Entwurfs vom 15. März 1979, dem Abgabetag der Finalunterlagen. Alles Scans mit schlechter Texterkennung, stellenweise albtraumhaft, aber lesbar.
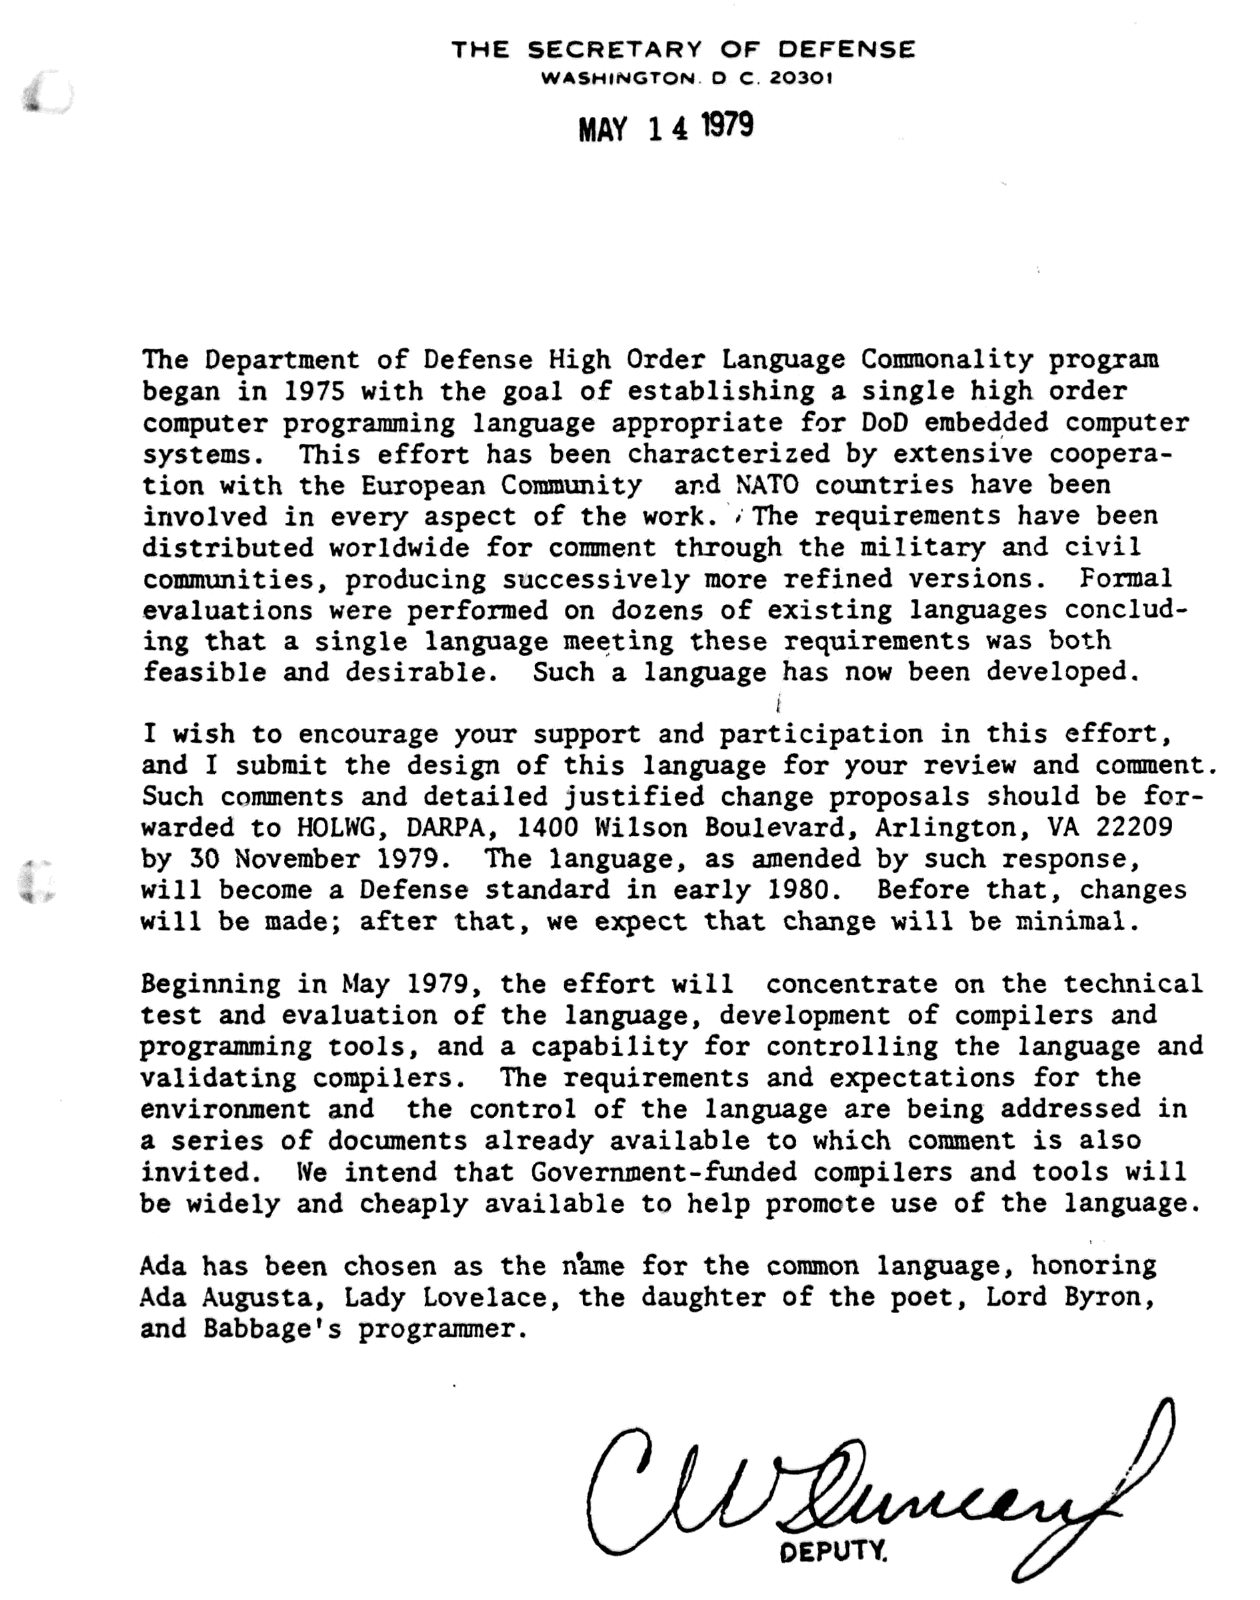
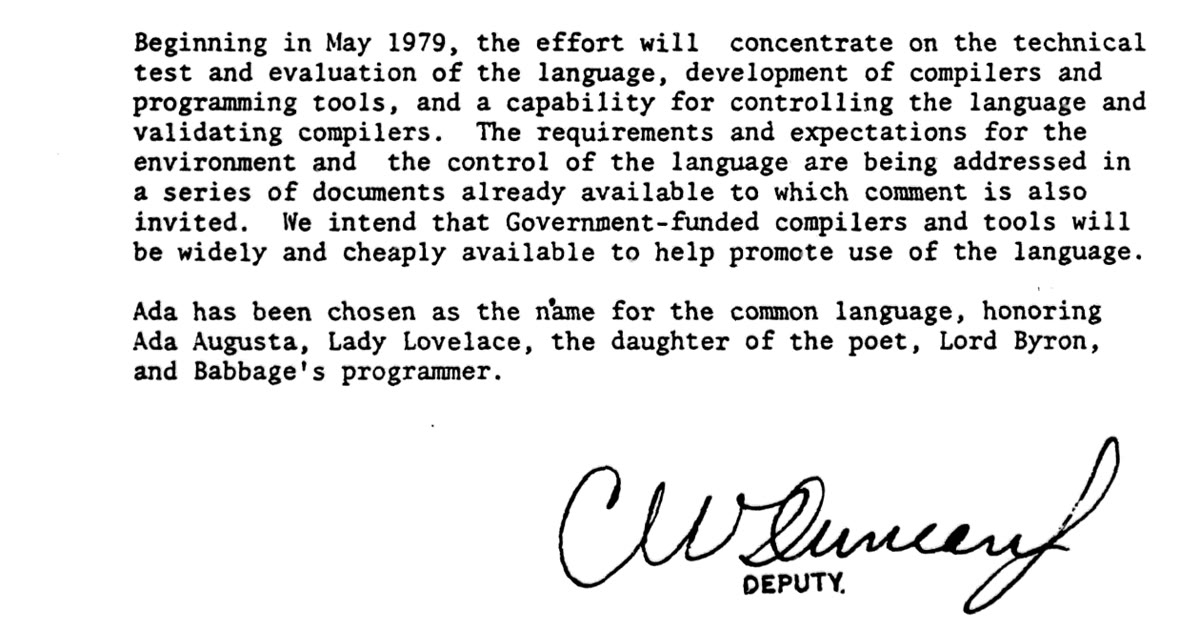
Das Schreiben des stellvertretenden Verteidigungsministers Charles Duncan vom 14. Mai 1979, das das Preliminary Ada Reference Manual eröffnet (DTIC AD-A071761, gescannt im Internet Archive). Kommentare zur Sprache werden bis zum 30. November erbeten, und der letzte Absatz erklärt, nach wem die Sprache benannt ist
Die Vertragsaufgaben verdienen ein eigenes Wort. Das sind zehn Aufgaben, die das US-Verteidigungsministerium jedem Team stellte: Tastaturen über einen gemeinsamen Ringpuffer abfragen, ein Interrupt-System mit vier Prioritätsstufen, ein Dateipaket, dynamische Grafik mit Joysticks, der Schutz einer Datenbank vor gleichzeitigem Zugriff, Prozesssteuerung, adaptives Routing, ein Echtzeit-Scheduler, verteilter Broadcast und das Entpacken bitgenauer Nachrichtenköpfe. Beide Teams lösten dieselben Aufgaben, was uns noch einmal eine einzigartige Gelegenheit gibt, ihre Ansätze zu vergleichen. Auch hier mussten alle zwanzig Lösungen erst erkannt werden, um Quellcode zu erhalten. Das Team Red kam mit 815 Zeilen Code ohne Kommentare aus, das Team Green brauchte 1660, doppelt so viele, und warum, zeige ich, wenn ich zu den Lösungen selbst komme.
Die Entwürfe Blue und Yellow stecken, nach einem Thread auf der Mailingliste systemsafety von 2023 zu urteilen, in einem riesigen Band von 4575 Seiten mit Berichten zur ersten Runde im selben DTIC (und so war es auch; sie kommen im nächsten Artikel dran). Was ich nicht finden konnte, ist der Übersetzer von Red. Von ihm sind nur ein bibliografischer Verweis in einem Artikel von Van Deusen aus dem Jahr 1981 („M. Davis and D. Levine, RED Translator, Intermetrics, Inc., March 1979“) übrig, ein paar Absätze in der Rationale darüber, welche Ein- und Ausgabe er unterstützte und wie die Syntax der Vertragsaufgaben durch ihn geschickt wurde, sowie Van Deusens eigene Erinnerungen. Quellcode ist nicht verfügbar. Den Compiler von 1979 werden wir also nicht sehen, aber wir können einen neuen schreiben, und das ist wohl der erste öffentlich verfügbare RED-Compiler in der gesamten Geschichte der Sprache.
Ein Rundgang durch RED
Auf den ersten Blick sieht RED aus wie ein Pascal, das lange im Fitnessstudio war. Hier ein Stück aus einem Paket für Matrizenrechnung aus dem Anhang der Rationale, deren Beispiele Paul Abrahams, Bruce Knobe, David Levine und andere geschrieben haben. Die Konstanten habe ich eingesetzt und die Kommentare entfernt. Achten Sie vor allem auf die Typen und auf den Funktionskopf:
CAPSULE matrix_vector_package EXPORTS ALL;
CONST maxdim := 100;
ABBREV mvfloat : FLOAT(6, -1.0E99 .. 1.0E99);
ABBREV dim : INT(2 .. maxdim);
TYPE matrix(m : dim, n : dim) : ARRAY INT(1 .. m), INT(1 .. n) OF mvfloat;
TYPE vector(n : dim) : ARRAY INT(1 .. n) OF mvfloat;

FUNC *(READONLY b : matrix, READONLY c : vector) => vector(b.m);
    ASSERT b.n = c.n;
    VAR a : vector(b.m);
    FOR i : INT(1 .. b.m) REPEAT
        a(i) := 0.0;
        FOR j : INT(1 .. b.n) REPEAT
            a(i) := a(i) + b(i,j) * c(j);
        END REPEAT;
    END REPEAT;
    RETURN a;
END FUNC *;
Sieht man genauer hin, stecken in diesen gut fünfzehn Zeilen schon viele Dinge, die der Mainstream erst viel später bekommen sollte. ABBREV ist hier einfach ein Kurzname für einen Subtyp, und FLOAT(6, …) ist ein Gleitkommatyp mit der Genauigkeit 6 und dem angegebenen Wertebereich. Die Dimensionen leben im Typ: vector(n) ist ein Typ mit Parameter, und b.m und c.n lesen sich wie gewöhnliche Attribute eines Werts. Deshalb wird der Ergebnistyp aus den Argumenten berechnet, und die Funktion verspricht schon vorab, vector(b.m) zurückzugeben. Der Operator * ist nach Operandentypen überladen, sodass ein einziges Zeichen Skalar mal Vektor, Matrix mal Skalar, Matrix mal Vektor und Matrix mal Matrix multipliziert. Weiter hinten im Paket ist das Kreuzprodukt als * für vector(3) deklariert: Die Einschränkung der Dimension steht direkt im Parametertyp, und ein Aufruf mit einem Vektor anderer Länge löst eine Subtyp-Ausnahme aus. In Rust würde man diese Einschränkung mit Const Generics ausdrücken, Vector<3>. Und ASSERT steht direkt im Funktionsrumpf, als Teil der Sprache.
Im Folgenden gehe ich durch, was mir an RED am interessantesten vorkam. Fast nichts davon ist eine Zusammenfassung des Reference Manual; es sind die Stellen, über die ich selbst gestolpert bin, als ich (zugegeben, nicht mit eigenen Händen) einen Compiler, ein Betriebssystem und Kubernetes in RED geschrieben habe.
Kapseln und abstrakte Typen ohne das Wort private
Ein Modul heißt in RED Kapsel. Eine Kapsel exportiert genau das, was nach EXPORTS aufgezählt ist, und wer sie benutzt, öffnet sich das Benötigte ausdrücklich mit EXPOSE:
CAPSULE stackcap EXPORTS stack, init, push, pop;
   TYPE stack : RECORD[top : INT(0 .. 100), elem : ARRAY INT(1 .. 100) OF INT];
   ...
END CAPSULE stackcap;

EXPOSE stack, push, pop FROM stackcap;
In Ada entsteht ein abstrakter Typ durch einen private-Teil in der Paketspezifikation. RED hat keinen solchen Teil, dafür aber eine Regel, die ich anfangs überlesen habe und über die ich später selbst gefallen bin: Wenn eine Kapsel einen Typ exportiert, exportiert sie weder den Zugriff auf seine Komponenten noch die Zuweisung. Von außen kann man eine Variable vom Typ stack deklarieren und an push übergeben, aber s.top := 0 kann man nicht schreiben. Wer das Innere freigeben will, exportiert am einfachsten alles mit EXPORTS ALL. Ob ein Typ abstrakt ist, hängt also nicht davon ab, wie er deklariert ist, sondern davon, was die Kapsel nach außen lässt. Wenn man darüber nachdenkt, ist das ein sehr ehrliches Modell: Der Typ selbst verbirgt nichts, das Verbergen übernimmt die Modulgrenze.
Geschlossene Gültigkeitsbereiche und IMPORTS
Diese Regel habe ich im Arbeitsalltag am stärksten gespürt. Eine Prozedur ist in RED ein geschlossener Gültigkeitsbereich: Sie sieht Konstanten, Typen und andere Prozeduren von außen, aber keine Variablen, es sei denn, sie importiert sie ausdrücklich:
VAR hits : INT := 0;
VAR limit : INT := 3;
PROC hit IMPORTS hits, READONLY limit;
   IF hits < limit THEN
      hits := hits + 1;
   END IF;
END PROC hit;
Eine Variable lässt sich auch nur lesend importieren, wie limit im Beispiel. Im Grunde ist das dasselbe wie die Capture-Liste einer Lambda in C++, nur verpflichtend und für jede Prozedur. Für eine Sprache, in der riesige Programme über Jahrzehnte gepflegt werden sollen, ist das vernünftig: Der Prozedurkopf zeigt auf einen Blick, welchen Zustand sie durcheinanderbringen kann.
Daneben steht die Unterscheidung zwischen normalen und abnormalen Funktionen. Eine normale Funktion hängt nur von ihren Argumenten ab, und der Übersetzer darf einen wiederholten Aufruf mit denselben Argumenten weglassen. Hängt das Ergebnis einer Funktion von mehr als ihren Argumenten ab, liest sie etwa äußere Variablen, muss man ABNORMAL davorschreiben. Eine normale Funktion darf Seiteneffekte nur auf die Variablen ihrer eigenen Kapsel haben, etwa einen Aufrufzähler oder eine Memo-Tabelle. Das Wort klingt komisch, aber die Idee liegt nahe an dem, was wir heute reine Funktionen nennen.
Parameter werden auf vier Arten übergeben: CONST kopiert, READONLY übergibt per Referenz ohne Recht auf Änderung, VAR übergibt per Referenz mit Änderung, und OUT ist eine lokale Variable, deren Wert nur dann an den aktuellen Parameter geht, wenn die Prozedur normal endet. Endet die Prozedur mit einer Ausnahme, bleibt die Variable des Aufrufers, wie sie war. Warum man Lesen per Kopie und Lesen per Referenz unterscheiden muss, erklärt das Team Red eigens. Die Wahl dem Übersetzer zu überlassen, geht nicht, weil dann das Verhalten des Programms von der Implementierung abhängt, und immer zu kopieren ist für große Objekte zu teuer.
Eine Schleife beim Namen verlassen
Eine Kleinigkeit, die mir sehr gefallen hat. EXIT muss in RED die Anweisung nennen, die es verlässt:
outer WHILE p /= NIL REPEAT
   ...
   IF found THEN
      EXIT outer;
   END IF;
END REPEAT outer;
Die Begründung ist einfach: Würde EXIT die nächstgelegene Schleife verlassen, dann würde eine neue Schleife, die man darum legt, die Bedeutung des Programms stillschweigend ändern. Und diesen Bug habe ich in Produktion öfter gesehen, als mir lieb ist.
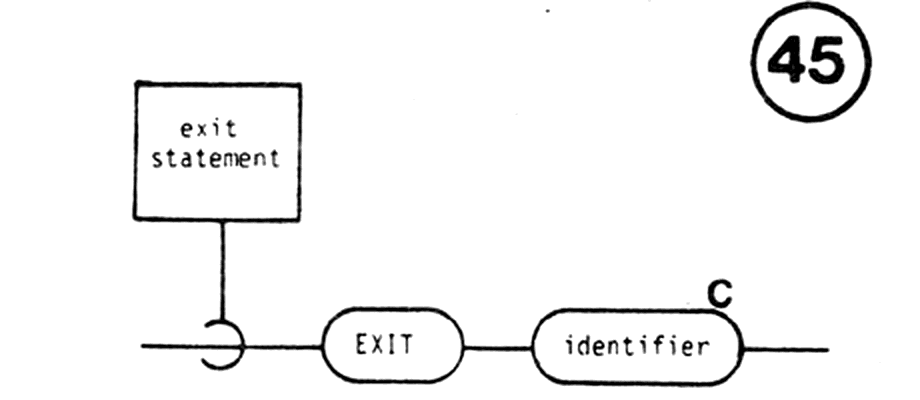
Diagramm 45 aus dem RED-Handbuch (Intermetrics, 1979), nachgedruckt auf iment.com. Auf EXIT folgt ein Bezeichner, und das Diagramm lässt keinen Weg daran vorbei
Mailboxen, WAIT und REGION
Der wichtigste Unterschied zwischen RED und dem späteren Ada ist die Nebenläufigkeit, und hier ist ein kurzer Exkurs für alle angebracht, die nie Ada geschrieben haben (also fast alle). In beiden Sprachen ist ein Task das, was wir heute einen Thread nennen würden: ein Teil des Programms, der gleichzeitig mit dem Rest läuft. Die Frage ist, wie sich Tasks untereinander verständigen. In Ada, und davor in der grünen Sprache, ist der einzige Weg das Rendezvous. Ein Server-Task hat Entries, die wie Prozeduren aussehen. Der Client ruft ein Entry auf und wartet; der Server erreicht in seinem eigenen Code eine accept-Anweisung für dieses Entry und wartet ebenfalls; und wenn beide da sind, läuft der Rumpf von accept, danach geht jeder seiner Wege. Es ist ein Treffen, daher der Name. RED funktioniert anders: Tasks tauschen Nachrichten über Mailboxen aus, also Nachrichtenwarteschlangen zwischen Tasks innerhalb des Programms, und schützen gemeinsame Daten mit kritischen Abschnitten:
VAR m : MAILBOX[msg](3);         % a mailbox for three messages
VAR d : DATA_LOCK;

TASK consumer IMPORTS m;
   VAR data : msg;
   WHILE TRUE REPEAT
      RECEIVE(m, data);
      ...
   END REPEAT;
END TASK consumer;

VAR c : ACT;
CREATE consumer NAMED c;
SEND(m, x);

REGION d DO
   shared := shared + 1;          % the lock is released however the body ends
END REGION;
Eine Mailbox ist typisiert und begrenzt. Eine Mailbox der Größe null ist ein Rendezvous: Der Sender kann dem Empfänger nicht vorauseilen. Die Anweisung WAIT wartet auf das erste von mehreren Ereignissen: einen Empfang aus irgendeiner Mailbox, ein Senden oder einen Timeout:
WAIT
   WHEN RECEIVE(ports(me), m) => handle(m);
   WHEN DELAY(35) => take_over;
END WAIT;
Und hier ein Detail, das zeigt, wie sorgfältig die Sprache durchdacht war. Ein SEND an eine Mailbox der Größe null ist innerhalb von WAIT verboten: Der Versuch löst die Ausnahme X_EMPTY_MAILBOX aus. Warum? Weil sonst Tasks, die gegenseitig darauf warten, an Mailboxen der Größe null zu senden, in ein zirkuläres Warten geraten könnten, und das ließe sich nur durch globales Scheduling verhindern.
REGION erwirbt eine Datensperre und gibt sie garantiert wieder frei, egal wie der Rumpf endet: normal, durch eine Ausnahme, durch das Verlassen einer Schleife oder durch die Rückkehr aus einer Prozedur. Ada 83 hat nichts Vergleichbares; dort baut man eine Sperre als eigenen Task mit zwei Entries, und schlägt zwischen Erwerb und Freigabe eine Ausnahme zu, bleibt die Sperre einfach belegt. Mehr dazu im Kapitel über Ada 83.
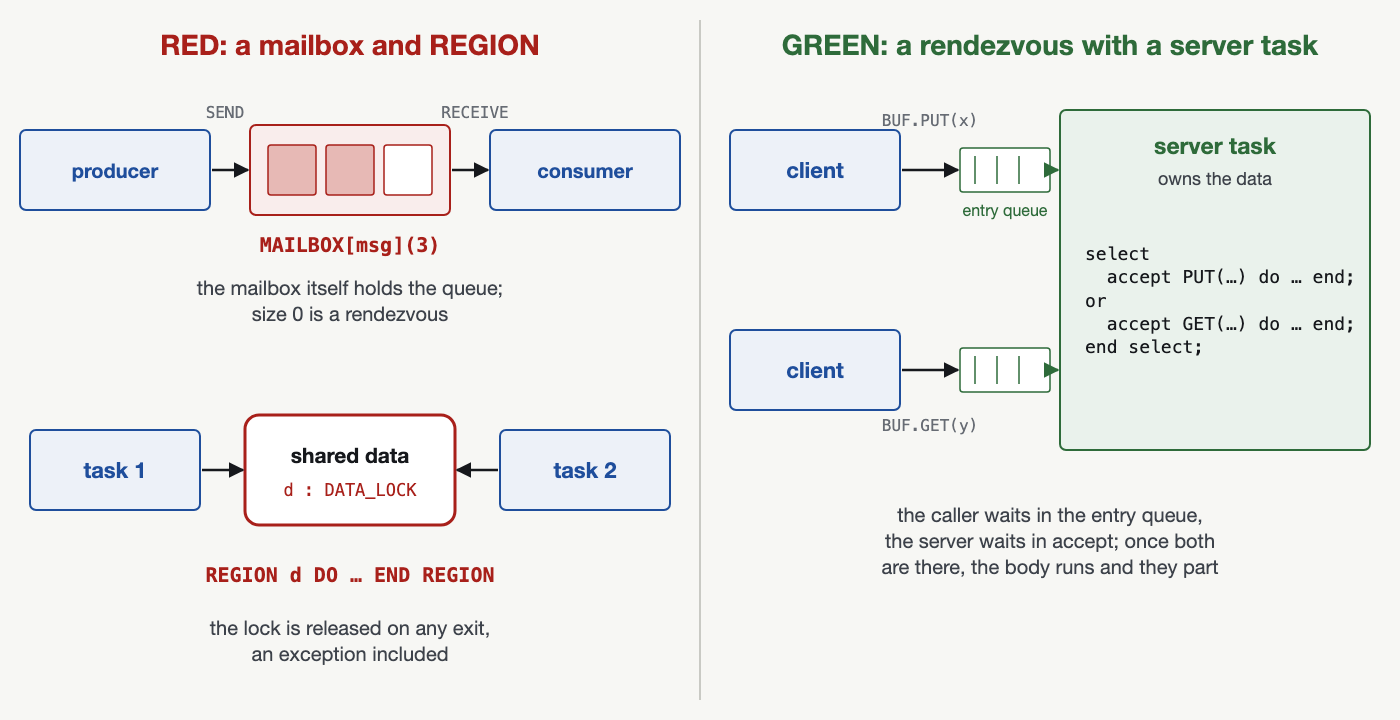
Links RED: Tasks übergeben Nachrichten über eine Mailbox, und REGION schützt die gemeinsamen Daten. Rechts die grüne Sprache: Ein Client ruft ein Entry des Server-Tasks auf und wartet in dessen Warteschlange, bis der Server sein accept erreicht
Tasks werden ausdrücklich gestartet, CREATE task NAMED variable, und jede Aktivierung, also jede laufende Instanz eines Tasks, hat einen Namen, eine Variable vom Typ ACT. Man kann sie fragen, ob der Task noch lebt, seine Priorität ändern, auf sein Ende warten oder ihn mit EXTERMINATE töten. Der eingebaute Scheduler arbeitet mit Prioritäten: Die höhere Priorität kommt zuerst, und unter Gleichen kommt zuerst dran, wer am längsten gewartet hat.
Ein eigener Scheduler
Auf der untersten Ebene der Sprache, in Kapitel vierzehn des Reference Manual, kann ein Systemprogrammierer seinen eigenen Scheduler und eigene Synchronisationsmechanismen beschreiben. Die Sprache gibt ihm die Operationen des Schedulers selbst in die Hand: eine Aktivierung anhalten, auf ein Signal warten, ein Codestück kritisch machen, sodass es weder verdrängt noch mittendrin getötet wird. Die eingebauten Mailboxen, Sperren und WAIT sind im selben Kapitel als Sonderfälle beschrieben, die aus diesen Operationen gebaut sind. Das Manual zeigt das an Beispielen: ein Round-Robin-Scheduler, Hoares Monitore auf Basis von Datensperren und sogar MAILBOX selbst, in der Sprache definiert. Alle diese Beispiele laufen in meinem Compiler. Allein die Tatsache, dass eine Sprache von 1979 den Benutzer einlud, Scheduler zu schreiben, statt nur den mitgelieferten zu benutzen, sagt mir viel.
Generics, die sich selbst instanziieren
Eine generische Prozedur sieht in RED so aus:
GENERIC t : TYPE NEEDS :=(t, t)
   PROC swap(VAR a, b : t);
      CONST c := a;
      a := b;
      b := c;
   END PROC swap;

swap(i, j);       % i and j are integers
swap(s, r);       % s and r are strings
Achten Sie darauf, was fehlt. In Ada muss man zuerst ausdrücklich eine Instanz erzeugen, procedure SWAP_INT is new SWAP(INTEGER), und erst dann kann man sie aufrufen. RED hat überhaupt keine Instanziierungsanweisung: Jeder Aufruf teilt dem Übersetzer mit, welche Typen er braucht, und der Übersetzer erzeugt eine Instanz oder verwendet eine bereits vorhandene wieder. C++-Templates sollten später genauso funktionieren, aber RED tat das elf Jahre früher. Und die Liste NEEDS legt fest, welche Operationen der Typparameter haben muss, in diesem Fall die Zuweisung. C++ bekam dasselbe erst 2020, unter dem Namen Concepts. Mein Compiler prüft diese Liste bei jedem Aufruf: Fehlt die Operation oder hat sie den falschen Kopf, wird der Aufruf nicht übersetzt. Generische Parameter können Typen, Werte, Prozeduren und sogar Tasks sein. In seiner Lösung der Vertragsaufgabe zum Scheduler übergibt das Team Red einen Task als Parameter an einen generischen Wrapper-Task, der ihn nach Zeitplan startet.
Strings, die sich ihre Länge merken
Der String-Typ in RED ist STRING[ASCII](n), und die Länge ist für jedes Objekt fest. Einen String anderer Länge kann man nicht zuweisen; das ist ein Subtypfehler. Für Text variabler Länge braucht man einen Zeigertyp mit Parameter, und das Reference Manual enthält genau so ein Beispiel, eine Symboltabelle:
TYPE sym : PTR (len : INT) STRING[ASCII](len);
ALLOC s.syms(s.top) PTR (val.LEN) := val;
ALLOC erzeugt einen dynamischen String von genau der Länge von val und legt einen Zeiger darauf in die Tabelle. Der in RED geschriebene RED-Compiler speichert alle seine Namen und Stücke des erzeugten Codes genau so. ASCII-Zeichen sind in RED benannte Aufzählungswerte, ein kleines a schreibt man also 'L_A, einen Apostroph 'APOS, ein doppeltes Anführungszeichen 'QUOTE. Ein doppeltes Anführungszeichen in ein String-Literal zu setzen, ist überhaupt nicht möglich; man kann den String nur mit dem Zeichen verketten. Im Quelltext eines Compilers, der C erzeugt, sieht das ziemlich lustig aus: "rt_str(" & q & "TRUE" & q & ", 4)", wobei q eine Funktion ist, die ein doppeltes Anführungszeichen zurückgibt.
Ein FREE, das sich weigert freizugeben
Eine letzte Sache im Reference Manual hat mich beeindruckt. Eine dynamische Variable lebt in RED so lange, wie es Referenzen auf sie gibt, die Sprache setzt also standardmäßig Garbage Collection voraus. Für alle, die sich das nicht leisten können, gibt es aber eine Prozedur FREE. Gibt es noch andere Zeiger auf die freizugebende Variable, gibt FREE sie nicht frei, sondern löst die Ausnahme X_FREE aus. Ein hängender Zeiger wird damit konstruktionsbedingt unmöglich, und die Prüfung selbst lässt sich abschalten, wenn sie zu teuer ist, mit einem Pragma, einer Anweisung an den Übersetzer, die im Programm selbst steht: PRAG(SUPPRESS(X_FREE)). Das alles 1979. In meinem Compiler durchläuft FREE den gesamten erreichbaren Speicher, bevor es irgendetwas freigibt: die globalen Variablen, die Frames der laufenden Unterprogramme jedes Tasks, die dynamischen Variablen und die Puffer der Mailboxen. Ein Programm, das FREE nicht benutzt, zahlt dafür nichts.
GREEN im Frühjahr 1979
Die grüne Sprache hält man leicht für ein frühes Ada, und das ist ein Fehler. Das vorläufige Handbuch vom Mai 1979 beschreibt eine Sprache, die in ihrer Syntax wie Ada 83 aussieht und stellenweise doch etwas ganz anderes ist. Parallel zum roten habe ich einen Compiler für die grüne Sprache in der grünen Sprache selbst gebaut, und dabei zeigte die Sprache nicht weniger Charakter als RED.
Wie ein Programm aussieht
Hier eines der Programme aus der „Informal Introduction“, ein Wechselgeldzähler:
restricted (TEXT_IO)
procedure COUNT_YOUR_CHANGE is
   use TEXT_IO;
   ...
begin
   ...
      PUT("CHANGE IS $");
      PUT(NUM_DOLLARS);
      PUT(".");
      PUT(NUM_CENTS);
   end if;
end;
Mehrere Unterschiede zu Ada 83 fallen sofort auf. Statt with TEXT_IO steht vor der Prozedur restricted(TEXT_IO): In der grünen Sprache ist jede Übersetzungseinheit standardmäßig auf eine leere Sichtbarkeitsliste beschränkt, und Bibliotheken müssen ausdrücklich genannt werden. Mehr noch, restricted kann vor jedem verschachtelten Modul stehen, nicht nur vor einer Übersetzungseinheit, und schränkt dann dessen Sichtbarkeit innerhalb des Programms ein. Eine Prozedur PUT_LINE gibt es nicht: Ein Zeilenumbruch ist die String-Konstante NEWLINE, ausgegeben mit PUT(NEWLINE). Dieses Programm gibt übrigens gar keinen aus. Und nach den E/A-Regeln von 1979 bekommt jede Zahl, die irgendwo außer am Zeilenanfang ausgegeben wird, ein Leerzeichen vorangestellt. Dieses Programm aus der Einführung gibt also buchstäblich CHANGE IS $ 2. 53 aus, und damals hat das offenbar niemand bemerkt.
Viele Kleinigkeiten verraten eine andere Sprache. Ein Zeichenliteral ist in der grünen Sprache einfach ein String der Länge eins, "A"; einen Apostroph für Zeichen gibt es nicht, er ist nur für Attribute da. Die Positionen von Aufzählungswerten zählen ab eins, sodass CHARACTER'ORD("A") 66 ergibt statt der vertrauten 65. Die Operation mod übernimmt das Vorzeichen des linken Operanden, verhält sich also wie rem in Ada 83. Einen Operator abs gibt es nicht, nur eine Funktion ABS, und die Zweige eines case stehen nach of, nicht nach is. Bei benannter Zuordnung steht der Parametermodus direkt an der Aufrufstelle: F := x übergibt einen Wert hinein, F =: v holt das Ergebnis heraus, und F :=: v tut beides. Die Sprache hatte außerdem eine Anweisung assert, die es nicht in Ada 83 schaffen sollte. Eine ausführliche Tabelle der Unterschiede zu Ada 83 steht in den Projektnotizen.
Regeln, um die herum der Compiler gebaut werden musste
Am meisten bin ich über die Regeln zur Reinheit von Funktionen in Abschnitt 6.5 des Handbuchs gestolpert. Eine Funktion darf in der grünen Sprache nichts Nichtlokalem zuweisen, keine Objekte über Zeiger ändern, keinen Speicher anlegen und, da Ein- und Ausgabe sowie externe Prozeduren Seiteneffekte haben können, diese auch nicht aufrufen. Für Generatoren wie „gib mir die nächste eindeutige Nummer“ gibt es wertliefernde Prozeduren: procedure NEXT return INTEGER. Sie dürfen globale Variablen ändern, aber man darf sie nur in einer Zuweisung, einer Initialisierung oder einem Prozeduraufruf aufrufen, und nur dort, wo diese globalen Variablen nicht sichtbar sind.
Das klingt nach einer Formalie, bis man anfängt, einen Parser zu schreiben. Ein gewöhnlicher Parser mit rekursivem Abstieg funktioniert so: Es gibt einen Zeiger auf das aktuelle Token, und eine Funktion EXPR parst einen Ausdruck, rückt dabei den Zeiger vor und gibt einen Baum zurück. In der grünen Sprache geht das nicht. Eine Funktion darf den Zeiger nicht vorrücken, und eine wertliefernde Prozedur darf nicht dort aufgerufen werden, wo der Zeiger sichtbar ist, und in einem Parser ist er überall sichtbar. Deshalb ist der gesamte Parser des Compilers für die grüne Sprache als Prozeduren mit Out-Parametern geschrieben: EXPR(X) statt X := EXPR. Der Compiler prüft diese Regeln auch bei fremden Programmen, und sein eigener Quelltext besteht die Prüfung.
Interessanterweise hat die rote Sprache dieselbe Frage umgekehrt gelöst. In RED ist eine Funktion standardmäßig normal: Ihr Ergebnis hängt nur von den Argumenten ab, und ändern darf sie nur die verborgenen Variablen ihrer eigenen Kapsel. Braucht sie mehr, wird sie als ABNORMAL gekennzeichnet, und dann ist alles erlaubt. Die grüne Sprache verbietet, die rote verlangt eine Kennzeichnung. Für militärischen Code ist der grüne Ansatz wohl sicherer. Für jemanden, der einen Compiler schreibt, ist der rote bequemer, und ich vermute, dass genau solche Stellen in den Jahren 1980–1983 aufgeweicht wurden.
Tasks ohne Task-Typen
Die Nebenläufigkeit beruht in der grünen Sprache wie in Ada auf dem Rendezvous, sieht aber anders aus. Task-Typen gibt es nicht. Man deklariert einen Task, und er existiert, startet aber erst mit einer Anweisung initiate. Läuft der Task bereits, löst ein zweites initiate die Ausnahme INITIATE_ERROR aus, während ein beendeter Task erneut gestartet werden kann, mit frischen Variablen. Für viele gleichartige Tasks gibt es Familien: task KUBELET(INTEGER range 1 .. 3) (so heißen die Node-Agenten meines Kubernetes; zu ihnen kommen wir noch), und in seinem Rumpf erfährt ein Task seine Nummer über KUBELET'INDEX. Auch Entry-Familien gibt es.
Ein select hat Wächter, Verzögerungen und else, aber keine Alternative terminate, und sind alle Alternativen geschlossen und gibt es kein else, wird SELECT_ERROR ausgelöst. Die aufrufende Seite kann überhaupt nicht zwischen Wartevorgängen wählen: kein zeitlich begrenzter Aufruf, kein bedingter Aufruf. Eine Ausnahme, die im Rumpf eines accept ausgelöst wird, erreicht beide Seiten des Rendezvous. Und die einzige Ausnahme, die man in einem anderen Task auslösen kann, heißt FAILURE: raise T.FAILURE. Einen anderen Task kann man dagegen mit einer Anweisung abort töten. Es gibt fünfzehn vordefinierte Ausnahmen, und jede benennt ihr Problem unverblümt: RANGE_ERROR, INDEX_ERROR, ACCESS_ERROR, DIVIDE_ERROR, NO_VALUE_ERROR für das Lesen einer nicht initialisierten Variable oder für eine Funktion, die ohne return endet, und so weiter. Ada 83 ersetzte sie durch fünf allgemeinere: Von den grünen Namen überlebte nur TASKING_ERROR, der Rest ging in CONSTRAINT_ERROR, NUMERIC_ERROR, PROGRAM_ERROR und STORAGE_ERROR auf.
Ein Compiler, der sich selbst übersetzt
Mein Ziel war folgendes: Jede Sprache sollte einen Compiler bekommen, der in ihr selbst geschrieben ist. Das ist nicht bloß eine schöne Tradition. Ein Compiler ist ein ehrlicher Test für eine Sprache: Wenn sich in ihr einige tausend Zeilen Parser, Symboltabellen, Typprüfung und Codeerzeugung schreiben lassen, taugt die Sprache für echte Arbeit, und all ihre unbequemen Stellen kommen von selbst ans Licht.
Eine gemeinsame Laufzeitumgebung und vorhersagbare Zeit
Beide Compiler übersetzen ein Programm nach C und binden es gegen eine gemeinsame Laufzeitumgebung, ebenfalls in C geschrieben. Sie umfasst rund achteinhalbtausend Zeilen und enthält alles, was die Sprachen zur Laufzeit brauchen: Strings, Exceptions, geprüfte Arithmetik, Ein- und Ausgabe, die Mailboxen und Locks von RED, die Rendezvous der grünen Sprache und den Task-Scheduler.
Beim Scheduler habe ich eine Sache gemacht, die sich vielfach ausgezahlt hat. Jeder Task in der Runtime ist ein Thread des Betriebssystems, aber die Threads reichen einander einen Staffelstab weiter, und zu jedem Zeitpunkt läuft genau einer von ihnen. Dadurch gelten die Scheduling-Regeln von RED buchstabengetreu: Es läuft der Task mit der höchsten Priorität, unter Gleichen kommt derjenige zuerst, der am längsten gewartet hat, und ein Task, der mit höherer Priorität bereit wird, verdrängt den aktuellen.
Die Zeit ist virtuell: Wenn alle Tasks auf etwas warten, springt die Uhr direkt zum nächsten Aufwachzeitpunkt. Und wenn niemand mehr aufzuwecken ist, hängt die Runtime nicht, sondern meldet, dass alle Tasks blockiert sind. Im Ergebnis gibt jedes Programm bei jedem Lauf exakt dasselbe aus, selbst mit einem Dutzend Tasks, Timeouts und abgebrochenen Tasks, und die erwartete Ausgabe kann direkt neben dem Test liegen. Für ein Betriebssystem und für Kubernetes, bei denen es ja gerade darum geht, was passiert, wenn im ungünstigsten Moment etwas ausfällt, ist das unbezahlbar: Der ungünstige Moment lässt sich auf die Millisekunde genau reproduzieren.
Bootstrapping
Einen in der Sprache X geschriebenen Compiler kann man erst bauen, wenn man einen Compiler für die Sprache X hat. Der klassische Ausweg ist Bootstrapping. Zuerst habe ich einen kleinen Seed-Übersetzer in Python geschrieben, rund zweitausendzweihundertfünfzig Zeilen samt Parser, der nur die Teilmenge von RED versteht, in der der eigentliche Compiler geschrieben werden sollte. Dann habe ich den eigentlichen Compiler, redc, in dieser Teilmenge geschrieben und durch den Python-Seed geschickt. Der so entstandene Compiler übersetzte seinen eigenen Quellcode, das Ergebnis übersetzte sich noch einmal selbst, und die beiden C-Dateien stimmten Byte für Byte überein. Das ist der Fixpunkt: Der Compiler reproduziert sich selbst, und der Seed wird nicht mehr gebraucht.
Ab hier wird es spannend. Von nun an braucht man zum Bauen nur noch die C-Datei, die der jeweils neueste Compiler aus seinem eigenen Quellcode erzeugt hat, und die Sprache wächst im Compiler selbst. Jedes neue Feature wird so in redc eingebaut, dass redc es selbst noch nicht verwendet; dann wird der Compiler mit der vorigen Version gebaut, der Fixpunkt geprüft, und erst danach darf das neue Feature im eigenen Quellcode verwendet werden. So kamen zuerst Kapseln, Exporte und verschachtelte Prozeduren mit statischen Links, also Zeigern auf den Frame der umgebenden Prozedur, dann Multitasking, dann Überladung mit parametrisierten Typen, zweidimensionale Arrays und Mengen und schließlich Generics. Heute umfasst der Compiler rund elftausend Zeilen RED und übersetzt sich selbst in ein paar Zehntelsekunden. Bei jeder Änderung baut die CI ihn zweimal aus dieser C-Datei neu und vergleicht die Ergebnisse, und ein eigenes Build-Target wiederholt den allerersten Schritt aus dem Python-Seed, sodass sich die Kette von Grund auf überprüfen lässt.
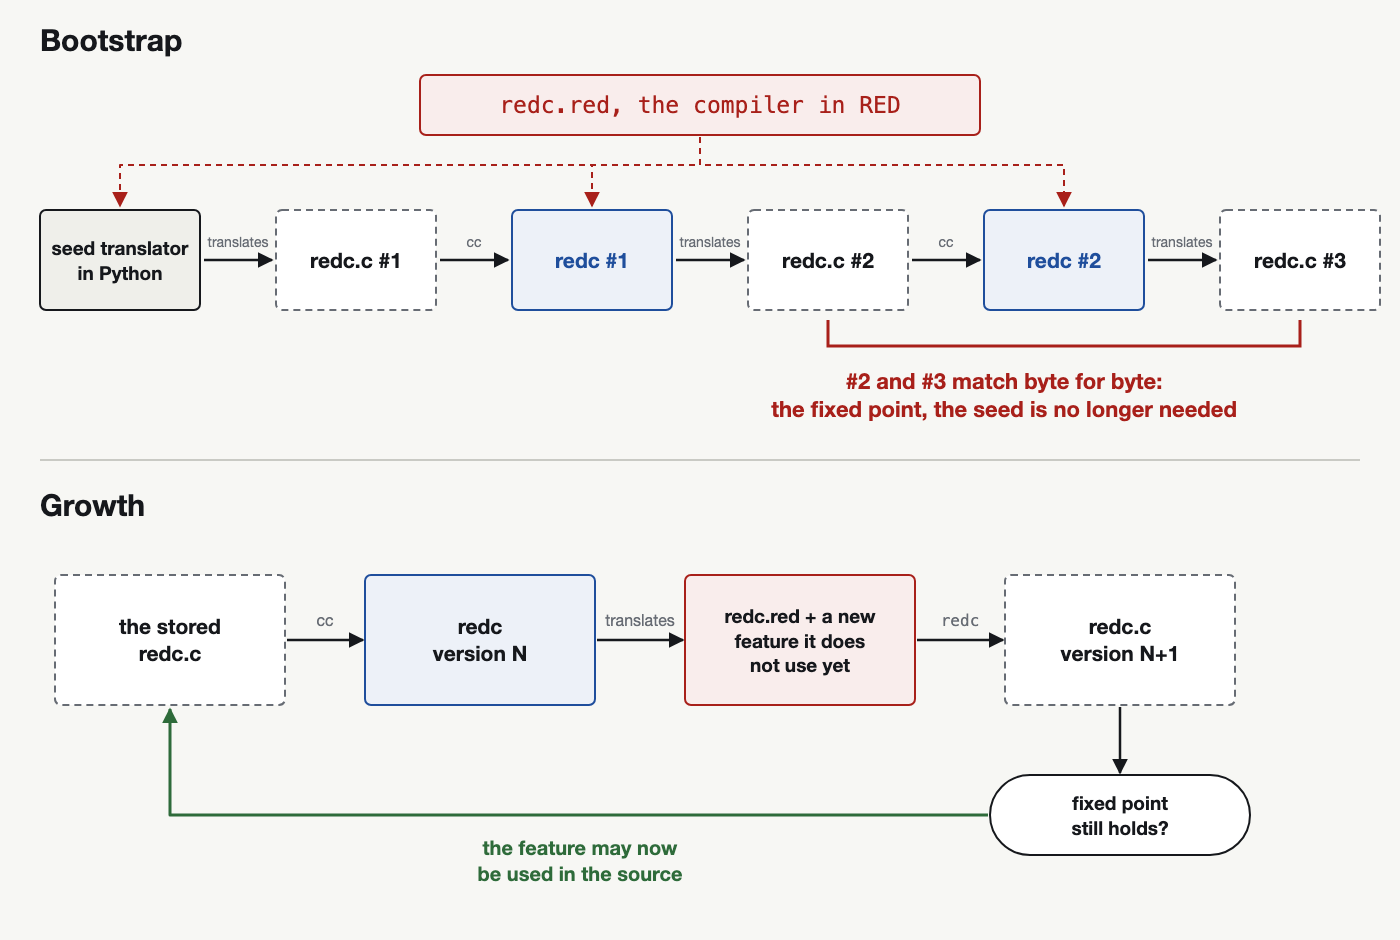
Bootstrapping und Wachstum des RED-Compilers. Der Python-Seed wird nur für den ersten Schritt gebraucht; danach wird jede Version von redc von der vorigen aus der gespeicherten C-Datei gebaut
Was RED mit mir gemacht hat
Elftausend Zeilen in einer Sprache von 1979 sind ein guter Test nicht nur für die Sprache, sondern auch für die eigene Geduld. Hier die Stellen, an denen das eigensinnige RED mit mir gestritten hat, und fast jedes Mal hatte es bei näherem Hinsehen recht.
Als Allererstes weigerte sich der Compiler, seinen eigenen Lexer zu übersetzen. Die Funktion upper machte aus einem Kleinbuchstaben über POS(c) einen Großbuchstaben, und der Compiler bestand darauf, dass POS keine Funktion sei. Wie sich herausstellte, hatte ich eine globale Variable pos, die Position im Tokenstrom, und Namen in RED unterscheiden nicht zwischen Groß- und Kleinschreibung, während eingebaute Namen wie POS nicht reserviert sind. Nach allen Regeln hatte meine Variable die eingebaute Funktion verdeckt. Später passierte dasselbe mit einem Record-Feld len, das mit dem Attribut .LEN kollidierte, und noch später mit einem Task-Parameter me, der die eingebaute Funktion ME verdeckte, die die aktuelle Aktivierung zurückgibt. Jedes Mal tat der Compiler genau das, was ihm die Sichtbarkeitsregeln vorschrieben, und jedes Mal brauchte ich etwa fünf Minuten, um es ihm zu glauben.
RED hat mehr als fünfzig reservierte Wörter, und einige davon sind unerwartet: TO, CAPSULE, EXPOSE, IMPORTS, READONLY, SUBTYPE. Die Parser-Funktion subtype musste umbenannt werden, und die Variable to im Client des Betriebssystems wurde zu dest.
RED hat keine leere Anweisung. Ein leerer Rumpf wird als Leerraum geschrieben, deshalb ist WHEN DELAY(20) => ; ein Syntaxfehler. Später fand ich genau diese Konstruktion, DELAY_UNTIL (next) => ;, in der Lösung der achten Vertragsaufgabe, obwohl der Übersetzer laut dem Team Red die Syntax aller Lösungen geprüft hatte. Offenbar war der Übersetzer von 1979 an dieser Stelle nachsichtiger als die Diagramme.
Strings fester Länge haben mich anfangs geärgert, erwiesen sich aber als überhaupt nicht schlimm: Alles, was länger lebt als ein einzelner Ausdruck, hält der Compiler in Zeiger-Strings, und innerhalb der Ausdrücke selbst werden Strings nach Herzenslust verkettet.
Die wertvollste Regel aber ist IMPORTS. Solange der Compiler sie nicht prüfte, schrieb ich natürlich, wie es gerade kam. Als die Prüfung dazukam, musste ich den Quellcode des Compilers einmal von oben bis unten durchgehen und in jedem Unterprogramm deklarieren, was es importiert. Für die kleinen Funktionen des Lexers und der Tabellen sind das echte Listen, aber für den Parser und den Codegenerator, die fast den gesamten globalen Zustand anfassen, habe ich IMPORTS ALL geschrieben, und diese Unterprogramme machten am Ende vier Fünftel des Codes aus. Auch das ist ehrlich: Der Kopf sagt auf einen Blick, dass die Prozedur alles anfasst. Und in den kleineren Programmen, dem Betriebssystem und Kubernetes, wo die Listen kurz und echt sind, hat dieselbe Prüfung zweimal meine Fehler gefunden. Zum ersten Mal habe ich verstanden, warum die Autoren der Sprachanforderungen so hartnäckig auf expliziten Schnittstellen bestanden.
Und dasselbe für Green
Der Compiler der grünen Sprache, geschrieben in der grünen Sprache selbst, umfasst rund vierzehntausend Zeilen und wurde genauso gebootstrappt: ein Python-Seed, eine erste Version, ein Fixpunkt und dann Wachstum, wobei jede Version von der vorigen gebaut wird. Er kennt Packages mit privaten Typen und eine Überladung, die Parametertypen, deren Modi, deren Namen und den Ergebnistyp unterscheidet, und Operatoren lassen sich als Funktionsnamen deklarieren. Er hat alle fünfzehn Exceptions, Tasks mit initiate, Rendezvous und select, Task- und Entry-Familien sowie Generics mit expliziter Instanziierung über is new. Die Programme aus der Einführung von 1979 laufen, und in zweien davon fand der Compiler Fehler, die er nicht durchlassen kann: einen Vergleich der reellen Variablen NET_RISE mit einem ganzzahligen Literal und die Oktalzahl 8#8060, die die Ziffer 8 enthält.
Was die Compiler in fremdem Code gefunden haben, verdient ein eigenes Kapitel.
Ein Programm von 1979 läuft zum ersten Mal
Der berührendste Moment des ganzen Projekts kam, als der Compiler Überladung und parametrisierte Typen gelernt hatte. Ich nahm das Matrixarithmetik-Paket aus dem RED Rationale, dasselbe, das ich am Anfang des Kapitels über die Sprache zitiert habe, ergänzte ein kleines Hauptprogramm und versuchte, es zu übersetzen.
Es klappte nicht. Der Compiler blieb an der Zeile ASSERT b.n : c.m hängen, einem Doppelpunkt statt eines Gleichheitszeichens. Das Paket enthielt vier solcher Zusicherungen. Als Nächstes stellte sich heraus, dass die Kapsel unter dem Namen matrix_vector_package beginnt und unter dem Namen vector_matrix_package endet. Dann, dass die Transpositionsfunktion die Variablen m und n verwendet, die nirgends in ihr deklariert sind, und dass zwei weitere Prozeduren in der Matrixinversion auf dasselbe undeklarierte m verweisen. Dann tauchten a(p.r), x(k.p) und x(i.p) auf, mit einem Punkt statt eines Kommas. Und der Typ integer, den es in RED nicht gibt. Obendrein kam Rauschen aus der HTML-Abschrift selbst hinzu: verirrte Backticks, geschützte Leerzeichen, eine Ziffer Eins statt eines Buchstabens in 1NT, SUBT_1OOP und realmultip1y.
Jeden dieser Fehler hätte jeder RED-Übersetzer sofort abgelehnt. Das Beispiel im Rationale wurde also nie kompiliert; es wurde einfach abgetippt und in den Druck gegeben. Überraschend ist das nicht: Der Übersetzer des Teams Red wurde zum selben Termin fertig wie die Dokumente, und offenbar blieb keine Zeit, die Beispiele aus dem Anhang durch ihn laufen zu lassen (dass sie den Wettbewerb ernst nahmen, war klar). Jede Korrektur habe ich in einer eigenen Datei festgehalten, eine Zeile mit Erklärung pro Korrektur, damit man sieht, dass ich nur korrigiert habe, was der Übersetzer nicht akzeptierte.
Nach diesen Korrekturen ließ sich das Paket übersetzen und lief. Es multiplizierte eine Matrix mit einem Vektor, berechnete Kreuz- und Skalarprodukt, die Determinante und die inverse Matrix durch Potenzieren mit minus eins, und jede Zahl stimmte mit meinen Handrechnungen überein:
005.000 004.000 006.000
000.000 009.000 -006.000
dot = 031.000
det = 008.000
001.000 002.000 003.000
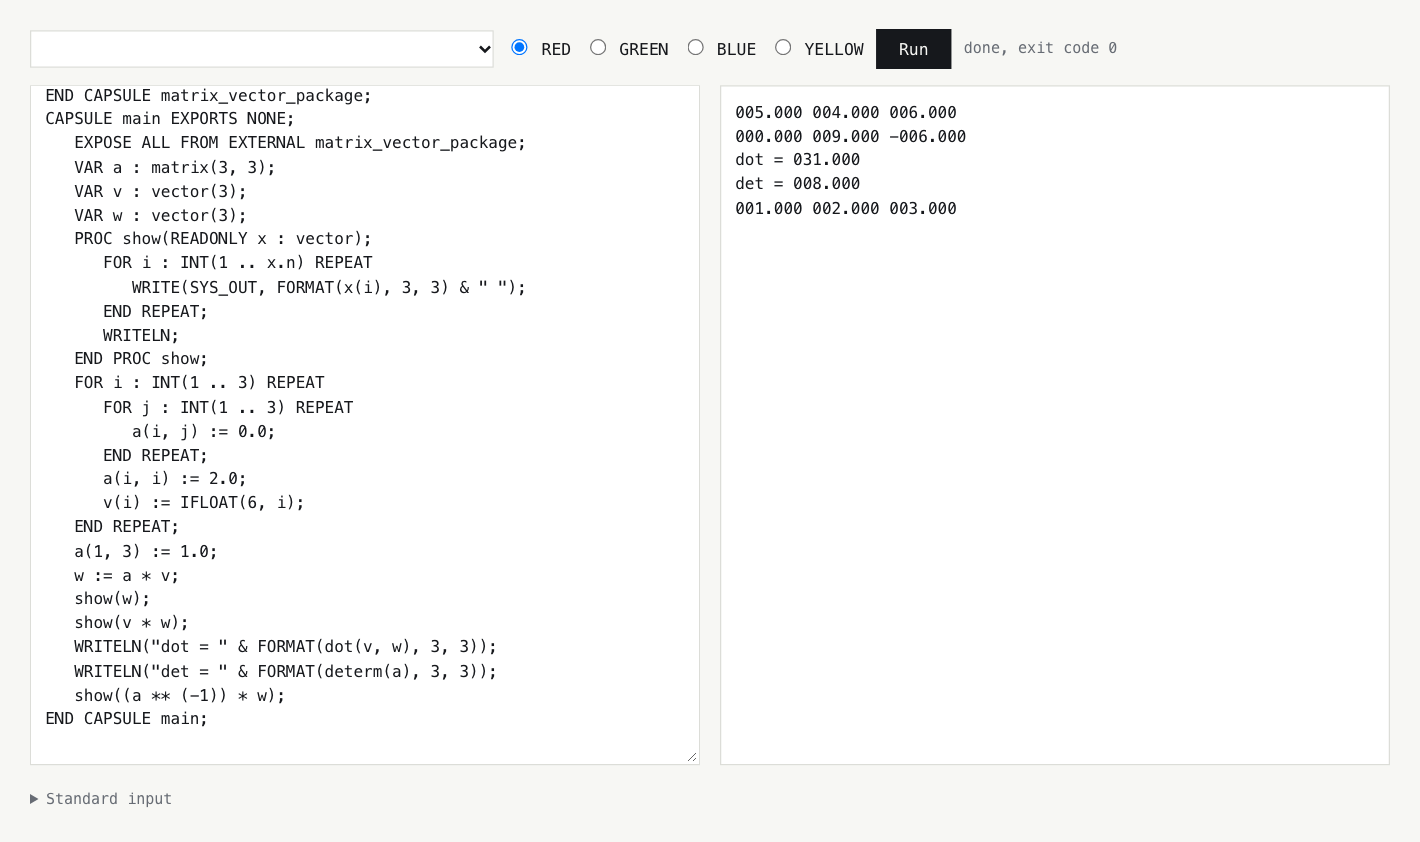
Das Matrixarithmetik-Paket aus dem RED Rationale mit den Korrekturen, auf denen der Übersetzer besteht, eingefügt in den Editor der Seite. Der Editor zeigt das Hauptprogramm, rechts steht, was das Paket bei seinem ersten Lauf ausgegeben hat
Die logischen Fehler, die der Übersetzer durchlässt, habe ich so gelassen, wie sie sind, denn sie gehören inzwischen zur Geschichte. In der Matrixinversion werden Zeilen unter der Bedingung IF i = j vertauscht, obwohl es IF i /= j heißen müsste, sodass die Pivotwahl nie wirklich greift. Die Determinante ignoriert den Vorzeichenwechsel bei Zeilenvertauschungen und multipliziert die Diagonale innerhalb der Eliminationsschleife statt danach. Und die Hilfsfunktion zum Potenzieren lässt ihre Schleife bis zu einer äußeren Variable k laufen statt bis zu ihrem eigenen Parameter. Keiner dieser Fehler zeigt sich bei meiner Testmatrix, und höchstwahrscheinlich hätte er sich auch 1979 nicht gezeigt.
Die Beispiele des Handbuchs selbst erzählen dieselbe Geschichte. In Kapitel vierzehn, wo ein Round-Robin-Scheduler, Hoares Monitore und MAILBOX selbst in der Sprache definiert werden, heißt die Variable des Schedulers new, ein reserviertes Wort, und ein Record-Feld im Monitor heißt external, ebenfalls reserviert. In der Definition der Mailbox steht SYNCH_SIGNAL statt SYNC_SIGNAL, und eine Bedingung ist aus der benachbarten Prozedur kopiert, ein Fehler, den kein Übersetzer finden würde.
Als Nächstes standen die Vertragsaufgaben auf dem Plan. Als erste lief Nummer sechs, „Prozesssteuerung“: Task a liest Lochkarten in einen Doppelpuffer, Task b verarbeitet sie, Task c druckt das Ergebnis, und Prozedur d spricht mit dem Operator und hält auf dessen Befehl DONE die Tasks a und b sauber an, ohne Daten zu verlieren. Wieder fand der Übersetzer im Original Dinge, die er nicht durchlassen kann, eine ganze Reihe kleiner. Von einem neuen Typ ohne Parameter wird ein Teilbereich genommen, mes('b0..'b1), während ein solcher Typ in RED genau einen Subtyp hat. Das Puffer-Array ist als Typ deklariert, wird aber als Variable verwendet, die es nicht gibt. Die Aktivierungen sind unter den Namen aa, ba und ca deklariert, die Tasks werden aber unter den Namen cc und bb erzeugt. Task b schickt seine Ergebnisse an die Mailbox mc, importiert aber aus irgendeinem Grund mr. Und der Schleifenname am Ende ist mit einem t statt mit zweien geschrieben. Das Eingabegerät und die Verarbeitung, die die Aufgabenstellung „als vorhanden annimmt“, habe ich durch Stubs ersetzt, und der Operator gibt seine Befehle auf Lochkarten mit achtzig Spalten, wie es sich für 1979 gehört.
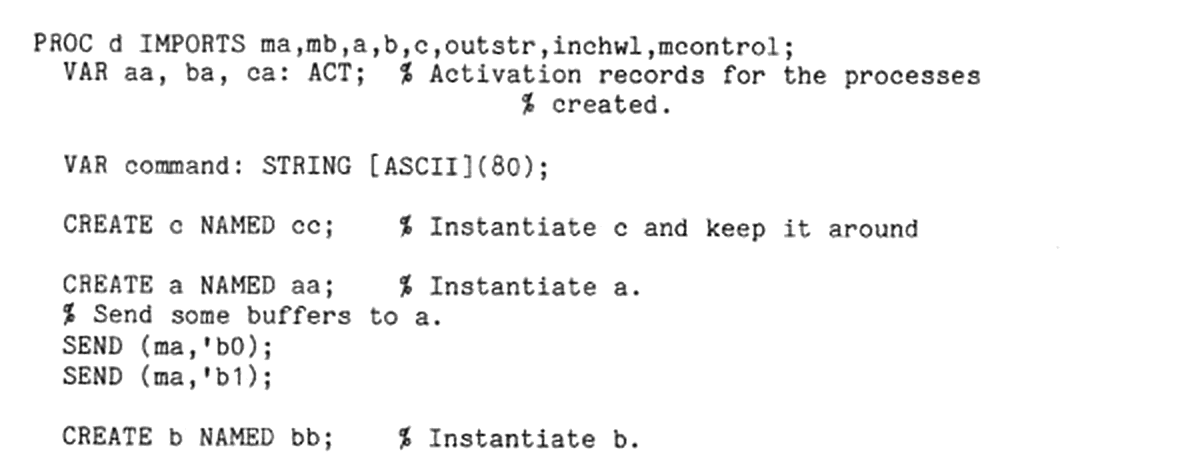
Die Operator-Prozedur d aus der Lösung der Aufgabe sechs im RED Rationale (Intermetrics, 1979, nachgedruckt auf iment.com). Die Aktivierungen sind als aa, ba und ca deklariert, die Tasks werden aber unter den Namen cc und bb erzeugt
Das Interessanteste begann, nachdem sich alles übersetzen ließ. Der Operator gibt DONE, und Task a liest für immer weiter Karten. Er wartet in einem WAIT auf zwei Ereignisse zugleich: einen zurückgegebenen Puffer und einen Stoppbefehl. Ein Puffer kommt immer zurück, und meine Runtime wählte die erste bereite Alternative in Textreihenfolge. Der Stoppbefehl bekam schlicht nie eine Chance. Das RED-Handbuch sagt, dass die Wahl unter bereiten Alternativen nicht festgelegt ist, die Lösung von 1979 ist also nur korrekt, wenn die Implementierung fair wählt. Ich bin auf eine Round-Robin-Auswahl umgestiegen, und DONE funktionierte. Dabei ging mein eigenes RED-Kubernetes kaputt, doch dazu mehr in einem eigenen Kapitel. Eine weitere Eigenschaft der Lösung von 1979 kam von selbst zum Vorschein: Stirbt Task a, hängt die Operatorkonsole für immer an einem Send an eine Mailbox der Größe null, die niemand mehr liest.
Die übrigen Aufgaben berühren Interrupts an bestimmten Adressen, Puffer im Speicher und das Bitlayout eines Wortes, sie brauchten also Hardware. Die habe ich durch Geräte-Tasks auf der virtuellen Uhr ersetzt: Tastaturen schicken Zeichen, Joysticks melden Geschwindigkeiten, Tasten werden zu vorgegebenen Millisekunden gedrückt, und Interrupt-Entries und Mailboxen an festen Adressen wurden zu gewöhnlichen Entries und Mailboxen. Auch die restlichen neunzehn Programme sind portiert, und jetzt laufen alle zwanzig Lösungen des Wettbewerbs, zehn rote und zehn grüne, dazu das Matrixpaket.
Kein einziges davon ließ sich so übersetzen, wie es gedruckt war. Interessant ist, welche Fehler jedes Team gemacht hat. Bei Red ist es meist Unachtsamkeit: undeklarierte Namen, eine Funktion OCTAL, die es in der Sprache nicht gibt, ein Parameter namens rep, obwohl REP ein reserviertes Wort ist. Es gibt aber auch Designfehler, die ein Übersetzer durchlassen würde. In der Aufgabe mit den bewegten Objekten werden Positionen als Zeiger gespeichert, und der Kollisionstest vergleicht Zeiger, die nie gleich sind: Die Objekte auf dem Bildschirm können schlicht nicht kollidieren. In der Aufgabe zum Schutz der Datenbank sucht jede Prozedur einen Datensatz, ändert eine Kopie davon und kehrt zurück, sodass keine Reservierung je die Datenbank erreicht.
Green hat weniger Tippfehler, verstößt aber häufiger gegen die Regeln der eigenen Sprache. Vier Lösungen starten Tasks, verlassen eine Schleife oder kehren aus einer Prozedur direkt im Rumpf eines accept zurück, was das Handbuch von 1979 verbietet. Auch Designfehler gibt es. In der Dateiaufgabe wird ein Datensatz ein Byte weiter hinten geschrieben, als er später gelesen wird, sodass jeder Datensatz verschoben zurückkommt. In der Aufgabe zum Entpacken von Paketen bekommt das Längenfeld acht Bit, eine Länge kann aber bis zu 256 betragen, wofür neun nötig sind. Beim Schutz der Datenbank wird eine Freigabe erst nach einer neuen Reservierung angenommen, sodass ein Aufruf des Entry FREE für immer hängt, und ein Task, der auf exklusiven Zugriff wartet, kann sich mit einem anderen verklemmen. Im Scheduler geht eine Anfrage, deren Frist früher liegt als der Kopf der Liste, einfach verloren, und die Anfragen des Operators verschwinden als erste.
1979 haben Dutzende Gutachterteams diese Texte gelesen. Sie lasen sie mit bloßem Auge: Das Team Red hat nach eigenen Angaben nur die Syntax durch seinen Übersetzer geschickt. Die Korrekturen daran liegen ebenfalls neben den Lösungen, sodass der gesamte Unterschied zwischen dem Gedruckten und dem, was läuft, offen zutage liegt.
Die Texte zeigen auch den Hauptunterschied zwischen den beiden Sprachen. Die roten Lösungen sind halb so lang, und drei Viertel des Unterschieds stammen aus drei Aufgaben: dem Dateipaket, dem Schutz der Datenbank und dem Scheduler. Wo Red einen eingebauten Lock, eine Mailbox oder ein Warten bis zu einem bestimmten Zeitpunkt hat, muss Green einen eigenen Server-Task schreiben, dem die Daten gehören und der Anfragen der Reihe nach bedient. In der Aufgabe zum Echtzeit-Scheduler schreibt das Team Red gar keinen Scheduler: Es hat DELAY_UNTIL und einen generischen Wrapper-Task, dessen Parameter ein anderer Task ist, insgesamt 44 Zeilen. Das Team Green baut einen ausgewachsenen Scheduler-Task, der vom Uhr-Interrupt geweckt wird, mit einer Liste anstehender Starts und einer Familie von Entries, 234 Zeilen. In der Aufgabe zum Schutz der Datenbank setzt das Team Red einen kritischen Abschnitt ein und wiederholt in einer Schleife, während das Team Green die Benutzer in Warteschlangen an den Entries eines Server-Tasks aufreiht. Wo Red einen Lock hat, hat Green einen Server. Das ist der ganze Streit von 1979, und genau dorthin geht es als Nächstes.
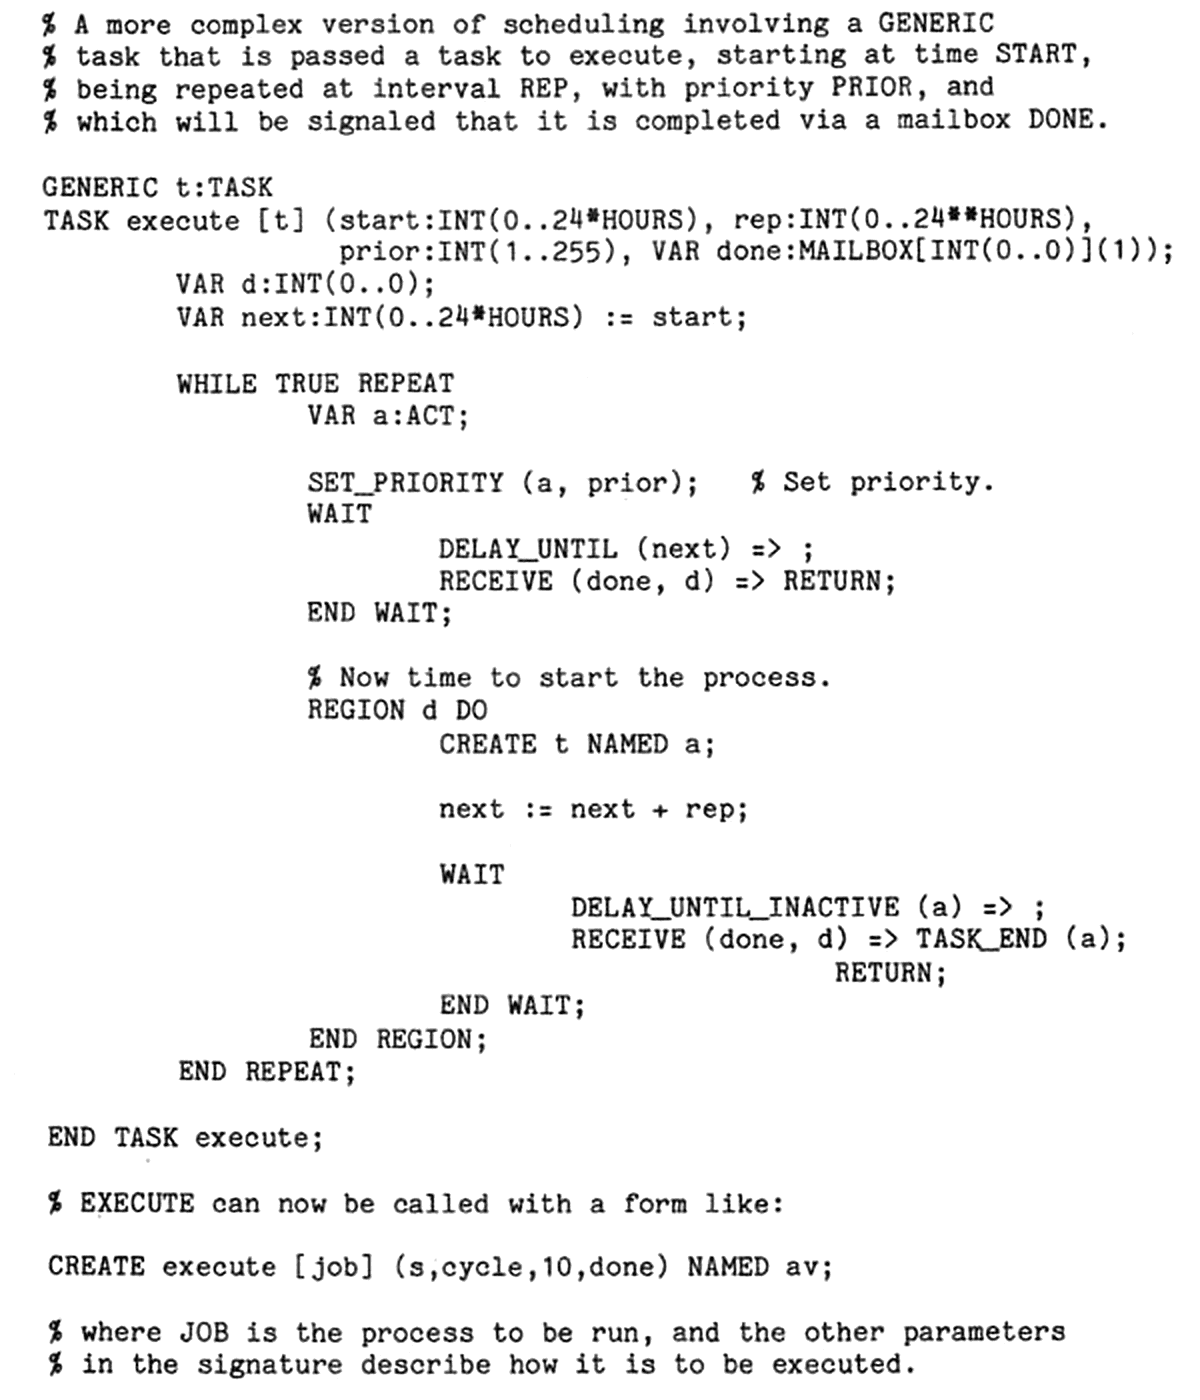
Der Echtzeit-Scheduler des Teams Red (das RED Rationale, Intermetrics, 1979, nachgedruckt auf iment.com). Der generische Task execute nimmt einen Task als Parameter und wartet mit DELAY_UNTIL. Man beachte den leeren Zweig DELAY_UNTIL (next) => ;, den die Diagramme der Sprache nicht erlauben
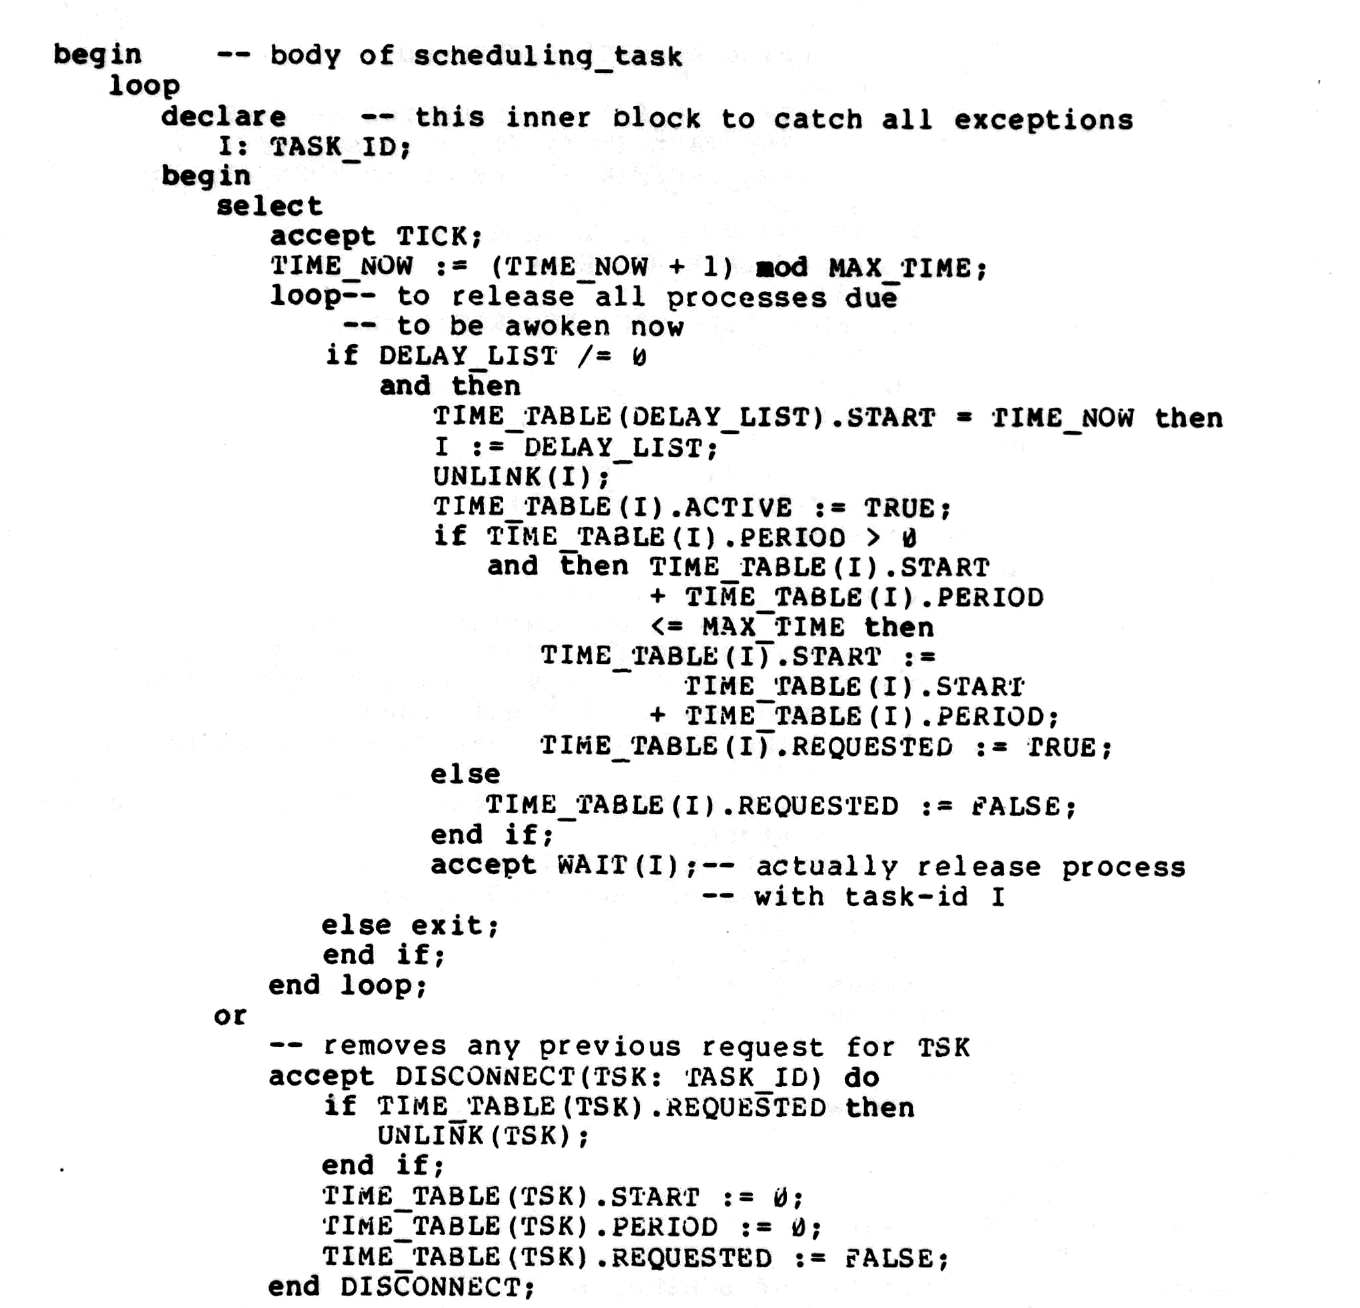
Dieselbe Aufgabe beim Team Green (DTIC ADA070752, April 1979, gescannt im Internet Archive): der Rumpf des Scheduler-Tasks. Jeder Uhrtakt kommt als Rendezvous accept TICK an, danach geht der Task die Liste der anstehenden Starts durch und gibt die fälligen über accept WAIT(I) frei
Ein Betriebssystem im Geist von Tandem
Beim Lesen des RED-Kapitels über Multitasking fiel mir die Tandem NonStop ein. Ihr Betriebssystem Guardian erschien 1976 und war verblüffend ähnlich aufgebaut. Prozesse teilen sich keinen Speicher und kommunizieren nur über Nachrichten, und jeder wichtige Dienst läuft als Paar von Prozessen auf verschiedenen Prozessoren: Der Primärprozess bedient Anfragen und schickt dem Backup vor jeder Antwort einen Checkpoint, eine Beschreibung dessen, was sich geändert hat. Fällt der Prozessor des Primärprozesses aus, erfährt das Backup davon über das System, das die Heartbeats der Prozessoren überwacht, und macht dort weiter, wo der letzte Checkpoint aufgehört hat. Joel Bartlett beschrieb diesen Kernel 1981 auf dem Symposium on Operating Systems Principles, SOSP, und 1985 schrieb Jim Gray seinen berühmten Aufsatz darüber, warum Computer stehen bleiben und was man dagegen tun kann.
RED hat alles, was man braucht, um das nachzubauen: Mailboxen sind fast schon Guardians Nachrichtensystem, WAIT mit Timeout ist ein Detektor für ausbleibende Heartbeats, und EXTERMINATE imitiert hervorragend einen Prozessor, der den Strom verliert. So entstand ein kleines Betriebssystem namens PAIRS, nur rund dreihundert Zeilen lang.
Es hat drei Prozessoren; die Ports der Prozesse sind Mailboxen, und eine Namenstabelle verrät, auf welchem Port der Dienst $BANK gerade lebt. Die Bank läuft als Prozesspaar: der Primärprozess auf Prozessor 0, das Backup auf Prozessor 1. Zwei Clients machen jeweils sechs Überweisungen zwischen Konten. Jede Anfrage ist nummeriert, und kommt binnen 50 Millisekunden keine Antwort, fragt der Client die Namenstabelle erneut und wiederholt die Anfrage mit derselben Nummer.
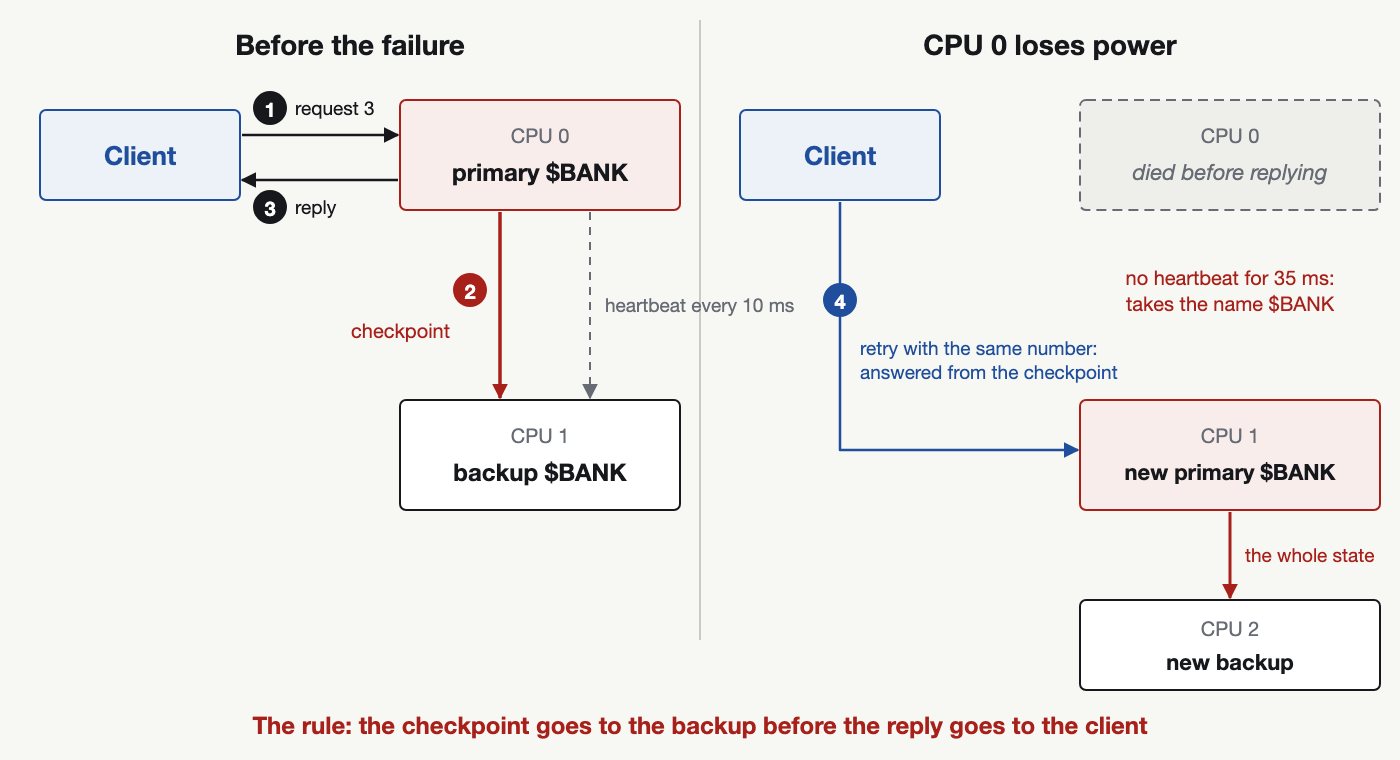
Das Prozesspaar in PAIRS. Der Primärprozess schickt dem Backup zuerst einen Checkpoint und antwortet erst danach dem Client. Wenn CPU 0 ausfällt, übernimmt das Backup nach 35 Millisekunden Stille den Namen $BANK und erkennt die Wiederholung des Clients an ihrer Nummer
Den Ausfall habe ich auf den denkbar ungünstigsten Moment gelegt. Der Primärprozess hat die dritte Anfrage des zweiten Clients verarbeitet und dem Backup einen Checkpoint geschickt, kam aber nicht mehr dazu, dem Client zu antworten, weil sein Prozessor genau in diesem Moment den Strom verlor. Das passiert danach:
[0 ms] $BANK primary on CPU 0 (port 3), backup on CPU 1 (port 4)
[6 ms] $BANK primary checkpointed request 3 of client 2 and has not replied yet
[6 ms] CPU 0 loses power
[41 ms] $BANK backup on CPU 1 hears no heartbeat: takes over as primary
[41 ms] $BANK backup started on CPU 2, port 5
[56 ms] client 2: no reply to request 3, retrying
[56 ms] client 1: no reply to request 3, retrying
[56 ms] $BANK: request 3 of client 2 is a retry, answered from the checkpoint
...
[68 ms] audit: every confirmed transfer is in the books exactly once
35 Millisekunden lang hört das Backup keinen Heartbeat; dann übernimmt es den Namen $BANK, startet auf einem freien Prozessor ein neues Backup für sich selbst und überträgt ihm den gesamten Zustand. Die Clients bekommen keine Antworten und wiederholen ihre Anfragen. Die Anfrage des ersten Clients ist in der Mailbox des toten Prozesses verbrannt, also führt der neue Primärprozess sie zum ersten Mal aus. Die Anfrage des zweiten Clients dagegen erkennt der neue Primärprozess an ihrer Nummer: Der Checkpoint ist durchgekommen, die Überweisung ist also schon gebucht, und der Client bekommt einfach die gespeicherte Antwort zurück. Am Ende reichen die Clients ein Protokoll all dessen ein, was ihnen bestätigt wurde, und es wird mit den Büchern der Bank abgeglichen. Jede bestätigte Überweisung ist genau einmal verbucht.
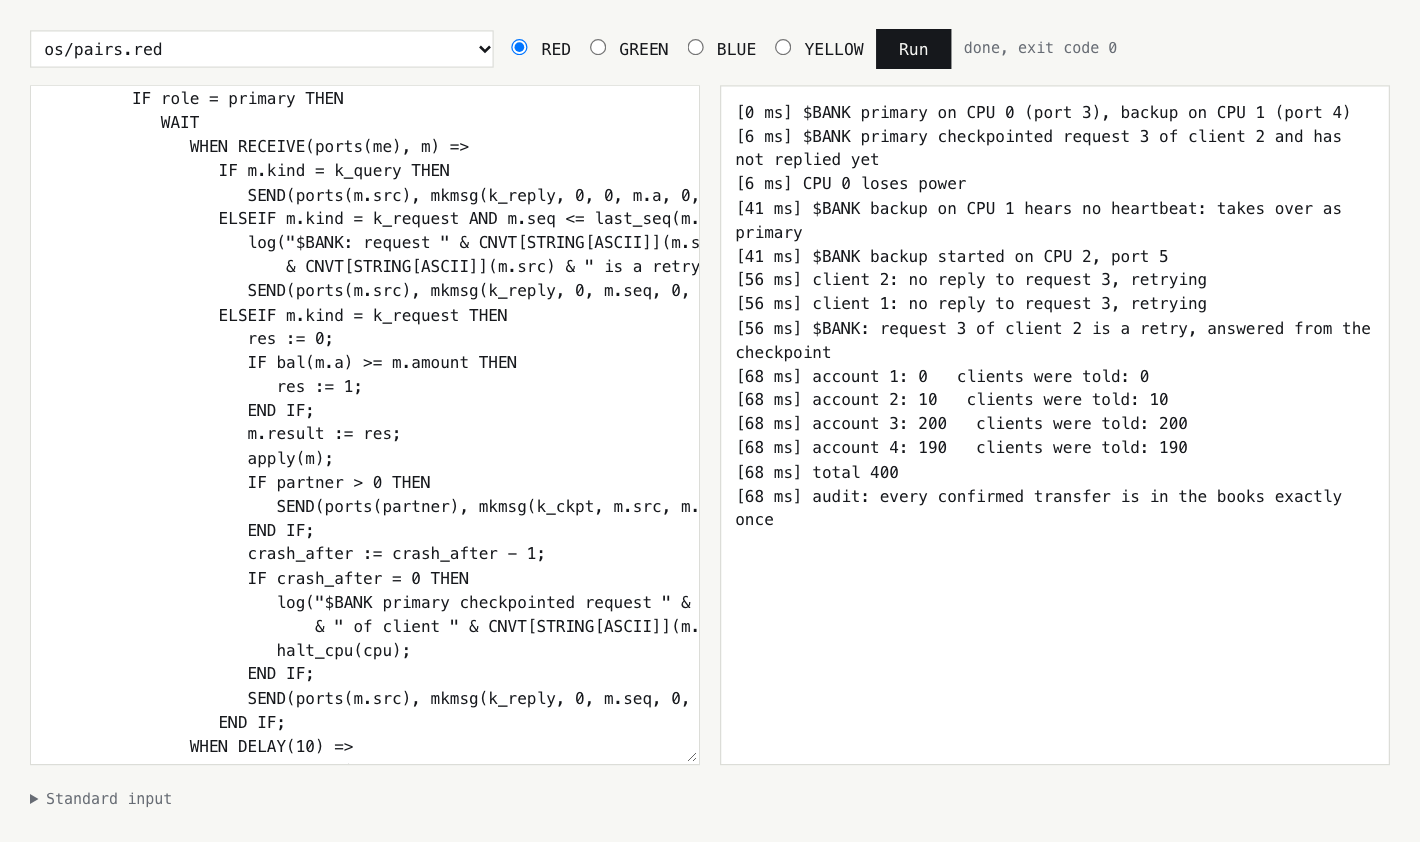
PAIRS im Browser. Links der Primärprozess: Der Checkpoint geht vor der Antwort hinaus. Rechts stirbt CPU 0 zwischen beidem, das Backup übernimmt $BANK, und die Prüfung am Ende stimmt mit dem überein, was den Clients mitgeteilt wurde
Jetzt zum lehrreichsten Teil. Vertauscht man im Primärprozess zwei Zeilen, sodass die Antwort an den Client zuerst hinausgeht und der Checkpoint danach, und stirbt der Prozessor dazwischen, kommt Folgendes heraus:
[68 ms] account 2: 40   clients were told: 10
[68 ms] account 4: 160   clients were told: 190
[68 ms] total 400
[68 ms] audit: 2 accounts disagree with what the clients were told
Dem Client wurde gesagt, eine Überweisung über dreißig Einheiten sei durchgegangen, und in den Büchern steht davon nichts. Und beachten Sie: Die Gesamtsumme ist immer noch 400, wer also nur darauf schaut, sieht überhaupt keinen Fehler. Genau dafür gibt es die Regel „Checkpoint vor der Antwort“, und sie lässt sich mit den besten Absichten, der Geschwindigkeit zuliebe, sehr leicht brechen. Diese Übung wurde zur Grundlage eines der Labs.
Dijkstras THE
Tandem ist nicht das einzige System jener Jahre, das geradezu danach verlangte, in RED geschrieben zu werden. Zehn Jahre vor Guardian, 1965–1968, baute Dijkstras Gruppe in Eindhoven das Multiprogrammiersystem THE, und der Aufsatz darüber wurde einer der meistzitierten in der Geschichte der Betriebssysteme. Seine zentrale Idee ist die Hierarchie. Das System ist eine Gesellschaft sequenzieller Prozesse, verteilt auf die Ebenen 0 bis 5: Prozessorzuteilung und Semaphoren auf Ebene 0, der Segment-Controller, der Informationen zwischen Kernspeicher und magnetischem Trommelspeicher, dem langsamen Hintergrundspeicher jener Jahre, hin- und herschiebt, auf Ebene 1, der Message-Interpreter, dem die einzige Konsole gehört, auf Ebene 2, die Pufferung von Ein- und Ausgabe auf Ebene 3, die Benutzerprogramme auf Ebene 4 und der Operator auf Ebene 5. Dijkstras Semaphor ist ein Zähler mit zwei Operationen: P wartet, bis der Zähler größer als null ist, und verringert ihn, V erhöht den Zähler und weckt einen Wartenden. Ein Prozess ruft nur Ebenen unterhalb seiner eigenen auf, und Dijkstra behauptete, genau das erlaube es, die Korrektheit des Systems im Voraus zu beweisen und es erschöpfend zu testen.
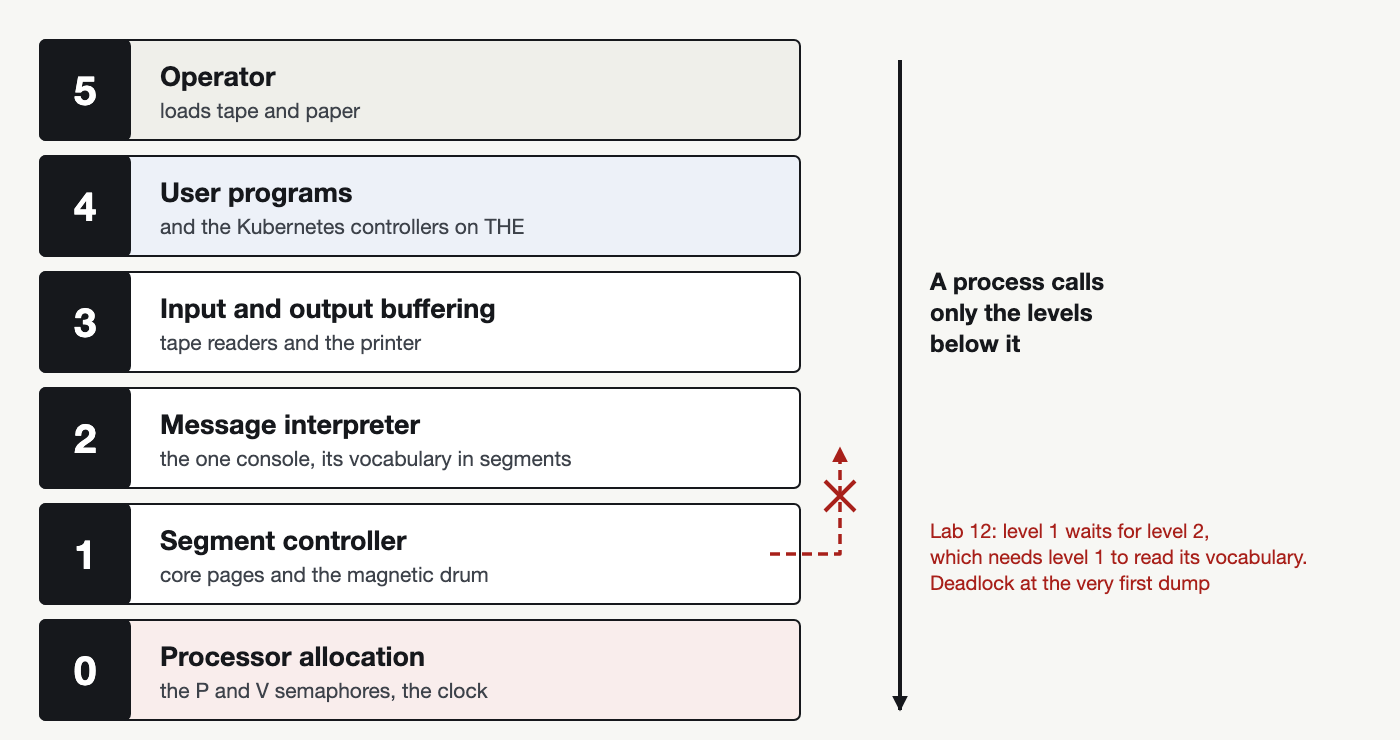
Die Ebenen von THE in meiner RED-Version. Ein Prozess ruft nur die Ebenen unter sich auf; der rote Pfeil nach oben ist das, was Lab 12 tut
Ich habe THE in RED gebaut, rund vierhundert Zeilen. Die Semaphoren wurden zu Mailboxen mit Token: P nimmt ein Token, V legt eines zurück. REGION taugt hier nicht, weil in THE ein Prozess das V ausführt und ein anderer das P, während der kritische Abschnitt von RED nur Code innerhalb eines Prozesses einklammert. Acht Segmente leben in drei Seiten des Kernspeichers, und der Controller lagert den Überschuss auf die freie Trommelseite mit der geringsten Latenz aus, genau wie im Aufsatz beschrieben. Drei Lochstreifenleser füllen Puffer, drei Programme berechnen Quadratsummen, der Drucker bittet den Operator in seiner dritten Zeile um Papier, und hundertvierzig Millisekunden später legt der Operator es ein.
Das Interessanteste am Aufsatz ist eine Passage, die man leicht übersieht. Dijkstra erklärt, warum der Message-Interpreter über dem Segment-Controller sitzt und nicht neben ihm: Das Vokabular der Konsole liegt in Segmenten, um einen Satz auszugeben, braucht der Interpreter also den Controller. Ich habe geprüft, was passiert, wenn man diese Ordnung verletzt. In Lab 12 meldet der Segment-Controller jede Auslagerung dem Operator, ein Prozess der Ebene 1 wartet also auf einen der Ebene 2. Das System friert bei der allerersten Auslagerung ein:
[20 ms] CONSOLE  reader 1: tape loaded, reading
[30 ms]   segment controller: segment 1 dumped from core page 1 to drum page 6
[40 ms] CONSOLE  reader 2: tape loaded, reading
*** deadlock: every task is waiting (t=400)
Der Controller wartet auf die Konsole, und die Konsole wartet darauf, dass der Controller ihr Vokabular einliest. Ein einziger Pfeil nach oben, und Dijkstras Beweis gilt nicht mehr.
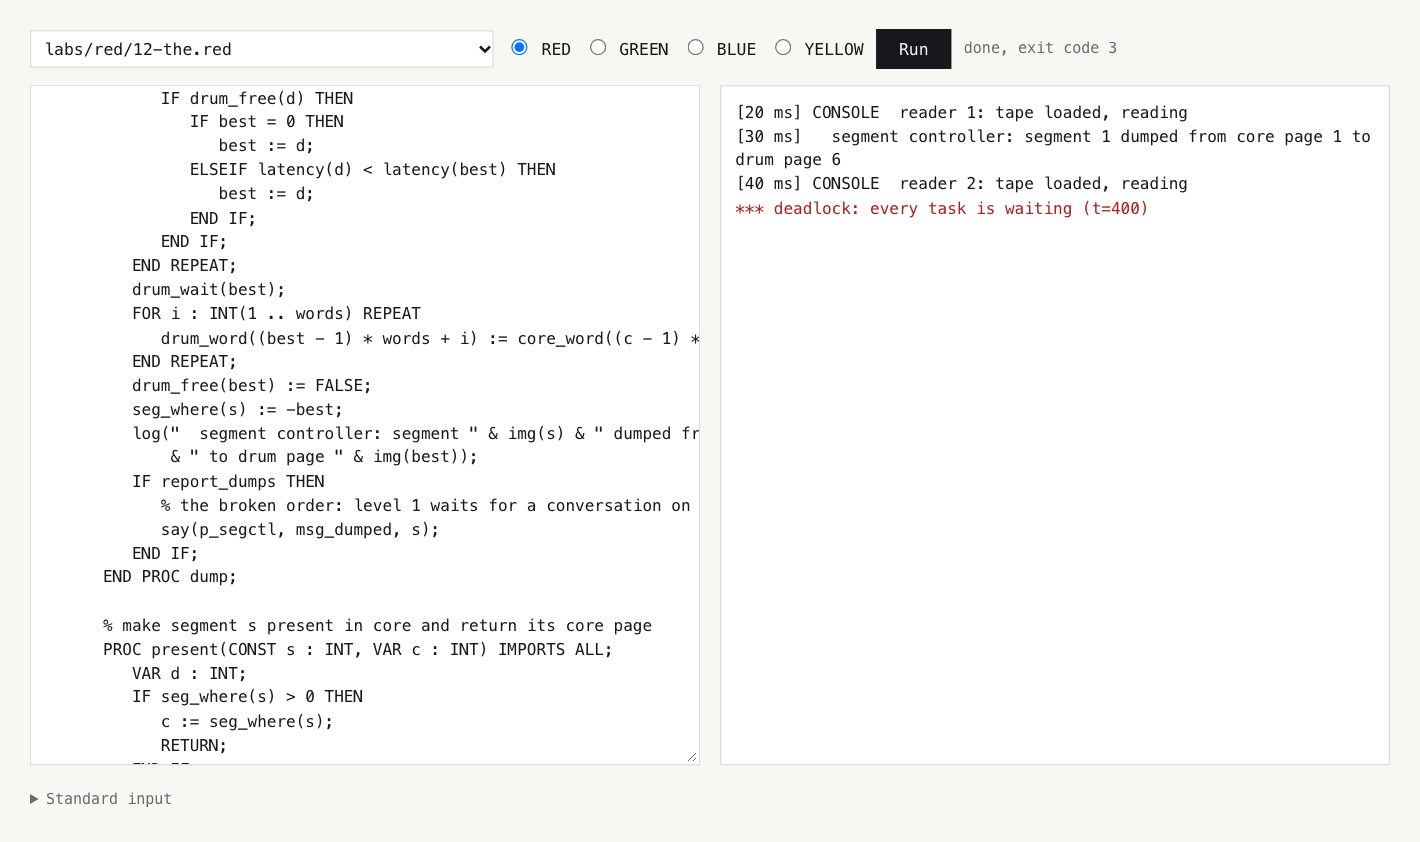
Lab 12 im Browser: report_dumps ist im Editor auf TRUE gesetzt, und der Segment-Controller wartet schon nach seiner allerersten Auslagerung auf die Konsole. Bei 400 Millisekunden meldet die Laufzeitumgebung, dass alle Tasks warten
Zum Vergleich habe ich den Kern von THE auch in GREEN geschrieben. Dort gibt es weder Semaphoren noch Mailboxen, also wird jeder Semaphor zu einem Server-Task, der P nur annimmt, solange sein Zähler positiv ist. Das funktioniert, aber neun Zeilen, die drei Programme über einen gemeinsamen Puffer ausgeben, kosten 54 Rendezvous, sechs für jede gedruckte Zeile. Wo RED einfach ein Token aus einer Mailbox nimmt, ruft GREEN bei jedem P und V einen Server-Task auf und wartet auf ein Rendezvous mit ihm.
Jetzt, da THE läuft, kann auch Kubernetes darauf laufen. Aber zuerst: wie Kubernetes auf Mailboxen funktioniert.
Kubernetes auf Mailboxen
Ein Wort für alle, die noch nicht mit Kubernetes gearbeitet haben. In Kubernetes befiehlt man nicht „starte drei Kopien des Dienstes“, sondern schreibt den gewünschten Zustand in einen Store, ein Deployment mit drei Replikas, und eine Reihe unabhängiger Controller vergleicht immer wieder Soll und Ist und schließt die Lücke: Sie erzeugen Pods, also Instanzen der Anwendung, weisen sie Nodes zu, räumen Pods von Nodes, die nicht mehr antworten, und rollen bei einem Versions-Upgrade neue Pods an die Stelle der alten aus. Alle lesen und schreiben über einen einzigen API-Server.
Im vorigen Teil der Serie habe ich Kubernetes auf Oberon gebaut, und die wichtigste Entdeckung dort war, dass sich ein Kubernetes-Controller ganz natürlich auf einen Hintergrund-Task des Betriebssystems abbilden lässt. In RED ist das Bild noch vergnüglicher, denn viele Teile von Kubernetes sind schon da und tragen nur andere Namen.
So bilden sich die Teile von Kubernetes auf RED ab:
| Kubernetes | RED |
|---|---|
| API-Server und Objekt-Store | ein Task, dem der Store allein gehört |
| Watch, ein Abonnement auf Änderungen | eine Mailbox: Der API-Server schickt jede Änderung in die Mailboxen der Controller, die Objekte dieser Art abonniert haben |
| Informer-Cache | die eigene Kopie der Objekte in jedem Controller |
| Reconcile-Loop | WAIT: Entweder ist ein Ereignis eingetroffen, oder der Timeout ist abgelaufen und es ist Zeit für einen vollständigen Resync |
| Optimistic Locking | ein Schreibvorgang trägt die Versionsnummer, auf der er beruht; ein veralteter Schreibvorgang wird abgelehnt |
| Expectations | die Zahl der Pods, deren Erzeugung der Replica-Controller angefordert, die er aber noch nicht gesehen hat; ohne sie würde er überzählige Pods erzeugen |
| Kubelet, der Node-Agent, und seine Lease | ein Task, der seine Lease regelmäßig erneuert; ein Node, der sie nicht mehr erneuert, wird für nicht bereit erklärt, und seine Pods ziehen woandershin |
Die Tasks teilen untereinander nichts außer Mailboxen. Von dieser Tabelle sind im Folgenden vor allem Expectations und Leases wichtig.
Im Hauptlauf wird ein Deployment mit drei Replikas erzeugt und auf fünf skaliert, ein zweiter Client versucht, eine veraltete Kopie zu schreiben, und wird abgewiesen, dann verliert Node 2 den Strom, seine Pods ziehen auf lebende Nodes um, und zum Schluss wird eine zweite Version ausgerollt. All das passt in rund fünfhundert Zeilen RED.
Die Control Plane als Prozesspaar
Und jetzt kommt der verrückte Teil, der ganze Grund, warum es sich lohnte, Tandem und Kubernetes zusammenzubringen. In Kubernetes kommt die Zuverlässigkeit der Control Plane von etcd: Mehrere Replikas des Stores einigen sich über das Raft-Protokoll, und solange ein Quorum lebt, lässt sich der Cluster verwalten. Was, wenn wir es auf die Tandem-Art machen? Der API-Server läuft als Paar: Nach jeder Änderung schickt der Primärprozess, bevor er irgendwelche Ereignisse verschickt, dem Backup einen Checkpoint, und das Backup überwacht den Heartbeat und übernimmt den Namen, wenn er ausbleibt. Kein Konsens, kein Quorum, nur ein Paar von Prozessen.
Das Problem ist, dass hier, anders als bei der Bank, niemand Anfragen wiederholt. Ein Controller schickt einen Schreibvorgang an den API-Server und macht weiter; er wartet nicht auf eine Antwort. Stirbt der Primärprozess, verschwindet alles, was in seiner Mailbox liegt, und niemand erfährt je davon. Ich war fast sicher, dass es nicht funktionieren würde, und habe den Ausfall so gemein gestaltet, wie ich konnte: Der primäre API-Server verliert mitten im Rollout einer neuen Version den Strom, direkt nachdem er den ersten Pod dieser Version gespeichert hat. replicaset 10 im Log ist das ReplicaSet der zweiten Version, das der Replica-Controller verwaltet. Schauen Sie sich die Zeilen bei 60 und 95 ms an: Der Scheduler bindet denselben Pod 11 zweimal, weil die erste Bindung mit der Mailbox des toten Servers untergegangen ist.
[60 ms] replicaset 10: 0 of 4 pods, creating 4
[60 ms] api server primary loses power right after storing pod 11; the writes still in its mailbox are gone
[60 ms] scheduler: pod 11 -> node 1
[80 ms] replicaset 10: 1 of 4 pods, creating 3
[95 ms] api server backup: no heartbeat, taking over the name API
[95 ms] scheduler: pod 11 -> node 1
[95 ms] kubelet 1: pod 11 (version 2) running
[115 ms] replicaset 10: 1 of 4 pods, creating 3
[115 ms] scheduler: pod 12 -> node 2
...
Drei Anfragen zur Pod-Erzeugung und eine Bindung eines Pods an einen Node sind mit der Mailbox des toten Servers verschwunden. Bei 80 Millisekunden laufen die Expectations des Replica-Controllers ab, und er fordert die Pods erneut an, aber wieder ins Leere, denn der Name gehört noch dem toten Server (und was tot ist, kann niemals sterben). Fünfzehn Millisekunden später übernimmt das Backup den Namen und schickt jedem Controller die vollständige Liste der Objekte. Der Scheduler sieht, dass Pod 11 in Wahrheit an keinen Node gebunden ist, und bindet ihn, und zwanzig Millisekunden danach, bei 115 Millisekunden, erzeugt der Replica-Controller, was noch fehlt. Der Cluster kommt dort an, wo er sein soll, ohne Konsens und ohne menschliches Zutun. Das funktioniert, weil Kubernetes-Controller Zustände vergleichen, statt auf Ereignisse zu reagieren: Ein verlorener Schreibvorgang ist nur eine weitere Abweichung, die die nächste Reconciliation auffängt.
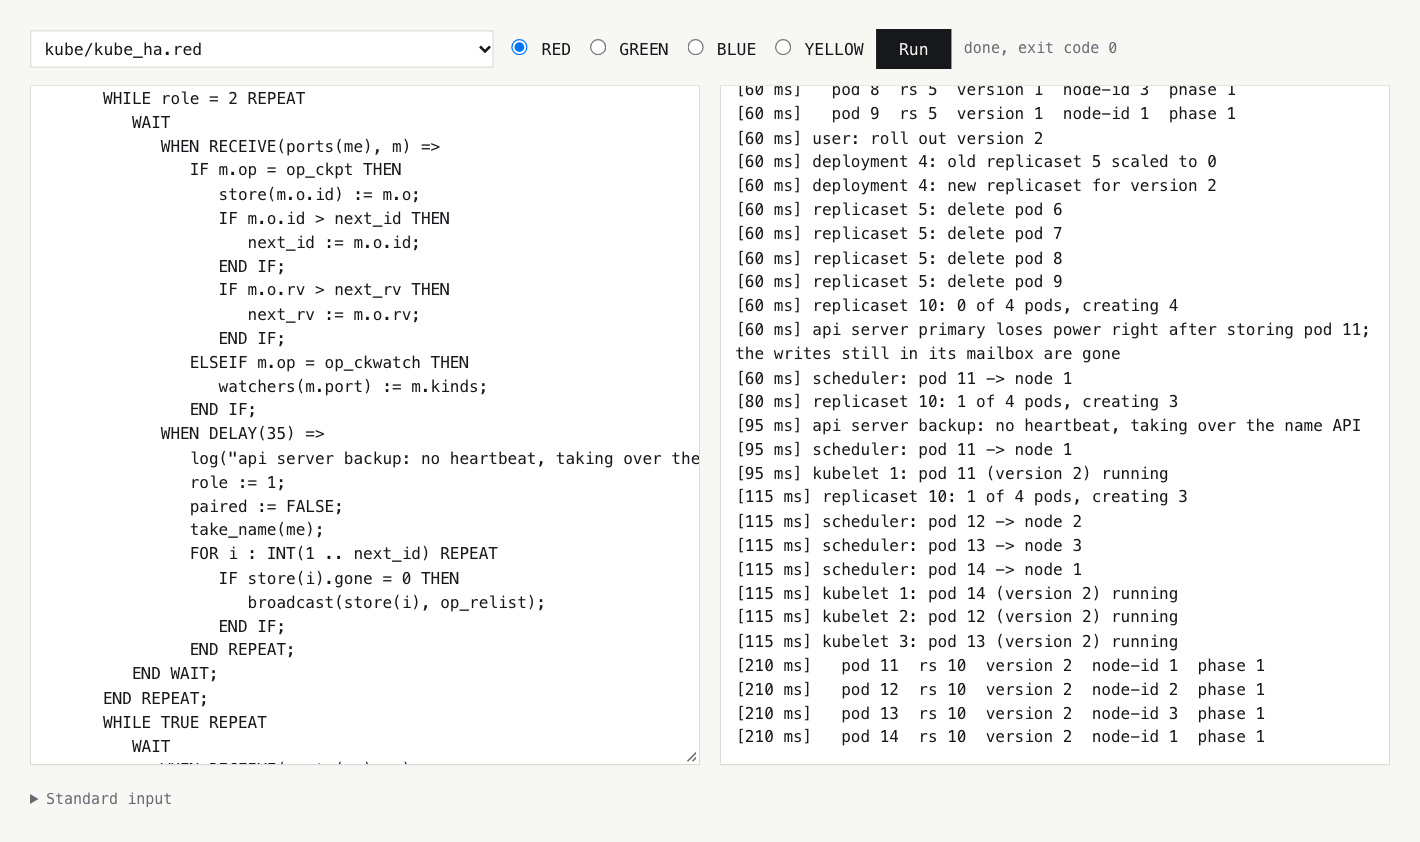
Kubernetes mit einem API-Server-Paar im Browser. Links der Backup-Server: Nach 35 Millisekunden ohne Heartbeat übernimmt er den Namen API und verschickt alle Objekte. Rechts stirbt der Primärprozess mitten im Rollout von Version 2, und bei 210 Millisekunden laufen alle vier ihrer Pods
Zwei echte Kubernetes-Fehler, zufällig gefunden
Wirklich interessant war nicht, was am Ende funktionierte, sondern wie es unterwegs kaputtging. Im ersten Lauf des Paars erklärte der Node-Controller nach dem Failover des API-Servers alle drei Nodes auf einmal für nicht bereit und räumte jeden einzelnen Pod. Während das Backup 35 Millisekunden lang die Stille abwartete, erneuerten die Kubelets ihre Leases beim toten Primärprozess, und nach dem Failover sah die Lease jedes Nodes veraltet aus. Das ist ein bekanntes Kubernetes-Problem, und auch seine Lösung ist bekannt: Wenn alle Nodes gleichzeitig verstummen, fehlte die Control Plane, nicht die Nodes, und niemand sollte geräumt werden. In Kubernetes geht eine Zone, in der alle Nodes verstummt sind, in den Zustand der vollständigen Störung über, FullDisruption, und wenn das allen Zonen passiert, hält der Eviction-Controller an. Dieselbe Prüfung habe ich eingebaut.
Im zweiten Lauf wurden die Nodes einer nach dem anderen geräumt. Node 3 schaffte es nach dem Failover als Erster, seine Lease zu erneuern, die Bedingung „alle schweigen“ galt nicht mehr, und die Nodes 1 und 2 wurden geräumt. Es gab zwei Ursachen, und beide entsprachen wieder dem, wie echtes Kubernetes es macht. Die Frische einer Lease darf man nicht an der Zeit messen, die in der Lease selbst steht; man muss sie an der Zeit messen, zu der der Controller selbst die Änderung gesehen hat. Und Entscheidungen sollte man nicht bei jedem Ereignis treffen, sondern auf Grundlage des Gesamtbilds: zuerst alles abarbeiten, was sich bereits in der Mailbox angesammelt hat. Der echte Node-Lifecycle-Controller arbeitet ganz ähnlich: Alle paar Sekunden geht er alle Nodes in seinem Cache durch, und wenn er die vollständige Störung verlässt, setzt er außerdem die Frische-Uhr jedes Nodes zurück, damit der erste Node, der seine Lease erneuert, die anderen nicht ans Messer liefert. Nach diesen beiden Korrekturen kostet ein Failover des API-Servers den Cluster genau null Räumungen.
Übrigens nutzte mein erster Versuch, den Rückstau abzuarbeiten, ein WAIT mit einem Empfang und einer Verzögerung von null, in der Annahme, der Empfang würde gewinnen. Sobald die Laufzeitumgebung anfing, unter den bereiten Alternativen fair zu wählen, gewann manchmal die Nullverzögerung, und wieder wurden Nodes geräumt. Der richtige Weg in RED ist, die Mailbox nach FULL_SLOTS zu fragen, also wie viele Nachrichten sie enthält, und sie zu entnehmen, solange welche da sind.
Mir gefällt, dass die Paar-Variante, rund sechshundert Zeilen in einer Sprache von 1979, ganz von selbst und ohne Hinweise auf dieselben Rechen getreten ist, auf die Kubernetes jahrelang getreten ist, und dass der Ausweg derselbe war. Es ist ein gutes Zeichen, dass die Rechen nicht zufällig herumliegen: Sie wachsen aus der Idee selbst, Dinge durch den Abgleich von Zuständen zu steuern.
Dasselbe in der grünen Sprache
Für einen fairen Vergleich habe ich dieselbe Steuerschleife in der grünen Sprache geschrieben. Die Struktur ist dieselbe: ein API-Server, Caches der Controller, optimistische Schreibvorgänge, Leases der Nodes. Vom Umfang her sind beide Versionen nahezu gleich, 522 Zeilen RED und 517 Zeilen GREEN, aber sie sind unterschiedlich gebaut, und der Unterschied ist genau der, über den man 1979 stritt.
Die grüne Sprache hat keine Mailboxen, nur das Rendezvous. Das heißt, der Ereignisstrom für jeden Controller wird zu einem Puffer-Task, einer Familie INBOX(1 .. 8) mit den Entries PUT_EVENT und GET_EVENT, und rund vierzig Zeilen fließen in das, was in RED eine einzige Variablendeklaration war. Es kommt noch schlimmer. Ein Controller muss entweder auf ein Ereignis oder auf einen Timeout für seinen periodischen Resync warten, und die grüne Sprache von 1979 kennt keinen zeitbegrenzten Entry-Aufruf. Ich musste den Timeout in die Mailbox verlegen: Kommt 20 Millisekunden lang nichts an, legt die Mailbox selbst ein leeres Tick-Ereignis in die Warteschlange, und wenn der Controller es erhält, weiß er, dass es Zeit für einen vollständigen Resync ist.
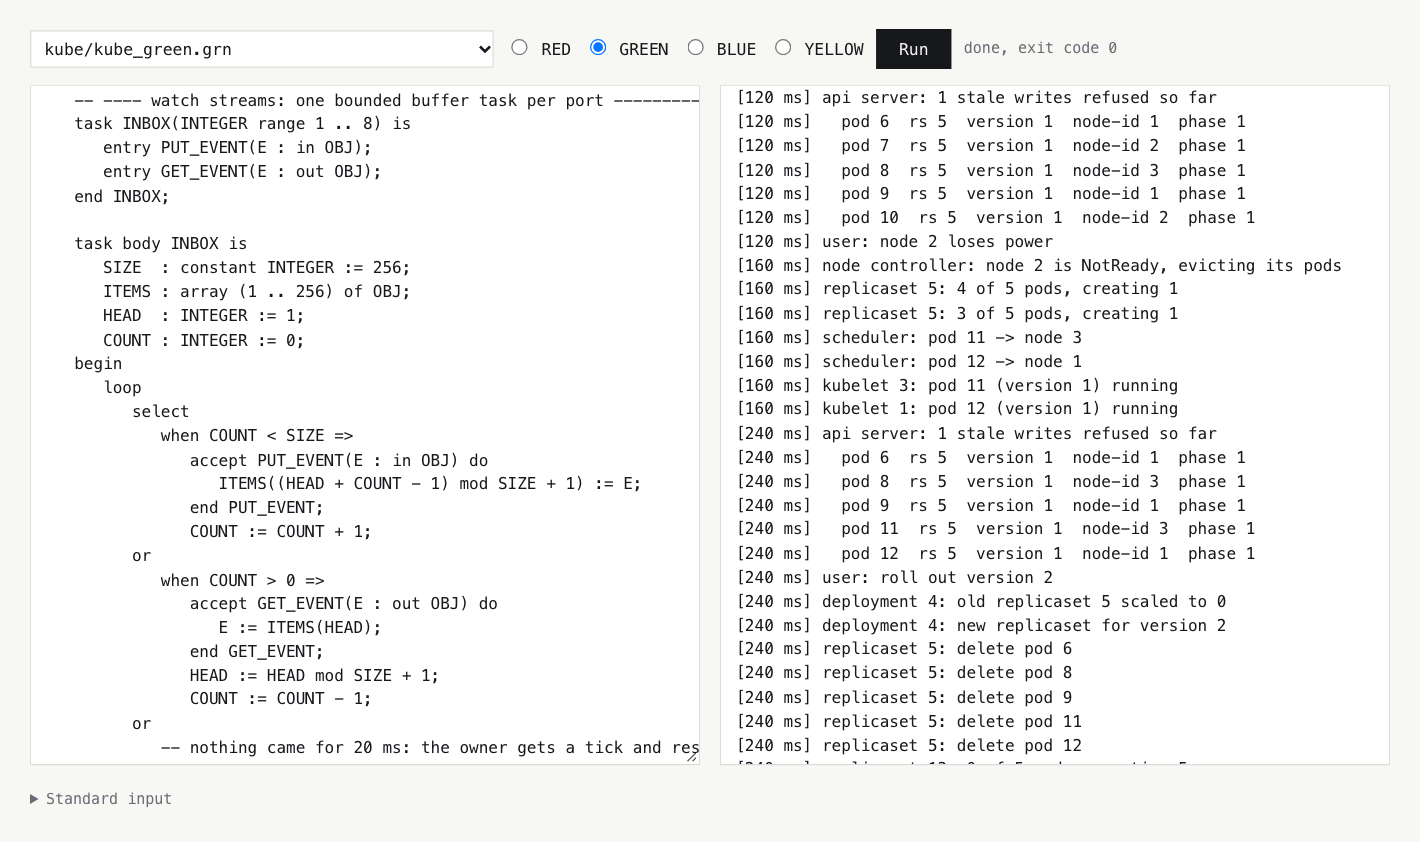
Kubernetes in der grünen Sprache im Browser. Links die Task-Familie INBOX, die die Mailboxen ersetzt, mit einer Verzögerung von 20 Millisekunden für den Tick. Rechts verliert Node 2 den Strom, und seine Pods ziehen auf die lebenden Nodes um
Und es gibt eine Falle, die ich im Voraus vorhergesagt und dann überprüft habe. Der API-Server verschickt Ereignisse, indem er INBOX(P).PUT_EVENT aufruft, und ist die Mailbox voll, wartet der Server. Der Eigentümer der Mailbox kann aber genau in diesem Moment auf den Server warten, weil er API.WRITE aufgerufen hat. Der Server wartet auf den Controller, der Controller auf den Server. Bei Mailboxen für 256 Ereignisse passiert das nicht, bei Mailboxen für vier aber blockiert der Cluster vollständig. Mehr noch: Die Laufzeitumgebung kann es nicht einmal als Deadlock erkennen, weil die Timer der anderen Mailboxen weiterticken und die virtuelle Zeit endlos vorwärtsläuft. Dieselbe Falle ist auch in RED möglich, aber in der grünen Welt steckt sie schon in der Form der Lösung: Wo RED eine Mailbox hat, hat GREEN einen Server-Task, und zwei Server-Tasks, die einander aufrufen, sind ein klassischer Weg, sich aufzuhängen.
Die grüne Version hat übrigens einen Fehler in meiner gemeinsamen Laufzeitumgebung gefunden. Wenn ein Node den Strom verliert, wird sein Kubelet mit abort beendet, und in diesem Moment steht es in der Warteschlange an einem Entry seiner Mailbox. Die Laufzeitumgebung machte den abgebrochenen Task bereit, vergaß aber, seinen Eintrag aus der Entry-Warteschlange zu entfernen, und einen Moment später „nahm“ die Mailbox einen Aufruf von einem bereits beendeten Task „an“ und weckte den Toten. Abschnitt 9.10 des Handbuchs von 1979 sagt klar, dass ein abgebrochener Aufrufer aus der Warteschlange entfernt wird, das war also mein Fehler, nicht der der Sprache.
Kubernetes auf THE
Eines blieb noch: dieselbe Steuerschleife nicht auf Mailboxen laufen zu lassen, sondern auf THE aus dem vorigen Kapitel. Ich habe mir eine strenge Regel gesetzt. Die Controller leben auf Ebene 4, als Benutzerprogramme von THE, und nutzen nur, was THE Programmen bietet: P und V, Segmente, die Konsole und die Uhr. Mailboxen und WAIT bleiben in den unteren Ebenen, da THE selbst aus ihnen gebaut ist.
Kubernetes verändert sich stärker, als ich erwartet hatte. In diesem Modell gibt es überhaupt keinen API-Server: Der Store besteht aus Segmenten, die der Segment-Controller zwischen Kernspeicher und Trommelspeicher verschiebt, geschützt durch einen einzigen Semaphor. Ein Watch wird zu einem Weck-Semaphor pro Controller, und wer etwas schreibt, weckt alle. Der Semaphor sättigt bei eins, ein Wecken sagt also nur „schau noch einmal hin“, nie „das hat sich geändert“, und die Controller werden schon durch ihre Konstruktion level-triggered. P hat keinen Timeout, und ein Prozess kann nicht auf zwei Semaphoren zugleich warten, also kommen Resync, Heartbeats der Nodes und Lease-Prüfungen alle von einem Uhrprozess auf Ebene 0, der alle zehn Millisekunden alle weckt. Selbst das „auf fünf skalieren“ des Operators erreicht den Deployment-Controller über denselben Weck-Semaphor, während der Befehl selbst in einem Segment liegt.
Die erste Version lieferte mir die nützlichsten Erkenntnisse. Ich ließ einen Node so ausfallen wie in PAIRS: EXTERMINATE auf den Kubelet-Task mitten in seiner Arbeit. In diesem Moment hielt das Kubelet den Semaphor des Stores. Das V kam nie, und die gesamte Control Plane blieb vollständig stecken: Weder der Scheduler noch der Node-Controller, der den Verlust hätte bemerken sollen, kamen je wieder in den Store. Kubernetes auf RED hatte dieses Problem nie, denn dort gehört der Store einem einzigen Prozess, und das Kubelet tauscht mit ihm nur Nachrichten aus. In THE sind die Daten geteilt, und ein Prozess, der in einem kritischen Abschnitt stirbt, reißt alle mit. Dijkstra schrieb offen, der erste große Fehler seiner Gruppe sei gewesen, für „eine perfekte Installation“ zu entwerfen und zu spät an Ausfälle zu denken. Ich habe ihren Fehler in den ersten fünf Minuten wiederholt :) Jetzt fällt ein Node zwischen zwei Durchläufen seiner Schleife aus, und der Cluster verschiebt seine Pods auf die lebenden Nodes. In GREEN funktioniert derselbe Entwurf, aber die Semaphoren sind wieder Server-Tasks, und ein Lauf kostet 1168 Rendezvous.
Ada 83 und was später zurückkam
Die siegreiche Ada wurde nicht sofort zu der Ada, die alle kennen. Zwischen der grünen Sprache vom Frühjahr 1979 und dem Standard von 1983 liegen vier Jahre Überarbeitung, und ich vergleiche beide mit der roten Sprache.
Damit der Vergleich nicht bloßes Gerede bleibt, habe ich drei Beispiele aus den RED-Labs genommen und in Ada 83 geschrieben, und die CI des Projekts baut diese Programme mit dem GNAT-Compiler im Ada-83-Modus und prüft ihre Ausgabe.
Das erste Beispiel ist ein beschränkter Puffer zwischen einem Erzeuger und einem Verbraucher. In RED ist das eine Zeile, VAR m : MAILBOX[INT](3), plus Aufrufe von SEND und RECEIVE. Ada 83 hat keine Mailboxen, also ist der Puffer ein Server-Task mit zwei Entries, der in einer Schleife auswählt, welchen Entry er gerade annehmen kann: PUT, solange Platz ist, und GET, solange es etwas herauszugeben gibt. Das sind rund dreißig Zeilen, die jeder, der Ada geschrieben hat, schon hundertmal geschrieben hat.
Das zweite ist das Warten auf eine Antwort mit Timeout auf der Seite des Aufrufers. In RED ist das ein WAIT mit zwei Zweigen. Ada 83 hat dafür den zeitgesteuerten Entry-Aufruf, select ... or delay ... end select. Die grüne Sprache von 1979 hatte ihn aber überhaupt nicht, weder den zeitgesteuerten noch den bedingten Aufruf. Die Green Rationale erklärt das als Grundsatzfrage: Ein Task kann sich immer nur in einer Warteschlange befinden, also wählt ein Aufrufer nicht zwischen mehreren Wartezuständen. Vier Jahre später hat Ada diesen Grundsatz teilweise aufgegeben.
Das dritte ist ein kritischer Abschnitt. In RED ist das REGION, das die Sperre freigibt, egal wie der Rumpf endet. In Ada 83 ist eine Sperre ein Task mit den Entries SEIZE und RELEASE, und tritt dazwischen eine Exception auf, gibt niemand die Sperre je wieder frei. Man muss daran denken, das im Handler zu tun, und genau davon handelt die Zeile LOCK.RELEASE; -- forget this line and the next SEIZE waits forever in meinem Programm.
Daneben liegen drei weitere kleine Beispiele, jedes dreimal geschrieben: in RED, in GREEN von 1979 und allein mit den Semaphoren von THE.
Das erste Beispiel handelt von einem Timeout: Der Erzeuger verstummt, und der Verbraucher muss es bemerken. In RED wartet der Verbraucher selbst auf ein Element, aber höchstens dreißig Millisekunden. GREEN hat 1979 keinen zeitgesteuerten Entry-Aufruf, also gibt nicht der Verbraucher auf, sondern der Puffer-Server: Sein select mit einer delay-Alternative teilt dem wartenden Aufrufer mit, dass nichts da ist. Und in THE hat P überhaupt keinen Timeout, also schiebt ein Watchdog an der Uhr ein falsches Element in den Puffer, um den Verbraucher zu wecken.
Das zweite Beispiel handelt von einem Ausfall unter einer Sperre. Ein REGION in RED gibt seine Sperre bei einer Exception frei, während ein Sperr-Task in GREEN und ein Semaphor in THE belegt bleiben und der zweite Worker ewig wartet.
Das dritte sind Leser und ein Schreiber. In RED reiht ein exklusives REGION alle hintereinander ein, und die Arbeit dauert vierzig Millisekunden. In GREEN gehören die Daten dem Server, der Kopien herausgibt, und das Lesen überlappt sich, sodass alles nach dreizehn Millisekunden fertig ist. Mit den Semaphoren von THE, nach Courtois, Heymans und Parnas von 1971, lesen die Leser gemeinsam, aber ein später Leser kommt vor einem Schreiber dran, der bereits wartet.
Das ergibt drei Mechanismen, und jeder hat seine eigene Antwort darauf, wem die Daten gehören, wer entscheidet, dass das Warten vorbei ist, und was passiert, wenn einer von ihnen stirbt.
Was Ada sich später zurückholte
Und jetzt der Teil, für den es sich meiner Meinung nach gelohnt hat, den ganzen Artikel zu schreiben. Legt man RED von 1979 neben die Geschichte von Ada bis heute, ergibt sich ein seltsames Bild: Vieles von dem, was das unterlegene RED sofort hatte, hat sich Ada über Jahre Stück für Stück zurückerkämpft.
Beide Finalisten hatten Assertions; Steelman verlangte sie. Ada 83 strich die assert-Anweisung; das Wort „assert“ kommt im Standard von 1983 nirgends vor. Das Pragma Assert kam erst mit Ada 2005 zurück, sechsundzwanzig Jahre später.
Das Rendezvous erwies sich als zu schwerfällig, um gemeinsam genutzte Daten zu schützen. Die Ada 95 Rationale sagt das ausdrücklich: Gerade die Allgemeinheit des Rendezvous bedeutet einen relativ hohen Overhead, deshalb werden Protected Objects (geschützte Objekte) eingeführt, ein leichtgewichtiger, datenorientierter Synchronisationsmechanismus. Im Kern ist das genau jenes eigenständige, primitive Konstrukt für gemeinsam genutzte Daten, das RED vorgeschlagen hatte. Eine wichtige Einschränkung: Die Ada 95 Rationale nennt Hoares bedingte kritische Regionen, Monitore und die Sprache Orca als Vorfahren der Protected Objects und erwähnt RED kein einziges Mal. Das ist also keine Übernahme, sondern Konvergenz. Allerdings eine vielsagende.
Ich habe geprüft, wie schwer das Rendezvous dort war, wo es am billigsten war: auf der Rational R1000, einer für Ada gebauten Maschine, deren Tasks direkt in ihrem Mikrocode lebten. Das dänische Computermuseum hat eine davon wieder zum Leben erweckt und einen Emulator geschrieben, der den echten Mikrocode Takt für Takt ausführt. Ich habe darin das Rational Environment gebootet, von den Platten des Museums, über die Operator-Konsole einen kleinen Ada-83-Test kompiliert und Takte gezählt. Ein Prozeduraufruf kostete die Maschine 2,75 Mikrosekunden, ein Rendezvous 55, etwa zwanzig Aufrufe. Derselbe Text, mit GNAT auf einem heutigen Server gebaut, ruft eine Prozedur in etwas mehr als einer Nanosekunde auf und schließt ein Rendezvous in 13,5 Mikrosekunden ab: zehntausend Aufrufe. Über diese Jahre ist ein Aufruf zweitausendmal billiger geworden, ein Rendezvous viermal. Die Protected Objects von Ada 95 kamen in eine Welt, in der Tasks nicht mehr im Mikrocode lebten, sondern in Threads des Betriebssystems.
Es geht noch weiter. Das Ravenscar-Profil für hochintegre Systeme verbietet Task-Entries ganz, Max_Task_Entries => 0, das heißt, die sicherheitskritischste Ada hat schlicht kein Rendezvous. Ada 2012 hat der Standardbibliothek beschränkte synchronisierte Warteschlangen hinzugefügt, die funktional eine typisierte, beschränkte Mailbox sind.
Eine andere Linie ist noch frappierender. Kapitel dreizehn des RED-Handbuchs beschreibt benutzerdefinierte Definitionen für die Sonderformen der Sprache: eine eigene Zuweisung, automatische Initialisierung und Finalisierung, eigene Operationen für Komponentenauswahl und Indizierung, eine eigene Schleife über einen benutzerdefinierten Typ und eigene Literale. Benutzerdefinierte Zuweisung und Finalisierung kamen 1995 zu Ada, benutzerdefinierte Indizierung und Iteratoren 2012, benutzerdefinierte Literale 2022. Es fehlt nur noch ein benutzerdefiniertes case.
Und noch etwas, das mich ehrlich überrascht hat. Die Revision von Ada begann 1988, und um 1990 gewann ein Team von Intermetrics den Designwettbewerb, sogar gegen das Team von Ichbiah selbst, der das GREEN-Projekt geleitet hatte. Technischer Leiter war Tucker Taft, und unter den Beratern war Ben Brosgol, der 1979 das Red-Projekt geleitet hatte. Ichbiah nahm als Gutachter teil und verließ das Projekt schließlich, weil er mit dem Objektmodell nicht einverstanden war. Ada 95 wurde also von Leuten aus der Firma entworfen, die 1979 verloren hatte. Taft selbst kam im September 1980 zu Intermetrics und war nie im Team Red, eine direkte Abstammungslinie gibt es hier also nicht. Aber die Firma, die Kultur und ein Teil der Menschen waren dieselben.
Was wäre, wenn … die Abstimmung anders ausgegangen wäre
Alternative Geschichte ist ein Genre, in dem man sich leicht alles Mögliche ausdenken kann, also habe ich den Aluhut vorsichtig aufgesetzt und mich sowohl an Weggabelungen gehalten, die es wirklich gab, als auch an Mechanismen, die sich tatsächlich nachverfolgen lassen. Das ergibt zwei Szenarien: Die rote Sprache gewinnt im Mai 1979, und die grüne Sprache wird in der Form eingefroren, in der sie im März eingereicht wurde, ohne vier Jahre Feinschliff.
Eine Welt, in der RED gewann
Beginnen wir mit dem, was sich ganz sicher nicht geändert hätte. Die Ada-Pflicht des US-Verteidigungsministeriums galt von 1987 bis 1997, zuerst als Direktive und später sogar als Zeile in einem Gesetz, und sie fiel nicht wegen Rendezvous oder Mailboxen, sondern weil der kommerzielle Markt sich zu C und C++ bewegt hatte und die Ada-Pflicht mehr zu kosten begann, als sie nützte. Diese Ökonomie hing nicht von der Farbe der Sprache ab. Eine rote Ada wäre also höchstwahrscheinlich genauso zur Sprache von Avionik, Eisenbahn und Raumfahrt geworden und genauso daran gescheitert, die Sprache für alles andere zu werden.
Innerhalb dieser Nische hätte sich allerdings vieles geändert.
Zuerst und vor allem die Nebenläufigkeit. In der roten Welt gibt es vom ersten Tag an zwei getrennte Mechanismen: Nachrichten, über die Tasks miteinander sprechen, und kritische Abschnitte für gemeinsam genutzte Daten. Ada brauchte sechzehn Jahre, um bei derselben Aufteilung anzukommen, und weitere zehn, um das Rendezvous in seiner hochintegren Variante ganz fallen zu lassen. In der roten Welt hätte das Buch von Burns, Lister und Wellings von 1987, „A Review of Ada Tasking“, von etwas ganz anderem gehandelt. An seine Stelle wäre ein anderes Problem getreten, vor dem Per Brinch Hansen, der die Monitore zusammen mit Hoare erfunden hat, bereits gewarnt hatte. Ein kritischer Abschnitt lässt sich überall hinsetzen, und in einem großen Programm verteilen sie sich über den ganzen Code: Jede Prozedur nimmt die Sperre um die gemeinsamen Daten selbst, und man sieht nicht mehr, wer diese Daten wann anfasst. Ein Monitor heilt das, indem er alle Operationen auf den gemeinsamen Daten an einem Ort sammelt. Ich vermute, dass die rote Ada bis Mitte der Achtziger ihre eigene Version der Protected Objects bekommen hätte, nur von der anderen Seite her, als Weg, verstreute Regionen in einem Modul zusammenzufassen.
Zweitens die Generics. Implizite Instanziierung an der Aufrufstelle, wie in RED, war sehr bequem, als ich einen Compiler darin schrieb. Sie hat aber einen bekannten Preis, den die Welt durch die Templates von C++ kennengelernt hat: Fehler, die tief in einer Instanz auftauchen, und aufgeblähter Code. In der roten Welt wären diese Probleme ein Jahrzehnt früher aufgetreten, in Militärprojekten mit ihren Zertifizierungsanforderungen, und vielleicht wäre genau dort zuerst jemand auf das gekommen, was später Concepts wurden. Zumal die NEEDS-Liste schon ein fertiger Entwurf von Concepts war.
Drittens die Sprachindustrie selbst. In seiner Geschichte von C++ schreibt Stroustrup offen, dass C++ nach 1985 von Ideen aus Ada, CLU (Barbara Liskovs Sprache vom MIT aus der Mitte der Siebziger, in der abstrakte Datentypen, Generics und Exceptions zuerst auftauchten) und ML beeinflusst wurde, dass er parametrisierte Typen und Exceptions mit denen von Ada verglich und dass ein Teil der Inspiration für die I/O-Streams von den letzten anderthalb Seiten der Ada Rationale von 1979 kam, die argumentierte, typsichere und knappe Ein- und Ausgabe sei unmöglich. Das war die Rationale des Green-Entwurfs, gedruckt in SIGPLAN Notices. In der roten Welt hätte stattdessen die RED Rationale dort gelegen, und die Templates von C++ wären mit einer Sprache verglichen worden, in der sich Instanzen selbst erzeugen. Vielleicht wären die Templates von C++ sogar einfacher geworden, ohne die Notwendigkeit, gegen Adas explizites new zu argumentieren.
Viertens Oracle. Die Dokumentation von Oracle sagt bis heute ausdrücklich, dass PL/SQL auf Ada basiert und Programme in der Datenbank als DIANA-Bäume speichert, Adas Zwischendarstellung. DIANA wurde im Januar 1981 auf einem Treffen erdacht, an dem unter anderem Nestor und Brosgol aus dem Team Red teilnahmen. In der roten Welt wäre PL/SQL auf RED aufgebaut worden, und jede Oracle-Datenbank enthielte heute Prozeduren mit Kapseln und EXPOSE. Vielleicht sogar mit DATA_LOCK für Zeilensperren, wer weiß.
Fünftens VHDL. Die Air Force gab die Hardwarebeschreibungssprache 1983 bei einem Konsortium aus Intermetrics, TI und IBM in Auftrag, und Intermetrics war dort der Sprachexperte. VHDL sah am Ende Ada sehr ähnlich. Die Ironie ist, dass die Firma der Verlierer eine Hardwaresprache nach dem Vorbild der siegreichen grünen baute. In der roten Welt hätten sie ihre eigene Sprache kopiert, und VHDL-Prozesse hätten vielleicht über Mailboxen statt über Signale kommuniziert.
Und sechstens das, womit ich am wenigsten gerechnet hatte. Erlang. Mitte der Achtziger verglich Ericsson Sprachen für Telefonvermittlungen, und Ada stand auf der Liste. Joe Armstrong schreibt, dass er zuerst Pipes ausprobierte, sie verwarf und Mailboxen baute. Es ist verlockend zu sagen, dass Erlang in der roten Welt nie nötig gewesen wäre. Das stimmt aber nicht: Erlang beruht auf Prozessisolation, asynchroner Nachrichtenübergabe per Kopie und Fehlerbehandlung, während RED gemeinsame Variablen hat und seine Mailboxen beschränkt und blockierend sind. Ich formuliere es also bescheidener: Eine rote Ada wäre Erlang näher gewesen als die grüne und hätte dem Militär und den Eisenbahnern vielleicht früher gezeigt, dass nachrichtenbasierte Systeme Systeme mit gemeinsamem Speicher überdauern. Mein dreihundert Zeilen langes Betriebssystem PAIRS handelt genau davon.
Eine Welt, in der die grüne Sprache 1979 eingefroren wurde
Das zweite Szenario ist bescheidener, aber interessanter, als es aussieht. Stellen Sie sich vor, es hätte nach der Auswahl keine vier Jahre Feinschliff gegeben, und Ada 83 wäre einfach Preliminary Ada vom Frühjahr 1979.
Dann hätte Ada von Anfang an eine assert-Anweisung gehabt, und die Gewohnheit, die eigenen Annahmen direkt im Code zu prüfen, hätte die Militärsoftware ein Vierteljahrhundert früher erreicht. Es hätte fünfzehn spezifische Exceptions statt fünf gegeben, und Programme würden eine Bereichsverletzung von einer Verletzung von Array-Grenzen unterscheiden, statt alles mit einem einzigen CONSTRAINT_ERROR abzufangen. Und es hätte die strengen Regeln zur Reinheit von Funktionen gegeben, genau die, die den Parser des grünen Compilers zwangen, als Prozeduren mit Out-Parametern geschrieben zu werden.
Es hätte keine Task-Typen gegeben. Man könnte kein Array von Tasks anlegen und keinen Task in einen Record stecken, nur Task-Familien und generische Tasks. Es gäbe keinen zeitgesteuerten Entry-Aufruf. Es gäbe keine terminate-Alternative, also müssten Server-Tasks explizit gestoppt werden. Ich glaube, das wäre das Erste gewesen, dessen Korrektur die Nutzer verlangt hätten, und zu Recht.
Was mir der Kern zu sein scheint
Lässt man die Details beiseite, ist der Unterschied zwischen der roten und der grünen Sprache der Unterschied zwischen zwei Antworten auf die Frage, wie viele Mechanismen eine Sprache braucht. Das Team Green wählte einen universellen Mechanismus, das Rendezvous, und erklärte ausführlich und schön, warum er für alles genügt. Das Team Red wählte mehrere spezialisierte: Nachrichten, Sperren, benutzerdefinierte Scheduler, benutzerdefinierte Sprachformen. Die grüne Antwort war leichter vorzuführen und leichter zu lernen. Die rote lag näher an dem, wo die Branche später ankam.
Und das ist, glaube ich, eine Lehre nicht über 1979, sondern über jede technologische Weggabelung, auch über die heutigen. Es gewinnt nicht der Entwurf, der sich unter realer Last besser hält, sondern der, der zuerst verständlich und stabil wird. Und was verloren hat, verschwindet nicht: Fünfzehn bis vierzig Jahre später kommt es unter anderem Namen zurück, und diesmal zahlt der Gewinner.
Labs
Wie in den früheren Teilen wollte ich, dass man über die Sprache nicht nur lesen, sondern mit eigenen Händen etwas kaputt machen kann. Das Verzeichnis impl/ada-colors/labs enthält zwölf RED-Übungen und ein Skript check.sh, das Ihre Version eines Programms übersetzt, ausführt und Ihnen sagt, ob Sie die Übung geschafft haben. Jedes Lab hat eine Nummer und mehrere Stufen: look, change, break und build. Nummer und Stufe sind die Argumente von check.sh, zum Beispiel labs/check.sh 03 look. Und weil die Zeit in den Programmen virtuell und der Scheduler deterministisch ist, können Sie Ihre Ausgabe Zeichen für Zeichen mit der eines anderen vergleichen.
Das ist enthalten:
01: eine Kapsel mit einem Stack: eine exportierte Funktionpeekhinzufügen, dann versuchen, von außen auf das Feldtopzuzugreifen, und zusehen, wie der Compiler erklärt, dass der Typ exportiert ist, seine Komponenten aber nicht;02: ein geschlossener Gültigkeitsbereich: eine Variable ausIMPORTSentfernen und abgewiesen werden, dann versuchen, einer nur lesend importierten Variable etwas zuzuweisen;03: eine Mailbox: ihre Größe auf null setzen und sehen, dass der Sender nicht mehr vorauslaufen kann; das ist ein Rendezvous;04:WAIT: ein Rennen gegen einen Timeout verlieren, dann versuchen, auf ein Senden an eine Mailbox der Größe null zu warten, und herausfinden, warum RED das verbietet;05:REGION: den Exception-Handler entfernen und sehen, wie die Laufzeitumgebung meldet, dass alle Tasks blockiert sind;06: Prioritäten: Tasks gleiche Prioritäten geben und die Reihenfolge nach Ankunft sehen;07: Generics: ein eigenesmaxfür Zahlen und Strings schreiben, ohne irgendetwas von Hand zu instanziieren;08: ein Prozesspaar: den Tod des Primärprozesses auf eine andere Anfrage verlegen, dann Antwort und Checkpoint vertauschen und die fehlende Überweisung mit der Prüfung erwischen;09: Kubernetes mit einer Control Plane als Prozesspaar: das Leeren der Warteschlange im Node-Controller entfernen und nach einem Failover gesunde Nodes evicted bekommen;10: der Compiler selbst:redceine eingebaute FunktionMAXhinzufügen, ihn neu bauen und sicherstellen, dass der Fixpunkt weiterhin hält;11: das Programm von 1979: eine Korrektur aus der Liste streichen und sehen, welcher Fehler im Original den Übersetzer stoppt;12: Dijkstras THE: den Segment-Controller jede Auslagerung auf die Trommel dem Operator melden lassen und zusehen, wie das ganze System einfriert, weil die Konsole genau den Controller braucht, der auf sie wartet.
Um das alles auszuführen, brauchen Sie nur einen C-Compiler und make:
git clone https://github.com/tym83/paleocomputing
cd paleocomputing/impl/ada-colors
make                     # builds redc from the ready-made C file and checks the fixed point
red/tests/run.sh         # language tests
os/run.sh                # the operating systems and every Kubernetes variant in every language
labs/check.sh 03 look    # the mailbox lab
Sie können ein RED-Programm auch ohne die Labs übersetzen und ausführen:
build/redc < program.red > program.c
cc -std=gnu11 -Irt program.c rt/paleo.c -lpthread -lm -o program
./program
Wenn Sie Cozystack zur Hand haben, eine offene Plattform, um auf Kubernetes eine Cloud aufzubauen, müssen Sie nichts installieren. Der Anwendungskatalog, den ich für diese Serie zusammengestellt habe, enthält eine Umgebung für Sprachen, und die Sprachen sind dort als eigenes Container-Image angekommen: Sie geben das Image ada-colors-run an, legen eine Quelldatei hinein, und das Programm läuft als einmaliger Kubernetes-Job, dessen Ausgabe zu seinem Log wird. Beim Bauen des Images gehen die Compiler den ganzen Weg erneut aus der gespeicherten C-Datei und prüfen, dass sie sich selbst reproduzieren.
Am einfachsten ist es aber, die Seite im Browser zu öffnen. Alles passiert direkt dort, ohne Server. Die Übersetzer, aus denselben C-Dateien nach WebAssembly gebaut, übersetzen den Quelltext nach C. Dann kompiliert clang, ebenfalls nach WebAssembly gebaut, dieses C, und das Programm läuft so, dass jeder Task seinen eigenen Thread bekommt und alle Threads sich einen Speicher teilen. Die Laufzeitumgebung ist dieselbe Datei wie unter Linux, mit derselben virtuellen Uhr, also geben die Labs, der PAIRS-Kernel, Kubernetes in RED und in GREEN, die Control Plane als Prozesspaar und die Beispiele aus Kapitel vierzehn des Handbuchs im Browser genau das aus, was sie auf einer gewöhnlichen Maschine ausgeben, Byte für Byte. Die CI prüft das: Sie führt jedes Beispiel in Headless Chrome aus und vergleicht die Ausgabe. Beim ersten Start wird der C-Compiler heruntergeladen, etwa zwanzig Megabyte, danach behält ihn der Browser.
Was ich mitnehme
Am Ende jedes Teils der Serie frage ich mich, was es sich lohnt, von meinen Funden in die heutige Infrastruktur mitzunehmen. Diesmal waren es überraschend viele Dinge.
Erstens: Mechanismen getrennt halten. Nachrichten dienen der Kommunikation, Sperren den gemeinsam genutzten Daten, und keiner der beiden Mechanismen gibt vor, der andere zu sein. Ada brauchte sechzehn Jahre, um an derselben Stelle anzukommen, und in der Kubernetes-Welt sehen wir ständig Versuche, alles mit einem Mechanismus abzudecken: eine Queue, die als Datenbank benutzt wird, oder eine Datenbank, die als Queue benutzt wird. Das Team Red verstand 1979 sehr genau, warum das nicht geht.
Zweitens: explizite Schnittstellen zum Zustand. IMPORTS in RED hat mich zuerst geärgert und dann begonnen, mir beim Lesen und Prüfen meines eigenen Codes zu helfen, auch wenn im Compiler selbst das Einfachste war, in den meisten Prozeduren IMPORTS ALL zu schreiben. In Infrastrukturcode, wo Controller, Operatoren und Hooks alle denselben Store anfassen, wäre eine solche Liste unbezahlbar, und stellenweise wird sie über Zugriffsrechte und Einschränkungen auf Feldebene faktisch schon eingeführt.
Drittens: Prozesspaare. Das ist wohl das Ergebnis, mit dem ich am wenigsten gerechnet hatte. Eine Kubernetes Control Plane, gebaut als Paar im Stil von Tandem, ohne Konsens, hat den Tod des API-Servers mitten in einem Rollout überlebt, weil die Controller Zustände vergleichen, statt auf Ereignisse zu reagieren. Für einen einzelnen Standort, an dem es oft schlicht nicht möglich ist, ein etcd-Quorum aus drei Nodes aufzubringen, ist das eine ernsthafte Alternative, und ich möchte sie nicht an einem Modell, sondern an einem echten Cluster testen.
Viertens: deterministische Zeit. Fast alles Interessante in diesem Artikel wurde gefunden, weil jeder Ausfall auf die Millisekunde genau reproduzierbar ist. So kamen die unfaire Auswahl in WAIT, der Bug mit dem abgebrochenen Entry-Aufruf und beide Fallen im Node-Controller ans Licht. Mit echten Threads und echten Uhren hätte ich nach der Hälfte davon wochenlang gesucht, und die andere Hälfte hätte ich nie gefunden. Für das Testen verteilter Infrastruktur ist das, glaube ich, die wichtigste Lehre: zuerst die Zeit kontrollierbar machen, dann nach Bugs suchen.
Und fünftens, gar nicht technisch. Die Verlierer zu studieren ist nicht aus Nostalgie nützlich, sondern damit man im Voraus weiß, welche Ideen zurückkommen werden, und nicht ein zweites Mal für sie bezahlt.
Wie es weitergeht. Die Gutachten zum Finale von 1979, das zwischen Red und Green entschied, existieren offenbar bis heute nur auf Mikrofiche, Karten aus Fotofilm mit verkleinerten Seiten, die man mit einer Lupe liest, und der Übersetzer von Red ist nie aufgetaucht. Wenn Sie Zugang zu einem von beiden haben, lassen Sie es mich wissen.
Quelltexte, Tests, Labs und alle Notizen liegen im Repository github.com/tym83/paleocomputing, unter impl/ada-colors. Wenn Sie einen Fehler in meiner Lesart der Handbücher von 1979 finden, sagen Sie es mir; das interessiert mich wirklich.
Frühere Teile der Paleocomputing-Serie:
- Teil 1. Wirths Prozessor, Project Oberon, eine neue Architektur in QEMU und KubeVirt und der Betrieb in Cozystack und Kubernetes
- Teil 2. Kubernetes in Oberon, Wirths Funk statt Netzwerk und ein Cluster im Browser
Häufig gestellte Fragen
Was waren RED und GREEN?
Was ist von RED heute noch übrig?
Warum hat GREEN gewonnen?
Was hat sich Ada später von RED zurückgeholt?
Kann eine Kubernetes Control Plane ohne etcd-Quorum funktionieren?
Wie kann ich RED und GREEN ausprobieren?
Testen Sie sich: die zwei Adas
5 questions · ~2 min