Auf einen Blick
- Prototyp: physis, Apache 2.0, github.com/kuberoot-dev/physis
- Kernobjekte: Problem, Substrate, Receipt, Mandate und Link; keine Node-Objekte
- Modellierte Physiken: 18; CPU und eine Apple-M4-GPU auf echter Hardware, 16 emuliert
- Hauptergebnis (Q3 2026): Energie −90 % und CO₂ −91 % gegenüber „Kubernetes heute“; −84 % CO₂ selbst am pessimistischen Ende jeder Annahme
- Conformance: 17/17 Tests auf fünf Testumgebungen, darunter ein Cluster aus vier Nodes auf Hetzner-Servern und ein Node ohne Container-Runtime
- Grundlage: kuberoot (Kubernetes 1.37), Workshop-Cluster von Cozystack
Quelle: github.com/kuberoot-dev/physis, results/ und docs/verification.md
Infrastruktur wird fast immer für die Aufgaben von gestern gebaut. Unix entstand für Time-Sharing-Rechner, TCP/IP für ein Netz, das den Ausfall von Knoten überstehen musste, und Borg für ein einzelnes Unternehmen mit eigenen Rechenzentren, in denen die Heterogenität der Hardware weitgehend hinter einem einheitlichen Ressourcenmodell verborgen blieb. Kubernetes hat von Borg fast alles übernommen, was unterhalb seiner API liegt. Jedes dieser Systeme war eine brillante Antwort auf seine eigenen Fragen, und jedes wurde anschließend über Jahrzehnte auf Fragen ausgedehnt, die sich seine Autoren nie gestellt hatten. Anders gesagt: Die Aufgaben von heute werden mit einer Konvention gelöst, auf die sich die Branche geeinigt hat, die aber nie dafür entworfen wurde.
Quanten-, photonisches, analoges, lebendes und Silizium-Computing laufen unter einer gemeinsamen Scheduling-Schicht zusammen
In diesem Artikel gehen wir das Problem vom anderen Ende an. Zuerst klären wir, welche Aufgaben morgen gelöst werden und wie die Physik des Rechnens, die Ökonomie und die Anforderungen an Vertrauen dann aussehen. Erst daraus leiten wir die passende Infrastrukturschicht ab und bauen einen Prototyp, der für eine Aufgabe nicht nur Ort und Zeit wählt, sondern auch die Physik der Berechnung selbst – von der CPU über den Quantencomputer bis zu lebenden Neuronen.
Ich habe mich diesem Thema schon mehrfach genähert; einmal haben wir sogar gemeinsam mit Kollegen versucht, es öffentlich in einer Folge des Kuber Community Podcast zu diskutieren. Seitdem habe ich mich still weiter durch Papers und Forschungsarbeiten zum Thema gearbeitet (natürlich ohne alles zu verstehen) und mir ein eigenes Bild davon gemacht, was uns morgen erwartet.
Man könnte sagen: Opa, nimm deine Tabletten, wozu brauchst du das überhaupt? Aber ich arbeite im Team, das die Plattform Cozystack baut, und ich möchte, dass Cozystack nicht nur die Aufgaben von heute löst, sondern auch in zwei Jahrzehnten noch relevant und frisch ist. Dafür müssen wir schon jetzt anfangen, über die Zukunft nachzudenken.
Der verstorbene Gennady Konstantinov von der HSE-Universität sagte – entweder im Podcast make sense oder in einem Vortrag auf einer der ProductSense-Konferenzen –, dass langfristige strategische Planung in einer Welt rascher Veränderungen weit wichtiger wird als in einer Welt, in der sich die Dinge vergleichsweise langsam ändern. Auf den ersten Blick wirkt der Gedanke kontraintuitiv, doch er hatte dafür eine einfache Metapher: Je schneller Ihr Auto fährt, desto weiter voraus müssen Sie schauen. Mich hat dieses Bild überzeugt.
Es wird viele Verweise auf Primärquellen geben. Sie sind trocken und schwer zugänglich, aber das ist der Weg.
Der Artikel ist lang, deshalb hier sein Aufbau:
- Wie wir morgen rechnen werden – die bereits sichtbaren Trends, von der Energiegrenze bis zum Rechnen auf Neuronen in der Petrischale.
- Die Ökonomie von übermorgen – wohin das Geld in der IT fließt und was das für Infrastruktur bedeutet.
- Menschen, Agenten und Vertrauen – was das Institute for the Future und die Future Today Strategy Group prognostizieren und wie sich das auf Infrastruktur abbilden lässt.
- Prinzipien, die sich aus diesen Trends ergeben.
- Ein Audit von Kubernetes: was es aus Sicht unserer Aufgabe richtig macht und was für die Welt von gestern gebaut wurde.
- Der Entwurf einer neuen Schicht: ohne das Konzept des Nodes, mit einem Scheduler, der die Physik wählt, einem Netz, in dem ein Teilnehmer nicht über seine IP-Adresse, sondern über eine kryptografisch überprüfbare Identität gefunden wird, und der Cloud als Markt von Substraten, also beliebiger Hardware, auf der Berechnungen laufen.
- Der Prototyp physis, der auf achtzehn verschiedenen Physiken des Rechnens läuft, zwei davon auf echter Hardware.
- Wie wir physis getestet haben und was dabei herauskam.
- Conformance für die Systeme von morgen – eine Testsuite, die jede Implementierung bestehen kann (wir haben sie selbst entworfen).
- Grenzen – wo wir uns irren könnten.
- Wie es weitergeht.
- Ungebetener Rat an die CNCF: wie sich Kubernetes jetzt weiterentwickeln lässt, damit es sowohl zur Welt von gestern als auch zur Welt von morgen passt – was im Kern bleiben und was steckbar werden sollte.
- Cozystack 3.0 als Plattform für die Infrastrukturschicht von morgen.
Code, Daten und Tests sind unter der Lizenz Apache 2.0 offen. Über Feedback würde ich mich freuen.
1. Wie wir morgen rechnen werden
Roy Amara, Präsident des Institute for the Future, formulierte das nach ihm benannte Gesetz: Wir überschätzen die Wirkung einer Technologie auf kurze Sicht und unterschätzen sie auf lange Sicht [1]. Im Folgenden geht es daher nicht um Prognosen, sondern um Trends, die bereits messbare Ausprägungen haben. Jeden davon werden wir später in eine Anforderung an Infrastruktur übersetzen.
F1. Energie wird zur wichtigsten Beschränkung
Im Jahr 2026 geben Amazon, Microsoft, Alphabet und Meta zusammen eine Größenordnung von 720–740 Milliarden US-Dollar für Infrastruktur aus [2]. Gartner prognostiziert die weltweiten IT-Ausgaben 2026 auf 6,37 Billionen US-Dollar, ein Plus von 14,2 % gegenüber dem Vorjahr [3]. Der Engpass sind jedoch nicht die Chips, sondern schlicht das Stromnetz. Der Netzanschluss eines großen Rechenzentrums dauert in einer Reihe von Regionen Jahre; der Kapazitätspreis bei PJM, dem größten Netzbetreiber im Osten der USA, stieg innerhalb von zwei Auktionen von 29 auf 330 US-Dollar pro Megawatt-Tag; für Gasturbinen gibt es mehrjährige Wartelisten; und die größten Cloud-Konzerne (die Hyperscaler) schließen Verträge mit Kernkraftwerken [4].
Energie hat auch eine Kehrseite, die meist vergessen wird. Die gesamte Energie, die ein Computer aufnimmt, wird zu Wärme. Streng genommen verwandelt Rechnen also Strom in Wärme und liefert dabei nebenbei einige Antworten auf die Fragen, die wir gestellt haben. Es gibt ein physikalisches Minimum, die Landauer-Grenze, also die Energie, die zum Löschen eines Bits nötig ist [5], und moderne Chips verbrauchen Größenordnungen mehr. Im Grenzfall stößt Rechnen aber nicht an die zugeführte Energie, sondern an die Fähigkeit, Wärme abzuführen. Daher Wasser zur Kühlung, Kryotechnik für Quanten- und supraleitende Maschinen und das Interesse an reversiblem Rechnen, das einen Teil der Energie zurückgewinnt.
Es gibt auch Beschränkungen, über die seltener gesprochen wird. Große Leistungstransformatoren hatten 2024 eine durchschnittliche Lieferzeit von 120 Wochen gegenüber 50 Wochen im Jahr 2021 [6], und auf Gasturbinen wartet man jahrelang [4]. Helium wird für die Kryotechnik von Quantenmaschinen und supraleitender Logik gebraucht. Sauerstoff dagegen wird nicht zur Beschränkung (das war für mich eine Offenbarung): Sämtliche weltweit verbrannten fossilen Brennstoffe senken zusammen mit allen anderen sauerstoffverbrauchenden Prozessen den Anteil dieses Gases in der Atmosphäre um etwa 19 Moleküle pro Million und Jahr, also um 0,002 % [7], und auf Rechenzentren entfällt davon nur ein kleiner Teil.
Was das für Infrastruktur bedeutet. Energie ist nicht länger ein einfacher Posten in Berichten und Rechnungen, sondern wird zu einer strategischen Ressource, die so geplant wird, wie heute CPU-Kerne geplant werden – und CO₂, der Preis pro Stunde und Wärme werden gemeinsam mit ihr betrachtet.
F2. Die Physik des Rechnens fächert sich auf
Bis vor Kurzem bedeutete heterogene Hardware CPUs und GPUs verschiedener Hersteller. Heute gibt es Maschinen, die auf grundlegend unterschiedliche Weise rechnen:
| Physik | Was es ist | Wo wir heute stehen |
|---|---|---|
| Analoges In-Memory-Computing | Matrixmultiplikation mit Strömen direkt in den Speicherzellen, ohne Daten hin- und herzubewegen | Der IBM-Chip HERMES auf Phasenwechselspeicher: 63,1 TOPS bei 9,76 TOPS/W, effektive Genauigkeit von 3–4 Bit [8] |
| Neuromorphe Chips | Kein Takt; die Berechnung läuft über Spike-Ereignisse | Hala Point bei Sandia: 1152 Loihi-2-Chips, 1,15 Milliarden Neuronen [9]; der erste Loihi benötigte etwa 20–25 pJ pro synaptischer Operation [10] |
| Probabilistische Computer auf p-Bits | Der Chip erzeugt Stichproben aus einer Verteilung und nutzt thermisches Rauschen als Ressource | Ein stochastischer magnetischer Tunnelkontakt – geschätzt etwa 2 fJ pro Zufallsbit [11]; die ersten Extropic-Geräte sind bei frühen Nutzern [12] |
| Ising-Maschinen | Ein Optimierungsproblem wird in ein physikalisches System kodiert, das von selbst in sein Energieminimum fällt | Ein FPGA mit Simulated Bifurcation löste MaxCut auf 2000 Knoten 124-mal schneller als ein optimiertes Simulated-Annealing-Verfahren [13]; optische Maschinen arbeiten bei Raumtemperatur [14] |
| Reversibles Rechnen | Die Logik gewinnt einen Teil der Schaltenergie zurück | Der Testchip von Vaire – rund 30 % Energieeinsparung bei derselben Aufgabe [15] |
| Supraleitende Logik | Schalten nahezu ohne Energie, aber bei 4 K | imec verspricht ein Rechenzentrum in Schuhkartongröße [16]; die Kühlung bei 4 K kostet nach der Carnot-Grenze mindestens 74 W pro Watt abgeführter Wärme, bei den besten Anlagen unter 400 W/W [17], bei gewöhnlichen Anlagen mit Collins- und Brayton-Kreisprozess etwa 740 W/W und bei kleinen Kryokühlern 5–7,5 kW/W [18] |
| Photonisches Rechnen | Multiplikation mit Licht | 0,27 pJ pro Multiply-Accumulate allein für den Laser in einem Laborprozessor [19] |
| Quantenprozessoren | Integriert in Supercomputing-Zentren unter einem herkömmlichen Scheduler | Das Zentrum PCSS in Poznań unter Slurm [20]; Googles supraleitende Sycamore-Anlage zog einschließlich Kryotechnik bis zu 26 kW [21] |
| Lebende Neuronen | Kulturen menschlicher Neuronen als Computer | Cortical Labs CL1 – aus menschlichen Stammzellen gezüchtete Neuronen auf einem Siliziumchip; kostet etwa 35.000 US-Dollar, zieht etwa 20 W, die Neuronen leben bis zu sechs Monate [22]; die Organoide von FinalSpark leben etwa 100 Tage [23] |
| Trainierbare Physik und rechnende Materialien | Schall, Licht und Mechanik werden wie ein neuronales Netz trainiert; ein Metamaterial arbeitet als Logik | Physikalische neuronale Netze [24]; ein mechanisches Metamaterial mit rekonfigurierbarer Logik [25] |
Neben dem Exotischen gibt es eine Welle weit bodenständigerer Architekturen. Sie ändern nicht die Physik des Schaltens, sondern die Art des Rechnens: wo es stattfindet, wie Zahlen dargestellt werden und welche Genauigkeit tatsächlich nötig ist. Genau diese werden in den kommenden Jahren in Rechenzentren ankommen.
| Architektur | Was sich ändert | Was bekannt ist |
|---|---|---|
| Systolische Tensor-Arrays | Matrixmultiplikation als Welle durch ein Gitter von Multiplizierern; Daten werden ohne Speicherzugriffe wiederverwendet | TPU v1: 65.536 Acht-Bit-Multiplizierer, 92 TOPS, 40 W unter Last, 30- bis 80-mal höhere TOPS/W als GPUs und CPUs ihrer Zeit [26]; TPU v4 – nochmals 2,7-mal bessere Leistung pro Watt [27] |
| Dataflow- und räumliche Prozessoren | Keine Caches oder Arbiter: Der Compiler legt den Datenfluss statisch über den Die, das Timing ist deterministisch | Groq TSP: etwa 750 TOPS int8 und 220 MiB SRAM auf dem Die [28]; Cerebras WSE-3 ist ein ganzer Wafer: 900.000 Kerne und 44 GB SRAM [29]; SambaNova SN40L verschmilzt die Operatoren eines Modells zu einer einzigen Pipeline [30] |
| Rechnen im DRAM | Recheneinheiten sitzen in den Speicherbänken; Daten wandern nicht zum Prozessor | Samsung HBM-PIM: 1,2 TFLOPS aus HBM2-Bänken [31], mit 3,5-mal weniger Energie pro übertragenem Bit [32]; UPMEM – Serienmodule, im Mittel 28- bis 93-mal schneller als eine CPU bei 13 von 16 PrIM-Benchmarks [33] |
| Reduzierte und Block-Genauigkeit | Genauigkeit wird zum Parameter: FP8, und in Microscaling-Formaten teilt sich ein Block von 32 Zahlen einen Skalierungsfaktor | FP8 erhält die Qualität des 16-Bit-Trainings bei Modellen mit bis zu 175 Milliarden Parametern [34]; Training mit MXFP4-Gewichten kostet nur einen geringen Genauigkeitsverlust [35]; eine Acht-Bit-Ganzzahlmultiplikation ist etwa 18-mal günstiger als eine 32-Bit-Gleitkommamultiplikation [36] |
| Stochastisches Rechnen | Eine Zahl ist der Anteil der Einsen in einem zufälligen Bitstrom; Multiplikation ist ein einzelnes Logikgatter | Die Genauigkeit wächst mit dem Logarithmus der Stromlänge, aber die Schaltung ist winzig und toleriert Bitfehler [37] |
| Hyperdimensionales Rechnen | Rechnen mit Zufallsvektoren mit Tausenden von Dimensionen: Binden, Bündeln, Vergleichen | Robust gegen den Ausfall einzelner Bits [38]; in Phasenwechselspeicher mehr als 6-mal weniger Energie als eine digitale Implementierung [39] |
| CGRAs und FPGAs | Statt eines Befehlsstroms ein Gitter von Recheneinheiten, das für die Aufgabe umkonfiguriert wird | Die meisten CGRAs schaffen mehr Operationen pro Watt als GPUs, einige um zwei Größenordnungen [40] |
Für die Steuerungsschicht ist diese Welle wichtiger als die exotischen Maschinen. Hier wird die Abwägung zwischen Qualität und Energie zur Routine. Dasselbe Modell ist in FP4 günstiger als in FP8, aber etwas ungenauer, und ob das genügt, sollte die Aufgabe selbst entscheiden, nicht der Programmierer.
Jede dieser Physiken hat ihre eigene Geschwindigkeit, Genauigkeit, ihr eigenes Rauschen, ihre eigene Kalibrierung und ihre eigenen Kosten pro Operation. Heterogenität bedeutet hier nicht „verschiedene Hersteller desselben Prinzips“, sondern verschiedene Arten zu rechnen.
Neue Physik bricht auch gewohnte betriebliche Annahmen. Den Zustand eines analogen Arrays, eines trainierten Metamaterials oder einer lebenden Kultur kann man nicht per „Snapshot“ sichern und auf eine andere Maschine verschieben; Migration läuft daher auf ein erneutes Training auf einem neuen Medium hinaus. Der eigentliche Zustand muss also außerhalb der Hardware leben, in der Beschreibung und den Trainingsdaten, und die Hardware wird zur reproduzierbaren Ausführung. Betrieb wird zur Pflege eines Organismus: Kalibrierung, Nachtraining, Alterung, Kryotechnik und bei Organoiden buchstäblich Fütterung. Und lebende Hardware bringt Ethik mit sich. Es ist die erste Infrastruktur, in der eine Ressource Rechte haben kann; die Plattform braucht deshalb Nutzungsrichtlinien, nicht nur RBAC.
Was das für Infrastruktur bedeutet. Eine Ressource lässt sich nicht mehr in Kernen und Gigabyte beschreiben. Sie muss über ihre Physik beschrieben werden: Operation, Geschwindigkeit, Energie pro Operation, Genauigkeit, Rauschen, Kalibrierfenster und Kapazität. Und der Scheduler muss die Physik genauso wählen, wie er einen Ort wählt.
F3. Die Grenzen von Maschine und Node verschwimmen
CXL ermöglicht Speicherpools und bietet bereits eine Speicherdomäne, die sich über Optik über das ganze Rechenzentrum erstreckt; ein Review in Nature Reviews Electrical Engineering nennt dies ausdrücklich ein Design „Rechenzentrum als einzelner Chip“ [41]. NVIDIA hat Vera Rubin Ultra mit 576 GPUs angekündigt, die über eine einzige NVLink-Switching-Fabric verbunden sind [42], und Oxide entwirft ein Rack statt eines Servers [43]. Der „Node“ als unteilbarer Server mit CPU, Speicher und Festplatten entspricht immer weniger der Art, wie moderne Hardware gebaut wird.
F4. Agenten werden zu den wichtigsten Nutzern
Agenten erhalten für jede Sitzung eine isolierte Sandbox, eine leichtgewichtige virtuelle Maschine (microVM) [44]. Zahlungsprotokolle von Maschine zu Maschine (x402, an die Linux Foundation übergeben, und AP2, an die FIDO übergeben) erlauben es einem Agenten, einen anderen Agenten im Rahmen eines Mandats eines Menschen zu bezahlen, also einer vom Menschen signierten Vollmacht, die festlegt, wie viel der Agent wo und bis wann ausgeben darf [45, 46]. Amy Webb von der Future Today Strategy Group nennt das das „nächste Internet“, gebaut für Agenten [47]. Der wichtigste Aufrufer der APIs der Infrastruktur von morgen wird eine Maschine sein, die Tausende Aufrufe pro Sekunde absetzt.
F5. Vertrauen ist nicht mehr umsonst
In seiner Prognose für 2036 hebt das Institute for the Future drei Themen rund um Wissen und Vertrauen hervor [48]: „Urteilsvermögen“ (discernment), also das, was an die Stelle der Heuristik „Sehen heißt Glauben“ tritt; eine Krise des wissenschaftlichen Wissens, in der generative Systeme auf Bestellung plausible Ergebnisse und gefälschte Zitate liefern; und die „vier Kulturen der KI“. Ein Jahr zuvor schrieb das IFTF gesondert über eine Krise des Nachweises, ein Mensch zu sein [1]. Die technische Antwort entsteht bereits: Hardware-Attestierung, Berechnungen über verschlüsselten Daten, die auf spezialisierte Beschleuniger wandern (vorerst FPGAs, ASICs in Entwicklung) [49], und formale Verifikation in Lean bei AWS [50]. Vertrauen wird nicht zu einer Emotion oder einem Gefühl, sondern zu einer strengen Datenstruktur, die sich überprüfen lässt.
F6. Rechenleistung wird zur Commodity
Der Preis, um ein festes Qualitätsniveau der Antworten von Sprachmodellen zu erreichen, fällt im Median um etwa das 50-Fache pro Jahr, je nach Aufgabe zwischen dem 9- und dem 900-Fachen [51]. Die Geschichte legt jedoch nahe, dass die Gesamtausgaben nicht sinken, sondern steigen. Das ist das Jevons-Paradoxon [52]: Eine Ressource, die billiger wird, wird immer stärker verbraucht. Die Börsen CME, ICE und Nodal bereiten Futures auf GPU-Stunden vor [53]. Die Abrechnung von Cloud-Software (SaaS) pro Arbeitsplatz weicht der Abrechnung nach Ergebnis [54]. Ab dem 12. Januar 2027 verbietet der EU Data Act Entgelte für den Wechsel des Cloud-Anbieters, einschließlich Gebühren für den Datenabfluss beim Umzug [55]. Rechenleistung hängt immer stärker von Energiepreisen und Abschreibungen ab, und Kunden werden durch Preis, Qualität und Vertrauen gehalten statt durch Vendor-Lock-in. In Berkeley hat man diese Logik bis zur Architektur des „Sky Computing“ zu Ende gedacht, bei der der Nutzer einen Job an einen Broker übergibt, der die Cloud selbst nach Preis und Verfügbarkeit auswählt [56].
F7. Rechnen wandert dorthin, wo es keine ständige Verbindung gibt
Physische KI, Roboter und Weltmodelle leben in einem geschlossenen Kreislauf aus „Datenerfassung – Training – Ausrollen auf Edge-Geräte – Feinabstimmung“ [57]. Das IFTF nennt den Wandel „von großen Sprachmodellen zu großen Weltmodellen“ eine der prägenden Kräfte des Jahrzehnts [48]. Rechenzentren werden sogar im Orbit geplant. Im Project Suncatcher will Google zusammen mit Planet Labs bis Anfang 2027 zwei Prototyp-Satelliten mit TPUs starten, und Starcloud hat bereits einen Satelliten mit einer NVIDIA-GPU in den Orbit gebracht [58]. Die Verbindung ist dort intermittierend, und für solche Umgebungen hat die IETF ein Store-and-Forward-Protokoll standardisiert, Bundle Protocol v7 [59]. Eine Steuerzentrale, die stets erreichbar sein muss, funktioniert dort nicht.
F8. Systeme werden zunehmend von Maschinen entworfen
In Berkeley fand ein Kreislauf aus „Generieren – Bewerten – Verfeinern“ für eine Reihe von Systemaufgaben Algorithmen, die besser sind als von Menschen entworfene (Scheduling über Cloud-Regionen, Lastverteilung über die „Experten“ in Mixture-of-Experts-Modellen (MoE), Transaktions-Scheduling): bis zu 5-mal schneller oder bis zu 50 % günstiger [60]. Der Engpass dieses Ansatzes ist ein präziser Bewerter. Infrastruktur braucht daher einen eingebauten digitalen Zwilling, also einen Simulator, der das Verhalten des realen Systems nachbildet, sowie Spezifikationen, an denen eine Maschine ihre eigenen Änderungen prüfen kann.
F9. Zustand ist wichtiger als Berechnung
Durable Execution, ein Ansatz, bei dem jeder Schritt eines Programms aufgezeichnet wird, sodass es nach einem Ausfall an derselben Stelle weiterläuft, macht den Programmzustand zum Primären und die Berechnung zu einem wiederherstellbaren Ausführenden; das Projekt DBOS begann als Forschung an „einem Betriebssystem, dessen gesamter Zustand in Datenbanktabellen gespeichert ist“ [61]. Hydro und das CALM-Theorem zeigen, welche verteilten Programme ohne Koordination auskommen [62, 63], während die Forschung von Ink & Switch zu Local-First-Software, bei der Daten primär auf dem Gerät des Nutzers leben, und zu „formbarer“ Software, die Nutzer für sich selbst umgestalten können, die Daten ihrem Eigentümer zurückgibt [64, 65]. Der Ausführende wird austauschbar, und der Wert verlagert sich auf die Daten und ihre Herkunft.
F10. Unsicherheit wird zur Norm
Probabilistische Chips liefern Stichproben, analoge ein Näherungsergebnis mit Rauschen, Quantenchips eine Verteilung von Ergebnissen über viele wiederholte Messungen, und KI-Modelle eine Antwort mit einem Konfidenzniveau. Die richtige Antwort wird durch eine Antwort ersetzt, die mit bekannter Wahrscheinlichkeit gut genug ist. Ein System, das nur „gewünschter Zustand: drei Replikas“ kennt, hat einer solchen Welt nichts zu sagen.
Vom Praktischen zum Wahnwitzigen
Ordnet man all das nach Reifegrad, ergibt sich folgende Leiter:
| Reifegrad | Was | Warum es für die Schicht wichtig ist |
|---|---|---|
| Bereits in Produktion | CXL-Speicherpools, optische Switching-Fabrics, microVMs für Agenten, Durable Execution, Verschieben von Jobs in Stunden mit saubererem Strom | Der Node ist nicht mehr die Einheit; Arbeit muss den Ausfall ihres Ausführenden überstehen |
| Die nächsten Jahre | KI, die Systeme entwirft; beweisbarer Code; Sprachen für die ganze Cloud; Broker über Clouds hinweg; Absicht statt Befehle | Zwillinge, Spezifikationen und ein Plan vor der Ausführung werden nötig |
| Andere Physik | Analoge, neuromorphe, probabilistische, photonische, reversible und supraleitende Maschinen; Quantenprozessoren im Rechenzentrum | Der Scheduler muss die Physik wählen |
| Wahnwitzig, aber finanziert | Rechenzentren im Orbit, DNA-Speicher im Rack [66], lebende Neuronen als Computer | Intermittierende Verbindung, begrenzte Lebensdauer der Hardware, Ethik der Ressource |
2. Die Ökonomie von übermorgen
Die IT erlebt einen beispiellosen Geldboom, und mit ihm wachsen die Schulden. Morgan Stanley schätzt, dass die Verschuldung von KI-Unternehmen 2026 die Marke von 500 Milliarden US-Dollar überschreiten wird [67], und die Bank of England warnt vor einer Fristeninkongruenz: Der Lebenszyklus von KI-Chips ist kurz und schwer vorherzusagen, während Kreditgeber lieber langfristig verleihen [68]. Holen die Umsätze die Investitionen nicht ein, erlebt die Welt, was sie 2001 schon einmal mit der Glasfaser gesehen hat: Die Investoren gingen bankrott, und die überschüssige Infrastruktur ging zum Schrottpreis an die nächste Generation über. Holen die Umsätze sie ein, wird Rechenleistung zu einer Versorgungsleistung – billig pro Einheit und gewaltig im Volumen. Und erweist sich Energie als der eigentliche Engpass, wird Rechenleistung an die Orte gebunden, an denen Energie verfügbar ist, und ihr Preis wird in Joule gerechnet.
In jedem dieser drei Szenarien formen dieselben Kräfte die Infrastruktur um:
- Die Werteinheit verschiebt sich von der SaaS-Lizenz pro Arbeitsplatz zur Aktion, zum Ergebnis, zum Token und schließlich zum Joule.
- Rechenleistung erhält einen Marktpreis, und damit braucht es Abrechnungsstandards und eine nachweisbare Leistungserbringung.
- Der Käufer ist eine Maschine, die jeden Aufruf innerhalb eines Budgets und eines Mandats bezahlt.
- Hardware hat eine kurze wirtschaftliche Lebensdauer, Gebäude eine lange. Fünf Generationen von Beschleunigern und dazu exotische Hardware werden in einem Pool stehen, und gewinnen wird, wer aus alter Hardware noch Geld herausholen kann.
- Energie ist der größte Kostenposten und zugleich eine neue Einnahmequelle. Arbeit, die sich verschieben lässt, bezahlt das Stromnetz selbst.
- Der Wechsel des Anbieters wird billiger, und Lock-in hört auf, ein Geschäftsmodell zu sein.
- Arbeit wird billiger. KI schreibt Code und betreibt Systeme, also muss die Plattform von Agenten bedienbar sein.
Daraus ergibt sich der Gedanke, den wir für den am wenigsten intuitiven dieses Abschnitts halten. Die größte wirtschaftliche Chance der kommenden Jahre liegt nicht darin, neue Kapazitäten zu bauen, sondern darin, das während der Blase bereits Gebaute günstig zu funktionierenden Clouds zusammenzufügen: gebrauchte GPUs, nicht ausgelastete Rechenzentren, nächtliche Energie, die Hardware kleiner Anbieter. Die Schicht, die diesen heterogenen Bestand in eine souveräne, messbare und überprüfbare Cloud verwandelt, wird in jedem Szenario gebraucht, ob bei einer sanften Landung oder bei einer Korrektur.
Die andere Seite der Energierechnung besteht aus Wärme, Wasser und CO₂. Die Schicht muss nicht nur die zugeführten Joule erfassen, sondern auch, wohin die Wärme geht. In Stockholm verkaufen Rechenzentren sie bereits an das Fernwärmenetz [69]. Sie muss außerdem erfassen, wie viel Wasser in die Kühlung geflossen ist und wie viel CO₂ hinter einem bestimmten Joule zu einer bestimmten Stunde an einem bestimmten Ort steht. Der Scheduler entscheidet dann nicht mehr, „wo der Strom am billigsten ist“, sondern „wo dieses Joule am günstigsten angekommen ist und am nützlichsten wieder hinausgeht“.
Wird Rechenleistung zur Ware und ist der Wechsel des Lieferanten kostenlos, arbeiten alle über eine einheitliche Schnittstelle, und die Unternehmen konkurrieren darüber, wie sie sie verpacken. Das ist bereits geschehen – mit dem Strom und der Normsteckdose, mit der S3-API und mit OpenAI-kompatiblen Schnittstellen für das Bereitstellen von Modellen. Ein Standard beseitigt den Wettbewerb in der Technik nicht; er verlagert ihn nach unten, in die Kosten des Joules, und nach oben, in das Produkt über dem Standard: Fachdomäne, Vertrauen, Komfort, Garantien. Doch das Modell der „einheitlichen Schnittstelle“ hat seine Grenzen. Ein Standard bleibt immer der kleinste gemeinsame Nenner. Er deckt ab, worauf sich alle einigen, also das Gestern, während alles Neue zuerst als Erweiterung eines bestimmten Herstellers auftaucht. Über Erweiterungen holen die Hersteller den Lock-in zurück, nach dem alten Rezept „embrace, extend, extinguish“. S3 etwa ist ein Standard, aber um ihn herum stehen Hunderte daran gekoppelter Dienste. Der Lock-in wandert aus der Technik in die Datengravitation (Petabytes an Daten brauchen lange für den Umzug, selbst wenn die Möglichkeit dazu nichts kostet), in Verträge und Mengenrabatte, in die Fähigkeiten des Teams und in die Integration mit Identitäts- und Audit-Systemen. Wem der Standard gehört, dem gehört der Markt. Indem Google Kubernetes öffnete, machte es genau die Schicht portabel, auf der der Lock-in beim Marktführer beruhte – eine Spielart von Joel Spolskys Strategie „commoditize your complements“ [70].
Das größte Risiko einer solchen Welt besteht darin, dass jemand die Schnittstelle vereinnahmt, sich darüber setzt und beginnt, eine Rente abzuschöpfen. Deshalb muss der Standard einer neutralen Stiftung gehören und durch offene Conformance-Tests überprüft werden.
Um die einheitliche Schnittstelle bildet sich ein Markt mit vier Rollen:
| Rolle | Wer | Worüber sie konkurrieren |
|---|---|---|
| Substrat-Anbieter | Eigentümer von Hardware jeder Physik, von Rechenzentren, Energie, freien Kapazitäten | Kosten pro Joule, Standort, Zuverlässigkeit |
| Methoden-Anbieter | Modelle, Solver, Compiler, die eine Aufgabe in eine Form für eine bestimmte Physik übersetzen, Algorithmen | Qualität pro Joule |
| Produkt-Anbieter | Wer Methoden und Substrate zu einem Ergebnis für den Kunden zusammenfügt: eine souveräne Cloud für eine Bank, eine GPU-Cloud für SaaS, KI für eine Klinik | Fachdomäne, Vertrauen, Komfort, Preisstruktur, Garantien – im Kern eine Versicherung des Ergebnisses |
| Konsumenten | Menschen und zunehmend Agenten | Ein Agent vergleicht Anbieter automatisch und sofort, der Markt wird dadurch sehr effizient |
Damit der Markt nicht zu einem App Store mit 30 % Provision verkommt, braucht es vier Bedingungen: einen Standard in der Hand einer neutralen Stiftung, offene Conformance, portable Abrechnung und Reputation sowie keinen verpflichtenden Vermittler zwischen Konsument und Anbieter.
3. Menschen, Agenten und Vertrauen
Das Institute for the Future veröffentlicht seit mehreren Jahrzehnten eine Zehnjahresprognose [1]. Die Ausgabe „2036 — What We Choose Next“ (Oktober 2026) besteht aus zehn Prognosen in drei Blöcken [48]:
- Vertrauen und Wissen: Urteilsvermögen in einer Welt, in der Sehen nicht mehr Glauben bedeutet; die Zukunft wissenschaftlichen Wissens; die „vier Kulturen der KI“ (ohne KI, durch KI erweitert, neben KI und von KI gesteuert).
- Wohin Macht und Kapital wandern: die „Muddle Powers“, deren Agenda eher die Energie als die Ideologie bestimmt; „China Is Everywhere“; die Welt nach der Finanzialisierung; das Ende des Versicherungsversprechens.
- Das Gewebe des Alltags: Einsamkeit, die zur prägenden sozialen Kraft des Jahrzehnts werden könnte; das Leben in extremer Hitze, in dem eine Erwärmung um 1,5 °C über das vorindustrielle Niveau (die vom Pariser Abkommen gesetzte Grenze) keine Obergrenze mehr ist, sondern der Ausgangspunkt; der Übergang von Sprachmodellen zu Weltmodellen.
Ein Jahr zuvor war das IFTF in seiner Ausgabe 2025–2035, „Strategy in the Age of Chaos“, von der Prämisse ausgegangen, dass die Betriebssysteme der Gesellschaft (Geld, Wissen, Klima, Bildung und sogar die Geburt) bis zur Unkenntlichkeit verändert werden [1]. Zu den Themen gehören Technik als neue Religion, KI als öffentliches Gut nach dem Modell der Daseinsvorsorge (Public Option AI), „post-epistemologische Wahrheit“, die Verglücksspielung von Märkten, die wie im Casino entstehen und verschwinden, das Leben in einer Welt, in der die Erwärmung die Grenze des Pariser Abkommens von 1,5 °C bereits überschritten hat, algorithmischer Schaden als Geschäftsmodell, ein „Backup der Zivilisation auf dem Mond“ und eine Krise beim Nachweis, dass man ein Mensch ist. Für die Infrastruktur sind hier zwei Fäden wichtig: KI und Rechenleistung als öffentliches Gut (ein Argument für eine offene Standardschicht, die keinem einzelnen Hersteller gehört) und Vertrauen, das von Grund auf neu aufgebaut werden muss.
2026 verkündete Amy Webbs Future Today Strategy Group die „schöpferische Zerstörung“ ihres klassischen Trendreports und stellte den Convergence Outlook über zusammenwachsende Technologien vor [47]. Zu diesen Konvergenzen zählen „living intelligence“ (KI, Sensorik und Biotechnologie) und „limitless labor“ (Agenten, Roboter und automatisierte Fabriken); gesondert spricht Webb vom „nächsten Internet“, das für Agenten gebaut wird.
Für die Infrastruktur folgen daraus zwei Schlüsse.
Wo der Mensch aufhört und der Agent beginnt. Der Mensch sollte festlegen, wofür er die Verantwortung trägt, also Werte, Grenzen und das Mandat. Das in Parameter zu übersetzen ist Aufgabe des Agenten. Ein Mensch sollte nicht „Genauigkeit 0,97 und 4096 Samples“ eingeben; er beantwortet die Fragen „Wie sicher muss die Antwort sein, wie viel bin ich zu zahlen bereit, bis wann, was darf nicht aufs Spiel gesetzt werden?“. Die Arbeit sollte nicht bei jedem Schritt anhalten und auf eine menschliche Unterschrift warten, sondern dort, wo ein Fehler teuer wäre: wenn sich eine Aktion schwer rückgängig machen lässt, wenn sie viel Geld kostet oder wenn ihre Folgen viele Menschen und Systeme betreffen. Je mehr dieser drei Merkmale zusammenkommen, desto früher sollte das System anhalten und einen Menschen fragen, wie es weitergehen soll. Das bestimmt, wie das System gebaut ist. Sein Kern ist für Programme ausgelegt, die die API aufrufen, und auf demselben Kern erhalten Menschen vertraute Werkzeuge: eine Konsole, Berichte und Monitoring-Dashboards. Der Code geht davon aus, dass der Aufrufer sich irren oder böswillig sein kann. Ein Mensch drückt einmal pro Minute einen Knopf, ein Agent dagegen setzt tausend Aufrufe pro Sekunde ab und sucht beharrlich nach Umwegen. Deshalb prüft der Server vor jeder Aktion selbst, ob sie ausgeführt werden darf: ob das Budget reicht, ob Zone und Rechtsraum zulässig sind, ob sie Regeln verletzt, die immer gelten müssen. Das geschieht gerade deshalb auf dem Server, weil ein Agent einen Knopf in der Oberfläche einfach umgehen würde. Jede Aktion wird entweder vollständig oder gar nicht ausgeführt, ohne halbfertige Zwischenzustände, und bevor sie läuft, gibt es einen Plan und eine Kostenschätzung. Manche Aktionen erfordern eine menschliche Unterschrift, die kryptografisch geprüft wird und nicht daran, ob es in der Oberfläche einen Knopf gibt. Und die „vier Kulturen der KI“ werden zu Autonomiestufen, also zu einer Einstellung statt zu getrennten Produkten (der Prototyp kennt drei; das Arbeiten ganz ohne KI bleibt außerhalb des Systems).
Vertrauen als Datenstruktur. Jedes Ergebnis sollte mit einer Quittung kommen, die festhält, wer gefragt hat und unter welchem Mandat, was berechnet wurde, worauf, aus welchen Daten, mit welcher Konfidenz und zu welchen Kosten. Quittungen werden signiert und verkettet, und jeder kann sie ohne Zugang zum System prüfen. Die IFTF-Prognose zum „Urteilsvermögen“ wird damit zu einer Eigenschaft der Infrastruktur: Vertrauen wird überprüft, statt nach Augenmaß beurteilt.
Auch Verifikation kostet Energie, deshalb wird ihre Tiefe nach dem Einsatz gewählt, von billig bis teuer:
- Signaturen und Herkunft – für alles.
- Hardware-Attestierung – der Nachweis, dass die Berechnung genau auf dem angegebenen Gerät am angegebenen Ort lief.
- Gegenprüfung auf einer anderen Physik oder bei einem anderen Anbieter.
- Ein statistisches Zertifikat für probabilistische Berechnungen, das Konfidenz statt „Korrektheit“ liefert.
- Ein formaler Beweis – für kritischen Code und kritische Richtlinien, wie bei Cedar von AWS [50].
Die Tiefe der Verifikation, von der Quittung für eine Routineaufgabe bis zum formalen Beweis für einen Zahlungskern, wird zu einer weiteren Größe im selben Kostenmodell, neben Zeit, Energie und Geld.
Die Quittungen selbst schreibt man am besten in ein Append-only-Log, in das Einträge nur hinzugefügt, aber nie geändert oder gelöscht werden können und das jeder von außen prüfen kann – nach dem Vorbild von Certificate Transparency [71, 72] oder des Rekor-Logs von Sigstore [73]. Dann lässt sich die Geschichte nicht nachträglich fälschen, und zwar nicht nur innerhalb der Kette eines einzelnen Agenten, sondern im gesamten System.
4. Prinzipien
Aus den zehn Kräften folgen vierzehn Prinzipien. Sie bilden zugleich die Grundlage der Conformance-Suite.
| # | Prinzip | Aus welchen Kräften |
|---|---|---|
| P1 | Die Schnittstelle bleibt, alles darunter ist austauschbar. Die Kubernetes-API ist die Sprache von heute; wer eine neue Sprache verlangt, verliert | F6; die Geschichte von Plan 9 und den Lisp-Maschinen |
| P2 | Eine Anfrage ist ein Ergebnis, keine Ressourcen. Qualität, Frist, Budget, zulässige Standorte; Algorithmus, Physik, Ort und Zeit zu wählen ist Sache des Systems | F2, F4, F6, F10 |
| P3 | Physik wird explizit beschrieben, und jede Zahl hat eine Herkunft | F2, F3 |
| P4 | Kosten sind ein Pflichtteil der Beschreibung. Jede Aufgabe und jeder Plan nennt Zeit, Energie, CO₂ und Geld, und es ist sichtbar, warum eine Variante eine andere schlägt | F1, F6 |
| P5 | Unsicherheit ist Teil des Versprechens des Systems. Qualität als Wahrscheinlichkeit mit unterer Schranke; nichts versprechen, was nicht gemessen wurde; nach Prognose planen, nach Fakten bewerten | F10, F5 |
| P6 | Geschlossener Regelkreis. Läufe trainieren die Modelle; ein digitaler Zwilling testet die Richtlinien | F8, F2 |
| P7 | Keine Nodes. Substrate holen sich die Arbeit selbst; ein Ausfall ist Arbeit, die nicht abgeholt wurde | F3, F7 |
| P8 | Lokale Autonomie. Begonnene Arbeit wird ohne die globale Ebene zu Ende geführt | F7 |
| P9 | Überprüfbarkeit des Ergebnisses. Signatur, Kette, Prüfung ohne Zugang zum System | F5 |
| P10 | Menschen setzen die Grenzen, Agenten handeln innerhalb davon: ein signiertes Mandat, Autonomiestufen | F4, F5 |
| P11 | Daten und Rechenleistung haben einen Ort und einen Rechtsraum; Souveränität ist eine harte Randbedingung | F5, F6 |
| P12 | Flexible Arbeit folgt sauberer und billiger Energie; dringende Arbeit wird nicht aufgeschoben | F1 |
| P13 | Ein offener Standard, durch Tests überprüft | F6 |
| P14 | Der Agent ist der erste Nutzer der API: strenge Schemata, ein Plan vor der Ausführung, Kosten vor dem Start | F4 |
5. Kubernetes auf dem Prüfstand
Kubernetes ist aus Borg [74] hervorgegangen, dem System eines einzelnen Unternehmens für langlebige Dienste und Batch-Jobs auf CPUs. Borg verbarg die Heterogenität der Maschinen größtenteils hinter einem einheitlichen Ressourcenmodell; in die API sickerte sie nur in Form von Maschinenattributen in Platzierungsbedingungen durch. Vieles daran ist richtig und wird bleiben.
Was richtig ist und bleibt
- Deklarative API und Reconciliation. Eine Ressource beschreibt eine Absicht, und ein Controller bringt die Welt dorthin. Diese Technik wird jede Physik überdauern.
- Erweiterbarkeit der API: CRDs, API-Aggregation, Abonnements auf Änderungen (list/watch), RBAC, Objektprüfungen bei der Admission. Genau deshalb werden die neuen Entitäten weiter unten hinzugefügt und nicht neu erfunden.
- Die Conformance-Kultur. Eine gemeinsame Testsuite hat Kubernetes zu einem Standard gemacht und nicht zu einem Produkt.
- Die Richtung von DRA. Der Kern von Dynamic Resource Allocation, seit Version 1.34 stabil, beschreibt Geräte mit strukturierten Attributen und wählt sie über Ausdrücke in CEL (Common Expression Language) aus [75]. Das ist ein erster Schritt hin zur Beschreibung von Physik, wenn auch noch ohne Kosten.
- Die Abkehr von iptables. Der nftables-Modus in kube-proxy wurde in 1.33 stabil (Standard ist weiterhin iptables), und der IPVS-Modus wurde in 1.35 als veraltet markiert [76, 77].
- Neutrale Governance in der CNCF.
Was für die Welt von gestern gebaut wurde
Der Node als Einheit von Platzierung, Identität und Ausfall. Ein Pod wird einem Node zugewiesen, kubelet ist der einzige Ausführende, und ein DaemonSet bedeutet „einer pro Node-Objekt“. Das bricht an drei Stellen. Hardware ist nicht mehr in gleichartige Server aufgeteilt (F3). Viele Substrate, etwa ein Quantenprozessor, eine Ising-Maschine oder ein analoges Array, sind überhaupt keine Computer mit Betriebssystem (F2). An Edge-Standorten und im Orbit ist „Node nicht erreichbar“ der Normalzustand und keine Störung (F7). Wir haben das im Projekt kuberoot durchgearbeitet: Der Versuch, mehrere Raspberry-Pi-Boards zu einem Node zusammenzukleben, scheitert am DaemonSet, weil jeder Agent auf dem „Node“ nur auf einer der mehreren Maschinen landet (der Artikel dazu ist noch nicht erschienen).
Die Bindung an Linux ist eine Eigenschaft des Nodes, nicht von Kubernetes. API, apiserver, etcd, Controller und Scheduler hängen nicht von Linux ab, und das Projekt kcp [78] hat längst gezeigt, dass die Kubernetes-API ganz ohne Nodes auskommen kann. Der Node-Agent kubelet ist an das Betriebssystem gebunden, aber nicht starr. Es gibt Windows-Nodes, und mit virtual-kubelet [79] kann sich alles Mögliche als „Node“ ausgeben, von einer Serverless-Cloud bis zur API eines Dritten. Durch und durch Linux bleibt nur die Arbeitseinheit, der Container. Die Frage „Kubernetes von Linux entkoppeln oder ein neues Betriebssystem schreiben“ ist also falsch gestellt. Ein einziges Betriebssystem, das „mit verschiedenen Physiken einheitlich arbeitet“, liefe auf den kleinsten gemeinsamen Nenner hinaus und würde genau das zunichtemachen, wofür man die jeweilige Physik überhaupt braucht – denn ein Quantenprozessor, eine Ising-Maschine und eine lebende Zellkultur sind keine Computer mit Betriebssystem, sondern Geräte mit eigenem Steuerungs-Stack. Bei NVIDIA-GPUs war die vereinheitlichende Schicht nicht Linux, sondern die Treiber und CUDA über dem Kernel. Vereinheitlicht werden muss die Schnittstelle des Substrat-Agenten, also die gemeinsamen Regeln, nach denen ein Agent für beliebige Hardware mit dem System spricht. Diese Regeln umfassen Lebenszyklus, Gesundheitszustand und Kalibrierung, Abrechnung und Attestierung. Für den klassischen Teil, der die Geräte betreut, genügt ein minimales Einzweck-Betriebssystem wie Talos [80] oder Hubris von Oxide [81].
Der Container als Arbeitseinheit. Er ist ein Linux-Prozess. Für CPUs ist das richtig, für ein Substrat, dessen Arbeitseinheit ein Quantenschaltkreis ist, eine Aufgabe in QUBO-Form (Quadratic Unconstrained Binary Optimization, das native Format von Ising-Maschinen) oder ein Satz Gewichte für ein Crossbar-Array, also ein Feld analoger Speicherzellen, dagegen falsch. Es gibt ein portables Prozessformat, das Container-Image nach OCI-Standard, aber kein portables Aufgabenformat. Gebraucht wird ein „OCI für Physik“, also eine portable Aufgabenbeschreibung plus für eine bestimmte Physik kompilierte Varianten. Der Container bleibt eine der Formen, geeignet für den klassischen Teil.
Das Ressourcenmodell: Kerne und Bytes. requests und limits werden in cpu und memory angegeben, Extended Resources werden als ganzzahlige Zähler geführt. Energie, Genauigkeit, Qualität oder Preis gibt es nicht.
Der Scheduler kennt nur das „Wo“. Er weiß nichts von Zeit und kann Arbeit nicht in eine saubere oder billige Stunde verschieben. Es gibt keine Wahl des Algorithmus oder der Physik. Es gibt keine Zielfunktion über Energie, CO₂ und Geld. Eine Frist wird als activeDeadlineSeconds eines Jobs ausgedrückt, nach deren Ablauf die Arbeit abgebrochen wird, und nicht als Ziel, auf das hin die Arbeit platziert wird.
Der Sollzustand ist eine deterministische Zahl. „Drei Replikas“ ist ein gutes Ziel für einen Dienst und ein schlechtes für ein probabilistisches Ergebnis.
Zentrales etcd. Kubernetes ist für Cluster mit höchstens 5000 Nodes, 150.000 Pods, 300.000 Containern und 110 Pods pro Node ausgelegt [82]; der gesamte Cluster-Zustand liegt in einem einzigen etcd, und verliert es sein Quorum, steht die Steuerung des ganzen Clusters still.
Keine überprüfbaren Ergebnisse. Das Audit-Log zeichnet API-Aufrufe auf, nicht aber, was berechnet wurde, worauf und zu welchen Kosten.
Konfiguration für Menschen. YAML und Helm-Templates werden von Menschen geschrieben, ein Agent dagegen braucht streng spezifizierte Anfragen, die der Server gegen ein Schema validiert, einen Plan vor dem Anwenden und serverseitige Budgets.
Die Ökonomie ist unsichtbar. Quotas zählen Objekte und Kerne, nicht Joule und Geld.
Der Netzwerk-Stack
Das Netzwerkmodell von Kubernetes verlangt, dass jeder Pod eine eigene IP-Adresse hat und Pods auf verschiedenen Nodes ohne NAT miteinander kommunizieren [83]. Die Implementierung des Netzwerks ist an CNI-Plugins delegiert, Services übernimmt kube-proxy oder einer seiner Ersatzbausteine auf Basis von eBPF, einer Technik, die kleine verifizierte Programme direkt im Linux-Kernel ausführt. Für ein einzelnes Rechenzentrum war das eine elegante Lösung. Sehen wir uns an, was daraus für morgen folgt.
| Eigenschaft | Warum es richtig war | Warum es morgen im Weg steht |
|---|---|---|
| Flaches adressierbares L3-Netz | Ein Rechenzentrum, vertrauenswürdiges Netz, Einfachheit für Anwendungen | Lässt sich nicht auf mehrere Standorte, Eigentümer, Rechtsräume und unterbrochene Verbindungen übertragen; Multi-Cluster muss angeflanscht werden |
| Identität wird über die IP-Adresse bestimmt | Kompatibilität mit Altsoftware | Eine Adresse ist kurzlebig, während Richtlinien, Audit und Quittungen sagen müssen, welches Programm oder welche Aufgabe handelt, und nicht, welche Adresse sie gerade hat |
| Ein Service ist eine virtuelle IP plus Regeln auf jedem Node | Transparent für Clients | Der Zustand wächst auf jedem Node mit der Zahl der Services und Endpunkte; iptables musste durch nftables ersetzt werden, IPVS wurde als veraltet markiert |
| Service Discovery über DNS | Standard | Caching und TTLs passen schlecht zu Workloads, die Sekunden leben |
| NetworkPolicy nach IP und Labels auf L3/L4 | Einfach | Keine gegenseitige Authentifizierung, keine Richtlinie „nach Zweck der Daten“, kein Rechtsraum |
| TCP als primärer Transport | Universalität | Für RPC innerhalb eines Rechenzentrums unterliegt TCP spezialisierten Protokollen; Ousterhout zeigt, dass seine Probleme grundlegend und miteinander verflochten sind, und Homa zeigt, dass ein Transport ohne sie möglich ist [84] |
| Datenübertragung ist für den Scheduler unsichtbar | Der Scheduler denkt in Prozessoren | Übertragung kostet Energie und Zeit und kann durch Souveränitätsvorgaben verboten sein. Aslan und Koautoren schätzen, dass die Datenübertragung über Kern- und Festnetz-Zugangsnetze 2015 0,06 kWh pro Gigabyte kostete und sich etwa alle zwei Jahre halbierte [85] |
| Konnektivität ist immer vorhanden | Ein Rechenzentrum | Edge-Standorte und Orbit leben mit Unterbrechungen; für sie gibt es Store-and-Forward (Bundle Protocol v7) [59] |
Ergebnis der Prüfung
| Kubernetes-Schicht | Entscheidung | Warum |
|---|---|---|
| API-Mechanismen (apiserver, CRD, watch, RBAC, admission) | Behalten | P1 |
| etcd als einziger Speicher | Neu schreiben als Hierarchie: lokaler Agentenzustand, regional und global nur für Geld, Berechtigungen und Audit | P8, F7 |
| Node und kubelet | Aus dem Kern entfernen, Kompatibilität über einen Agenten für „Linux-Prozesse“ | P7, F2, F3 |
| Pod und Container | Als eine Art von Arbeit behalten | P1, P2 |
| Ressourcenmodell cpu/memory | Ersetzen durch eine Beschreibung von Physik und Kosten, mit DRA als Brücke | P3, P4 |
| Scheduler | Neu schreiben als Optimierer über Algorithmus, Physik, Ort und Zeit | P2, P4, P12 |
| Netzwerk (flaches L3, VIP, IP-Richtlinien) | Neu schreiben rund um identitätsbasierte Adressierung und Verbindungen als bepreiste Objekte | P11, F5, F7 |
| API-Audit | Erweitern um Ergebnis-Quittungen | P9 |
| Quotas | Ersetzen durch Budgets in Joule, Geld und Gramm CO₂ unter einem Mandat | P10, P4 |
| Conformance | Technik behalten, Gegenstand erweitern | P13 |
6. Entwurf der neuen Schicht
Objekte
| Objekt | Was es beschreibt | Was es in Kubernetes ersetzt |
|---|---|---|
Substrate | Ein Substrat: seine Physik, sein Modell (Geschwindigkeit, Energie, Genauigkeit, Kalibrierung, Kapazität), Zone, Betreiber und Rechtsraum sowie Lebenszeichen seines Agenten | Node; der DRA-ResourceSlice ist ein Sonderfall ohne Kosten |
Link | Eine Verbindung: Latenz, Bandbreite, Joule pro Byte, die Rechtsräume, die der Pfad durchquert (Verfügbarkeitsfenster sind im Entwurf vorgesehen) | Kein Gegenstück; im Prototyp implementiert |
Problem | Arbeit als Ergebnis: Klasse, Instanz per Referenz (der Content-Hash geht in die Quittung ein), Qualität und Konfidenz, Frist, Budget, Policy, Flexibilität, zulässige Zonen und Rechtsräume, Ort der Daten | Ergänzt Pod und Job |
Plan im Status des Problem | Die gewählte Methode, Prognosen, die Trade-off-Front, die Physiken, auf denen die Aufgabe lösbar ist, Ablehnungsgründe | Kein Gegenstück |
Übernahme (claimedBy) | Ein Substrat hat die Arbeit übernommen | Bindung eines Pods an einen Node |
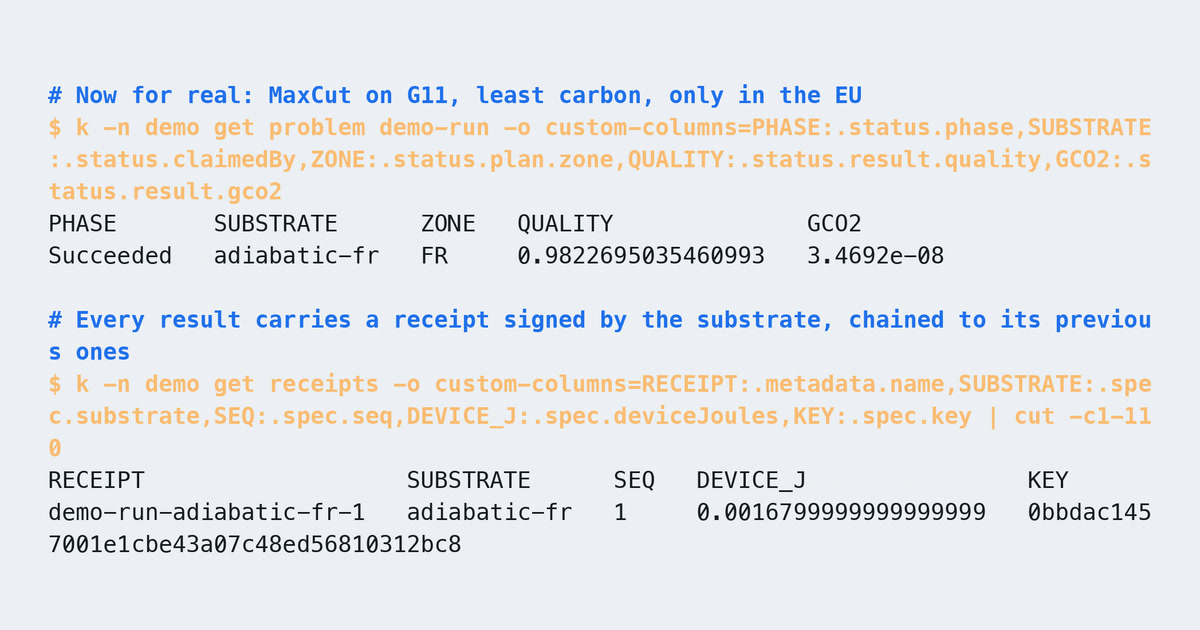
Receipt | Ein signierter Eintrag über das Ergebnis in einer Kette | Kein Gegenstück |
Mandate | Von einem Menschen signierte Delegation: Namespace, Tagesbudget, Zonen, Gültigkeitszeitraum, Autonomiestufe | Quotas |
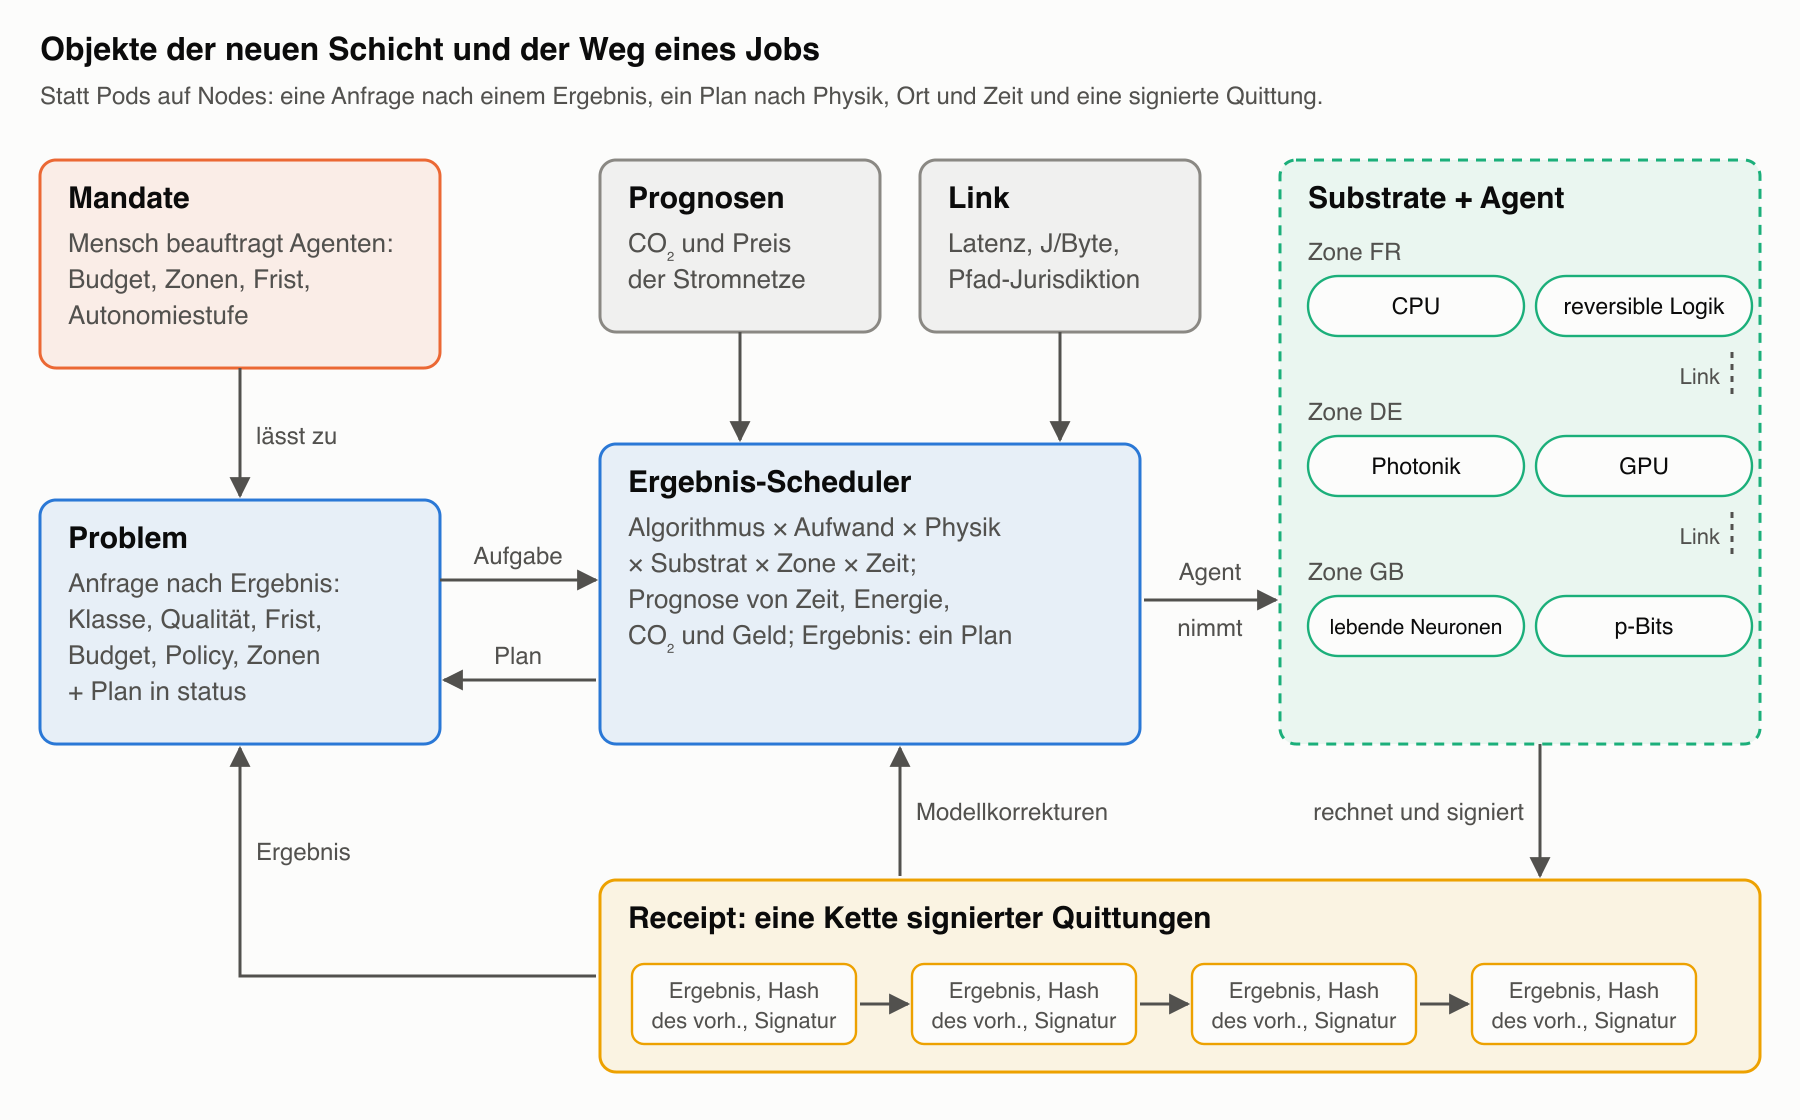
Objekte der neuen Schicht: Ein Mandat lässt eine Aufgabe zu, der Scheduler wählt anhand von Stromnetzprognosen und Verbindungen eine Methode, ein Substrat-Agent übernimmt die Arbeit, und eine signierte Quittung liefert das Ergebnis und Modellkorrekturen zurück
Lebenszyklus der Arbeit
- Ein Mensch oder ein Agent legt ein
Probleman. - Das Mandat wird geprüft: Die Signatur muss zu einem registrierten Menschen gehören, und der Gültigkeitszeitraum muss den aktuellen Zeitpunkt einschließen.
- Der Scheduler zählt Varianten nach Algorithmus, Aufwand, Physik, Substrat und Startzeit auf. Für jede sagt er Zeit, Energie, CO₂ und Geld voraus, verwirft Varianten, die Randbedingungen verletzen, wählt gemäß Policy und hält den Plan zusammen mit der Trade-off-Front fest, also der Menge der Varianten, bei denen man auf einer Achse nur auf Kosten einer anderen gewinnen kann (die Pareto-Front). Verlangt das Mandat eine Freigabe, wartet der Plan auf einen Menschen.
- Der Substrat-Agent sieht einen Plan, der auf seinen Namen lautet, wartet die Startzeit ab und übernimmt die Arbeit mit einem optimistischen Schreibvorgang, der die Version des Objekts prüft, sodass von zwei Agenten, die um dieselbe Arbeit konkurrieren, nur einer Erfolg hat.
- Der Agent rechnet, signiert eine Quittung und schreibt das Ergebnis. Ist die globale Ebene nicht erreichbar, wartet die Quittung in einer lokalen Warteschlange auf der Festplatte.
- Die Quittung aktualisiert die Qualitätsverteilungen und die Modellkorrekturen.
- Verstummt der Agent, bevor er die Arbeit übernommen hat, kehrt sie in den Pool zurück und wird erneut eingeplant.
Scheduling
Eine Aufgabe wird als Absicht beschrieben, und darunter liegt eine mehrstufige Darstellung nach dem Vorbild von MLIR, der Compiler-Infrastruktur, in der ein Programm schrittweise von allgemeinen Operationen zu Instruktionen für konkrete Hardware abgesenkt wird [86]: Aufgabe (Optimierung, Inferenz, Simulation) → Algorithmen (exakt, Annealing, Sampling, approximative Inferenz) → Physik → konkrete Geräte und Datenrouten. Der entscheidende Punkt ist, dass das Berechnungsmodell vom Scheduler gewählt wird, nicht vom Programmierer. Dieselbe Optimierung lässt sich exakt auf einer CPU in einer Stunde lösen, näherungsweise auf einer Ising-Maschine in einer Sekunde oder per Sampling auf p-Bits, und jede Methode hat ihre eigene Kurve aus Qualität, Energie und Zeit. Auf einem heterogenen Graphen mit schwankenden Preisen ist diese Wahl ein NP-schweres Problem, und niemand wird es exakt lösen. Gangbar ist der Weg über Heuristiken, die von KI erzeugt und ausgewählt und auf einem Simulator oder einem digitalen Zwilling validiert werden. Genau so arbeitet der ADRS-Ansatz [60].
Der Entscheidungsraum ist Algorithmus × Aufwand × Physik × Substrat × Zone × Startzeit. Im Kostenmodell wird die Zahl der Operationen (für Annealing und den Klassifikator ist sie vor dem Lauf exakt bekannt) mithilfe des Substratmodells in Zeit und Energie umgerechnet und dann mit den aus Quittungen gelernten Korrekturen sowie mit dem Faktor für die Energieeffizienz des Standorts multipliziert (PUE; im Prototyp ist das eine einzige Konstante von 1,2 für alle Standorte). Hinzu kommt die Energie für den Datentransport über die Verbindung. CO₂ wird aus der Prognose der CO₂-Intensität des Stromnetzes für das Ausführungsfenster berechnet, Geld aus dem Preis für die jeweilige Stunde.
Qualität ist definiert als untere Schranke der Wahrscheinlichkeit, das Ziel zu erreichen, gestützt auf beobachtete Läufe (das Wilson-Intervall). Gibt es keine Beobachtungen, wird die Variante nicht angeboten. Die Randbedingungen sind Frist, Budget, Zonen, Rechtsräume, Mandat, Kalibrierfenster und Kapazität.
Das Scheduling ist hierarchisch, und alle drei Ebenen funktionieren im Prototyp. Die globale Ebene arbeitet im Takt von Minuten und Stunden und wählt Zone und Startzeit anhand von Stromnetzprognosen und Preisen. Die Standortebene arbeitet im Sekundenbereich und wählt Substrat und Zeitpunkt innerhalb der Zone, deren Warteschlangen sie kennt. Die lokale Ebene lebt im Substrat-Agenten. Zeigen die jüngsten eigenen Ergebnisse des Geräts, dass der geplante Aufwand die geforderte Qualität mit der geforderten Konfidenz nicht mehr erreicht, erhöht der Agent den Aufwand um eine Stufe, signiert in der Quittung, was er tatsächlich ausgeführt hat, und der Scheduler lernt daraus. Die Ebenen melden sich über Lease-Objekte an, also über Leases, die eine Ebene regelmäßig erneuern muss, da sie sonst als verschwunden gilt. Es ist dieselbe Hierarchie, die man aus der Steuerung von Stromnetzen kennt; das Experiment auf der Testumgebung beschreibt Abschnitt 8.6.
Die unteren Ebenen dieser Hierarchie müssen ohne die globale Ebene auskommen können. Eine nützliche Idee dazu stammt von Dave Ackley von der University of New Mexico, der sie Robust-first Computing nennt [87]. Sein Modell der Movable Feast Machine und die physischen T2 Tiles beschreiben einen Rechner aus identischen Modulen ohne globalen Takt und ohne Master. Jede Kachel spricht nur mit ihren Nachbarn, Berechnung entsteht aus einer Population kleiner „Atome“ mit lokalen Regeln, Strukturen reparieren sich fortlaufend selbst, und Korrektheit wird nach dem Prinzip „best effort“ erreicht. Die Maschine lässt sich beliebig vergrößern, indem man einfach Kacheln hinzufügt. Ackley lehnt den Von-Neumann-Handel ab, bei dem vollkommen deterministische Hardware es der Software erlaubt, fragil zu sein. In Reinform ist das eher eine Philosophie als eine fertige Architektur, denn Überlebensfähigkeit wird mit Präzision und Debugbarkeit bezahlt. Für Edge-Standorte, Roboter und den Orbit aber, wo die globale Ebene per Definition nicht erreichbar ist, erweisen sich lokale Regeln und Abstimmung unter Nachbarn als die richtige Form. Zentrale Garantien bleiben dort, wo man nicht ohne sie auskommt, nämlich bei Geld, Berechtigungen und Audit.
Oft wird gefragt, ob ein Quantencomputer Kubernetes braucht. Innerhalb des Quantenprozessors nicht, denn das ist eine einzelne teure Maschine mit eigenem Steuerungsstack. Das ungelöste Problem liegt um ihn herum, und Forschende bezeichnen das Scheduling hybrider Workloads ausdrücklich als Lücke, der weniger Aufmerksamkeit zuteilwurde als der Integration des Software-Stacks [88]. Ein Quantenprozessor ist eine knappe, im Zeitmultiplex geteilte Ressource, deren Kalibrierung driftet. Variationelle Algorithmen durchlaufen tausendfach eine Schleife zwischen einem konventionellen Prozessor und dem Quantenprozessor (QPU), und ihre klassischen und quantenmechanischen Teile müssen mit minimaler Latenz nebeneinander platziert werden. Die Dekodierung für die Quantenfehlerkorrektur ist eine gewöhnliche klassische Berechnung, doch die Antwort wird innerhalb von Mikrosekunden gebraucht, also muss sie neben dem Quantenprozessor berechnet werden. Am PCSS (Poznań) etwa geschieht das mit Slurm und CUDA-Q [20]. In unserem Modell wird die QPU zu einem Substrat mit Kalibrierfenstern und Kryotechnikkosten, und die Aufgabe wird als Ergebnis formuliert.
Der Agent als erster Nutzer
Prinzip P14 besagt, dass die API in erster Linie für eine Maschine entworfen wird, während ein Mensch mit demselben Zustand über Konsole, Berichte und Dashboards arbeitet, die darauf aufsetzen. Lange bedeutete das im Prototyp nur, dass sich eine Aufgabe als Ergebnis statt als Satz von Ressourcen beschreiben ließ und dass man einen Plan anfordern konnte, ohne etwas auszuführen. Das reicht nicht. Ein Agent unterscheidet sich an der API von einem Menschen nicht nur dadurch, dass er ein Programm ist. Er ruft die API tausendmal auf, wo ein Mensch es einmal täte. Er wiederholt Anfragen, weil ihm ein Timeout nichts darüber sagt, ob die Arbeit angenommen wurde. Und er liest die Antwort nicht, sondern wählt anhand ihrer programmatisch seinen nächsten Schritt; eine Antwort, die nur ein Mensch verstehen kann, ist für einen Agenten also gar keine Antwort.
Daraus ergaben sich drei Änderungen im Kern. Die erste erlaubt Wiederholungen ohne doppelte Ausführung. Die Spezifikation der Aufgabe hat ein Feld requestID erhalten. Enthält der Namespace bereits eine Aufgabe mit derselben Kennung, plant der Scheduler die Kopie nicht ein, sondern lehnt sie ab und nennt im Feld status.duplicateOf das Original. Ein Agent, der nicht auf eine Antwort gewartet und die Aufgabe unter anderem Namen erneut eingereicht hat, erhält einen Verweis auf den ersten Versuch statt einer zweiten Rechnung für dieselbe Arbeit. Ein Dry Run belegt die Kennung nicht, weil er nichts ausführt; ebenso wenig ein Versuch, der als Duplikat oder wegen Überschreitung des Ratenlimits abgelehnt wurde, da eine Wiederholung nach einer solchen Ablehnung sonst an ihrem eigenen Fehlschlag scheitern würde.
Die zweite Änderung liefert Ablehnungen, aus denen ein Programm ableiten kann, was als Nächstes zu tun ist. Bisher war der Ablehnungsgrund nur Text: „Zone nicht zulässig“, „Budget überschritten“, „Frist nicht einhaltbar“. Der Text bleibt, doch daneben enthält status.reasonCodes nun stabile Codes: ZoneNotAllowed, JurisdictionNotAllowed, BudgetExceeded, QualityUnreachable, DeadlineTooShort, MandateInvalid, Duplicate, RateLimited und einige weitere. Ein Code ändert sich nicht, wenn sich die Formulierung ändert. Der Scheduler hält den Code jeder verworfenen Variante fest, nicht nur der zwanzig, deren Texte er als Beispiele aufbewahrt. Erhält ein Agent BudgetExceeded, kann er das Budget erhöhen oder die Qualitätsanforderung lockern; bei DeadlineTooShort kann er die Frist verschieben; bei QualityUnreachable kann er erkennen, dass es nicht am Geld liegt.
Die dritte Änderung schützt den Server vor seinem eigenen Hauptnutzer. Der Scheduler lässt pro Namespace und Minute nicht mehr als eine festgelegte Zahl neuer Aufgaben zu, standardmäßig sechzig; der Überschuss wird mit dem Code RateLimited abgelehnt und nicht eingeplant. Der apiserver schützt sich zwar selbst vor einer Flut von Anfragen als solcher, doch Scheduling kostet mehr als das Schreiben eines Objekts, weil für jede Aufgabe Algorithmen, Physiken, Orte und Startzeitfenster gegen Stromnetzprognosen durchgespielt werden müssen. Arbeit, die nach dem Verstummen eines Substrats in den Pool zurückkehrt, zählt nicht als neu.
Darüber hinaus braucht ein Agent einen Weg, all das zu entdecken, ohne etwas von CRDs und kubeconfig zu wissen. Dafür gibt es jetzt physis-mcp, einen Model-Context-Protocol-Server, über den das Programm, das den Agenten beherbergt, die verfügbaren Werkzeuge entdeckt und aufruft. Es sind fünf Werkzeuge: Substrate samt ihren Modellparametern und deren Herkunft auflisten, einen Plan mit Alternativen abrufen, ohne ihn auszuführen, eine Aufgabe einreichen (eine requestID ist Pflicht), ihren Zustand prüfen und die Quittungskette eines Substrats gegen seine veröffentlichten Schlüssel verifizieren, aktuelle wie widerrufene. Jedes Werkzeug hat ein striktes Schema, und ein unbekanntes Feld in den Argumenten wird als Fehler behandelt, nicht als Randbedingung, die stillschweigend wegfallen darf. Der Server hat keine eigenen Privilegien. Er ruft die API mit den Zugangsdaten des Agenten auf, und Mandate, Budgets und Ratenlimits gelten genau wie für jeden anderen Client.
Offen bleibt Folgendes. Eine Quittung bindet das Ergebnis noch nicht an einen bestimmten Agenten, weil der Name des Anfragenden aus einer Annotation stammt, die der Client selbst setzt. Ein Mandat wird für einen Namespace ausgestellt, nicht für einen Agenten, sodass sich zwei Agenten im selben Namespace ein Budget teilen. Das Fenster des Ratenlimits liegt im Speicher des Schedulers und geht bei einem Neustart verloren. Das System überträgt kein Geld zwischen Agent und Betreiber, obwohl es Budgets in Euro bereits gibt und Protokolle für maschinelle Zahlungen aufgekommen sind. Und die Conformance-Suite prüft den Schutz vor wiederholter Ausführung (Idempotenz), die Codes und das Ratenlimit noch nicht; abgedeckt sind sie nur durch Unit-Tests.
Netzwerk
- Adressierung nach Identität, nicht nach IP. Jede Aufgabe, jeder Dienst und jedes Substrat hat eine kryptografische Identität, also einen Schlüssel, an dem es sich eindeutig erkennen und verifizieren lässt. Policy, Audit und Quittungen sprechen in Identitäten, und IP wird zu einem Transportdetail innerhalb eines einzelnen Segments.
- Eine Verbindung ist ein Objekt mit Preis. Latenz, Bandbreite, Joule pro Byte, Verfügbarkeit über die Zeit, Rechtsraum des Pfads.
- Datentransport ist eine eingeplante Operation. Daten werden inhaltsadressiert, und „Datensatz X in Zone Y verschieben“ wird zu einem Planschritt mit Preis statt zu einem Nebeneffekt eines Starts.
- Transport nach Kontext. Innerhalb eines Rechenzentrums RPC-orientierte Protokolle wie Homa, zwischen Standorten QUIC, auf zeitweise unterbrochenen Verbindungen Store-and-Forward. Die Anwendung gibt die Zustellsemantik vor, nicht das Protokoll.
- Policy nach Zweck und Rechtsraum. Die Anforderung „Diese Daten werden nur in EU-Zonen von Betreibern verarbeitet, die X unterzeichnet haben“ wird zu einer Scheduling-Regel statt zu einem Satz von IP-Regeln auf Nodes.
- Gegenseitige Authentifizierung als Standard, weil es kein „vertrauenswürdiges internes Netz“ mehr gibt.
- Kein globaler flacher Adressraum. Die Konnektivität zwischen Standorten wird durch Verbindungen beschrieben, nicht durch die Forderung, dass „jeder jeden sieht“.
So sieht das in Objekten aus. Im Prototyp wird eine Verbindung durch die Ressource Link beschrieben, und der Scheduler berücksichtigt sie bei jeder Entscheidung, bei der eine Aufgabe Daten deklariert hat:
apiVersion: physis.kuberoot.dev/v1alpha1
kind: Link
metadata: {name: de-fr}
spec:
  from: DE
  to: FR
  jPerByte: 4.77e-06          # energy to transfer one byte
  latencySeconds: 0.01
  bytesPerSecond: 1.25e+09    # 10 Gbit/s
  pathJurisdictions: [EU]     # jurisdictions the path crosses
  source: "ref:aslan2018 …; bandwidth and latency: assumption"
Eine Aufgabe deklariert, wo ihre Daten liegen, wie viele es sind und in welchen Rechtsräumen sie verarbeitet werden dürfen:
spec:
  dataZone: GB
  dataBytes: 1.0e+9
  jurisdictions: [EU]
Daraus folgen drei Regeln, und alle drei sind durch Tests abgedeckt:
- Eine Übertragung kostet genau so viel Energie, wie die Verbindung angibt, und wird beim CO₂ mit der mittleren CO₂-Intensität der Endpunkte des Pfads verrechnet;
- die Arbeit beginnt nicht, bevor die Daten ankommen können: Die Übertragungszeit beträgt
dataBytes / bytesPerSecondzuzüglich Latenz; - gibt es zwischen den Zonen keine Verbindung oder durchquert der Pfad einen Rechtsraum, den die Aufgabe nicht zugelassen hat, ist die Variante nicht verfügbar, selbst wenn das Substrat am anderen Ende zulässig ist. Daten aus dem Vereinigten Königreich mit der Anforderung „nur EU“ gehen nicht nach Frankreich, weil der Pfad den britischen Rechtsraum durchquert.
Was aus dem heutigen Stack als Fundament taugt und was ersetzt wird:
| Heute | Rolle in der neuen Schicht |
|---|---|
| eBPF-basierte Verarbeitung von Netzwerkverkehr (zum Beispiel Cilium) | Bleibt als schneller lokaler Transport und als Mittel zur Durchsetzung von Policy an einem Standort |
| Gateway API | Bleibt als Standard zur Beschreibung eingehenden Verkehrs von außen; das Routing innerhalb des Substrat-Marktplatzes erfolgt über Identitäten und Verbindungen |
| SPIFFE (ein Standard für kryptografische Dienstidentitäten) und ähnliche Ansätze | Fundament für identitätsbasierte Adressierung und gegenseitige Authentifizierung |
| Multi-Cluster Services | Ersetzt durch Verbindungen als Objekte und Datentransport als Planschritt |
| kube-proxy und virtuelle IPs von Services | Werden zu einem Detail eines einzelnen Standorts statt zum Modell für das ganze System |
| NetworkPolicy nach IP und Labels | Ersetzt durch Policy nach Identität, Zweck und Rechtsraum, durchgesetzt vom Scheduler |
Der Migrationspfad sieht so aus. Zuerst erscheinen Verbindungen und Übertragungskosten als Objekte neben dem bestehenden Netz, und das leistet der Prototyp bereits. Danach wird Datentransport zu einem Planschritt mit Inhaltsadressierung. Anschließend ersetzt die Identität die IP in Policies und Quittungen. Das flache Netz des Clusters kann währenddessen innerhalb eines einzelnen Standorts so lange bestehen bleiben wie nötig.
Identitätsbasierte Adressierung: was bereits funktioniert
Bisher hatte der Prototyp von den sieben Punkten des Netzwerkabschnitts die Verbindung als Objekt mit Preis und Rechtsraum des Pfads umgesetzt, während identitätsbasierte Adressierung und gegenseitige Authentifizierung eine Beschreibung blieben. Ihr Kern funktioniert jetzt für Substrate und lässt sich mit Tests und auf der Testumgebung überprüfen.
Die Identität eines Substrats ist der Schlüssel, den der Agent ohnehin schon hatte. Der Agent signiert Quittungen mit einem Ed25519-Schlüssel, veröffentlicht ihn in status.publicKey und behält ihn über Neustarts hinweg. Derselbe Schlüssel dient nun auch als Netzwerkadresse. Es müssen keine neuen Zugangsdaten ausgestellt werden, und Daten werden von derselben Identität transportiert, die das Ergebnis signiert. Die Adresse wird als physis: geschrieben, gefolgt von der Base32-Kodierung des vollständigen Schlüssels plus zwei Prüfsummenbytes, zum Beispiel physis:mvmz7oylrc5wkjhfmz2jlai2kn3tuxjp37nxegq2tpv42btcy2ek7zq. Die Adresse enthält den ganzen Schlüssel, nicht nur ein Präfix davon. Dadurch ist sie selbstzertifizierend. Um zu bestätigen, dass die Gegenseite die genannte ist, muss man nichts nachschlagen und niemandem vertrauen – weder DNS noch einer IP-Adresse noch dem API-Server. Ein Tippfehler in der Adresse führt zu einem Prüfsummenfehler, nicht zu einem fremden Schlüssel.
Wo das Substrat gerade erreichbar ist, meldet der Agent selbst. Wird er mit dem Flag -listen gestartet, erscheint im Status des Substrats eine Liste von Endpunkten:
status:
  publicKey: 65599fbb...
  endpoints:
  - {transport: https, address: 10.0.3.7:7443}
Der Resolver, also der Dienst zur Auflösung von Identitäten, findet das Substrat, seine Zone, seinen Rechtsraum und seine Endpunkte. Ein bei der Rotation ausgemusterter Schlüssel führt nirgendwohin und taugt nur noch zur Prüfung alter Quittungen. Beanspruchen zwei Substrate denselben Schlüssel, verweigert der Resolver die Wahl, weil der Rechtsraum einer solchen Identität mehrdeutig ist und ein in ein fremdes Objekt kopierter öffentlicher Schlüssel nichts umleiten darf. Endpunkte dienen hier nur als Hinweise, und ihnen wird nicht vertraut. Der Schlüssel wird bei jeder Verbindung geprüft, und eine veraltete oder gefälschte Adresse führt zu einer Ablehnung, nicht zu fremden Daten.
Die gegenseitige Authentifizierung beruht auf TLS 1.3 auf beiden Seiten, wobei der Zertifikatsschlüssel der Identitätsschlüssel ist. Die Zertifikate sind selbstsigniert, und weder Zertifizierungsstelle noch Name noch Gültigkeitsdauer werden geprüft – nur der Schlüssel. TLS 1.3 ist selbst ein Challenge-Response-Verfahren, denn jede Seite signiert das Handshake-Transkript, das die Zufallsnonce der Gegenseite enthält, mit dem privaten Schlüssel ihres Zertifikats. Der Aufrufer prüft, ob der Schlüssel im Zertifikat zu der Partei gehört, die er erreichen wollte; die empfangende Seite erfährt aus dem Zertifikat, wer sich verbunden hat. Wir haben diesen Weg gewählt, statt jede Antwort über einfaches HTTP zu signieren, weil TLS Verschlüsselung, Schutz vor Replay und Integrität jedes Bytes über die Standardbibliothek liefert und nur noch der Abgleich des Schlüssels zu prüfen bleibt.
Darauf baut die Datenübertragung zwischen Agenten auf. Agent A fordert von Identität B ein Objekt nach Namen an. Der Client findet B über den Resolver, baut die Verbindung auf, prüft den Schlüssel und holt das Objekt in Teilstücken ab. Das erste Teilstück kommt zusammen mit dem Content-Hash, die übrigen werden unter der Bedingung angefordert, dass sich der Hash nicht geändert hat, und am Ende wird das gesamte Objekt gegen den Hash geprüft. Ist B umgezogen, unter anderer Adresse neu gestartet oder hat eine andere Maschine seine alte Adresse übernommen, bricht die Verbindung entweder ab oder scheitert an der Schlüsselprüfung. A findet B dann erneut über die Identität und setzt ab dem zuletzt empfangenen Byte fort. Eine Ablehnung durch B selbst, etwa aus Policy-Gründen, ist endgültig, und eine Wiederholung ist zwecklos. Der Test spielt genau dieses Szenario durch. B zieht mitten in der Übertragung um, und eine dritte Identität übernimmt seinen alten Port und liefert unter demselben Namen andere Bytes aus; A erkennt die Unterschiebung am Schlüssel, findet B erneut und erhält die Bytes von B.
Die Entscheidung „darf das gesendet werden“ trifft der Sender, und zwar anhand der Identität des Empfängers, nicht seiner Adresse. Die Regel ist dieselbe, die der Scheduler auf Datenpfade anwendet. Der Rechtsraum des Betreibers des Empfängers muss zu denen gehören, die für diese Daten zulässig sind, und wenn im Cluster Verbindungen deklariert sind, muss zwischen den Zonen von Sender und Empfänger eine Verbindung bestehen, deren Pfad keine verbotenen Rechtsräume durchquert. Eine Identität, hinter der kein Substrat steht, erhält nichts. Lassen sich die Verbindungen nicht lesen, wird die Übertragung verweigert, weil ein unbekanntes Netz nicht als offen gilt. Scheduler und Agent teilen sich jetzt den Code für diese Regel, sodass sie nicht auseinanderlaufen können.
Für ein Substrat hinter NAT, das nicht angewählt werden kann, aber selbst den API-Server erreicht, gibt es einen Ausweichweg über ein Postfach für kleine signierte Nachrichten. A legt eine Anfrage mit seiner Signatur und einer frischen Nonce ab; B holt sie ab, prüft die Signatur von A, wendet dieselbe Policy an und legt eine Antwort mit seiner eigenen Signatur ab, die die Nonce von A wiederholt. Eine Antwort lässt sich nicht im Namen von B fälschen, eine Anfrage nicht im Namen von A, und eine alte Antwort lässt sich nicht erneut einspielen. Die Antwort ist auf 256 KiB begrenzt. Das Protokoll ist geschrieben und gegen ein In-Memory-Postfach getestet, doch das Postfach auf API-Objekten ist noch nicht gebaut, und der Agent bietet diese Verbindungsart nicht an.
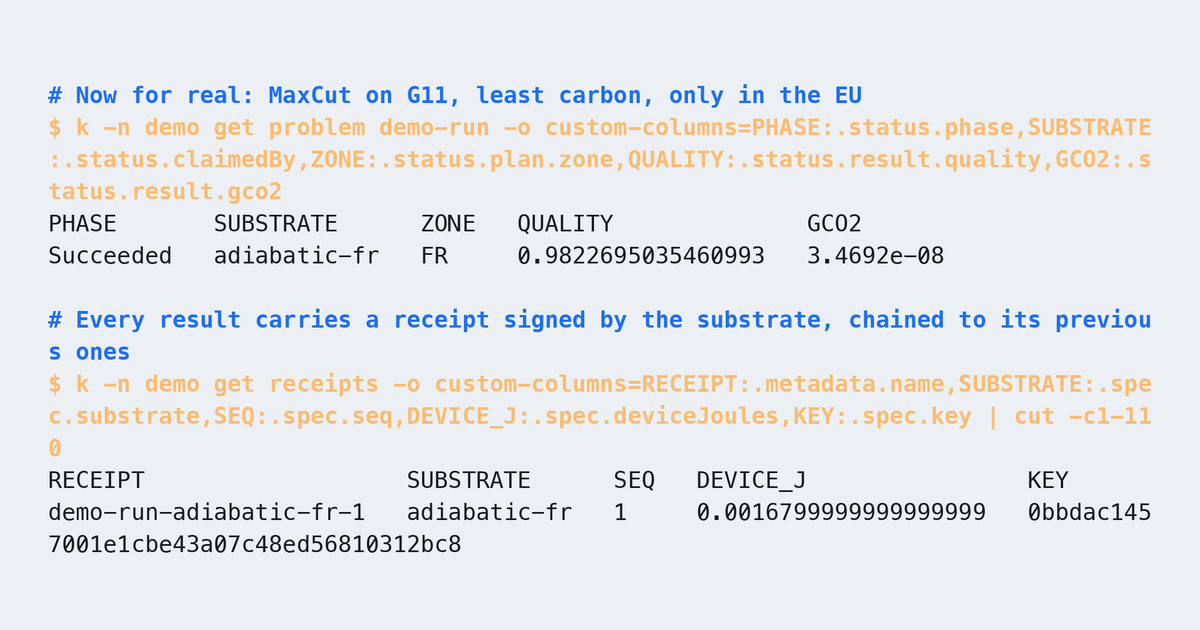
Auf der Node-freien Testumgebung sieht das so aus. Substrat B in Zone DE unter EU-Rechtsraum liefert eine 3-MB-Datei aus, die nur für die EU zugelassen ist. Agent A aus FR erhält sie, und die Bytes stimmen überein. Agent C aus dem Vereinigten Königreich bekommt eine Ablehnung: „substrate c is under UK jurisdiction, data allowed for [EU]“. B startet auf einem anderen Port neu, veröffentlicht einen neuen Endpunkt, und A erhält die Datei erneut unter derselben Adresse physis:…. Auf einem kuberoot-Cluster mit vier Nodes wurde das Experiment maschinenübergreifend wiederholt: Substrat B auf einem Node lieferte 3 MB an Agent A auf einem anderen Node, der Hash stimmte, und Agent C mit britischem Rechtsraum auf einem dritten Node wurde abgewiesen (results/identity-cluster.txt). All das ist standardmäßig abgeschaltet. Ohne -listen öffnet der Agent keinen Port und veröffentlicht nichts, sodass bestehende Testumgebungen und die Conformance-Suite unberührt bleiben.
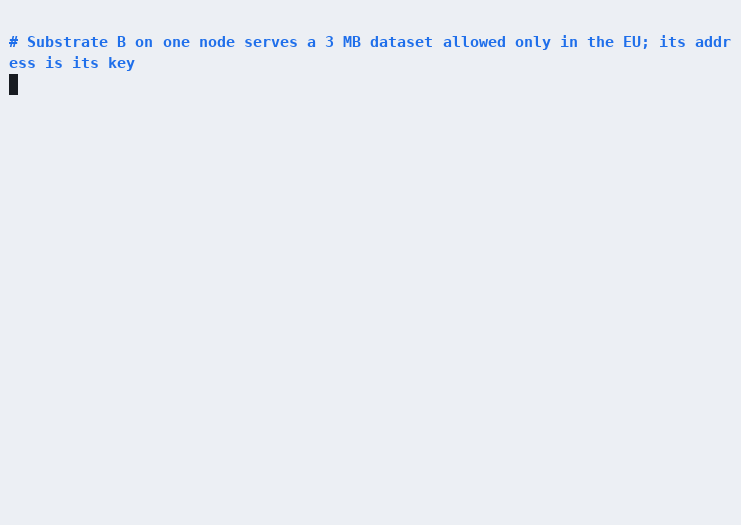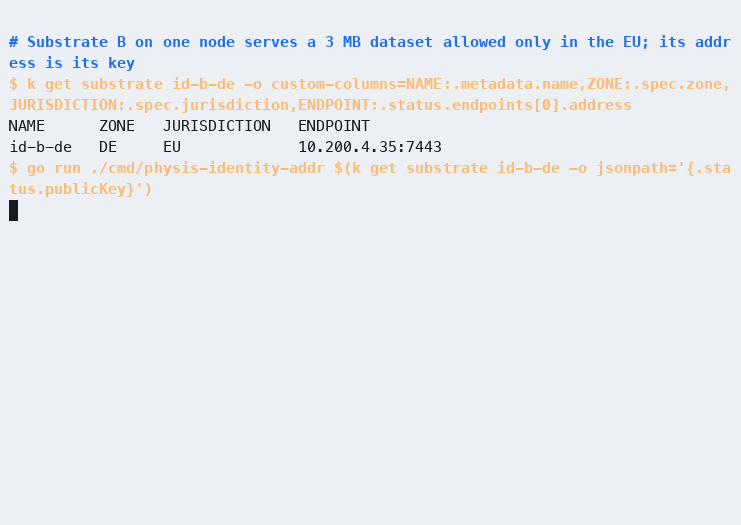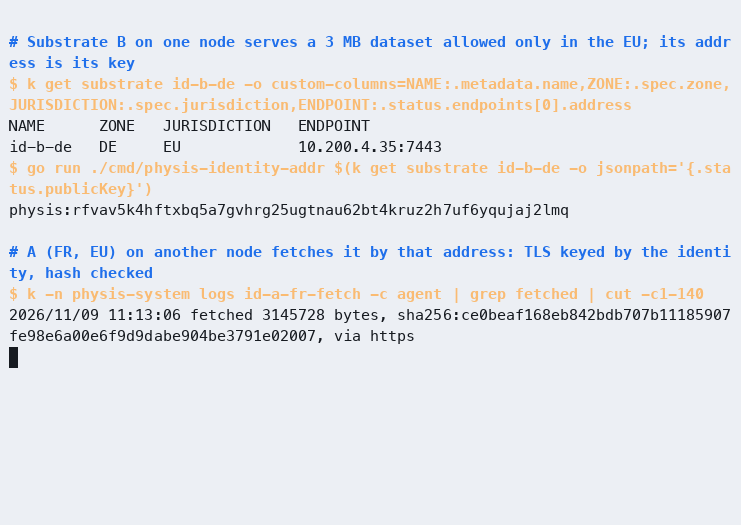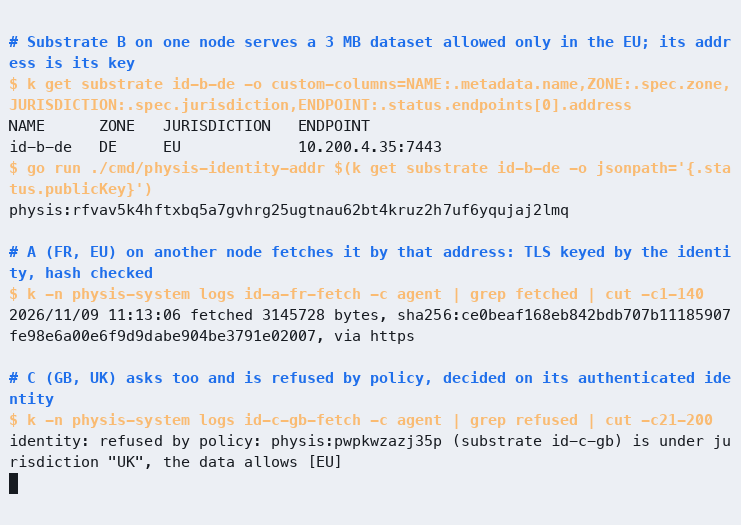
Identitätsbasiertes Netzwerk auf einem kuberoot-Cluster: eine aus dem Schlüssel abgeleitete Substratadresse, Datenabruf auf einem anderen Node und eine Ablehnung aus Gründen des Rechtsraums
Was das beweist und was nicht. Eine Gegenseite, die den Handshake abgeschlossen hat, besitzt den privaten Schlüssel der Identität. Ein API-Server, ein DNS oder ein Router, der über Endpunkte lügt, kann eine Übertragung stören, aber weder A dazu bringen, Bytes anzunehmen, die nicht von B stammen, noch B dazu, Daten an die falsche Identität herauszugeben. Der Rechtsraum des Substrats hingegen ergibt sich aus dem, was in der API über es deklariert ist, denn die Authentifizierung beweist, wer der Empfänger ist, nicht wo er sich befindet. Nachrichten über das Postfach sind signiert, aber nicht verschlüsselt. Das gesamte Objekt wird im Speicher gehalten, und der Speicher ist ein Verzeichnis mit Dateien. Es handelt sich um einen Protokollprototyp, nicht um einen produktionsreifen Mechanismus für die Datenübertragung.
Noch im Entwurfsstadium ist das Postfach auf API-Objekten mit Verschlüsselung für den Empfänger. Ebenso die Übertragung als Planschritt: Der Scheduler berechnet Kosten und Dauer einer Übertragung bereits, beauftragt sie aber noch nicht, und Daten werden durchgängig noch nach Namen statt nach Inhalt adressiert. Noch nicht implementiert sind Identitäten für Workloads, Datensätze und Mandate, nicht nur für Substrate, sowie eine SPIFFE-kompatible Form für bestehende Service Meshes, die sich um Verschlüsselung und Routing zwischen Diensten kümmern. Der Transport wird noch nicht nach Kontext gewählt. Es gibt nur einen, HTTP/1.1 über TLS 1.3 über TCP, während QUIC zwischen Standorten, Homa im Rechenzentrum und Multipath-Übertragung nur im Entwurf existieren. Auch Store-and-Forward über das Bundle Protocol für Verbindungen, die stundenlang ausfallen, ist nicht implementiert, denn die Wiederaufnahme in Teilstücken übersteht eine Unterbrechung von Sekunden oder Minuten, aber nicht von Stunden. kube-proxy und CNI wurden nicht ersetzt. Der Identitätskanal läuft über dem IP-Netz, das der Standort gerade hat, und Pod-Netz, Services und NetworkPolicy bleiben unberührt. Und es gibt keinen Nachweis des Standorts, sodass der Rechtsraum deklariert und nicht attestiert ist.
Der oben beschriebene Migrationspfad ist damit einen Schritt vorangekommen: Die Identität hat die IP-Adresse bereits dort ersetzt, wo Substrate einander Daten übertragen und entscheiden, ob diese gesendet werden dürfen.
Die Cloud als Substrat-Marktplatz und Souveränität
Wenn die Physik variiert und verschiedenen Eigentümern in verschiedenen Ländern gehört, bedeutet „Cloud“ nicht mehr einen Anbieter mit identischen Servern. Die Cloud wird zu einem Marktplatz von Substraten, die über eine gemeinsame Schnittstelle verbunden sind. Anbieter (einer mit einer Ising-Maschine in Polen, ein anderer mit einem Quantenprozessor in Deutschland, ein weiterer mit analogen Beschleunigern in Frankreich) veröffentlichen ein Substrate mit Modell, Preis und Rechtsraum. Der Scheduler wählt nach Ergebnis und Kosten. Souveränität (Rechtsraum des Betreibers, Ort der Daten, Pfad der Daten, Attestierung des Substrats) wird zu einer harten Scheduling-Randbedingung statt zu einem Häkchen im Vertrag. Hybrid hört dann auf, eine Architektur nach dem Muster „ein bisschen eigenes, ein bisschen öffentliches“ zu sein, und wird zur Norm, weil jede Aufgabe auf jede Physik bei jedem Eigentümer gehen kann, solange das Mandat es erlaubt und es sich lohnt.
Kompatibilität
Die neuen Entitäten sind als CRDs auf einem Standard-apiserver implementiert, sodass kubectl, RBAC und GitOps (die Verwaltung eines Clusters über in Git abgelegte Beschreibungen) ohne Weiteres mit ihnen funktionieren. Pods und Container bleiben das Substrat „Linux-Prozesse“ für Legacy-Software, hören aber auf, das Zentrum des Systems zu sein.
Die Brücke von der heutigen Gerätebeschreibung steht. Ein DRA-Treiber veröffentlicht Geräte in einem ResourceSlice; physis-dra-bridge macht aus jedem erkannten Gerät ein Substrate. DRA kennt kein Kostenmodell, daher kann ein Treiber eines als Attribute in der Domäne physis.kuberoot.dev hinzufügen; was er angibt, wird mit Verweis auf den Treiber zitiert, und alles, was er nicht angibt, wird aus dem Referenzmodell für diese Physik übernommen und als Annahme gekennzeichnet. Die Brücke schreibt nur die Beschreibung, und lebendig wird das Substrat erst, wenn ein Agent es bedient (physis-agent -adopt); ein Gerät, das beschrieben, aber von niemandem bedient wird, landet also nie in einem Plan. Damit das funktioniert, baut der Scheduler das Modell jedes Substrats jetzt aus dem auf, was das Substrat über sich selbst veröffentlicht, statt aus einer eingebauten Tabelle.
Und ein Substrat-Agent muss kein Container mehr sein, nicht einmal ein Linux-Prozess. Der Gerätekern – die Berechnung und das Signieren mit einem Schlüssel, der nur dort liegt – wurde in ein eigenes Programm ausgelagert, physis-device, das JSON-Nachrichten, eine pro Zeile, über Standardeingabe und Standardausgabe austauscht und weder Netzwerk noch Sockets noch Linux benötigt. Es lässt sich nach WebAssembly (WASI) kompilieren und läuft in einer Sandbox; der Agent darum herum kümmert sich nur um das Netzwerk und bekommt den Schlüssel nie zu sehen. Dasselbe Protokoll funktioniert für einen Mikrocontroller an einer seriellen Schnittstelle. Für kuberoot gibt es eine containerfreie Distribution (deploy/kuberoot-distro), in der ein Node nur den Kernel, init, den API-Server mit eigenem Speicher, den Controller Manager, die Node-API und physis selbst als Node-Dienste ausführt, ohne kubelet, containerd oder Pods. Sie ist gebaut, auf einem Server gebootet und besteht die Conformance (Abschnitt 8.6).
7. Der Prototyp physis
Um den Entwurf zu überprüfen, haben wir einen Prototyp gebaut. Wir nannten ihn physis – das griechische Wort für „Natur“ im Sinne von „die Art, wie ein Ding beschaffen ist“. Er umfasst rund elftausend Zeilen Go unter der Lizenz Apache 2.0. Der Prototyp implementiert genau die oben beschriebenen Objekte auf einem unveränderten kube-apiserver und lässt sich als kubepkg-Paket oder als Helm-Chart in kuberoot installieren; Scheduler und Agenten laufen als gewöhnliche Pods.
Was drinsteckt
| Komponente | Aufgabe |
|---|---|
physis-scheduler | Beobachtet Problem-Objekte, prüft Mandate, plant über die verfügbaren Substrate und aktuelle Netzprognosen hinweg und hält den Plan samt seinen Alternativen fest. Selbst führt er nichts aus und bindet nichts an Nodes |
physis-agent | Ein Agent pro Substrat. Veröffentlicht das Modell des Substrats, sendet regelmäßig ein Lebenszeichen (Heartbeat), übernimmt die für dieses Substrat geplante Arbeit, führt sie aus, signiert eine Quittung und meldet das Ergebnis. Ein gewöhnliches Deployment ohne Node-Affinität |
physis-conformance | Eine Suite aus 17 Black-Box-Tests (Abschnitt 9) |
physis-calibrate | Führt jeden Algorithmus auf jeder Physik aus und erstellt Qualitätsverteilungen |
physis-sim | Ein digitaler Zwilling: dieselbe Scheduler-Logik, angewandt auf einen Strom von Aufgaben und ein Quartal realer Netzdaten |
physis-data | Lädt Netzdaten |
CRDs Substrate, Problem, Receipt, Mandate, Link | Die Objekte der Schicht auf einem unveränderten kube-apiserver; Link beschreibt das Netz zwischen Zonen als Pfade mit Kosten |
Die zentrale Architekturentscheidung lautet: Der Code enthält keinen einzigen Verweis auf Node-Objekte. Die RBAC-Rollen, die physis erhält, gewähren weder Zugriff auf Nodes noch auf Pods, und der Conformance-Test TC-02 prüft genau das. Arbeit wird über einen optimistischen Schreibvorgang in den Status der Aufgabe übernommen: Konkurrieren zwei Agenten um dieselbe Arbeit, gewinnt derjenige, dessen Schreibvorgang mit der aktuellen Objektversion eintrifft.
Zwei Aufgaben
Ein fairer Vergleich von Physiken braucht Aufgaben, die sich natürlich auf sie abbilden lassen.
MaxCut sucht eine Aufteilung der Knoten eines Graphen in zwei Gruppen, die das Gesamtgewicht der Kanten zwischen den Gruppen maximiert. Es ist ein klassisches NP-schweres Problem und zugleich die kanonische Aufgabe für Ising-Maschinen. Ordnet man jedem Knoten einen „Spin“ von ±1 zu, entspricht der Schnitt bis auf Vorzeichen und eine Konstante der Energie eines Ising-Modells. Wir verwenden die Standardsammlung Gset (Helmberg und Rendl), konkret die Graphen G1, G2, G11, G14, G22 und G43 mit 800 bis 2000 Knoten. Für G1, G2 und G22 haben wir die veröffentlichten besten bekannten Schnitte in zwei unabhängigen Quellen bestätigt [89]. Außerdem nutzen wir kleine Zufallsgraphen mit 12–20 Knoten, deren exaktes Optimum sich durch vollständige Suche bestimmen lässt.
Der Prototyp löst MaxCut hauptsächlich mit Simulated Annealing. Der Algorithmus kippt Spins einzeln und übernimmt Änderungen, die den Schnitt verbessern, fast immer, Änderungen, die ihn verschlechtern, dagegen immer seltener, je weiter eine gedachte „Temperatur“ sinkt. Die Temperatur wird schrittweise abgesenkt, so wie Metall langsam abkühlt – daher der Name: Anfangs streift die Suche frei durch den Lösungsraum, gegen Ende kommt sie in einer guten Lösung zur Ruhe. Die Zahl der Schritte bestimmt den Aufwand: Mehr Schritte liefern einen besseren Schnitt und eine teurere Berechnung. Dieselbe Dynamik läuft auf der digitalen Ising-Maschine sowie auf supraleitender und reversibler Logik, während p-Bits und die optische Ising-Maschine das Energieminimum auf ähnliche, physikalisch aber andere Weise suchen.
Klassifikation handgeschriebener Ziffern aus dem UCI-Datensatz (1.797 Testbilder mit 8×8 Pixeln) [90] mit einem linearen Modell. Sie reduziert sich auf Matrix-Vektor-Multiplikationen, die native Operation von analogem In-Memory-Computing, Photonik und neuromorphen Chips.
Achtzehn Physiken
Nur zwei Physiken des Prototyps sind real: die CPU und die GPU. Zwölf Physiken werden im Folgenden beschrieben. Sechs weitere kamen später hinzu und werden in Abschnitt 8.6 behandelt: ein systolisches Tensor-Array (FP8, MXFP4, int8), Processing in DRAM, ein Datenflussprozessor, stochastisches und hyperdimensionales Rechnen sowie ein grobgranulares rekonfigurierbares Array (CGRA). Die Rolle der GPU übernimmt der Grafikprozessor des Apple M4 in einem Laptop. Der Klassifikator läuft darauf über MLX, Apples Bibliothek für maschinelles Lernen, und gemessen wird die Gerätezeit (Einzelheiten in Abschnitt 8.6). Die übrigen sechzehn Physiken sind emuliert. Der Algorithmus, den die jeweilige Physik ausführen würde, läuft tatsächlich auf der CPU und zählt seine elementaren Operationen; ein Gerätemodell rechnet die Operationszahl in Zeit und Energie der realen Maschine um. Jeder Modellparameter trägt seine Herkunft: eine Messung, ein veröffentlichter Wert mit Quellenangabe oder eine ausdrückliche Annahme mit einem Wertebereich, der später in einer Sensitivitätsanalyse geprüft wird.
Das ist eine bewusste Entscheidung, deshalb sei klar gesagt, was sie zeigt. Die Emulation beweist nicht, dass etwa p-Bits hundertmal effizienter sind als eine CPU. Sie prüft den Mechanismus: ob die Schicht unterschiedliche Physiken beschreiben, nach Ergebnis und Kosten zwischen ihnen wählen, aus Quittungen lernen und Beschränkungen einhalten kann. Sobald eine reale Maschine angeschlossen ist, wird ihr Modell anhand der Quittungen neu kalibriert (siehe Abschnitt 8.4).
Jede Physik führt ihre eigenen Algorithmen aus:
- CPU: exakte Enumeration (bis 24 Knoten), lokale Suche mit Neustarts, Metropolis-Annealing; ein Klassifikator mit doppelter Genauigkeit.
- Digitales Annealing, supraleitende Logik (SFQ) und reversible (adiabatische) Logik führen dasselbe Metropolis-Annealing aus, also identische Dynamik auf unterschiedlicher Physik, und liefern daher identische Qualität.
- p-Bits: Gibbs-Sampling mit steigender inverser Temperatur, denn so arbeiten probabilistische Computer.
- Kohärente optische Ising-Maschine: Amplitudendynamik parametrischer Oszillatoren mit Sättigung, Rauschen und Rückkopplung.
- Quantenprozessor: QAOA (der Quantum Approximate Optimization Algorithm) mit linearem Winkelplan auf einem Emulator des vollständigen Zustandsvektors, bis 20 Qubits; Fehler von Zwei-Qubit-Gattern werden mit einem globalen Depolarisationsmodell abgebildet (0,5 % pro Gatter).
- Analoger Speicher und Photonik: ein Klassifikator mit Gewichtsquantisierung, Programmierfehler, Leserauschen und einem ADC.
- Neuromorpher Chip: spikebasierte Klassifikation mit Ratenkodierung, bei der eine Zahl durch die Pulsfrequenz übertragen wird; mehr Zeitschritte bedeuten höhere Genauigkeit und höhere Kosten.
- Lebende Neuronenkultur: Reservoir Computing. Ein verrauschtes zufälliges rekurrentes Netz (ein Echo State Network) steht stellvertretend für die Kultur, und eine lineare Ausleseschicht wird auf einem herkömmlichen Computer trainiert. So werden Kulturen heute eingesetzt, weil sich ihre Synapsen nicht per Gradientenabstieg trainieren lassen.
Gerätemodelle (die Tabelle wird aus dem Code des Prototyps erzeugt):
| Physik | Emuliert | Operationen/s | Energie pro Operation, J | Leistung, W | Laden, s | Laden, J | Kalibrierung | Kapazität |
|---|---|---|---|---|---|---|---|---|
| cpu | nein | 5e+07 (1e+07–2e+08) · gemessen | — | 6.04 (3–9) · ref:amd-9454p | — | — | — | 1073741824 |
| ising-digital | ja | 4e+09 (1e+08–4e+10) · Annahme | — | 40 (15–150) · Annahme | 0.002 (0.0005–0.02) · Annahme | 0.08 (0.01–1) · Annahme | — | 100000 |
| pbit | ja | 1e+11 (1e+09–1e+12) · Annahme | 2e-15 (1e-15–2e-14) · ref:singh2024 | — | 0.001 (0.0001–0.01) · Annahme | 0.01 (0.001–0.1) · Annahme | — | 20000 |
| analog-imc | ja | 3.16e+13 (1e+12–3.16e+13) · ref:legallo2023 | 2.05e-13 (2e-14–2e-12) · ref:legallo2023 | — | 0.05 (0.01–1) · Annahme | 0.001 (0.0001–0.01) · Annahme | 30 s alle 1 h | 4194304 |
| qpu | ja | 5e+03 (1e+03–2e+04) · Annahme | — | 2.6e+04 (1.5e+04–3e+04) · ref:arute2019supp | 2 (0.5–30) · Annahme | 5.2e+04 (7.5e+03–9e+05) · Annahme | 900 s alle 6 h | 20 |
| optical-ising | ja | 1e+09 (1e+08–1e+10) · Annahme | — | 1e+03 (200–3e+03) · Annahme | 0.01 (0.001–0.1) · Annahme | — | — | 100000 |
| sfq | ja | 2e+10 (1e+09–1e+11) · Annahme | 7.4e-12 (7.4e-13–7.5e-10) · Annahme | 740 (74–3.75e+04) · Annahme | 0.001 (0.0001–0.01) · Annahme | — | — | 50000 |
| adiabatic | ja | 2e+09 (5e+07–2e+10) · Annahme | 7e-09 (1e-09–9e-09) · Annahme | — | 0.002 (0.0005–0.02) · Annahme | — | — | 100000 |
| neuromorphic | ja | 1e+10 (1e+09–1e+11) · Annahme | 2.36e-11 (4e-12–2.5e-11) · ref:loihi | 1 (0.1–5) · Annahme | 0.01 (0.001–0.1) · Annahme | — | — | 1048576 |
| photonic | ja | 1e+12 (1e+11–1e+13) · Annahme | 2.7e-13 (2e-14–2e-12) · ref:photonic2024 | 5 (1–20) · Annahme | 0.001 (0.0001–0.01) · Annahme | — | — | 65536 |
| organoid | ja | 3e+04 (3e+03–3e+05) · Annahme | — | 30 (20–100) · ref:cl1power | 1 (0.1–10) · Annahme | — | 3600 s alle 24 h | 1048576 |
| systolic | ja | 4.6e+13 (4.6e+12–4.6e+13) · ref:jouppi2017tpu | — | 40 (30–75) · ref:jouppi2017tpu | 0.001 (0.0001–0.01) · Annahme | 0.04 (0.003–0.75) · Annahme | — | 1073741824 |
| pim-dram | ja | 6e+11 (6e+10–6e+11) · ref:kwon2021fimdram | 4.6e-11 (2e-11–9.3e-11) · Annahme | — | 0.0001 (1e-05–0.001) · Annahme | — | — | 1073741824 |
| dataflow | ja | 3.75e+14 (3.75e+13–3.75e+14) · ref:abts2020tsp | — | 300 (150–400) · Annahme | 0.0001 (1e-05–0.001) · Annahme | 0.03 (0.0015–0.4) · Annahme | — | 1073741824 |
| stochastic | ja | 1e+12 (1e+11–1e+13) · Annahme | 5e-15 (1e-15–3e-14) · Annahme | — | 0.0001 (1e-05–0.001) · Annahme | — | — | 1073741824 |
| hdc | ja | 1e+12 (1e+11–1e+13) · Annahme | 6e-16 (2e-16–5e-15) · Annahme | — | 0.0001 (1e-05–0.001) · Annahme | — | — | 1073741824 |
| cgra | ja | 6.15e+12 (1.1e+12–6.15e+12) · ref:podobas2020cgra | — | 49 (20–49) · ref:podobas2020cgra | 0.0001 (1e-05–0.01) · Annahme | 0.0049 (0.0002–0.49) · Annahme | — | 1073741824 |
| gpu | nein | 5e+09 (8e+08–7e+09) · gemessen | — | 8 (3–20) · Annahme | 0.004 (0.003–0.05) · gemessen | 0.032 (0.009–1) · Annahme | — | 1073741824 |
Einige Anmerkungen zur Tabelle. Die Energie des Quantenprozessors ergibt sich aus der Leistung der Anlage einschließlich Kryotechnik (etwa 26 kW [21]) mal Zeit, nicht als Energie „pro Operation“, und sie schließt zwei Sekunden für das Laden der Aufgabe ein, 52 kJ, die bei kleinen Aufgaben den Gesamtwert dominieren. Ebenso fließt bei p-Bits (10 mJ) und digitalem Annealing (80 mJ) bei kleinen Aufgaben der größte Teil der Energie in das Laden und nicht in die Berechnung. Für reversible Logik übernehmen wir aus der Arbeit von Vaire nur die Einsparung von 30 Prozent [15]; die Basisenergie des herkömmlichen Annealers, an der sie gemessen wird, ist unsere eigene Annahme. Für supraleitende Logik wird die Schaltenergie mit einem Kühlfaktor von 740 W pro Watt Wärme bei 4 K auf die Energie an der Steckdose hochgerechnet, denn so viel benötigen Anlagen auf Basis von Collins- und Brayton-Kreisprozessen typischerweise [18]. Die Carnot-Grenze liegt bei etwa 74 W/W, die besten Anlagen kommen mit weniger als 400 W/W aus [17], kleine Kryokühler benötigen 5–7,5 kW/W [18]. Bei der lebenden Kultur entfallen die Hauptkosten auf das Lebenserhaltungssystem und nicht auf die Neuronen selbst; wir setzen 30 W an, mit Reserve gegenüber den für das Gerät angegebenen 20 W [22]. Genau das macht sie für den Scheduler interessant: Jede Physik hat ihr eigenes Kostenprofil.
Kalibrierung: Was tatsächlich herauskommt
Vor der Planung wird jede Kombination „Algorithmus × Aufwand × Physik“ auf allen Instanzen mit 12 verschiedenen Seeds des Zufallszahlengenerators ausgeführt (exakte Löser einmal). Insgesamt entstanden so 6.405 Kalibrierungsdatensätze, da eine einzige Annealing-Emulation für jede Physik mit derselben Dynamik zählt. Die CPU-Zeit wird gemessen, die Leistung pro Kern stammt aus der Spezifikation des EPYC 9454P [91], alles Übrige berechnet das Modell. Hier ein Ausschnitt der Ergebnisse, sortiert nach Energie:
MaxCut G22 (2000 Knoten, 19.990 Kanten), Qualität als Anteil am besten bekannten Schnitt von 13.359
| Physik | Algorithmus / Aufwand | Qualität (Mittelwert ± Std.-Abw.) | Gerätezeit | Geräteenergie |
|---|---|---|---|---|
| adiabatic | anneal / w300 | 0,9951 ± 0,0015 | 2,3 ms | 4,2 mJ |
| pbit | pbit / w300 | 0,9922 ± 0,0015 | 1,01 ms | 10 mJ |
| pbit | pbit / w3000 | 0,9969 ± 0,0013 | 1,06 ms | 10 mJ |
| pbit | pbit / w30000 | 0,9995 ± 0,0011 | 1,6 ms | 10,3 mJ |
| sfq | anneal / w300 | 0,9951 ± 0,0015 | 1,03 ms | 22,2 mJ |
| adiabatic | anneal / w3000 | 0,9987 ± 0,0013 | 5 ms | 42 mJ |
| cpu | local / s10 | 0,9605 ± 0,0022 | 10,7 ms | 64,3 mJ |
| ising-digital | anneal / w300 | 0,9951 ± 0,0015 | 2,15 ms | 86 mJ |
| ising-digital | anneal / w3000 | 0,9987 ± 0,0013 | 3,5 ms | 140 mJ |
| cpu | anneal / w300 | 0,9951 ± 0,0015 | 25,8 ms | 156 mJ |
| sfq | anneal / w3000 | 0,9987 ± 0,0013 | 1,3 ms | 222 mJ |
| optical-ising | cim / r200 | 0,9286 ± 0,0035 | 10,4 ms | 400 mJ |
| adiabatic | anneal / w30000 | 0,9999 ± 0,0001 | 32 ms | 420 mJ |
| cpu | local / s100 | 0,9639 ± 0,0017 | 105 ms | 634 mJ |
| ising-digital | anneal / w30000 | 0,9999 ± 0,0001 | 17 ms | 680 mJ |
| cpu | anneal / w3000 | 0,9987 ± 0,0013 | 261 ms | 1,58 J |
| optical-ising | cim / r1000 | 0,9649 ± 0,0033 | 12 ms | 2 J |
| sfq | anneal / w30000 | 0,9999 ± 0,0001 | 4 ms | 2,22 J |
| optical-ising | cim / r5000 | 0,9833 ± 0,0021 | 20 ms | 10 J |
| cpu | anneal / w30000 | 0,9999 ± 0,0001 | 2,46 s | 14,9 J |
MaxCut auf zufälligen Graphen mit 20 Knoten, Qualität als Anteil am exakten Optimum
| Physik | Algorithmus / Aufwand | Qualität (Mittelwert ± Std.-Abw.) | Gerätezeit | Geräteenergie |
|---|---|---|---|---|
| adiabatic | anneal / w300 | 1,0000 ± 0,0000 | 2 ms | 42 µJ |
| cpu | local / s10 | 0,9978 ± 0,0079 | 16,5 µs | 99,6 µJ |
| sfq | anneal / w300 | 1,0000 ± 0,0000 | 1 ms | 222 µJ |
| adiabatic | anneal / w3000 | 1,0000 ± 0,0000 | 2,03 ms | 420 µJ |
| cpu | anneal / w300 | 1,0000 ± 0,0000 | 110 µs | 663 µJ |
| cpu | local / s100 | 1,0000 ± 0,0000 | 129 µs | 782 µJ |
| sfq | anneal / w3000 | 1,0000 ± 0,0000 | 1 ms | 2,22 mJ |
| optical-ising | cim / r200 | 0,9619 ± 0,0342 | 10 ms | 4 mJ |
| adiabatic | anneal / w30000 | 1,0000 ± 0,0000 | 2,3 ms | 4,2 mJ |
| cpu | anneal / w3000 | 1,0000 ± 0,0000 | 1,01 ms | 6,09 mJ |
| pbit | pbit / w300 | 1,0000 ± 0,0000 | 1 ms | 10 mJ |
| pbit | pbit / w3000 | 1,0000 ± 0,0000 | 1 ms | 10 mJ |
| pbit | pbit / w30000 | 1,0000 ± 0,0000 | 1,01 ms | 10 mJ |
| optical-ising | cim / r1000 | 0,9894 ± 0,0131 | 10 ms | 20 mJ |
| sfq | anneal / w30000 | 1,0000 ± 0,0000 | 1,03 ms | 22,2 mJ |
| cpu | exact / full | 1,0000 ± 0,0000 | 8,4 ms | 50,7 mJ |
| cpu | anneal / w30000 | 1,0000 ± 0,0000 | 9,97 ms | 60,2 mJ |
| ising-digital | anneal / w300 | 1,0000 ± 0,0000 | 2 ms | 80,1 mJ |
| ising-digital | anneal / w3000 | 1,0000 ± 0,0000 | 2,01 ms | 80,6 mJ |
| ising-digital | anneal / w30000 | 1,0000 ± 0,0000 | 2,15 ms | 86 mJ |
| optical-ising | cim / r5000 | 0,9964 ± 0,0071 | 10,1 ms | 100 mJ |
| qpu | qaoa / p4s256 | 0,9564 ± 0,0309 | 2,05 s | 5,33e+04 J |
| qpu | qaoa / p8s1024 | 0,9555 ± 0,0312 | 2,2 s | 5,73e+04 J |
Klassifikation von 1.797 handgeschriebenen UCI-Ziffern, Qualität als Genauigkeit relativ zum exakten Klassifikator
| Physik | Algorithmus / Aufwand | Qualität (Mittelwert ± Std.-Abw.) | Gerätezeit | Geräteenergie |
|---|---|---|---|---|
| photonic | analog / w4 | 0,9958 ± 0,0035 | 1 ms | 6,06 µJ |
| neuromorphic | spiking / t8 | 0,9898 ± 0,0022 | 10,3 ms | 347 µJ |
| analog-imc | analog / w4 | 0,9771 ± 0,0051 | 50 ms | 1 mJ |
| neuromorphic | spiking / t32 | 0,9983 ± 0,0015 | 11,1 ms | 1,39 mJ |
| cpu | exact-fp / fp64 | 1,0000 ± 0,0000 | 726 µs | 4,39 mJ |
| neuromorphic | spiking / t128 | 1,0002 ± 0,0012 | 14,5 ms | 5,55 mJ |
| organoid | reservoir / s8 | 1,0365 ± 0,0028 | 145 s | 4,31e+03 J |
| organoid | reservoir / s20 | 1,0340 ± 0,0019 | 360 s | 1,08e+04 J |
Schon die Kalibrierung zeigt Zusammenhänge, die der Scheduler später ausnutzt:
- Auf großen Graphen kostet dasselbe Annealing auf spezialisierten Maschinen bei gleicher Qualität 2- bis 40-mal weniger als auf der CPU, und p-Bits mit ihrem eigenen Sampling-Algorithmus kosten bis zu drei Größenordnungen weniger.
- Auf kleinen Graphen schlägt die günstigste CPU-Variante fast alle spezialisierten Maschinen, weil bei vielen von ihnen die Fixkosten für das Laden der Aufgabe die eigentliche Berechnung übersteigen. Die Ausnahme ist reversible Logik, deren Modell keine Ladeenergie kennt.
- Auf Graphen mit 20 Knoten erreicht der Quantenprozessor im Mittel 95,6 % des Optimums (Gatterfehler zehren einen Teil der Qualität auf) und verbraucht etwa 53 kJ, weil die Kryotechnik während der gesamten Laufzeit der Aufgabe arbeitet. Die exakte Enumeration auf der CPU findet das Optimum für 51 mJ, rund eine Million Mal günstiger. Dieses Modell besagt nicht, dass Quantencomputer nutzlos sind. Es besagt, dass sie für MaxCut auf 20 Knoten keinen Sinn ergeben – und dass der Scheduler das erkennen muss.
- Die lebende Kultur klassifiziert Ziffern sogar genauer als das lineare Modell, weil das Reservoir eine nichtlineare Merkmalserweiterung darstellt. Für 1.797 Bilder braucht sie jedoch etwa sechs Minuten und etwa 10 kJ Energie für die Lebenserhaltung, rund eine Million Mal mehr als jede andere Physik bei dieser Aufgabe.
Der Scheduler
Für jede Aufgabe zählt der Scheduler die Kombinationen aus Algorithmus × Aufwand × Substrat × Startzeitpunkt auf. Aufschiebbare Arbeit wird in 15-Minuten-Schritten bis zur Deadline betrachtet. Für jede Variante
- zählt er die Operationen, und zwar bei Annealing, QAOA und Klassifikation exakt und vor der Ausführung;
- rechnet sie mit dem Modell des Substrats in Zeit und Energie um und multipliziert mit den aus Quittungen gelernten Korrekturen sowie mit der PUE (im Prototyp eine einheitliche Konstante von 1,2);
- addiert die Energie für die Datenübertragung, falls das Substrat außerhalb der Zone der Daten liegt;
- prüft Kalibrierungsfenster und bereits auf dem Substrat reservierte Intervalle;
- bildet aus den beobachteten Läufen die untere Wilson-Schranke für die Wahrscheinlichkeit, die geforderte Qualität zu erreichen (eine Variante ohne Beobachtungen wird nicht vorgeschlagen);
- berechnet die CO₂-Emissionen aus der prognostizierten CO₂-Intensität des Netzes im Ausführungsfenster und die Kosten aus dem stündlichen Day-Ahead-Marktpreis;
- verwirft alles, was Deadline, Budget, Zonen, Rechtsräume oder Mandat verletzt.
Anschließend wählt er das Minimum gemäß der Policy (minimale CO₂-Emissionen, Energie, Kosten oder Zeit) und behält die Pareto-Front – die Menge der Varianten, von denen keine auf allen Achsen zugleich schlechter ist als eine andere.
Netzdaten
Die CO₂-Intensität für Deutschland, Frankreich und Polen berechnen wir selbst aus dem Erzeugungsmix, den Energy-Charts (Fraunhofer ISE) veröffentlicht [92], mit den Median-Emissionsfaktoren über den Lebenszyklus aus IPCC AR5 [93]. Für diese Länder ist unsere Prognose naiv: Wir nehmen dieselbe Viertelstunde des Vortags. Für Großbritannien verwenden wir die offizielle Prognose und die Ist-Werte des Netzbetreibers [94]. Die Preise stammen vom Day-Ahead-Markt (CC BY 4.0, Bundesnetzagentur | SMARD.de); für Großbritannien gibt es keinen offenen Preis. Spanien haben wir ausgeschlossen, weil seine Preisdaten nur für private Zwecke verwendet werden dürfen.
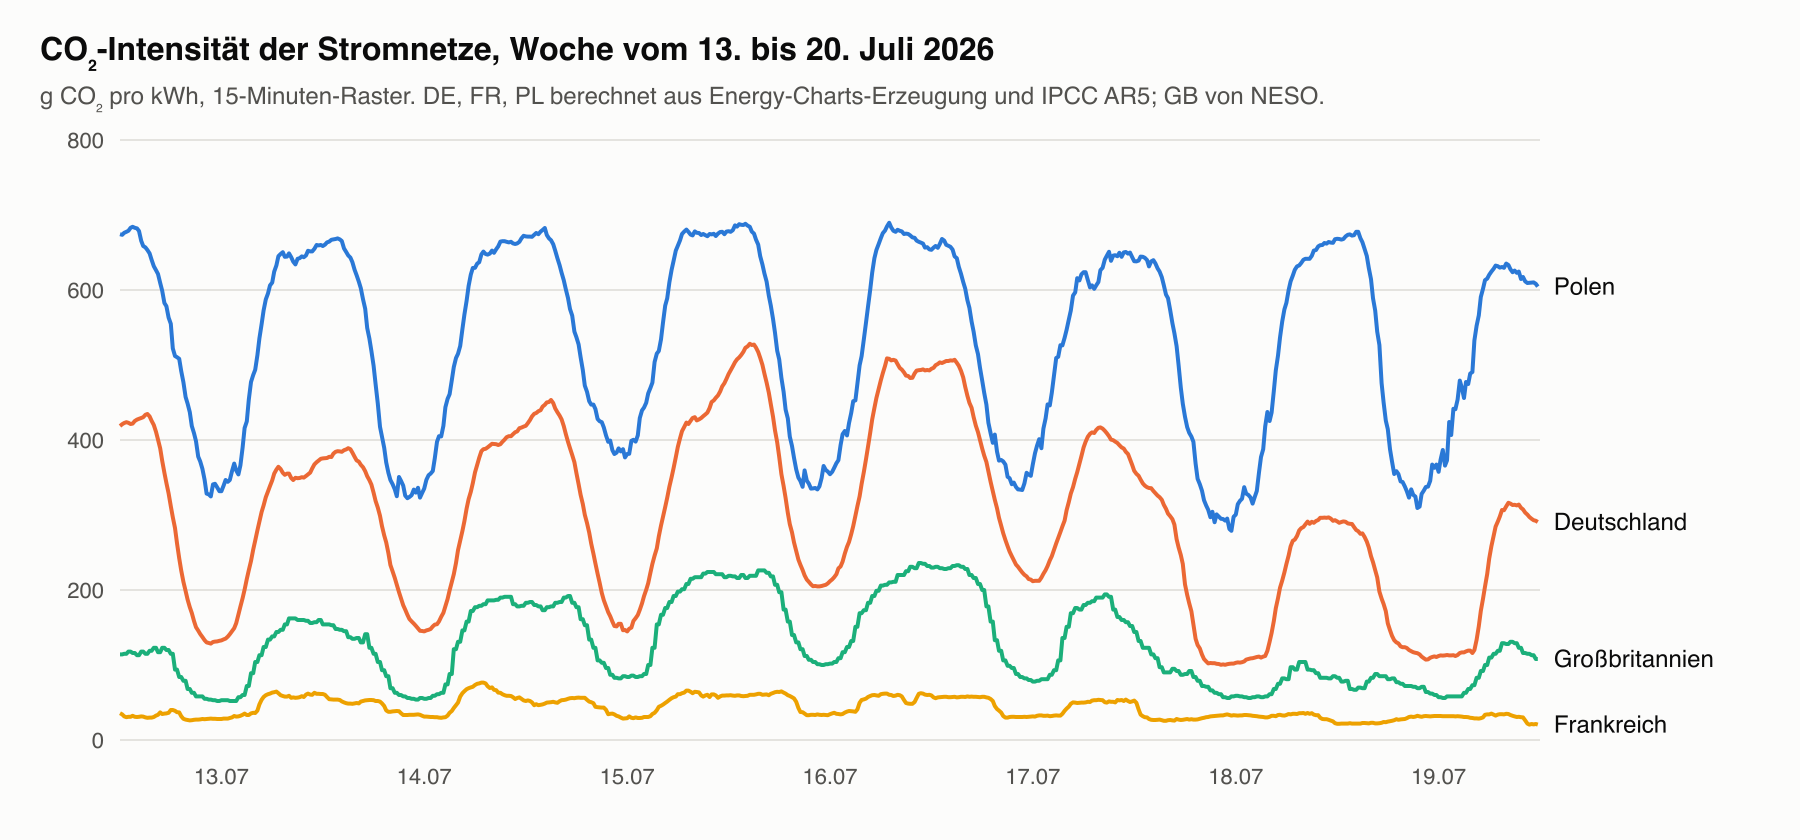
CO₂-Intensität von vier Stromnetzen über eine Woche
Die Mittelwerte für das dritte Quartal 2026 zeigen, wie unterschiedlich diese Netze sind. Im Diagramm ist der Tagesrhythmus deutlich zu erkennen. Tagsüber, wenn die Sonne scheint, sinkt die Intensität in Deutschland um den Faktor zweieinhalb und in Polen fast um die Hälfte, abends steigt sie wieder; genau daraus ergibt sich der Nutzen, flexible Arbeit zeitlich zu verschieben. Das stark auf Kernkraft setzende Frankreich liegt bei etwa 39 g CO₂ pro kWh, Großbritannien bei etwa 118, Deutschland bei etwa 293 und das kohlelastige Polen bei etwa 505. Der mittlere Fehler unserer naiven Prognose für Deutschland beträgt 67 g/kWh, der der offiziellen britischen Prognose 12. Was dieser Unterschied kostet, zeigen wir weiter unten.
Quittungen und Mandate
Beim ersten Start erzeugt jeder Agent einen Ed25519-Schlüssel und veröffentlicht dessen öffentlichen Teil im Status seines Substrats. Eine Quittung hält fest: wer die Anfrage gestellt hat und unter welchem Mandat; den Hash der Instanz, Algorithmus, Aufwand, Agent-Build und Seed des Zufallszahlengenerators; Substrat, Physik und ob diese emuliert ist; Hash und Qualität des Ergebnisses; Operationszahl, Gerätezeit und -energie, CPU-Zeit des Hosts, Netzintensität und Emissionen. Die Quittung ist signiert und enthält den Hash der vorherigen Quittung desselben Agenten. Eine Quittung lässt sich nicht unbemerkt ändern oder löschen, weil dann entweder die Signatur oder das nächste Glied der Kette bricht. Das Receipt-Objekt selbst ist auf API-Ebene unveränderlich, durchgesetzt über eine Validierungsregel der CRD.
Ein Mandat wird von einem Menschen signiert. Es überträgt einen Namespace, ein Tagesbudget in Joule, Euro und Gramm CO₂, Zonen, eine Gültigkeitsdauer und eine Autonomiestufe: „manual“ verlangt die Freigabe jedes Plans; „augmented“ verlangt die Freigabe von Plänen oberhalb eines Schwellenwerts; „directed“ lässt Agenten innerhalb des Budgets selbstständig handeln. Die Schlüssel der Menschen sind in der Control Plane des Systems registriert, und die Signatur wird bei jeder Aufgabe geprüft.
8. Wie wir es getestet haben
8.1. Methodik
Wir haben auf drei Ebenen getestet, und jede davon erfüllt ihre eigene Aufgabe.
Kalibrierung auf einem realen Prozessor. Jede Kombination aus „Algorithmus × Aufwand × Physik“ lief auf allen Instanzen mit 12 Seeds des Zufallszahlengenerators; insgesamt ergab das 6405 Kalibrierungsdatensätze. Es handelt sich um echte Berechnungen: Schnitte werden tatsächlich berechnet, Klassifikatoren klassifizieren tatsächlich, und die Qualität wird an den besten bekannten Ergebnissen und an exakten Lösungen gemessen. Die CPU-Zeit wird gemessen; Zeit und Energie der übrigen Physiken berechnet ein Modell aus der Zahl der Operationen. Zwölf Wiederholungen sind keine willkürliche Wahl. Bei fünf Wiederholungen weigerte sich der Scheduler, G22 einzuplanen, denn fünf Erfolge aus fünf Versuchen ergeben eine untere Wilson-Schranke von 0,83, verlangt waren aber 0,9. Das System lehnte es ab, etwas zuzusagen, das es nicht gründlich genug geprüft hatte – genau so, wie es Prinzip P5 verlangt.
Ein digitaler Zwilling auf realen Stromnetzdaten. Der Simulator führt denselben Scheduler-Code aus. Ein Strom von rund 13.000 Aufgaben pro Quartal trifft tagsüber doppelt so häufig ein wie nachts. Die Hälfte der Aufgaben ist interaktiv (Deadline 60 Sekunden, Warten nicht erlaubt), die andere Hälfte Batch (Deadline 2 bis 24 Stunden, Warten erlaubt). Jede fünfte Aufgabe darf nur in der EU laufen, jede zehnte nur in der Zone, in der ihre Daten liegen. Wir haben zwei Quartale des Jahres 2026 verwendet, das erste (Winter) und das dritte (Sommer), mit Daten für Deutschland, Frankreich, Polen und das Vereinigte Königreich in 15-Minuten-Auflösung. Der Bestand an Substraten besteht aus CPU-Pools mit 16 Slots in jedem Land sowie je einer Maschine jeder der zehn speziellen Physiken, die verschiedenen „Eigentümern“ in verschiedenen Ländern gehören. Der Scheduler sieht nur die Prognose, CO₂ und Geld werden dagegen nach den tatsächlichen Stunden abgerechnet, in denen die Arbeit wirklich lief. Das Ergebnis der Ausführung stammt aus der Kalibrierung: Die Qualität wird zufällig aus den Werten gezogen, die für diese Kombination tatsächlich beobachtet wurden, und die Kosten liefert das Modell mit einer Streuung von ±10 % (log-normales Rauschen). Jede Policy läuft fünfmal mit unterschiedlichen Seeds; angegeben sind der Mittelwert und der Bereich von 5–95 %.
Live-Testumgebungen. Die erste Testumgebung ist ein realer kube-apiserver 1.37 mit etcd und ohne einen einzigen Node; der Scheduler und 14 Agenten laufen als Prozesse. Sie soll zeigen, dass das System Node-Objekte überhaupt nicht braucht. Die zweite Testumgebung ist der kuberoot-Cluster
edge. Die Distribution wurde für arm64 aus den Quellen gebaut (Linux-Kernel 6.18.55, DRBD-Module, Root-Dateisystem, Image von 403 MB) und in QEMU mit Hardware-Virtualisierung gebootet. Die Maschine startet als Single-Node-Cluster auf Kubernetes 1.37.1, und physis wird aus einem Helm-Chart installiert, das in einem kubepkg-Paket ausgeliefert wird (die Manifeste werden aus dem Chart erzeugt und mit kubectl angewendet). Das physis-Image liegt in einer Registry auf dem Node selbst, und containerd zieht es von der eigenen lokalen Adresse des Nodes. Alle 15 physis-Komponenten (der Scheduler und 14 Agenten) laufen auf kuberoot als Pods. Beide Testumgebungen nutzten frische Stromnetzprognosen für den Tag des Laufs, einen Strom von 120 Aufgaben in Echtzeit sowie die Conformance-Suite. Zwei weitere Testumgebungen, kuberoot-Cluster mit mehreren Nodes, auf denen wir eine echte Netzwerkpartition getestet haben, beschreibt Abschnitt 8.6.
Wir haben sieben Policies verglichen:
| Policy | Was sie ist |
|---|---|
| „Kubernetes heute“ | Nur CPU, nur in der Zone der Daten, sofort, so schnell wie möglich. So arbeiten die meisten Cluster |
| CO₂-bewusst, nur CPU | Nur CPU, aber in jeder zulässigen Zone und zeitlich in Richtung minimaler CO₂-Intensität verschoben – so arbeiten die heutigen „grünen“ Scheduler |
| Gemischte Physiken, nur Geschwindigkeit | Alle Physiken, aber das Ziel ist, so früh wie möglich fertig zu werden, ohne Rücksicht auf Energie |
| physis: minimale Energie | Alle Physiken, alle Zonen, kein Warten |
| physis: minimales CO₂ | Alle Physiken, alle Zonen, Warten bis zur Deadline erlaubt |
| physis: minimale Kosten | Dasselbe, mit Geld als Ziel |
| Orakel | Wie „minimales CO₂“, sieht aber statt der Prognose die tatsächliche Intensität: eine obere Schranke dessen, was eine perfekte Prognose leisten kann |
8.2. Das Hauptergebnis
Drittes Quartal 2026, rund 13.000 Aufgaben pro Lauf, fünf Läufe:
| Policy | Energie, Wh | CO₂, g CO₂ (5–95 %) | Gegenüber „Kubernetes heute“ | Mittlere Wartezeit | Verpasste Deadlines | Qualitätsdefizit |
|---|---|---|---|---|---|---|
| „Kubernetes heute“ | 11,17 | 2,525 (2,43–2,61) | — | 0 | 0 | 0,73 % |
| CO₂-bewusst, nur CPU | 12,19 | 0,797 (0,78–0,81) | Energie +9 %, CO₂ −68 % | 162 min | 0 | 0,73 % |
| Gemischte Physiken, nur Geschwindigkeit | 2,97 | 0,671 (0,65–0,69) | −73 %, −73 % | 0 | 0 | 0,73 % |
| physis: minimale Energie | 1,17 | 0,220 (0,21–0,23) | −90 %, −91 % | 0 | 0 | 0,93 % |
| physis: minimales CO₂ | 1,23 | 0,190 (0,19–0,20) | −89 %, −92 % | 163 min | 0 | 0,91 % |
| physis: minimale Kosten | 395,1 | 13,31 (12,8–14,3) | +3437 %, +427 % | 171 min | 0,002 % | 0,89 % |
| Orakel | 1,23 | 0,185 (0,18–0,19) | −89 %, −93 % | 173 min | 0 | 0,91 % |
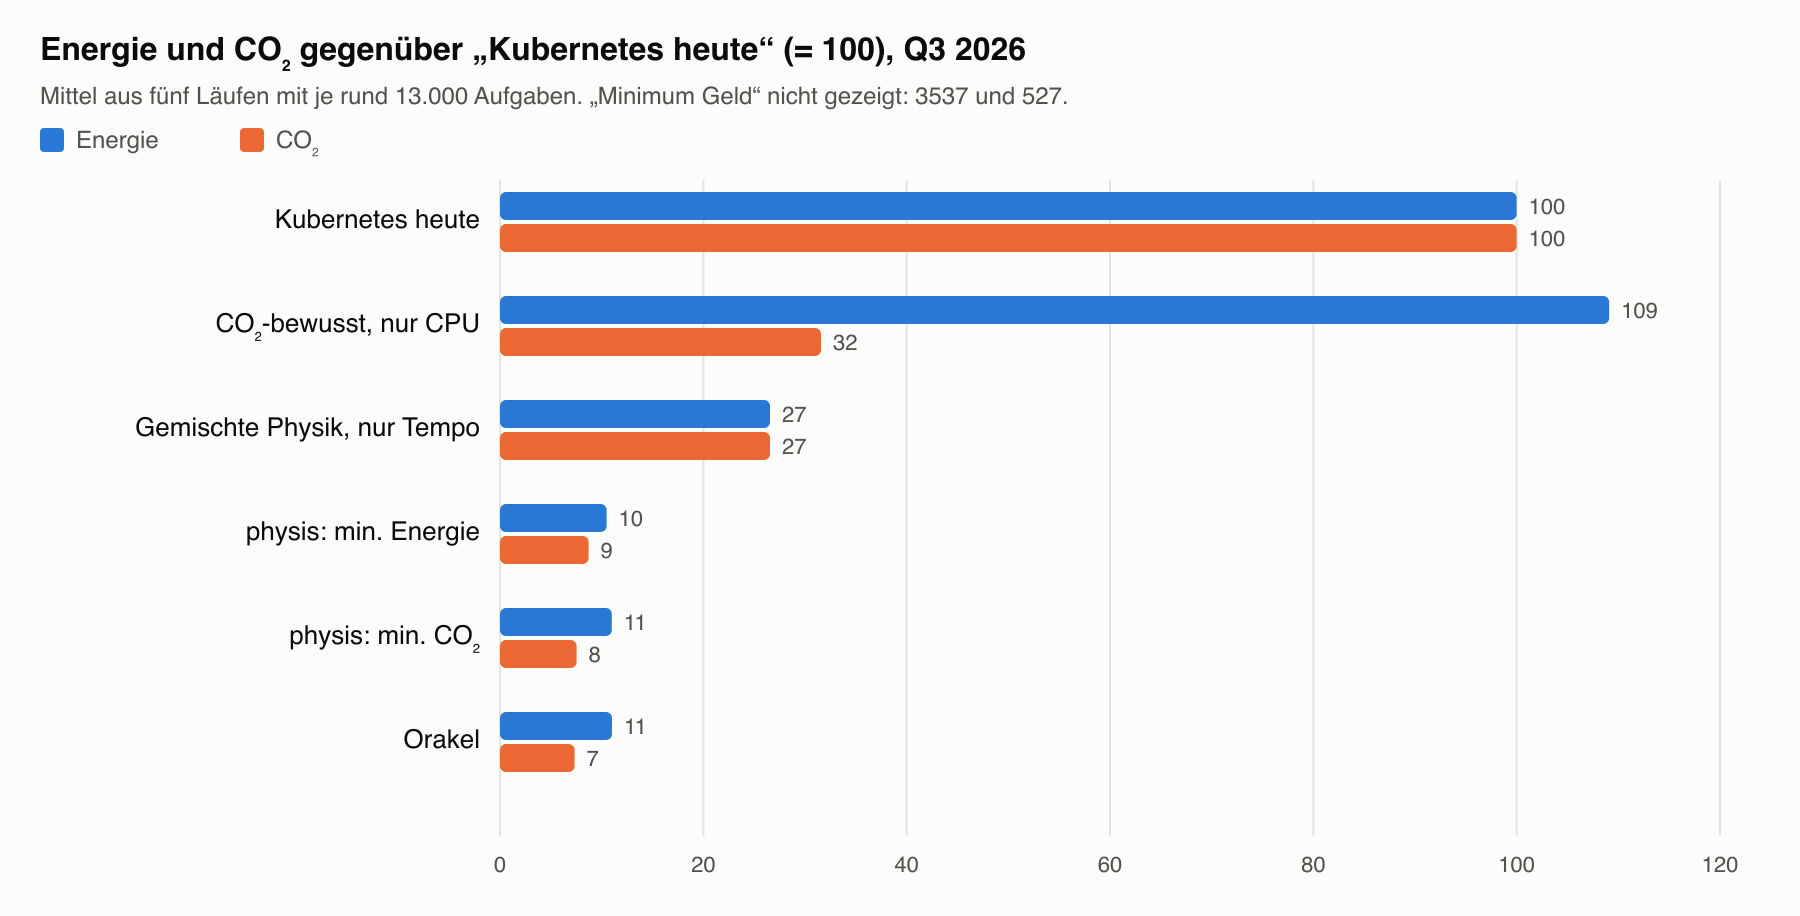
Energie und CO₂ der sieben Policies im Verhältnis zu „Kubernetes heute“, drittes Quartal 2026
Das erste Quartal (Winter) zeigt dasselbe Bild: „Minimale Energie“ senkt die Energie um 89 % und das CO₂ um 91 %, „minimales CO₂“ senkt das CO₂ um 92 %, das Orakel ebenfalls um 92 %, und CO₂-bewusstes Scheduling allein auf CPUs senkt das CO₂ um 69 % – um den Preis von 9 % mehr Energie.
Aus diesen Zahlen folgen vier Schlüsse.
Die Wahl der Physik zählt mehr als die Wahl von Ort und Zeit zusammen. Arbeit allein auf Prozessoren in Zeit und Raum zu verschieben (was heute CO₂-bewusstes Scheduling heißt), beseitigt etwa 70 % des CO₂, erhöht aber die Energie um 9 % und lässt Batch-Arbeit im Mittel fast drei Stunden warten. Allein ein Wechsel der Physik, sogar ohne jedes Energieziel, bringt −73 % bei beiden Kennzahlen, ohne Wartezeit. physis mit Energieziel bringt minus 90 % Energie und 91 % CO₂, ebenfalls ohne Wartezeit. Das Warten auf saubere Stunden spart darüber hinaus weitere 14 % CO₂.
Ziele müssen bewusst gewählt werden: „minimale Kosten“ ist ein gefährliches Ziel. Auf Day-Ahead-Märkten gibt es mitunter negative Preise: Das Netz bezahlt für Verbrauch, wenn ein Überschuss an Wind- und Solarstrom nirgendwohin kann. Im dritten Quartal 2026 kam das in Deutschland in 7,6 % der Viertelstunden vor, in Frankreich in 6,5 % und in Polen in 3,7 % (wo das Minimum −120 € pro MWh erreichte). Ein Scheduler, der die Kosten minimiert, wählt in diesen Stunden die energiehungrigste Option, die lebende Neuronenkultur samt Lebenserhaltung (3,6 % der Aufgaben), und verbraucht insgesamt 35-mal mehr Energie als Kubernetes – und verdient dabei buchstäblich Geld. Aus Sicht des Preissignals ist das korrektes Verhalten, denn das Netz braucht Last; aus Sicht des CO₂ und des gesunden Menschenverstands ist es falsch. Die Lehre für das Design: Geld darf nie das einzige Ziel sein. Nötig ist ein zusammengesetztes Ziel oder eine Energie- und CO₂-Beschränkung zusätzlich zum Geld. Mandate mit einem Tagesbudget in Joule und Gramm (Prinzip P10) sind ein Weg dahin.
Die Prognose bringt wenig. Das Orakel, das die Zukunft exakt kennt, schlägt unsere naive Prognose „wie gestern“ im dritten Quartal nur um 2,5 % CO₂ und im ersten um 2,6 %. Fast der gesamte Gewinn stammt aus der Wahl der Physik und aus dem Warten an sich, nicht aus der Genauigkeit der Prognose.
Deadlines werden praktisch nie verpasst. Die einzige Überschreitung in fünf Läufen ging auf die Policy „minimale Kosten“ zurück. Ein Qualitätsdefizit betrifft weniger als 1 % der Aufgaben, bei einer zugesagten unteren Konfidenzschranke von 90 %. Bei den physis-Policies liegt es etwas höher (0,9 % gegenüber 0,7 %), weil sie öfter den minimalen Aufwand wählen, der das Ziel statistisch gerade noch erreicht.
8.3. Datenbewegung: Die Berechnung sollte zu den Daten gehen
In der ersten Version des Simulators wurde die Energie für das Verschieben von Daten mit der CO₂-Intensität des Ziellandes verrechnet, und der Scheduler schickte Aufgaben bereitwillig ins atomstromversorgte Frankreich, sodass bis zu einem Drittel der Arbeit dorthin wanderte. Das war ein Modellierungsfehler. Daten laufen über Netze zwischen Ländern, und es ist ehrlicher, die Übertragung mit der mittleren Intensität von Quelle und Ziel zu verrechnen. Nach der Korrektur wurde physisch nur noch die Arbeit verschoben, die Souveränitätsbeschränkungen zu verschieben zwangen, also 4,8 % der Aufgaben. Freiwillig verschob der Scheduler keine einzige Aufgabe.
Der Grund ist der Maßstab. Nach Aslan und Koautoren kostete die Datenübertragung über Kern- und Festnetz-Zugangsnetze 2015 0,06 kWh pro Gigabyte und halbierte sich etwa alle zwei Jahre [85]. Hochgerechnet auf 2026 ergibt das rund 4,8 µJ pro Byte. Der Graph G22 umfasst etwa 480 KB, und ihn zu verschieben kostet größenordnungsmäßig 2,3 J. Dieselbe Aufgabe auf reversibler Logik zu lösen kostet 4 mJ, fünfhundertmal weniger. Je sparsamer die Physik der Berechnung wird, desto stärker dominiert die Datenbewegung die Rechnung. Es ist dasselbe Muster, das Mark Horowitz innerhalb eines Chips gezeigt hat, wo ein Speicherzugriff Größenordnungen mehr kostet als eine arithmetische Operation [36]. Nur zeigt es sich jetzt im Maßstab von Stromnetzen und Ländern. Wir haben das Experiment mit Datenmengen von 65 Byte bis 100 MB pro Abbild durchgeführt, und der Anteil freiwilliger Übertragungen blieb in jedem Fall bei null.
Wir haben angenommen, dass die Übertragung innerhalb einer Zone zehnmal billiger ist als zwischen Zonen, und das ist eine Annahme. Der Schluss hängt aber nicht von ihr ab. In einer Welt, in der Berechnungen um Größenordnungen billiger werden, das Netz dagegen alle zwei Jahre nur um die Hälfte, sollte der Scheduler die Berechnung zu den Daten bringen und nicht umgekehrt. Für das Design ist das ein Argument für Datenbewegung als explizite, geplante Operation mit einem Preis (Abschnitt 6) und gegen ein flaches Netz, in dem Bewegung unsichtbar bleibt.
8.4. Das Modell ist falsch – das System lernt
Die wichtigste Frage zur Emulation lautet: Was passiert, wenn sich das Modell einer realen Maschine als falsch erweist? Das haben wir direkt getestet. Fünf Physiken (digitales Annealing, SFQ, reversible Logik, p-Bits und Photonik) verbrauchen in der „Welt“ 30-mal mehr Energie, als das Modell des Schedulers annimmt. Das reicht, damit das Vertrauen in das Modell zur falschen Wahl der Physik führt. Wir haben drei Varianten verglichen:
| Variante (Q3) | Energie, Wh | CO₂, g | Arbeit auf der „falschen“ Physik | Prognosefehler: erste 10 Läufe → erste 100 → Quartalsende |
|---|---|---|---|---|
| Ohne Lernen | 11,97 | 2,99 | 64,6 % | 67 % → 74 % → 73 % |
| Lernen aus Quittungen | 5,42 | 0,78 | 29,7 % | 32 % → 7,6 % → 4,4 % |
| Wahrheit im Voraus bekannt | 5,41 | 0,74 | 30,3 % | 3 % → 4,4 % → 4,2 % |
Ohne Lernen vertraut der Scheduler weiter dem Modell und verbraucht 2,2-mal mehr Energie. Mit Lernen sinkt der Prognosefehler von 32 % über die ersten zehn Läufe auf 7,6 % über die ersten hundert und pendelt sich dann auf dem Rauschniveau ein (etwa 4–5 %). Die resultierende Energie und der Anteil der Arbeit auf der „falschen“ Physik entsprechen praktisch der Variante, in der die Wahrheit im Voraus bekannt ist. Das erste Quartal liefert dieselben Zahlen.
Genau deshalb ist die Emulation im Prototyp keine Attrappe, sondern ein Versuchsaufbau. Das Substratmodell dient als Ausgangshypothese, nicht als Behauptung. Auf realer Hardware gleicht das System es innerhalb der ersten paar hundert Läufe über Quittungen mit der Wirklichkeit ab.
Nebenbei hat dieses Experiment einen weiteren Fehler aufgedeckt. Anfangs konvergierte das Lernen nicht, und der Fehler blieb bei etwa 60 %, weil die Quittungen mit der bereits korrigierten Prognose verglichen wurden – das System lernte also eine „Korrektur der Korrektur“. Jetzt wird der tatsächliche Wert mit der rohen Modellvorhersage verglichen, ohne Korrekturen, Standort-Overhead oder Datenbewegung.
8.5. Wie stark die Schlüsse von den Annahmen abhängen
Die meisten Parameter der emulierten Physiken beruhen auf Annahmen mit Bandbreiten. Wir haben jede Physik einzeln an das pessimistische Ende ihrer Bandbreite verschoben (Energie und Leistung maximal, Geschwindigkeit minimal) und an das optimistische Ende, wobei wir die „Welt“ und das Modell des Schedulers gleichzeitig geändert haben. Dann haben wir betrachtet, welchen Anteil der Arbeit diese Physik erhält und was mit dem gesamten CO₂ geschieht. Jeder Punkt bekam drei Läufe in beiden Quartalen; unten ist das dritte Quartal dargestellt, das erste führt zu denselben Schlüssen.
| Physik | Anteil der Arbeit (min. CO₂): pessim. / nominal / optim. | Gesamt-CO₂, g: pessim. / nominal / optim. |
|---|---|---|
| Reversible Logik | 30,8 % / 31,2 % / 32,3 % | 0,191 / 0,189 / 0,185 |
| p-Bits | 6,2 % / 8,7 % / 8,9 % | 0,192 / 0,189 / 0,189 |
| Photonik | 2,3 % / 2,3 % / 2,3 % | 0,189 / 0,189 / 0,189 |
| Neuromorpher Chip | 0 % / 2,2 % / 2,2 % | 0,189 / 0,189 / 0,189 |
| Digitales Annealing | 0 % / 8,6 % / 13,7 % | 0,349 / 0,189 / 0,146 |
| SFQ | 0 % / 13,3 % / 18,2 % | 0,250 / 0,189 / 0,146 |
| Quantenprozessor, optische Ising-Maschine, lebende Kultur, analoger Speicher | 0 % bei beliebigen Parametern | unverändert |
Nach dieser Tabelle zerfallen die Physiken in drei Gruppen.
- Robust. Die Anteile von reversibler Logik, p-Bits, Photonik und neuromorphem Chip hängen kaum davon ab, wo in der Bandbreite der Annahmen die Wahrheit liegt.
- Annahmeabhängig. Die Rolle von digitalem Annealing und supraleitender Logik wird vollständig durch ihre Geschwindigkeit, ihre Leistung und, bei SFQ, die Kosten der Kühlung bestimmt. Am pessimistischen Ende wählt der Scheduler sie nicht mehr, und das gesamte CO₂ steigt um 32–84 %. Diese Physiken müssen auf realer Hardware kalibriert werden, bevor sich Schlüsse ziehen lassen.
- Nie gewählt für diese Aufgaben: der Quantenprozessor (bei Aufgaben mit bis zu 20 Knoten frisst die Kryotechnik alles auf), die optische Ising-Maschine (schlechtere Qualität und zugleich höhere Energie), die lebende Kultur (langsam und wegen der Lebenserhaltung teuer) und der analoge Speicher (die Photonik löst dieselbe Klassifikation genauer und billiger). Das ist kein Urteil über diese Physiken, sondern eine Eigenschaft dieser Aufgaben und dieser Modelle – und genau das muss der Scheduler erkennen können.
Der wichtigste Punkt für den gesamten Artikel: Selbst am pessimistischsten Ende jeder beliebigen Physik liegt das gesamte CO₂ von physis um 84 % unter dem von „Kubernetes heute“ (0,40 g gegenüber 2,52 g im dritten Quartal, 0,47 g gegenüber 2,95 g im ersten). Die Sensitivität ändert, welche spezielle Physik gewinnt, nicht aber, dass die Wahl der Physik gewinnt.
Allerdings wurden die Physiken einzeln verschoben und nicht alle gleichzeitig, und die Bandbreiten haben wir selbst gewählt. Ein gemeinsames pessimistisches Szenario wird der nächste Test sein.
Reproduzierbarkeit. Wir haben alle Simulationen in einem Build-Pod des Workshop-Clusters von Grund auf neu laufen lassen, also auf einem Serverprozessor AMD EPYC 9454P unter Linux statt auf einem Laptop mit Apple M4 unter macOS. Mit derselben veröffentlichten Kalibrierung stimmten die Endtabellen aller vier Experimente für beide Quartale Byte für Byte mit den veröffentlichten überein, und in den Zusammenfassungsdateien wichen die Zahlen um weniger als ein Milliardstel ab, was sich durch die unterschiedliche Gleitkommaarithmetik der beiden Architekturen erklärt. Dann haben wir etwas getan, was die veröffentlichten Zahlen nicht abdeckten: Wir haben alle Physiken auf dem EPYC selbst neu kalibriert (9429 Datensätze, results/repro/) und das Hauptexperiment wiederholt. Der Serverprozessor rechnet unsere Aufgaben langsamer als der M4, daher wurde die Basislinie „Kubernetes heute“ energetisch etwa anderthalbmal teurer, während sich die physis-Policies kaum veränderten. Im Ergebnis wuchs der Vorsprung: Im dritten Quartal senkt physis mit Energieziel die Energie um 93 % und das CO₂ um 94 %, gegenüber 90 % und 91 % in der veröffentlichten Fassung. Das ist genau die Ungenauigkeit, die bei den Einschränkungen erwähnt ist: Die Geschwindigkeit des M4 in Kombination mit der Leistungsaufnahme des EPYC machte den Prozessor in der Simulation etwas günstiger, als er wirklich ist. Die veröffentlichten Zahlen sind also konservativer, als es eine Kalibrierung auf einem realen Serverprozessor nahelegt.
8.6. Live-Testumgebungen
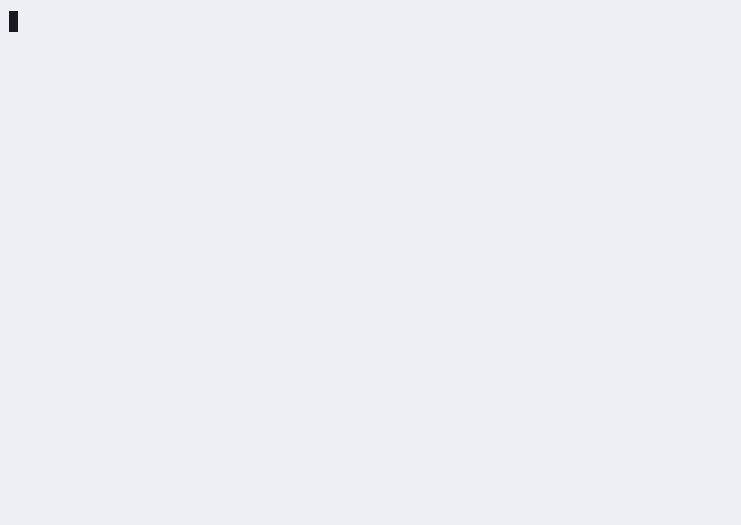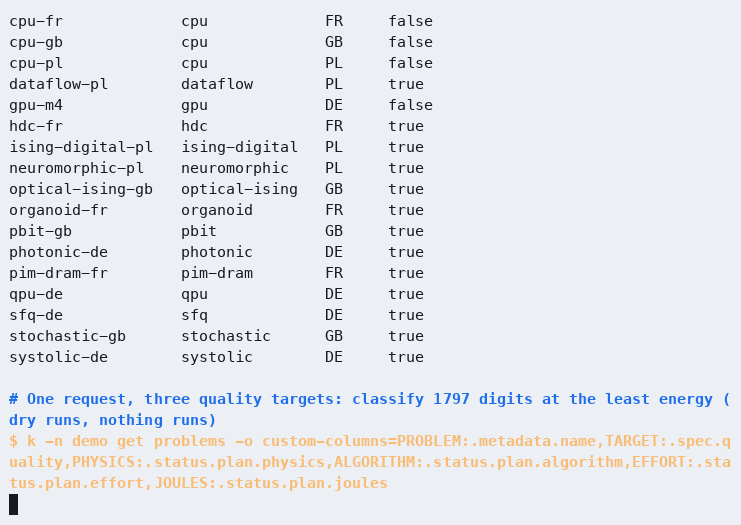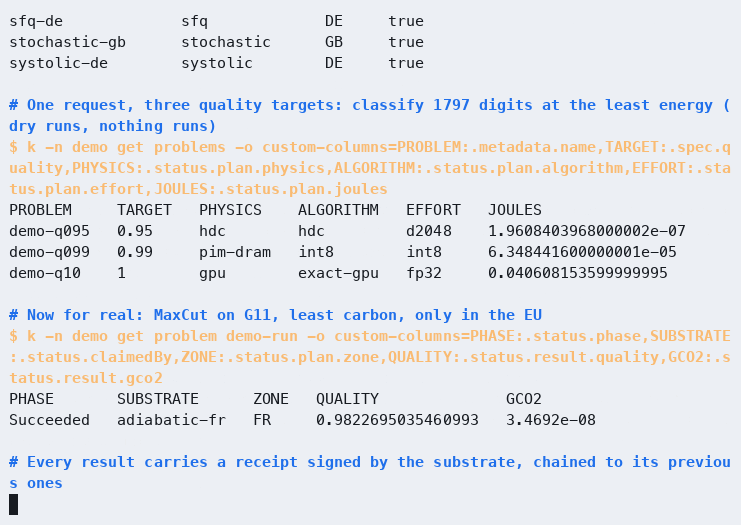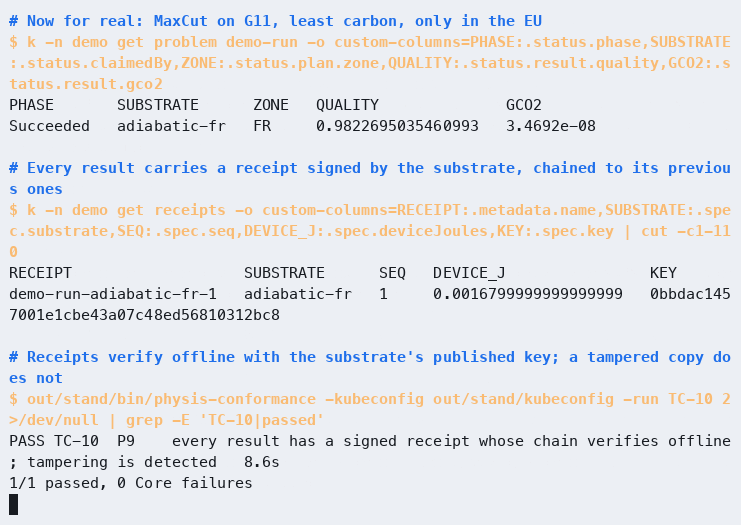
Eine Live-Testumgebung: Kubernetes ohne Nodes und zwanzig Substrate. Dieselbe Aufgabe geht bei Qualitätszielen von 0,95, 0,99 und 1,0 an hyperdimensionales Rechnen, an int8-Rechnen im Speicher und an eine exakt rechnende GPU; es folgen ein echter Lauf und eine signierte Quittung, die die Prüfung besteht.
Die Aufzeichnung hat das Skript hack/demo.sh auf der Testumgebung ohne Nodes erstellt; alles, was sie zeigt, ist echte kubectl-Ausgabe.
Ein Echtzeitstrom von 120 Aufgaben (MaxCut auf Gset- und Zufallsgraphen, Ziffernklassifikation, vier verschiedene Policies, ein Drittel der Aufgaben auf „nur EU“ beschränkt) lief auf beiden Testumgebungen gegen aktuelle Stromnetzprognosen für den 8. November 2026. Der Zufallszahlengenerator startet mit demselben Seed, die Abfolge der Aufgaben ist also identisch, und die Testumgebungen lassen sich vergleichen. Auf der Control Plane ohne Nodes:
- alle 120 Aufgaben wurden abgeschlossen, keine Deadline wurde verpasst;
- die Arbeit verteilte sich auf fünf Physiken: reversible Logik übernahm 47 Aufgaben, Photonik 27, CPU 26, p-Bits 12, SFQ 8;
- in 3 von 120 Fällen (2,5 %) blieb die Qualität unter dem Ziel, was innerhalb der angegebenen Konfidenz von 90 Prozent liegt;
- der Median der Zeit von der Erstellung einer Aufgabe bis zu ihrer Übernahme durch einen Agenten liegt bei 2,3 s, das 95. Perzentil bei 3,7 s. Das ist der Preis des Pollings: Der Scheduler prüft die Aufgaben alle 2 Sekunden, der Agent einmal pro Sekunde;
- alle 120 Quittungen des Laufs in sechs Ketten wurden mit den öffentlichen Schlüsseln der Substrate geprüft, ohne jeden Zugriff auf das System.
Auf kuberoot, wo physis als Pods läuft:
- alle 120 Aufgaben wurden ohne verpasste Deadlines abgeschlossen, und die Verteilung auf die Physiken war dieselbe: reversible Logik 47, Photonik 27, CPU 26, p-Bits 12, SFQ 8. Bei gleicher Eingabe trifft der Scheduler dieselben Entscheidungen, wo immer er läuft;
- Qualitätsunterschreitungen: 3 von 120;
- Latenz bis zur Übernahme: 2,4 s im Median, 3,6 s im 95. Perzentil;
- nach dem Lauf wurden alle 132 Quittungen in 7 Ketten mit den öffentlichen Schlüsseln der Substrate geprüft, und eine manipulierte Kopie wurde zurückgewiesen;
- aufgeschobene Arbeit ist live zu sehen: In Test TC-09 legte der Scheduler eine flexible Aufgabe mit einer Deadline von einem Tag 18–19 Stunden später, auf den Mittag des Folgetags, für den die Prognose im französischen Stromnetz 63 g CO₂ pro kWh vorhersagte.
Kuberoot fand außerdem einen Fehler, den die Testumgebung ohne Nodes übersehen hatte. Der Seed des Zufallszahlengenerators wird in der Quittung als 64-Bit-Ganzzahl gespeichert, doch bei der Umwandlung des Objekts für die API lief er durch eine Gleitkommazahl und verlor seine niederwertigen Stellen. Die Signatur deckte den exakten Wert ab, gespeichert war aber der gerundete. Auf kuberoot wies Test TC-10 eine solche Quittung zu Recht zurück. Zahlen werden jetzt exakt übergeben, und ein Unit-Test prüft, dass eine Quittung den Weg durch die API und zurück ohne eine einzige Änderung übersteht.
Eine zweite echte Physik: die GPU. Auf der Testumgebung ohne Nodes kam zu den 14 übrigen ein fünfzehnter Agent hinzu, gpu-m4. Er schickt die Klassifikation über MLX an die GPU des Apple M4 (tools/gpu-worker.py) und misst die Zeit auf der GPU selbst, wobei er die Vorbereitung der Metal-Compute-Kernel (der Programme, die auf der GPU laufen) von der eigentlichen Berechnung trennt. Die Kalibrierung über 21 Batches ergab eine Qualität, die der des exakten Klassifikators entspricht (float32 ändert keine einzige Antwort), einen Durchsatz von 8·10⁸ Multiply-Accumulate-Operationen pro Sekunde bei einem Batch von 1797 Bildern bis 6,5·10⁹ bei einem synthetischen Batch von 200.000 sowie eine Vorbereitungszeit von 3–14 ms (etwa 50 ms, wenn die kompilierten Kernel noch nicht im Cache liegen; separat gemessen in hack/gpu-benchmark.py, results/gpu-throughput-benchmark.txt). Die Conformance auf der Testumgebung mit GPU liegt bei 17 von 17.
Anschließend ließen wir dieselben Batches auf einer echten CPU und einer echten GPU laufen, jeweils fünfmal (results/real-cpu-vs-gpu.json, Mediane):
| Batch | CPU, Zeit | CPU, Energie | GPU, Zeit | GPU, Energie |
|---|---|---|---|---|
| 100 Bilder | 0,14 ms | 0,8 mJ | 5,5 ms | 44 mJ |
| 500 | 0,29 ms | 1,7 mJ | 6,0 ms | 48 mJ |
| 1797 | 1,1 ms | 6,9 mJ | 6,7 ms | 53 mJ |
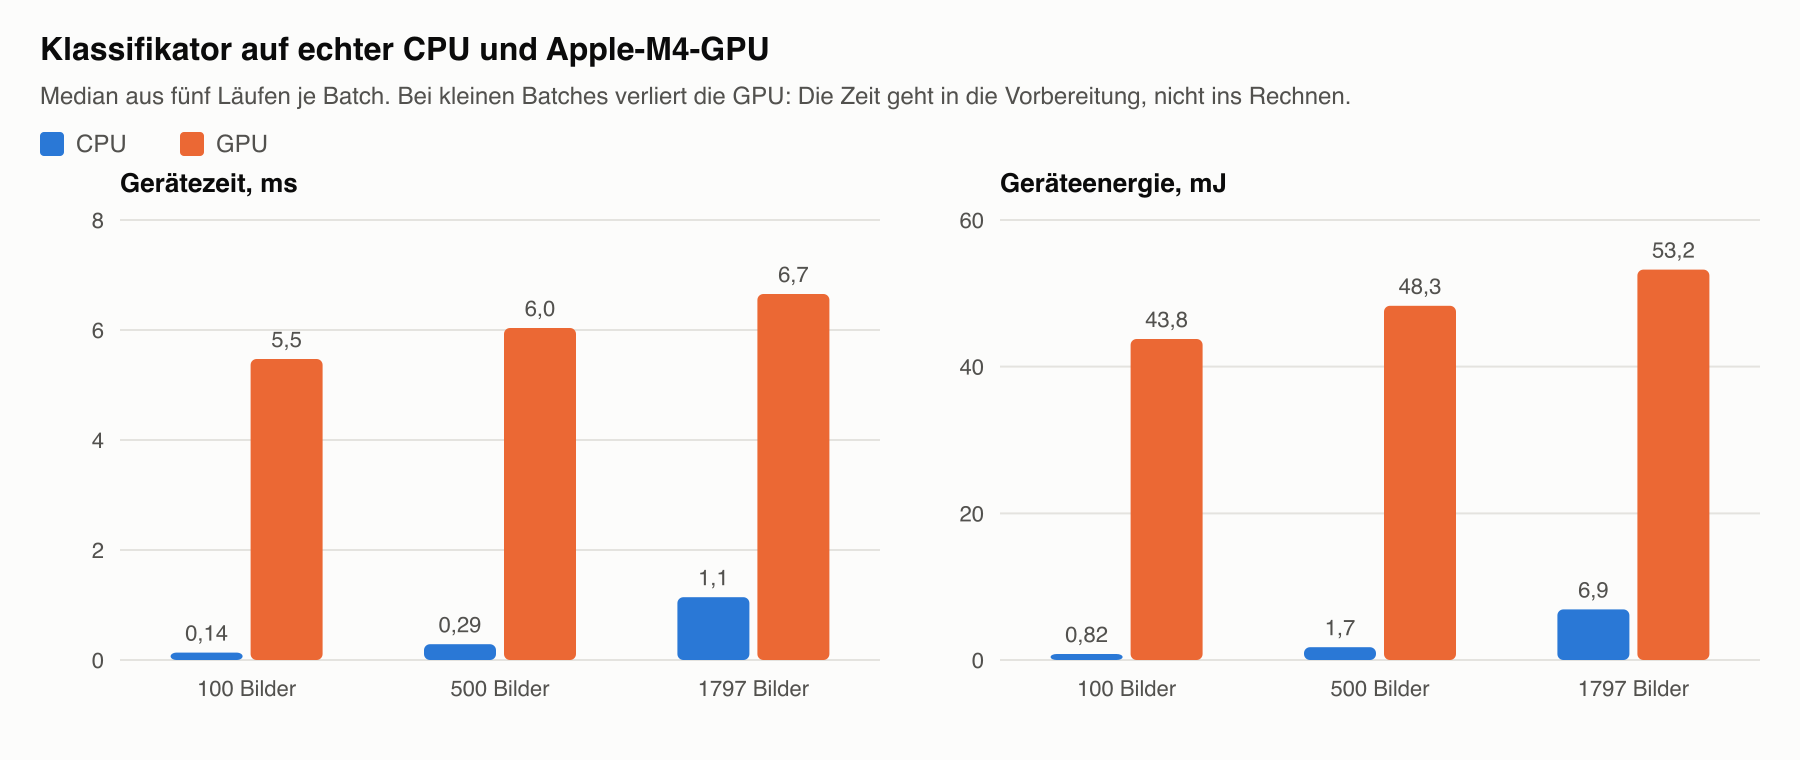
Zeit und Energie einer echten CPU und einer echten Apple-M4-GPU bei Batches von 100, 500 und 1797 Bildern.
Bei solchen Batches unterliegt die GPU der CPU in der Zeit um das 6- bis 40-Fache und in der Energie um das 8- bis über 50-Fache, weil die Vorbereitung und nicht die Berechnung alles aufzehrt. Die Energie ist hier die gemessene Zeit multipliziert mit einer Modellleistung, die für die CPU als Anteil der Nennleistung (TDP) eines Server-EPYC angesetzt und für die GPU angenommen ist. Bei den gemessenen Geschwindigkeiten würden sich die Zeiten bei etwa 12.000 Bildern angleichen, die Energie erst später, und wo genau, hängt von der Leistung der GPU ab, die wir noch nicht messen. Ohne Korrekturen aus den Quittungen irrt sich der Scheduler immer dann, wenn sich die Modelle irren. Bei einem Ziel von 1,0 wählt er die GPU (das ist in der Aufzeichnung der Testumgebung oben zu sehen), obwohl die echte CPU bei diesem Batch achtmal sparsamer ist. Dasselbe Experiment zeigt, wozu Quittungen nötig sind. Das CPU-Modell mit seiner anfänglichen, unkalibrierten Geschwindigkeit überschätzte die Zeit um das 9- bis 22-Fache, das GPU-Modell unterschätzte sie um ein Drittel; der Scheduler korrigiert beide anhand der Quittungen (Abschnitt 8.4).
Kubernetes ohne Container und ohne Nodes. Die letzte Testumgebung war ein kuberoot-Knoten aus der Distribution physis, gebaut im Workshop-Cluster und in einer virtuellen Maschine auf einem der Server dieses Clusters gebootet. Auf ihm laufen nur Dienste des Betriebssystems: der Speicher kine (ein etcd-Ersatz auf Basis einer gewöhnlichen Datenbank), der API-Server, der Controller Manager, die Knoten-API von kuberoot, der physis-Scheduler und die Substrat-Agenten – anfangs zwölf, im jüngsten Build alle zwanzig emulierten. kubectl get nodes und kubectl get pods -A liefern nichts zurück, denn dieser Cluster hat keine Node-Objekte und keine Pods, und auf dem Knoten gibt es weder containerd noch kubelet. Die Conformance-Suite besteht mit zwölf wie mit allen zwanzig Substraten 17 von 17 (results/containerless-node*.txt, results/conformance-kuberoot-containerless-*.json). Der erste Build mit acht Substraten kam auf 15 von 17: TC-13 schaltet vorübergehend ein Substrat stumm, wodurch für MaxCut nur eine Physik übrig blieb, und für TC-14 fehlte ein langsames Substrat, das sich mitten in der Arbeit abtrennen ließ. Das ist eine Anforderung an die Menge der Substrate, nicht an den Kern, und mit zwölf Substraten bestehen die Tests. Beim Booten starten die Agenten zweimal neu, während der API-Server hochfährt; die Reihenfolge der Dienste im Profil ließe sich also noch verbessern.
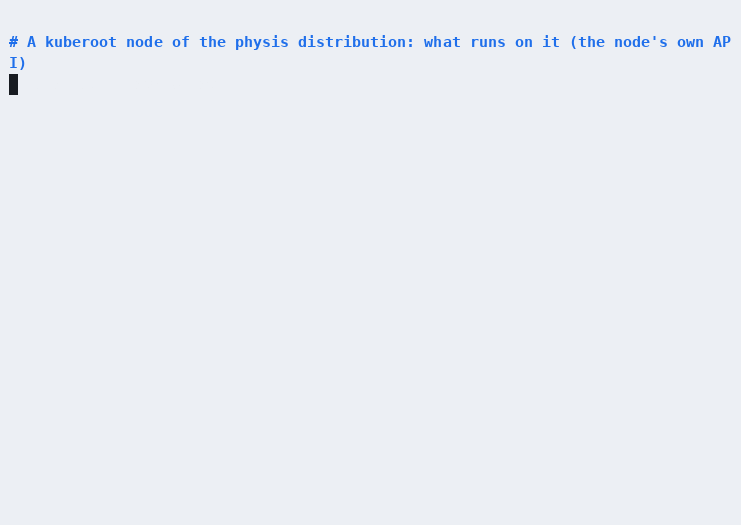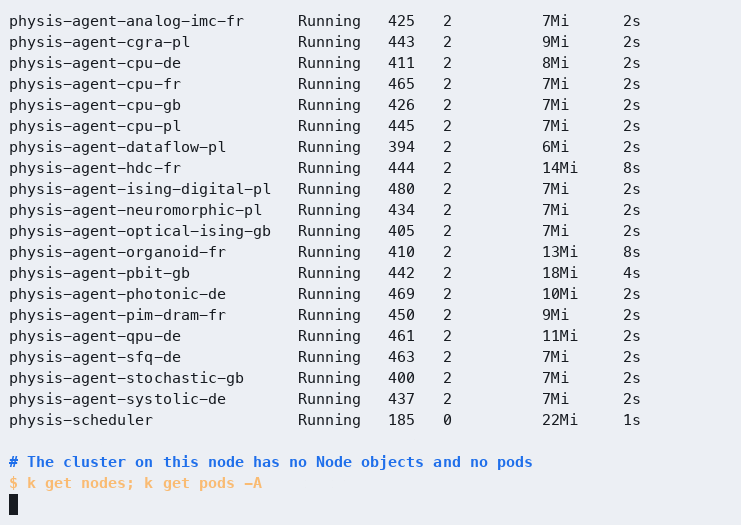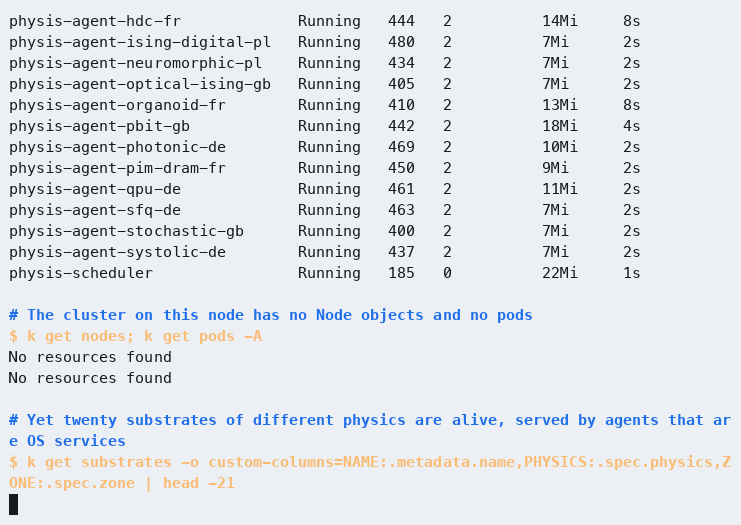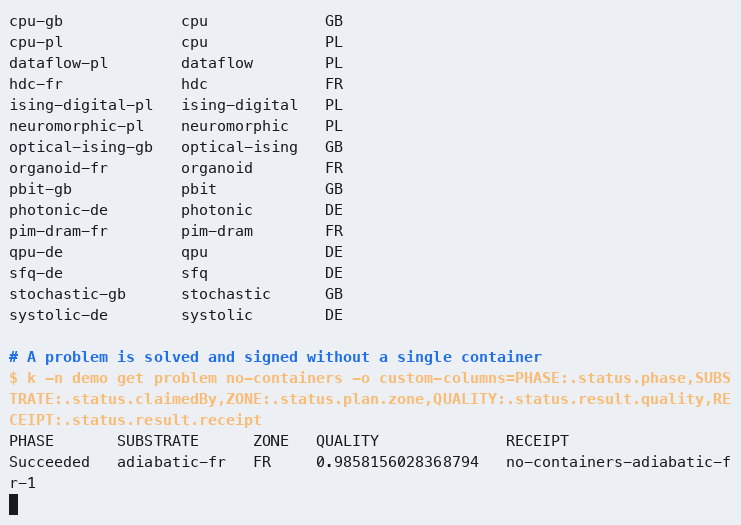
Ein kuberoot-Knoten ohne Container: nur Dienste des Betriebssystems, leere Node- und Pod-Listen, zwanzig Substrate und eine gelöste Aufgabe.
Eine Brücke von DRA. Auf der Testumgebung veröffentlichten wir einen ResourceSlice mit einem Gerät, der Apple-M4-GPU des Laptops, für das der Treiber Geschwindigkeit und Vorbereitungszeit angab, zur Leistung aber nichts sagte. physis-dra-bridge legte daraus das Substrat dra-m4-gpu0 an, dessen Modell Geschwindigkeit und Vorbereitung mit Verweis auf den Treiber und Leistung sowie Vorbereitungsenergie als Annahmen kennzeichnet. Ein Agent mit dem Flag -adopt übernahm es, ohne seine Beschreibung zu ändern, und löste eine Klassifikationsaufgabe auf der echten GPU (results/dra-bridged-*.json). Dasselbe wiederholten wir auf einem kuberoot-Cluster mit vier Nodes: Das Gerät cpu.example.com/rack-7/cpu0, für das der Treiber nur die Leistung angab, wurde zum Substrat, ein Agenten-Pod übernahm es, und eine nur im Rechtsraum CH zulässige Aufgabe ging an dieses Substrat (results/dra-cluster-*.json).
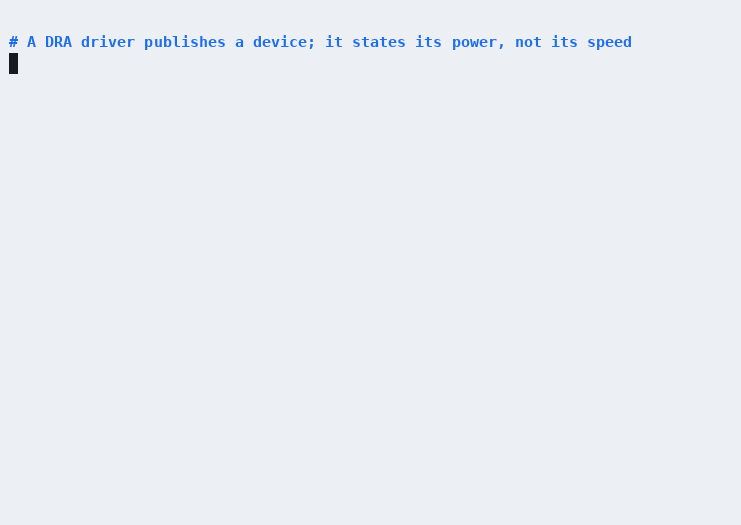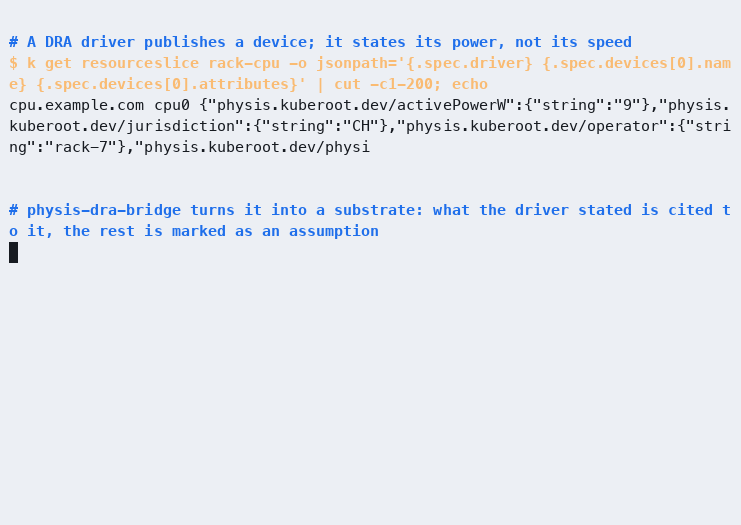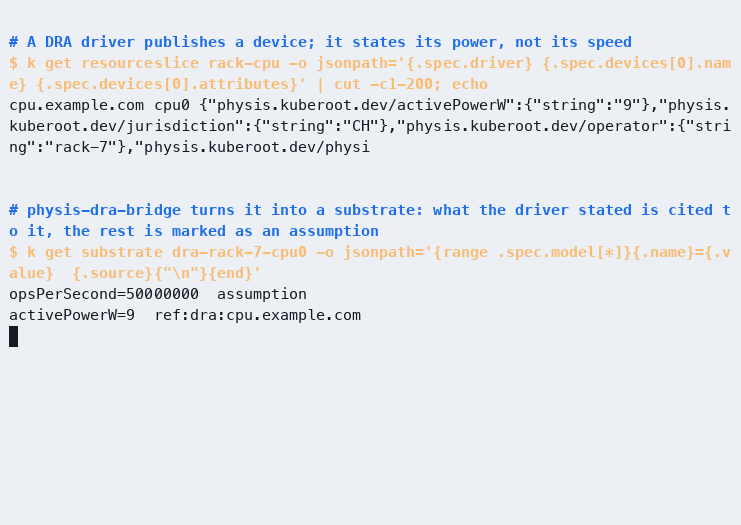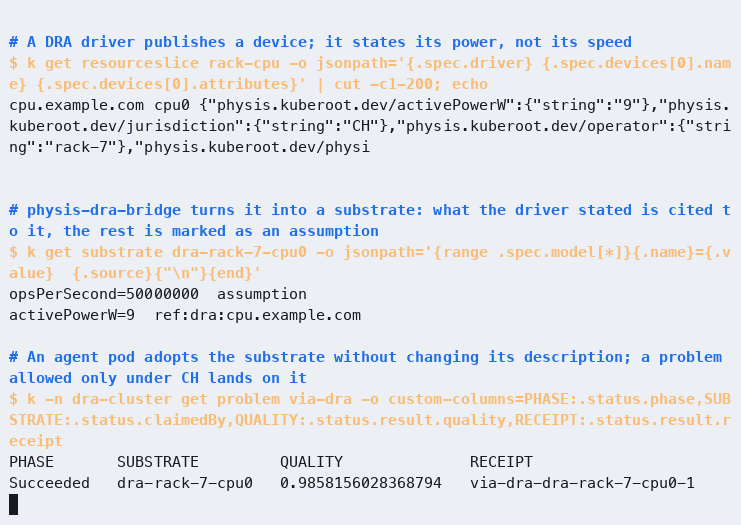
Eine Brücke von DRA auf einem kuberoot-Cluster: ein Gerät aus einem ResourceSlice, ein Substratmodell mit Herkunft der Parameter und eine gelöste Aufgabe.
Hierarchie des Schedulings. Wir ersetzten den einzelnen Scheduler durch einen globalen und zwei Standort-Scheduler für DE und FR und reichten einen Strom von 12 Aufgaben ein, die in allen vier Zonen zulässig waren. Die globale Ebene wählte die Zone FR und übergab die Aufgaben an diesen Standort, der das Substrat auswählte; alle 12 wurden vom Standort FR eingeplant. Danach hielten wir die globale Ebene an und reichten weitere 12 Aufgaben ein, sechs nur in DE zulässig und sechs überall. Ohne globale Ebene plante der Standort DE alle sechs Aufgaben seiner Zone selbstständig ein, und der Standort FR übernahm die Aufgaben ohne Zonenbeschränkung. Es gab weder Umplanungen noch doppelte Ausführung, denn das optimistische Locking der API trennt zwei Standorte, die sich derselben Aufgabe annehmen (results/hierarchy-problems.json).
Auf dem kuberoot-Cluster, wo die Ebenen als Pods laufen, zeigte der erste Lauf ein gemischtes Bild: Die globale Ebene plante einige Aufgaben selbst ein, und die Standorte übernahmen andere, während die globale Ebene noch lebte. Dafür gab es zwei Ursachen. Der API-Server wies jede Erneuerung der Lease zurück, weil die Zeit darin mit Nanosekunden geschrieben war, das Feld aber nur Mikrosekunden akzeptiert; zudem wurde die Lease zu Beginn des Scheduling-Zyklus erneuert, und auf einem Pod mit CPU-Limit dauerte der Zyklus länger als erlaubt. Die Lease wird jetzt mit eigenem Timer und im richtigen Format erneuert, und ob eine Ebene noch lebt, wird ebenso beurteilt wie bei der Leader Election in client-go, der Standard-Clientbibliothek von Kubernetes: daran, ob sich der Wert der Lease ändert, und nicht durch den Vergleich fremder Uhren mit der eigenen. Nach der Korrektur verlief auf dem Cluster alles wie auf der Testumgebung: Die globale Ebene übergab alle 12 Aufgaben an den Standort FR, und ohne globale Ebene planten die Standorte ihre eigenen Aufgaben ein (results/hierarchy-cluster-*).
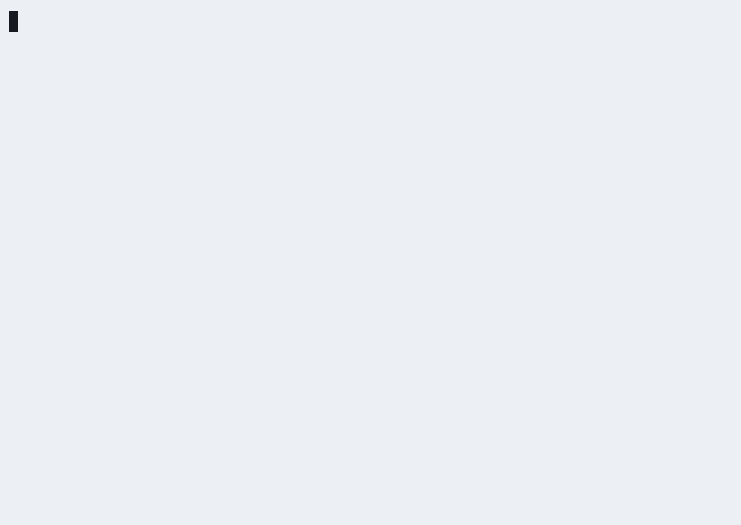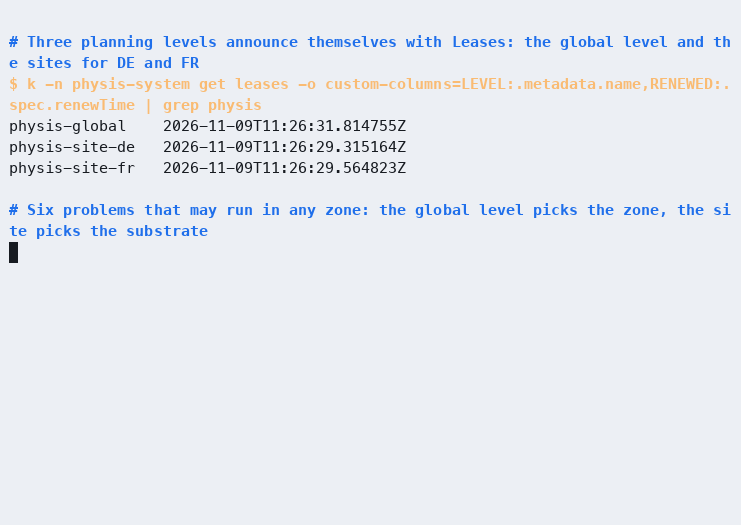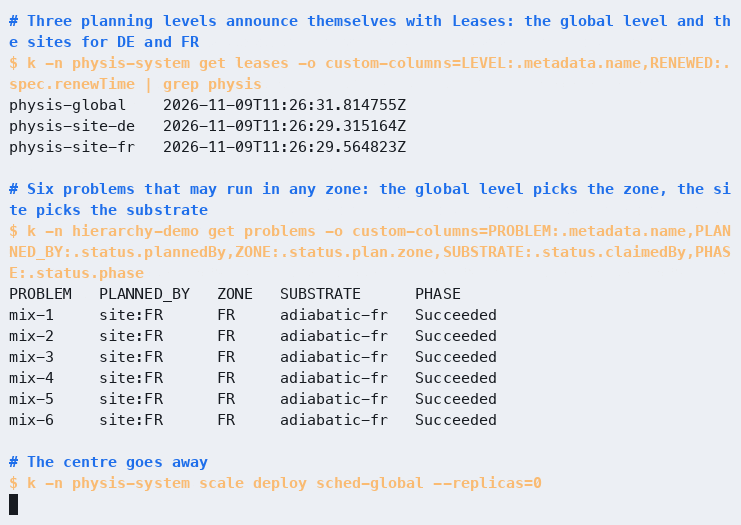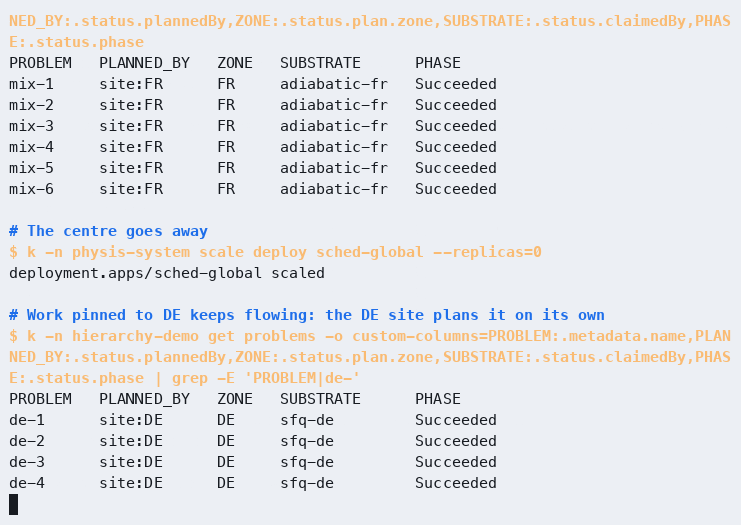
Hierarchie des Schedulings auf einem kuberoot-Cluster: Leases von drei Ebenen, Aufgaben, die über den Standort FR geleitet werden, und nach dem Anhalten der globalen Ebene DE-Aufgaben, die der Standort DE einplant.
Der Gerätekern in einer WASI-Sandbox. Der Agent wasi-cpu-ch auf der Testumgebung rechnet und signiert selbst nichts; das übernimmt für ihn physis-device, gebaut für WebAssembly und ausgeführt in wasmtime, mit Zugriff nur auf das eigene Zustandsverzeichnis und auf die Daten. Der Signaturschlüssel wurde in der Sandbox erzeugt und verlässt sie nie. Fünf MaxCut-Aufgaben auf dem Graphen G1 wurden mit einer Qualität von 0,994–0,996 gelöst, und die Quittungen sind mit dem Schlüssel aus der Sandbox signiert und bestehen die Kettenprüfung (TC-10) (results/wasi-device-*.json). Nebenbei deckte dieses Experiment einen Fehler in der neu hinzugekommenen lokalen Ebene auf: Der Agent nahm seine eigene Sperre zweimal und blieb nach dem ersten Ergebnis hängen. Der Fehler wurde vor der Veröffentlichung behoben.
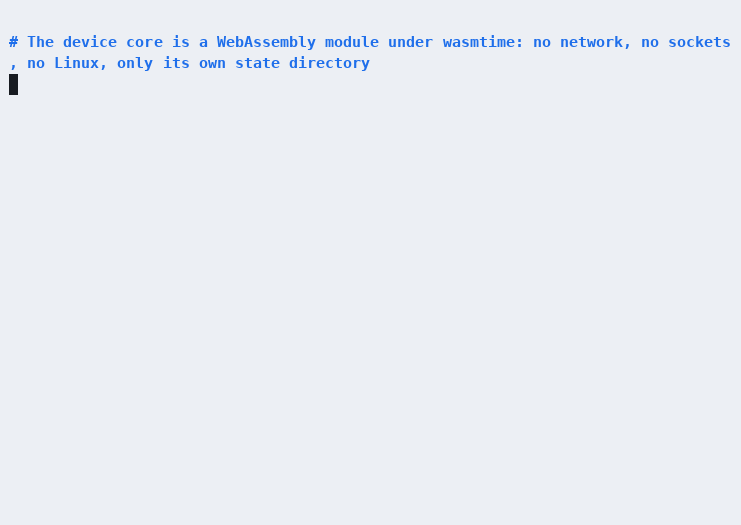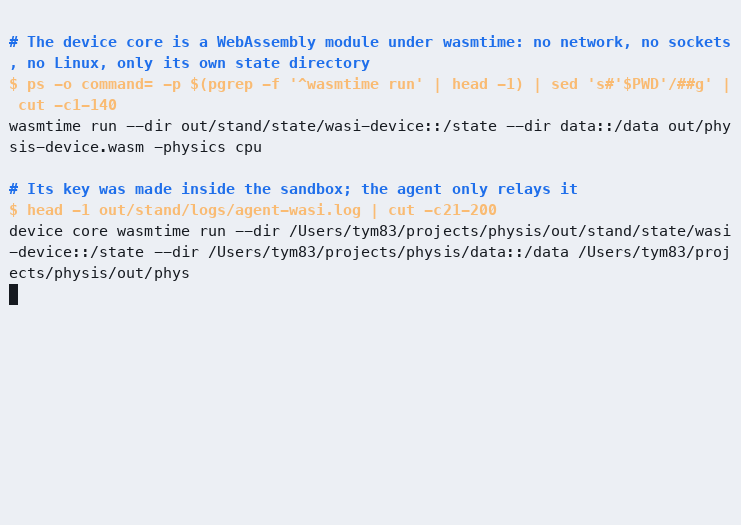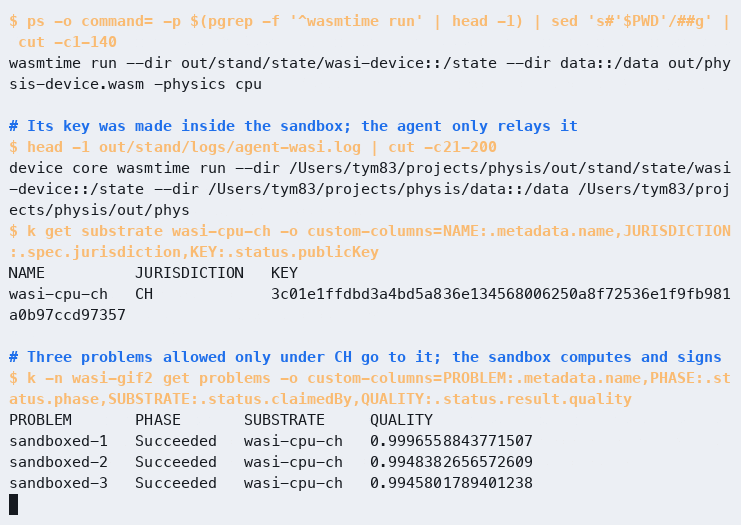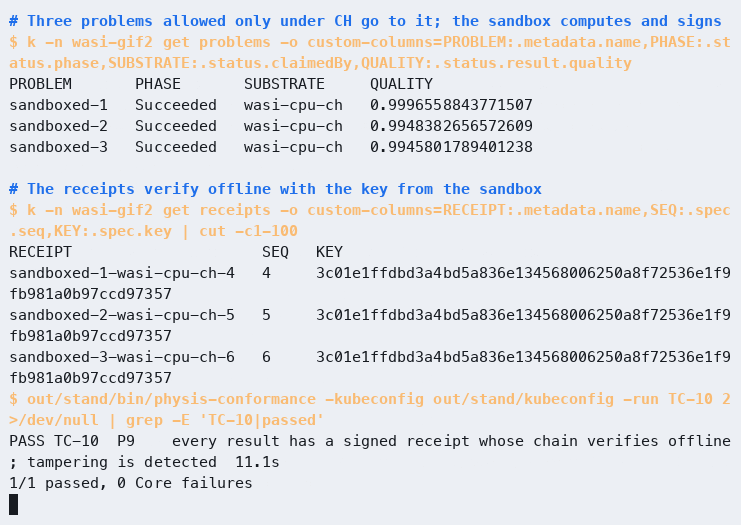
Der Gerätekern in einer WASI-Sandbox: wasmtime mit Zugriff nur auf das eigene Verzeichnis, ein in der Sandbox erzeugter Schlüssel, gelöste Aufgaben und Prüfung der Quittungskette.
MCP für Agenten. Auf der Live-Testumgebung und danach auf dem kuberoot-Cluster lieferte das Werkzeug plan aus physis-mcp einen Dry-Run-Plan mit Alternativen und maschinenlesbaren Begründungen, submit mit einer requestID legte eine Aufgabe an, und ein wiederholtes submit mit derselben requestID gab die bestehende Aufgabe zurück, statt eine zweite anzulegen (results/mcp-cluster.jsonl). Eine unerfüllbare Anfrage wird mit dem Code QualityUnreachable abgelehnt, anhand dessen der Agent entscheiden kann, wie er weiter vorgeht.
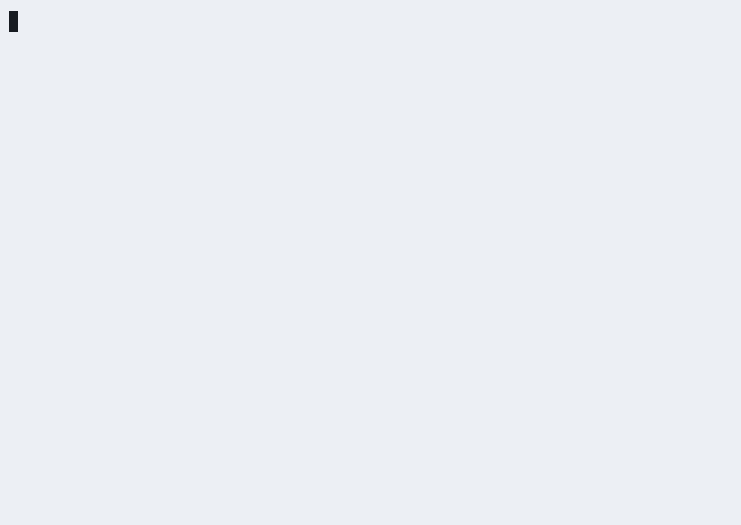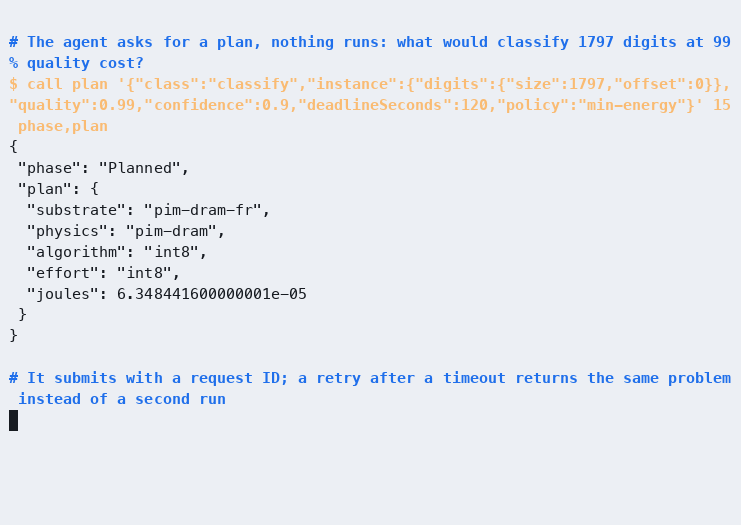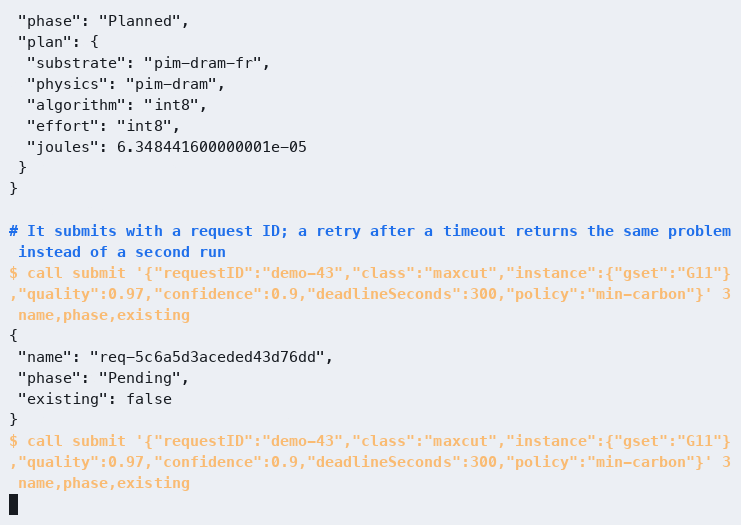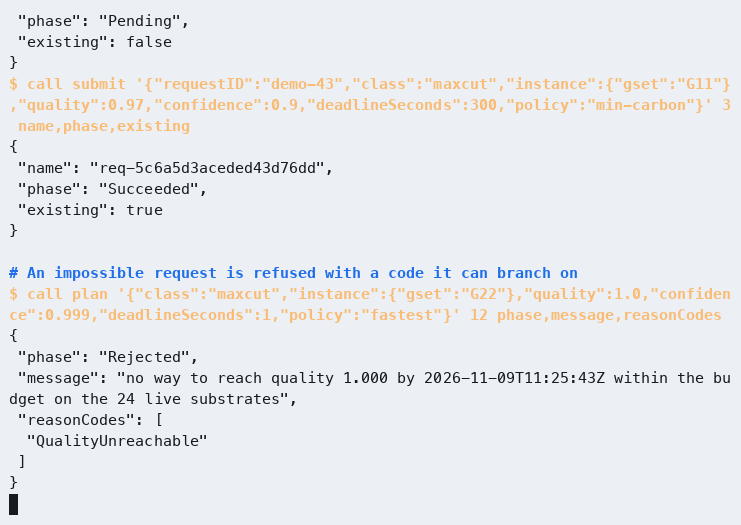
MCP aus Sicht des Agenten: ein Dry-Run-Plan, eine Einreichung mit Request-ID, eine Wiederholung, die keinen zweiten Lauf startet, und eine Ablehnung mit Code.
Fünf Architekturen, die die Art des Rechnens verändern. Die Testumgebung erhielt fünf weitere Substrate: ein systolisches Tensor-Array (nach dem Vorbild der TPU), Rechnen im DRAM (HBM-PIM), einen Dataflow-Prozessor (Groq) sowie stochastisches und hyperdimensionales Rechnen. Ihre Emulatoren tun genau das, was die Hardware täte: Sie quantisieren Gewichte und Eingaben mit Block-Skalierung auf FP8 oder FP4, rechnen in int8 mit 32-Bit-Akkumulation, kodieren Zahlen als zufällige Bitströme, bilden Hypervektoren und trainieren sie. Die Antwortqualität wird dadurch gemessen und nicht angenommen. Zeit und Energie stammen aus Gerätemodellen mit Quellen: Spitzengeschwindigkeit und Leistung der TPU v1 [26], die Spitzengeschwindigkeit von Groq [28] (die Leistung ist eine Annahme, da die Quellen sie nicht nennen), die Geschwindigkeit von HBM-PIM [31] mit einer Energie, die aus den Kosten eines DRAM-Lesezugriffs [36] und dem PIM-Gewinn [32] abgeleitet ist, sowie Annahmen mit Spannbreiten für die stochastischen und hyperdimensionalen Verfahren. Die Kalibrierung ergab 3024 Datensätze (results/calibration-numeric-runs.csv). Ergebnisse bei einem Batch von 1797 Bildern (Qualität als Anteil des exakten Klassifikators):
| Substrat | Variante | Qualität | Energie pro Batch |
|---|---|---|---|
| Tensor-Array | int8 | 1,000 | 40 mJ |
| Tensor-Array | FP8 (E4M3) | 0,999 | 40 mJ |
| Tensor-Array | MXFP4 (E2M1) | 0,984 | 40 mJ |
| Rechnen im DRAM | int8 | 1,000 | 53 µJ |
| Dataflow | int8 | 1,000 | 30 mJ |
| Stochastisch | 64-Bit-Strom | 0,975 | 0,37 µJ |
| Stochastisch | 1024-Bit-Strom | 0,998 | 5,9 µJ |
| Hyperdimensional | 512 Dimensionen | 0,964 | 0,04 µJ |
| Hyperdimensional | 2048 Dimensionen | 1,007 | 0,16 µJ |
Aus der Tabelle folgen drei Schlüsse. Reduzierte Genauigkeit kostet kaum Qualität: FP8 verliert ein Tausendstel, int8 nichts und FP4 anderthalb Prozent. Stochastische und hyperdimensionale Verfahren erkaufen Qualität mit Stromlänge und Dimensionalität, genau wie das Annealing sie mit Schritten erkauft. Und bei kleinen Batches unterliegen das Tensor-Array und der Dataflow-Prozessor dem Rechnen im Speicher, weil ihre Energie in die Vorbereitung und die Leistung einer ganzen Karte fließt statt in die Multiplikationen (aus demselben Grund kosten die drei Varianten des Tensor-Arrays gleich viel).
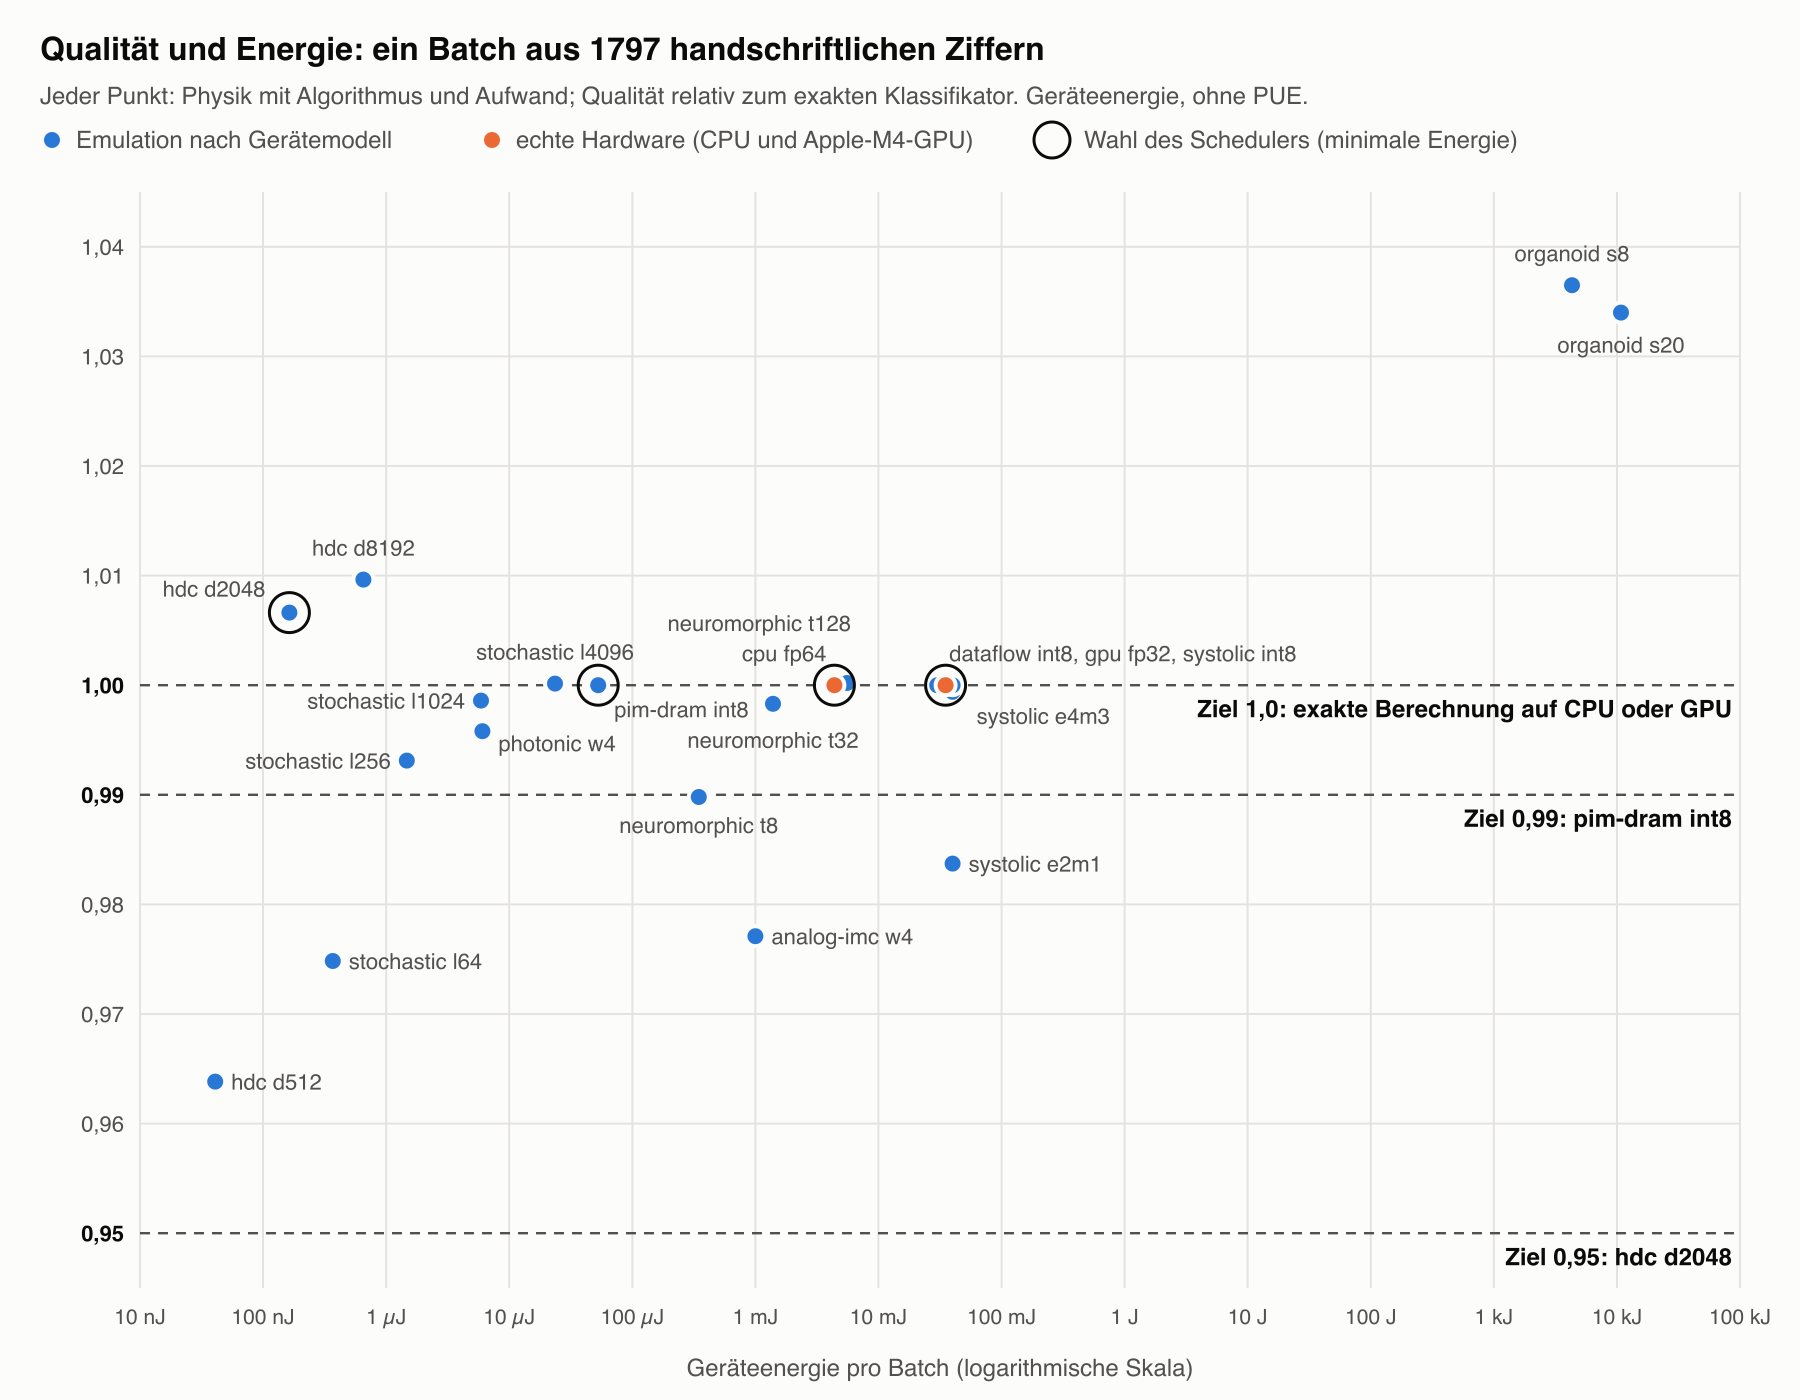
Qualität gegen Energie bei einem Batch von 1797 Bildern für alle Klassifikatoren. Eingekreist sind die Entscheidungen des Schedulers bei Zielen von 0,95, 0,99 und 1,0.
Entscheidend ist aber, dass die Wahl von der geforderten Qualität abhängt. Wir befragten den Scheduler zu einem Batch von 1797 Bildern (Dry-Run-Plan, minimale Energie). Bei einem Ziel von 0,95 nimmt er hyperdimensionales Rechnen mit 2048 Dimensionen (etwa 0,2 µJ einschließlich PUE); bei 0,99 bestehen diese die Konfidenzprüfung nicht mehr, und der Scheduler wechselt zu int8 im Speicher (64 µJ); bei 1,0 bleibt nur exaktes Rechnen auf CPU und GPU. Mit der Policy „am schnellsten“ gewinnt bei Zielen von 0,95 und 0,99 der Dataflow-Prozessor. Die Conformance auf der Testumgebung mit allen 20 Substraten liegt bei 17 von 17.
Als Letztes kam ein rekonfigurierbares CGRA-Fabric mit den Parametern von Plasticine hinzu, also 12,3 TFLOP/s bei höchstens 49 W [40], wobei die untere Grenze der Geschwindigkeit berücksichtigt, dass reale Anwendungen 18–25 % der Spitzenleistung erreichen. Es führt dasselbe Annealing und denselben exakten Klassifikator aus wie der Prozessor, die Qualität ist also gleich, verschieden sind Geschwindigkeit und Energie. Die Kalibrierung ergab 669 Datensätze (results/calibration-cgra-runs.csv). Damit hat die Testumgebung 21 Substrate, die Conformance ergibt wieder 17 von 17, und das Fabric erscheint sofort auf der Pareto-Front. In Dry-Run-Plänen mit der Policy „am schnellsten“ schlägt es bei MaxCut auf dem Graphen G22 die reversible Logik und die p-Bits, und bei der Klassifikation liegt es gleichauf mit dem Rechnen im Speicher und dem Dataflow-Prozessor.
Ein kuberoot-Cluster aus zwei Maschinen und eine echte Netzwerkpartition. Die dritte Testumgebung besteht aus zwei virtuellen kuberoot-edge-Maschinen vom selben Boot-Medium. Jede hat zwei Netzwerkschnittstellen, eine für den Zugang von außen und eine für eine direkte Verbindung zwischen den Maschinen, mit den Adressen 10.0.0.11 und 10.0.0.12. Die erste Maschine dient als Control-Plane-Node, die zweite trat dem Cluster mit einer einmaligen Einladung (JoinTicket) als Worker-Node bei. Die Agenten sind durch eine Scheduling-Bedingung im Helm-Chart gleichmäßig auf die Maschinen verteilt, sieben und sieben; der Scheduler ist an den Control-Plane-Node gebunden. Die Conformance-Suite besteht auf diesem Cluster 17 von 17.
Vor allem aber erlaubt der zweite Node, eine Partition auf Netzwerkebene zu testen statt über eine Annotation. Ein privilegierter Pod auf dem Worker-Node schaltet dessen Cluster-Netzwerkschnittstelle ab und nach einer festgelegten Zeit wieder ein. Die Agenten auf dem Worker-Node verlieren dabei jeden Kontakt zum API-Server, auch für Heartbeats, Übernahmen und Berichte.
- Ein Strom während der Partition. Ein Strom von 120 Aufgaben, bei dem der Worker-Node ab Sekunde 90 für zwei Minuten die Verbindung verliert. Alle 120 Aufgaben wurden abgeschlossen. Während der Partition übernahmen die Substrate des Control-Plane-Nodes 41 Aufgaben, die des abgeschnittenen Nodes keine. Keine Aufgabe blieb an einem verstummten Substrat hängen, denn der Scheduler bot diese Substrate nicht mehr an, sobald ihr Heartbeat veraltet war. Als die Verbindung zurückkam, übernahmen die Agenten des Worker-Nodes wieder Arbeit.
- Vor der Partition übernommene Arbeit. Der Agent der lebenden Zellkultur wurde auf den Worker-Node verlegt und erhielt einen Batch von 100 Bildern; sobald er ihn übernommen hatte, brach die Verbindung für 90 Sekunden ab. Die Arbeit war 11 Sekunden nach der Übernahme fertig, bereits ohne Verbindung. Der Bericht mit signierter Quittung traf 2 Sekunden nach Wiederherstellung der Verbindung ein.
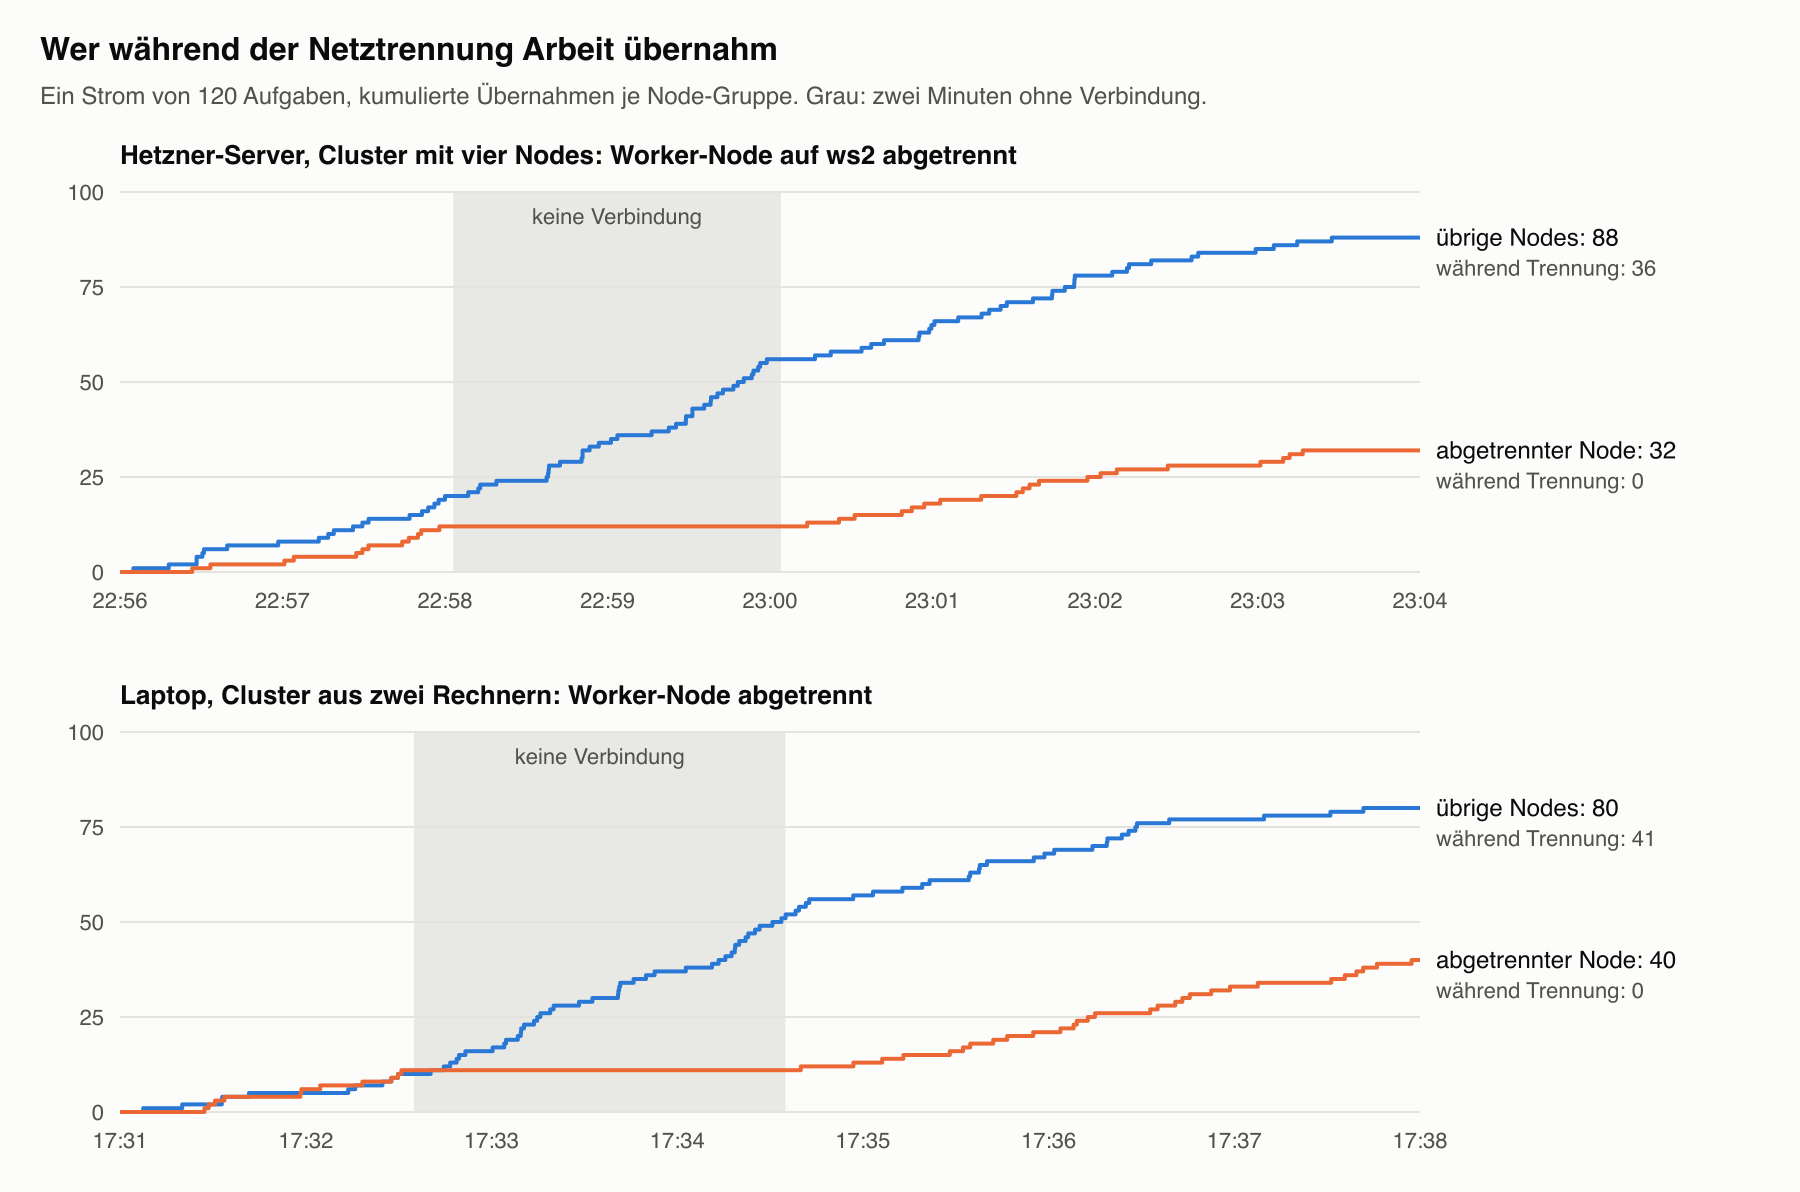
Übernahmen von Aufgaben im Zeitverlauf: Solange der Worker-Node abgeschnitten ist, übernehmen nur die anderen Nodes Arbeit.
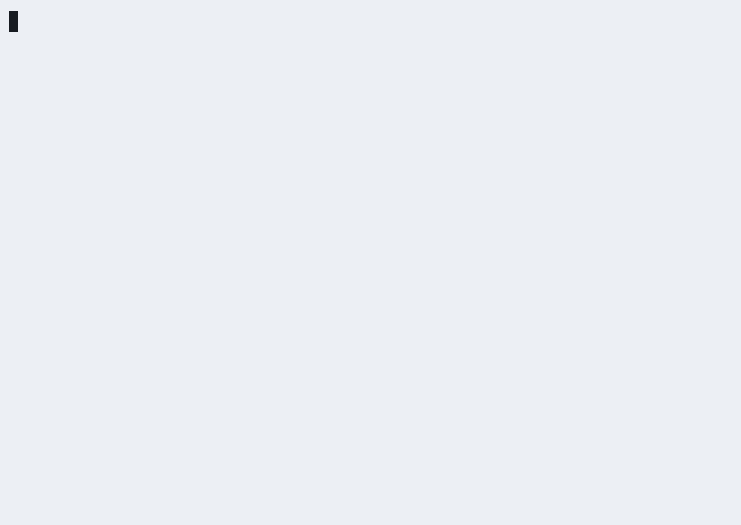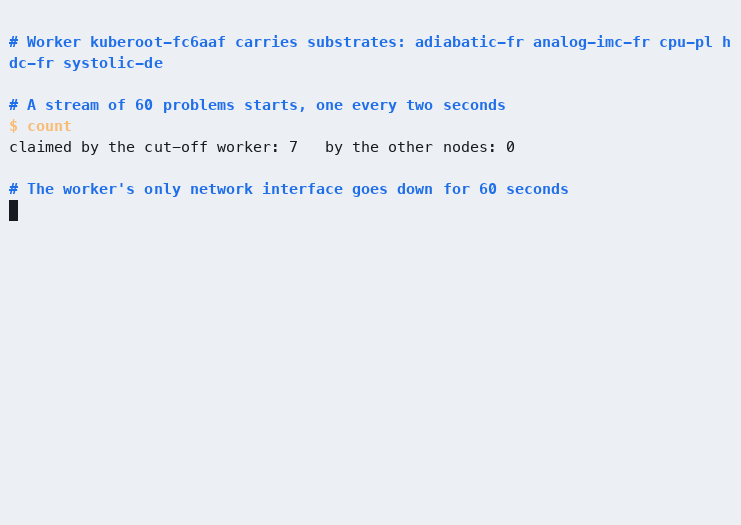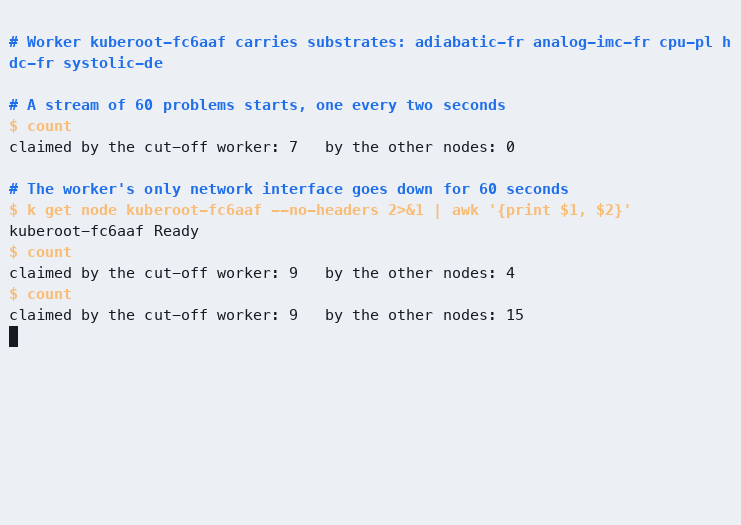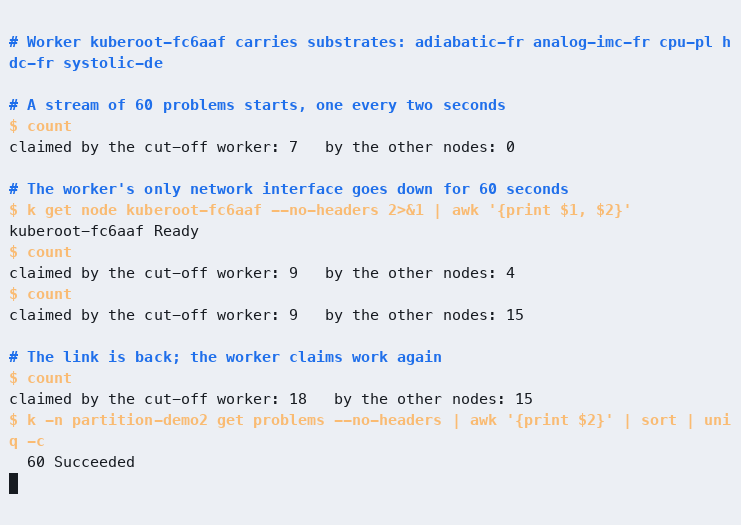
Eine Netzwerkpartition in Echtzeit auf einem kuberoot-Cluster: Der Aufgabenzähler des abgeschnittenen Nodes steht still, während die anderen Nodes Arbeit übernehmen, und sobald die Verbindung zurück ist, nimmt der Node wieder Aufgaben. Alle 60 Aufgaben wurden abgeschlossen.
Unsere Testumgebung brachte drei weitere Fehler ans Licht. Der erste, ein ernster, steckte im Prototyp: Der Agent bewahrte seinen Signaturschlüssel im temporären Verzeichnis des Pods auf. Nach einem Neustart kam er mit einem neuen Schlüssel zurück, ersetzte stillschweigend den veröffentlichten, und seine früheren Quittungen ließen sich nicht mehr prüfen. TC-10 bemerkte das, nachdem die Agenten neu gestartet worden waren. Der Schlüssel liegt jetzt in einem Secret und übersteht Neustarts und Verlegungen des Agenten; ändert sich der Schlüssel doch, bleibt der alte in der Liste früherer, ausgemusterter Schlüssel des Substrats. Frühere Quittungen werden gegen ihn geprüft, und eine Quittung, die mit einem nie vom Substrat veröffentlichten Schlüssel signiert ist, wird zurückgewiesen. Nach der Korrektur starteten wir alle 14 Agenten neu, und die Schlüssel blieben unverändert. Der zweite Fehler lag in der Testsuite selbst: TC-14 setzte eine Annotation auf Grundlage eines veralteten Lesestands des Objekts und geriet mit dem Heartbeat des Agenten in Konflikt. Bei einem Konflikt wiederholt der Test den Schreibvorgang jetzt. Der dritte betraf die Paketierung: Das Helm-Chart lieferte eine alte Kopie der Kalibrierung ohne GPU, ohne die neuen Architekturen und ohne CGRA aus, sodass diese Substrate auf dem Cluster zwar lebten, der Scheduler sie aber nie wählte, und die Conformance bemerkte es nicht. Das Chart bezieht die Kalibrierung jetzt aus results/, und ein Test schlägt fehl, wenn die Kopien auseinanderlaufen; nach der Korrektur wählt der Scheduler auf dem Cluster dieselben Physiken wie auf der Testumgebung.
Genau das prüfen TC-13 und TC-14 mit einer Annotation, nun aber bei einer echten Netzwerkpartition. Die Daten liegen in results/partition-* und results/conformance-kuberoot-*.json, die Skripte in hack/kuberoot-local-multi.sh und hack/kuberoot-partition-*.sh.
8.7. Die Umgebungen, in denen wir all das getestet haben
| Umgebung | Was darauf getestet wurde |
|---|---|
| Laptop mit Apple M4 (macOS, arm64) | Kalibrierung: 6405 Datensätze über alle Algorithmen auf allen Physiken; Unit-Tests (25 Tests: Solver gegen erschöpfende Suche, Scheduler, Quittungen, Mandate, Hin- und Rückweg einer Quittung durch die API) |
| Control Plane ohne Nodes: kube-apiserver 1.37 und etcd aus envtest, 14 Agenten als Prozesse | Durchgängiger Betrieb ohne Node-Objekte; Live-Strom von 120 Aufgaben; Conformance 17/17 und ein Kontrolllauf mit 0/17 |
| Digitaler Zwilling auf Stromnetzdaten von DE, FR, PL, GB für das erste und dritte Quartal 2026 | Vergleich von sieben Policies, Wert von Prognosen, Datenübertragung, Lernen bei falschem Modell, Empfindlichkeit gegenüber Annahmen |
kuberoot-edge-Cluster: aus dem Quellcode für arm64 gebaut, in QEMU (HVF) unter macOS gebootet, Single-Node-Cluster auf Kubernetes 1.37.1; physis als Pods aus dem Helm-Chart des kubepkg-Pakets, angewendet mit kubectl | Conformance 17/17; Live-Strom von 120 Aufgaben; anschließende Prüfung aller Quittungen; einen Fehler der numerischen Genauigkeit in Quittungen gefunden und behoben |
| kuberoot-Cluster aus zwei Maschinen: dasselbe Boot-Medium mit statischen Cluster-Netzwerkadressen, Worker-Node per JoinTicket beigetreten; Agenten 7 + 7 | Conformance 17/17; Strom von 120 Aufgaben mit einer zweiminütigen Netzwerkpartition des Worker-Nodes; vor der Partition übernommene und danach berichtete Arbeit |
| kuberoot-Cluster in einem Tenant des Cozystack-Workshop-Clusters (KubeVirt auf Hetzner-Servern), amd64, im Cluster gebaut: zuerst drei Nodes (einer auf Server ws1, zwei auf ws3), dann vier (plus ws2) | Conformance 17/17 auf drei und auf vier Nodes; Ströme von 120 Aufgaben mit einer zweiminütigen Netzwerkpartition des Worker-Nodes auf ws3 (drei Nodes) und auf ws2 (vier Nodes); vor der Partition übernommene und danach berichtete Arbeit (drei Nodes); den Fehler mit dem Agentenschlüssel und den Konflikt gleichzeitiger Schreibvorgänge in TC-14 gefunden und behoben |
kuberoot-Knoten ohne Container (Distribution physis): eine virtuelle KubeVirt-Maschine auf einem Server des Workshop-Clusters, physis als Dienste des Betriebssystems, keine Nodes und keine Pods | Conformance 17/17 mit 12 und mit 20 Substraten |
kuberoot-Cluster mit vier Nodes auf dem aktuellen Codestand: 20 Substrate, Kalibrierung aus results/ | Conformance 17/17; Hierarchie der Ebenen als Pods; Brücke von DRA; identitätsbasierte Übergabe zwischen Nodes; MCP; Netzwerkpartition in Echtzeit |
9. Conformance für die Systeme von morgen
Die Kubernetes-Conformance beantwortet die Frage, „ob der Cluster die API genauso umsetzt wie die Referenz“. Unsere Testsuite stellt eine andere Frage: Verhält sich das System so, wie es die Prinzipien verlangen? Es handelt sich um eine Black-Box-Suite: Sie spricht ausschließlich mit der API, legt Aufgaben in einem eigenen Namespace an und urteilt nach dem Verhalten, nicht nach dem Innenleben. Jede Implementierung der Ressourcen physis.kuberoot.dev/v1alpha1 kann sie bestehen, nicht nur unsere. Die vollständige Spezifikation steht in docs/conformance.md.
Die Tests sind auf zwei Stufen verteilt. Die Basisstufe Core ist verpflichtend. Die erweiterte Stufe Extended wird von Produktivsystemen erwartet und darf mit Angabe von Gründen übersprungen werden. Ein übersprungener Test zählt nie als bestanden.
| Test | Stufe | Prinzip | Anforderung |
|---|---|---|---|
| TC-01 | Core | P3 | Jedes aktive Substrat deklariert seine Physik, seine Zone, den Rechtsraum seines Betreibers und ein Modell, in dem jeder Parameter eine Herkunft hat |
| TC-02 | Core | P7 | Arbeit läuft ohne Node-Objekte, und die Rollen des Systems gewähren keinen Zugriff auf Nodes oder Pods |
| TC-03 | Core | P2, P4 | Eine Ergebnisanfrage wird mit einer Prognose für Zeit, Energie und CO₂-Intensität des Stromnetzes eingeplant und bis zu ihrer Deadline abgeschlossen |
| TC-04 | Core | P4 | Der Plan zeigt Alternativen, und keine davon ist in allen Metriken zugleich schlechter als eine andere |
| TC-05 | Core | P5 | Ein unerreichbares Ergebnis wird mit Begründung abgelehnt und nie gestartet |
| TC-06 | Core | P4 | Das Budget ist eine harte Grenze |
| TC-07 | Core | P11 | Erlaubte Zonen und Rechtsräume der Betreiber sind harte Randbedingungen |
| TC-08 | Core | P14 | Eine Plananfrage als Dry Run liefert einen Plan und startet nichts |
| TC-09 | Extended | P12 | Flexible Arbeit mit langer Deadline wird auf die Alternative mit der geringsten prognostizierten CO₂-Intensität gelegt |
| TC-10 | Core | P9 | Jedes Ergebnis hat eine signierte Quittung; die Kette ist ohne Zugriff auf das System überprüfbar; Manipulationen werden erkannt |
| TC-11 | Core | P9 | Quittungen lassen sich nicht verändern |
| TC-12 | Core | P10 | Arbeit unter einem Mandat mit fremder Signatur wird abgelehnt; ein Plan oberhalb des Schwellenwerts wartet auf die Freigabe durch einen Menschen und läuft danach |
| TC-13 | Core | P7 | Arbeit, die auf ein verstummtes Substrat eingeplant wurde, kehrt in den Pool zurück und läuft auf einem anderen |
| TC-14 | Extended | P8 | Ein Substrat, das nach der Übernahme von Arbeit von der API abgeschnitten wird, führt sie zu Ende und meldet das Ergebnis, sobald die Verbindung wieder steht |
| TC-15 | Core | P2, P3 | Dieselbe Klasse von Aufgaben kann auf mehr als einer Physik laufen |
| TC-16 | Core | P5 | Das Ergebnis weist die erreichte Qualität aus; der Plan nennt eine untere Konfidenzgrenze und die Zahl der zugrunde liegenden Beobachtungen |
| TC-17 | Core | P11 | Der Datentransfer wird anhand von Link-Objekten geschätzt; Pfade durch verbotene Rechtsräume werden nicht genutzt |
TC-13 und TC-14 setzen voraus, dass ein Substrat unerreichbar gemacht wird. In einer realen Installation geschieht das über eine Network Policy; die Referenzsuite verwendet stattdessen ein portables Verfahren, die Annotation physis.kuberoot.dev/simulate-partition-until am Substrat. Sobald der Agent sie sieht, stellt er bis zum angegebenen Zeitpunkt jede Kommunikation mit der API ein, unterbricht aber keine bereits laufende Arbeit.
Ergebnisse
physis besteht 17 von 17 Tests auf fünf Testumgebungen: einer Control Plane ganz ohne Nodes, einem kuberoot-Cluster mit einem einzigen Node, einem kuberoot-Cluster aus zwei virtuellen Maschinen auf einem Laptop, einem kuberoot-Cluster mit vier Nodes auf drei physischen Servern und einem kuberoot-Node ganz ohne Container, auf dem physis als Dienste des Betriebssystems läuft.
Ein Kontrolllauf auf derselben Control Plane mit denselben CRDs, aber ohne Scheduler und Agenten – also ungefähr dem, was blankes Kubernetes bietet – erreichte 0 von 17. Den Kontrolllauf brauchten wir, um die Tests selbst zu prüfen, und er fand einen Fehler in ihnen. Ohne vorhandene Substrate prüfte TC-07 nichts und wurde als bestanden gewertet. Inzwischen verlangt der Test, dass es etwas zu prüfen gibt: aktive Substrate in mindestens zwei Zonen und zwei Rechtsräumen.
Die Suite deckte außerdem fünf echte Fehler im Prototyp auf, bevor wir selbst von ihnen wussten. Erstens wurde ein unbekannter Preis als NaN gespeichert (der Sonderwert „not a number“), der sich nicht nach JSON serialisieren lässt, sodass Pläne schlicht nicht geschrieben wurden. Zweitens (TC-04) ist bei unbekanntem Preis jeder Vergleich mit NaN falsch, weshalb Optionen, die in allen Metriken schlechter waren als andere, auf der Pareto-Front landeten. Richtig ist es, Optionen bei unbekanntem Preis hinsichtlich der Kosten als unvergleichbar zu behandeln und anhand der übrigen Achsen zu entscheiden. Drittens verloren die Quittungen, wie oben beschrieben, an Genauigkeit beim 64-Bit-Seed des Zufallsgenerators; das zeigte sich nur auf kuberoot. Viertens hatte der Agent eine Race Condition, bei der das Ergebnis von der Reihenfolge gleichzeitiger Schreibvorgänge abhängt: Der Heartbeat des Agenten überschrieb die Metadaten des Substrats aus einem leicht veralteten Snapshot und konnte dabei eine Annotation löschen, die der Betreiber gerade gesetzt hatte. Fünftens ging der Signaturschlüssel des Agenten bei einem Neustart verloren (Abschnitt 8.6). Zudem brachte die Suite zwei Fehler in den Tests selbst ans Licht. TC-14 verglich Zeitstempel mit Nanosekundengenauigkeit, während die Annotation sie nur sekundengenau trägt, sodass der Test gelegentlich grundlos fehlschlug; außerdem setzte er die Annotation auf Basis eines veralteten Lesestands des Objekts und geriet so mit dem Heartbeat des Agenten in Konflikt. Genau für solche Befunde ist Conformance da.
10. Grenzen
Dieser Abschnitt ist Teil der Ergebnisse, kein Anhang dazu. Die vollständige Liste steht in docs/limitations.md.
- Sechzehn der achtzehn Physiken sind emuliert. Echt sind CPU und GPU (ein Apple M4 in der Laptop-Testumgebung). Bei der GPU wird die Zeit gemessen, die Leistungsaufnahme dagegen angenommen, weil Apple sie nicht veröffentlicht. Schlussfolgerungen, die auf einer einzigen angenommenen Zahl beruhen, sollte man nicht als Schlussfolgerungen behandeln; die Sensitivitätsanalyse zeigt, welche von ihnen über die gesamten Wertebereiche hinweg Bestand haben.
- Derselbe Annealing-Lauf auf CPU, digitalen, supraleitenden und reversiblen Geräten liefert konstruktionsbedingt identische Qualität. Reale Hardware unterscheidet sich in Präzision und Rauschen.
- Die Emulation des Quantenprozessors ist grob: feste QAOA-Winkel, bis zu 20 Qubits, ein globales Fehlermodell.
- Die lebende Kultur ist ein Echo State Network mit angenommenem Rauschen.
- Die CPU-Energie ist modelliert. Die gemessene CPU-Zeit wird mit einem Anteil der TDP eines einzelnen EPYC-9454P-Kerns multipliziert. Die Energiezähler des Prozessors (RAPL) sind innerhalb der Pods des Clusters nicht zugänglich.
- Die Kalibrierung erfolgte auf einem Laptop (Apple M4). Die CPU-Geschwindigkeit im Simulator stammt vom M4, die Leistungsaufnahme vom EPYC.
- Die CO₂-Intensität für Deutschland, Frankreich und Polen berechnen wir selbst, ohne Importe und Exporte zu berücksichtigen; Braunkohle wird wie Steinkohle behandelt, was die deutsche Intensität zu niedrig ausweist.
- Das Lernen im laufenden Scheduler wird im Arbeitsspeicher gehalten und geht bei einem Neustart verloren; im Simulator bleibt es erhalten. Innerhalb der Conformance-Suite selbst wird der Substratausfall in TC-13 und TC-14 mit einer Annotation simuliert; eine echte Netzwerkpartition wurde in separaten Experimenten auf kuberoot-Clustern aus zwei Maschinen auf dem Laptop und auf den Servern des Workshop-Clusters überprüft (Abschnitt 8.6).
- Die fünf später hinzugekommenen Architekturen (Tensor-Array, Processing in DRAM, Dataflow, stochastisch und hyperdimensional) laufen in den aktiven Testumgebungen und in der Conformance, nicht aber in den quartalslangen Simulationen, die früher durchgeführt wurden. Ihre Qualität ist gemessen, ihre Energie aus Spitzenwerten modelliert; die Leistungsaufnahme der Dataflow-Karte und die Energie pro Bitoperation der stochastischen und hyperdimensionalen Schaltungen sind als Annahmen mit Wertebereichen angegeben.
- Die Aufgaben sind klein: Sie werden in Joule gemessen, nicht in Kilowattstunden. Entscheidend sind die Verhältnisse, nicht die absoluten Summen.
- Die Last ist synthetisch, mit explizit angegebenen Verteilungen.
- Die kuberoot-Testumgebungen sind virtuelle Maschinen: in QEMU auf dem Laptop (ein und zwei Nodes) und in KubeVirt auf den Servern des Workshop-Clusters (vier Nodes auf drei physischen Servern), keine dedizierten Racks in einem Rechenzentrum. Die Ausfallsicherheit von kuberoot selbst (mehrere Control Planes, etcd) wurde hier nicht getestet. Getestet wurde, dass sich physis auf dem regulären Weg in kuberoot installieren lässt und sich so verhält, wie es die Tests verlangen.
- Das Netz von morgen ist erst teilweise gebaut. Verbindungen als Objekte mit Kosten, Übertragungszeit und Rechtsraum des Pfads funktionieren und werden von TC-17 geprüft; identitätsbasierte Adressierung von Substraten mit gegenseitiger Authentifizierung und die Übertragung von Objekten zwischen Substraten funktionieren und sind durch Tests und in einer Testumgebung verifiziert, aber standardmäßig abgeschaltet. Ein Postfach auf API-Objekten für Substrate hinter NAT, Datentransfer als Planschritt, Content Addressing und die kontextabhängige Wahl des Transports sind noch Entwurf; der Rechtsraum eines Substrats wird deklariert, nicht attestiert. Energie- und Bandbreitenwerte für Verbindungen stammen aus der Schätzung von Aslan mit Extrapolation sowie aus eigenen Annahmen.
11. Wie es weitergeht
physis ist kein Produkt, sondern eine im Code überprüfte These. Einiges, was in der ersten Fassung des Artikels auf dieser Liste stand, ist bereits erledigt: eine echte GPU als Substrat, identitätsbasierte Adressierung, drei Ebenen des Scheduling, eine Brücke von DRA, ein Gerätekernel außerhalb von Linux und eine Schnittstelle für Agenten. Die nächsten Schritte ergeben sich von selbst:
- Echte nicht standardmäßige Hardware. Ein Quantenprozessor aus der Cloud, Annealing auf FPGAs, ein neuromorphes Board, Server mit zugänglichen Energiezählern – und danach die Neukalibrierung der Modelle anhand der Quittungen aus Live-Daten.
- Datentransfer als Planschritt, mit Content Addressing und einem Postfach auf API-Objekten für Substrate hinter NAT.
- Eine Hierarchie ohne zentrales etcd. Heute teilen sich die Ebenen einen Speicher; der nächste Schritt besteht darin, den Standorten eigene Speicher zu geben und den Abgleich über Quittungen herzustellen.
- Ein Standard. Die Ressourcen, das Conformance-Profil und die Kostenattribute in DRA mit der Community diskutieren, so wie einst CNI und CSI diskutiert wurden (mehr dazu in den Abschnitten 12 und 13).
Alles ist offen: der Code, die Daten (über Download-Skripte), die Tests, die Modelle und ihre Quellen. Wenn Sie die Idee einer Infrastruktur anspricht, die auf morgen zielt, statt das Gestern mitzuschleppen, machen Sie mit – mit einem Substrat, mit Kritik am Modell oder mit einem Test, an dem unser Prototyp scheitert.
12. Wie sich Kubernetes weiterentwickeln lässt, damit es der Welt von gestern und der von morgen dient
Die einfache Schlussfolgerung aus dem Prototyp lautet: Kubernetes muss nicht neu geschrieben werden, es braucht eine andere Grenze zwischen dem Kern und dem, was an ihn angeschlossen wird. Heute ist diese Grenze so gezogen, als wären eine Linux-Maschine und Container Teil der API selbst. Das Node-Objekt, das Kubelet, der Pod und das Pod-Netzwerk sind fest ins Modell eingebaut, und alles Ungewöhnliche muss vorgeben, eines davon zu sein. Morgen wird eine Linux-Maschine ein Substrat unter vielen sein, und der Kern sollte über sie nicht mehr wissen als über einen Quantenprozessor.
Was im Kern bleiben sollte. Der API-Server mit seinem Speicher, Watch und optimistischer Nebenläufigkeitskontrolle; CRDs; RBAC; Admission und Audit; das Modell „gewünschter Zustand plus Controller“. Das ist der eigentliche Beitrag von Kubernetes, und der Prototyp stützt sich auf nichts anderes. In einer Testumgebung ganz ohne Nodes besteht physis alle 17 Tests. Es lohnt sich, diesen Kern als eigenständiges Produkt zu stabilisieren – eine Control Plane ohne Nodes, auf die kcp schon lange zusteuert – mit einem eigenen Conformance-Profil, das weder Node noch Pod voraussetzt.
Was austauschbar werden sollte. Jede Stelle, an der heute eine bestimmte Welt fest verdrahtet ist, wird zu einer gemeinsamen Schnittstelle mit mehreren Implementierungen, so wie CNI, CSI und CRI einst Netzwerk, Speicher und Runtime ausgelagert haben.
- Ausführung. Das Kubelet wird zu einer Implementierung der Schnittstelle des Substrat-Agenten: sich mit einem Modell beschreiben, dessen Parameter eine Herkunft tragen, regelmäßig melden, dass es lebt, Arbeit übernehmen, das Ergebnis signieren und den Bericht nach einer Verbindungsunterbrechung nachliefern. Ein Container-Node implementiert sie über Pods, ein Quantenprozessor über seinen Steuerungsstack, ein Mikrocontroller über einen Gerätekernel an einer seriellen Schnittstelle. Das Node-Objekt bleibt für diejenigen erhalten, die es brauchen, ist aber nicht mehr für jede Art von Arbeit Pflicht.
- Ressourcenbeschreibung. DRA beschreibt Geräte bereits mit strukturierten Attributen, ihm fehlen aber standardisierte Kostenattribute (Geschwindigkeit, Energie pro Operation, Leistungsaufnahme, Rüstzeit, Kalibrierfenster) mit Herkunftsangabe. Das ist eine kleine Erweiterung, die sich als KEP, der formale Kubernetes Enhancement Proposal, vorschlagen ließe, und die Brücke im Prototyp zeigt, wie sie sich auf das Scheduling abbilden würde.
- Scheduling. Neben dem kube-scheduler, der Pods auf Nodes platziert, brauchen wir einen Ergebnis-Scheduler als separate, austauschbare Komponente, der mit Aufgaben arbeitet, die als Ergebnisse beschrieben sind, und mit Zielen für Energie, CO₂, Geld und Rechtsraum. Der Plugin-Mechanismus des kube-scheduler (das Scheduling Framework) hilft hier nicht weiter, denn er beantwortet die Frage „welcher Node“, während die Frage nun lautet: „welcher Algorithmus, auf welcher Physik, wo und wann“.
- Netzwerk. kube-proxy und CNI werden zu einem Detail eines einzelnen Standorts. Zwischen Standorten werden Verbindungen als Objekte mit Kosten und Rechtsraum des Pfads zur gemeinsamen Schnittstelle, dazu identitätsbasierte Adressierung wie in Abschnitt 6.
- Abrechnung und Vertrauen. Signierte Quittungen werden neben Events zu einer Standard-API, unveränderlich und ohne Zugriff auf den Cluster überprüfbar. Quotas erhalten Dimensionen in Joule, Gramm CO₂ und Geld, und Mandate erweitern RBAC um die Delegation von Budgets von einem Menschen an einen Agenten.
Wie man die alte Welt nicht zerbricht. Pod, Deployment und Job bleiben. Für bestehende Arbeit kann sich eine Ergebnisaufgabe einfach zu einem Pod auf dem Substrat „Linux-Prozesse“ entfalten, sodass vorhandene Charts, Operatoren und GitOps weiter funktionieren. Die neuen Bausteine entstehen daneben, als CRDs und separate Komponenten, und verdrängen die alten nur dort, wo sie besser sind. So wurde der Prototyp gebaut, und kein einziger Schritt erforderte eine Änderung am Kubernetes-Code im Hauptrepository des Projekts.
In welcher Reihenfolge. Zuerst kommt, was nichts kaputt macht: standardisierte Kostenattribute in DRA und Energieabrechnung in Metriken und Quotas. Danach die Schnittstelle des Substrat-Agenten als eigene Spezifikation und der Ergebnis-Scheduler als externe Komponente. Dann ein Conformance-Profil „morgen“ neben dem heutigen, damit Implementierungen ehrlich angeben können, was sie unterstützen. Erst danach können Node und Pod im Kern optional werden – sobald es dafür lebende Implementierungen gibt und nicht nur einen Prototyp.
13. Cozystack als Plattform für diese Schicht
Cozystack ist eine Open-Source-Plattform der CNCF, auf der Provider ihre eigenen Clouds aufbauen: Kubernetes, virtuelle Maschinen auf Basis von KubeVirt, Managed Databases und Cluster für Tenants. Nichts von dem, was dieser Artikel beschreibt, existiert dort heute. Strukturell ist Cozystack der benötigten Form aber näher als blankes Kubernetes, denn es kennt bereits Tenants als Verantwortungsgrenze, einen Servicekatalog, Provider an verschiedenen Standorten und GPU-Unterstützung. Um zum Fundament der Schicht von morgen zu werden, muss es mehrere Schritte durchlaufen, und jeder davon ist für sich genommen sinnvoll.
Der erste Schritt macht den Tenant zum Träger von Mandaten und Budgets. Heute erhält ein Tenant Quotas für CPU und Arbeitsspeicher. Er braucht Budgets in Joule, Gramm CO₂ und Geld, dazu Zonen und Rechtsräume, und die Menschen innerhalb eines Tenants brauchen eine Möglichkeit, einen Teil des Budgets an Agenten zu delegieren – mit einer Autonomiestufe und einem Schwellenwert, oberhalb dessen eine menschliche Signatur erforderlich ist.
Der zweite Schritt ergänzt den Servicekatalog um einen Substratkatalog. Ein Provider auf Cozystack veröffentlicht nicht nur virtuelle Maschinen und Cluster, sondern auch Substrate (GPUs, Beschleuniger und später nicht standardmäßige Physiken) mit Kostenmodell, Herkunft der Parameter und Rechtsraum des Betreibers. Der natürliche Einstiegspunkt ist die DRA-Brücke aus diesem Prototyp. Sobald die GPUs, die Cozystack an Tenants vergibt, von einem DRA-Treiber beschrieben werden (der NVIDIA GPU Operator hat bereits einen solchen Modus), werden sie zu Substraten, sobald ein Agent sie übernimmt, der Arbeit auf ihnen ausführen kann.
Der dritte Schritt sorgt für eine Abrechnung, der man vertrauen kann. Energiezähler an den Standorten, die CO₂-Intensität des Stromnetzes und signierte Quittungen machen aus der Frage „Was hat das gekostet?“ statt einer Schätzung einen überprüfbaren Nachweis und aus der Abrechnung nach Joule und Gramm ein Produkt, das sich einer Aufsichtsbehörde vorlegen lässt.
Der vierte Schritt macht aus der Föderation einen Markt. Viele Cozystack-Provider in verschiedenen Ländern, verbunden durch Verbindungsobjekte mit Kosten und Rechtsraum des Pfads, bilden zusammen die „Cloud als Markt der Substrate“ aus Abschnitt 6. Souveränität wird hier zu einer Randbedingung des Scheduling statt zu einem Versprechen im Vertrag, und eine Aufgabe geht nur dorthin, wohin ihr Mandat und der Rechtsraum der Daten es erlauben.
Der fünfte Schritt bietet eine Schnittstelle für Agenten auf Plattformebene (einen MCP-Server, Pläne als Dry Run, Idempotenz, Ablehnungscodes und Rate Limiting), damit die Agenten der Tenants direkt mit der Plattform arbeiten, statt sich in einer Webkonsole als Menschen auszugeben.
Der sechste Schritt betrifft die Nodes. Für klassische Workloads bleibt Talos die richtige Wahl, weil es ausgereift ist, und KubeVirt, auf dem die virtuellen Maschinen von Cozystack beruhen, hat gerade die höchste Reifestufe der CNCF für Projekte erreicht (graduated). Cozystack vollständig auf kuberoot umzustellen, ergibt derzeit keinen Sinn. Spezialisierte Substrate brauchen jedoch Nodes ohne Container, auf denen der Agent als Dienst des Betriebssystems selbst läuft. kuberoot dient hier als Labor, in dem das vom Kernel bis zur API erprobt wird, und was sich bewährt, wandert als Komponenten in den Standard.
Der letzte Schritt betrifft die Conformance. Eine neutrale Open-Source-Plattform ist ein guter Ort für die Referenzimplementierung des Profils „morgen“ – nicht, um den Standard zu besitzen, sondern damit der Standard eine lebende Implementierung hat, die jeder Provider ausrollen und überprüfen kann. In diesem Modell werden Unternehmen wie Ænix zu Anbietern von Produkten auf der Plattform und zu einem Beschleuniger für andere Provider. Man kann klein anfangen, und zwar schon heute, denn physis hat ein Helm-Chart und lässt sich wie jede andere Anwendung in den Kubernetes-Cluster eines Cozystack-Tenants installieren.
Quellen und Daten
Die Zahlen in eckigen Klammern im Text verweisen auf diese Liste. Die vollständige Liste mit Anmerkungen dazu, was wir selbst überprüft haben, sowie sämtliche Daten finden Sie im Repository des Projekts: https://github.com/kuberoot-dev/physis
- IFTF Ten-Year Forecast 2025–2035 “Strategy in the Age of Chaos”. https://www.iftf.org/events/iftf-ten-year-forecast-2025-2035-sanctuaries-of-social-imagination/ ; perspectives: https://www.iftf.org/projects/iftf-ten-year-forecast-urgent-futures-perspectives/
- Yield Theory, “Hyperscaler Capex 2026: $720B to $740B Guidance by Company” (updated 5 November 2026). https://www.yieldtheory.app/research/hyperscaler-ai-capex-tracker-2026
- Gartner, “Gartner Forecasts Worldwide IT Spending to Grow 14.2% in 2026, Totaling $6.37 Trillion”, 27 July 2026. https://www.gartner.com/en/newsroom/press-releases/2026-07-27-gartner-forecasts-worldwide-it-spending-to-grow-14-point-2-percent-in-2026-totaling-6-point-37-trillion ; the Gartner page refuses automated fetching, the release is checked through TelecomTV: https://www.telecomtv.com/content/digital-platforms-services/gartner-forecasts-worldwide-it-spending-to-grow-14-2-in-2026-totalling-6-37tn-55964/
- Grid interconnection and data centre power. https://www.softwareseni.com/the-broken-power-grid-infrastructure-bottlenecks-driving-the-nuclear-push-for-ai-data-centres/
- The Landauer limit kT ln 2 per erased bit (textbook result).
- Wood Mackenzie, “Supply shortages and an inflexible market give rise to high power transformer lead times”: lead times from about 50 weeks in 2021 to 120 weeks on average in 2024. https://www.woodmac.com/news/opinion/supply-shortages-and-an-inflexible-market-give-rise-to-high-power-transformer-lead-times/
- Scripps O2 Program: “The observed downward trend amounts to 19 ‘per meg’ per year”, mostly from fossil-fuel burning. https://scrippso2.ucsd.edu
- M. Le Gallo et al., “A 64-core mixed-signal in-memory compute chip based on phase-change memory for deep neural network inference”, Nature Electronics (2023), doi:10.1038/s41928-023-01010-1. 63.1 TOPS at 9.76 TOPS/W for 8-bit input/output MVM; effective MVM precision 3–4 bits. HERMES, 63.1 TOPS and 9.76 TOPS/W are in the abstract; the 3–4-bit precision is in the body text (arXiv:2212.02872); see also HPCwire’s summary: https://www.hpcwire.com/off-the-wire/ibm-develops-a-new-64-core-mixed-signal-in-memory-computing-chip/
- Sandia, Hala Point (1152 Loihi 2 chips, 1.15 billion neurons). https://www.sandia.gov/news/publications/hpc-annual-reports/article/advancing-neuromorphic-computing-at-the-neural-exploration-and-research-lab/
- M. Davies et al., “Loihi: A Neuromorphic Manycore Processor with On-Chip Learning”, IEEE Micro 38(1), 2018. Energy per synaptic operation as reported by later surveys: 20–25 pJ (we did not find the figure in the paper’s abstract). https://arxiv.org/pdf/2509.23896
- N. S. Singh et al., CMOS plus stochastic magnetic tunnel junctions for probabilistic computing (arXiv:2304.05949). The paper does not measure sMTJ p-bit energy; it repeats an earlier projection of about 2 fJ per random bit (its Ref. [28]), and reports 145–293 fJ for CMOS p-bits. https://arxiv.org/html/2304.05949v3
- Extropic thermodynamic computing. https://extropic.ai/writing/from-one-to-one-billion
- K. Tatsumura, A. Dixon, H. Goto, “FPGA-Based Simulated Bifurcation Machine”, FPL 2019: 2000-node all-to-all MAX-CUT 14× faster than the CIM and 124× faster than optimised simulated annealing (paper, doi:10.1109/FPL.2019.00019). Slides: https://fpl2019.bsc.es/sites/default/files/uploaded/A12.FPL2019-slides-FPGABasedSimulatedBifurcation.pdf ; algorithm: H. Goto, K. Tatsumura, A. Dixon, Science Advances (2019), doi:10.1126/sciadv.aav2372.
- Optical Ising machine based on polarization symmetry breaking in a driven Kerr resonator (Auckland/Dijon/Strathclyde), Nature Communications (2026). https://thequantuminsider.com/2026/03/24/new-zealand-researchers-report-advance-in-optical-ising-machine-for-hybrid-quantum-optimization/
- Vaire Computing adiabatic reversible test chip “Ice River”: tested in August 2025, it “drew around 30 percent less energy than a regular chip performing the same computation” (Science News). https://www.sciencenews.org/article/computer-chip-reuses-energy ; https://www.techradar.com/pro/more-like-a-pendulum-than-a-hammer-the-ai-chip-that-can-reuse-its-own-energy-reaches-proof-of-concept-stage-but-i-dont-think-it-will-be-enough-to-convince-hyperscalers-to-invest
- imec superconducting digital computing: “How to Put a Data Center in a Shoebox”, IEEE Spectrum. https://spectrum.ieee.org/superconducting-computer
- B. A. Primavera, J. M. Shainline, “Considerations for neuromorphic supercomputing in semiconducting and superconducting optoelectronic hardware”, arXiv:2106.14803: Carnot limit 74 W/W at 4 K from 300 K; “State-of-the-art systems have reached specific powers below 400 W/W”. https://arxiv.org/abs/2106.14803
- Development of a 4 K–10 K Collins-type cryocooler for space, SPIE 5904 (2005), abstract: “machines based on the conventional Collins or Brayton cycles routinely operate with input powers of about 740 Watts per Watt of refrigeration at 4K”; small coolers of about 1 W at 4 K “typically require 5 kW–7.5 kW per Watt”. https://opticalengineering.spiedigitallibrary.org/conference-proceedings-of-spie/5904/59040X/Development-of-a-4K-10K-Collins-type-cryocooler-for-space/10.1117/12.626151.full
- Minimalistic photonic matrix processor: 0.27 pJ/MAC laser energy at 10 mW and 36.7 GBaud (arXiv:2403.04216). https://arxiv.org/pdf/2403.04216
- Hybrid classical-quantum supercomputing: multi-user, multi-QPU and multi-GPU environment at PCSS under Slurm (arXiv:2508.16297). https://arxiv.org/pdf/2508.16297
- F. Arute et al., supplementary information for “Quantum supremacy using a programmable superconducting processor” (arXiv:1910.11333): total worst-case apparatus power about 26 kW (dilution refrigerator about 10 kW plus chilled water, about 3 kW electronics). https://arxiv.org/pdf/1910.11333
- Cortical Labs CL1 (heise online, 12 March 2025): human neurons grown from stem cells on a chip, about $35,000 per device, about 20 W, cells live “up to six months”. We model 30 W of life support (range 20–100 W); a higher figure only makes the culture less attractive, which changes no result. https://heise.de/-10312614
- FinalSpark Neuroplatform; organoid lifetime about 100 days. https://www.tomshardware.com/pc-components/cpus/worlds-first-bioprocessor-uses-16-human-brain-organoids-for-a-million-times-less-power-consumption-than-a-digital-chip
- L. G. Wright et al., deep physical neural networks trained with backpropagation, Nature 601 (2022); training review Nature 645 (2025). https://mcmahon.aep.cornell.edu/aspen/2024/slides/Wright.pdf
- Mechanical metamaterials with reprogrammable sequential deformation for analog-to-digital encoding and computing, Advanced Materials (2026). https://advanced.onlinelibrary.wiley.com/doi/10.1002/adma.74376
- N. P. Jouppi et al., “In-Datacenter Performance Analysis of a Tensor Processing Unit”, ISCA 2017 (arXiv:1704.04760): “a 65,536 8-bit MAC matrix multiply unit that offers a peak throughput of 92 TeraOps/second”; TOPS/Watt “about 30X - 80X higher” than contemporary GPU or CPU; 75 W TDP, 40 W busy. https://arxiv.org/abs/1704.04760
- N. P. Jouppi et al., “TPU v4: An Optically Reconfigurable Supercomputer”, ISCA 2023 (arXiv:2304.01433): “outperforms TPU v3 by 2.1x and improves performance/Watt by 2.7x”. https://arxiv.org/abs/2304.01433
- D. Abts et al., “Think Fast: A Tensor Streaming Processor for Accelerating Deep Learning Workloads”, ISCA 2020, doi:10.1109/ISCA45697.2020.00023 (abstract): no “reactive elements in the hardware (e.g. arbiters, and caches)”; slides (ISC 2020): “~750 Tops (Int8Acc32) peak”, “220 MiBytes of globally shared SRAM”. Power is not given in these sources. https://mlhardware.github.io/2020/groq.pdf
- Cerebras, “Cerebras announces third generation wafer scale engine”, 13 March 2024: “900,000 AI optimized compute cores”, “44GB on-chip SRAM”, “125 petaflops of peak AI performance”. https://www.cerebras.ai/press-release/cerebras-announces-third-generation-wafer-scale-engine
- R. Prabhakar et al., “SambaNova SN40L: Scaling the AI Memory Wall with Dataflow and Composition of Experts”, arXiv:2405.07518: 1040 compute and 1040 memory units, 520 MiB on-chip SRAM, operator fusion on chip. https://arxiv.org/abs/2405.07518
- Y.-C. Kwon et al., “A 20nm 6GB Function-In-Memory DRAM, Based on HBM2 with a 1.2TFLOPS Programmable Computing Unit Using Bank-Level Parallelism”, ISSCC 2021, doi:10.1109/ISSCC42613.2021.9365862 (abstract).
- S. Lee et al., “Hardware Architecture and Software Stack for PIM Based on Commercial DRAM Technology”, ISCA 2021, doi:10.1109/ISCA52012.2021.00013 (abstract): “reduces the energy per bit transfer by 3.5×”.
- J. Gómez-Luna et al., “Benchmarking a New Paradigm: Experimental Analysis and Characterization of a Real Processing-in-Memory System”, IEEE Access 10 (2022), doi:10.1109/ACCESS.2022.3174101 (arXiv:2105.03814): the UPMEM systems “outperform a modern CPU (by 93.0× and 27.9×, on average, respectively) for 13 of the PrIM benchmarks”. https://arxiv.org/abs/2105.03814
- P. Micikevicius et al., “FP8 Formats for Deep Learning”, arXiv:2209.05433: E4M3 and E5M2; “effectively matching the result quality achieved by 16-bit training sessions” up to 175B-parameter models. https://arxiv.org/abs/2209.05433
- B. D. Rouhani et al., “Microscaling Data Formats for Deep Learning”, arXiv:2310.10537: blocks of 32 with a shared E8M0 scale; training with 4-bit MX weights, “incurring only a minor accuracy drop”. https://arxiv.org/abs/2310.10537
- M. Horowitz, “Computing’s energy problem (and what we can do about it)”, ISSCC 2014, doi:10.1109/ISSCC.2014.6757323. Energy per operation at 45 nm (8-bit multiply ≈ 0.2 pJ, 8-bit add ≈ 0.03 pJ). Copy: https://www.Gwern.net/doc/cs/hardware/2014-horowitz-2.pdf (we did not re-read the table in this work; the values are the widely cited ones).
- A. Alaghi, J. P. Hayes, “Survey of Stochastic Computing”, ACM TECS 12(2s), 2013: multiplication by “a single AND gate”; “A stochastic number p̂ of length n has m = log2 n bits of precision”. https://homes.cs.washington.edu/~armin/ACM_TECS_2013.pdf
- P. Kanerva, “Hyperdimensional Computing”, Cognitive Computation 1 (2009), doi:10.1007/s12559-009-9009-8: “When bits fail, the information degrades in relation to the number of failing bits irrespective of their position”. https://cs.uwaterloo.ca/~jhoey/teaching/cogsci600/papers/Kanerva09.pdf
- G. Karunaratne et al., “In-memory hyperdimensional computing”, Nature Electronics 3 (2020), doi:10.1038/s41928-020-0410-3 (arXiv:1906.01548): “> 6× end-to-end reductions in energy compared with a dedicated digital CMOS implementation”. https://arxiv.org/abs/1906.01548
- A. Podobas, K. Sano, S. Matsuoka, “A Survey on Coarse-Grained Reconfigurable Architectures From a Performance Perspective”, IEEE Access 8 (2020), doi:10.1109/ACCESS.2020.3012084 (arXiv:2004.04509): “a majority of CGRAs can execute more operations … per unit power” than GPUs; “Some architectures, such as the Plasticine, can be up to two orders of magnitude more power-efficient”. https://arxiv.org/abs/2004.04509
- Panmnesia and Meta, CXL fabric spanning AI datacentres. https://www.hpcwire.com/off-the-wire/panmnesia-and-meta-outline-cxl-fabric-spanning-entire-ai-data-centers/ ; “One-chip-like datacenter design enabled by CXL-based scale-up fabrics”, Nature Reviews Electrical Engineering (2026). https://www.nature.com/articles/s44287-026-00315-5
- “OCP 2026: Agentic AI Pushes the Data Center from Chip to Grid”. https://www.datacenterfrontier.com/hyperscale/article/55411534/ocp-2026-agentic-ai-pushes-the-data-center-from-chip-to-grid
- Oxide Computer: a rack designed as one integrated platform (compute, storage, networking, software). https://oxide.computer/
- “Your Container Is Not a Sandbox: The State of MicroVM Isolation in 2026”. https://emirb.github.io/blog/microvm-2026/
- Linux Foundation, “Linux Foundation is Launching the x402 Foundation and Welcoming the Contribution of the x402 Protocol”, 2 April 2026. https://www.linuxfoundation.org/press/linux-foundation-is-launching-the-x402-foundation-and-welcoming-the-contribution-of-the-x402-protocol
- “FIDO Alliance to start work on interoperable standards for agentic commerce”, Biometric Update, April 2026: work drawing on initial contributions from Google (AP2) and Mastercard. https://www.biometricupdate.com/202604/fido-alliance-to-start-work-on-interoperable-standards-for-agentic-commerce
- Future Today Strategy Group, Convergence Outlook 2026 (Amy Webb, SXSW 2026), as reported by Meio & Mensagem and FTSG’s own summaries; the full report is behind a form. https://sxsw.md/news/2026-03-16-amy-webb-end-of-trend-reports ; https://fortune.com/brandstudio/future-today-strategy-group/the-5-convergences-that-will-redefine-business
- Institute for the Future, Ten-Year Forecast 2036 “What We Choose Next” (October 2026). https://www.iftf.org/projects/iftf-ten-year-forecast-2036-tyf/
- Niobium, “The Fog”: encrypted cloud for FHE workloads, private beta April 2026, running on the mistic Core FPGA accelerator; Niobium’s FHE ASIC is in development. https://www.darkreading.com/endpoint-security/niobium-introduces-the-fog ; https://siliconangle.com/?p=737132
- L. de Moura, “Lean 4: A Unified Platform for Programming and Verification”, NFM 2026. https://leodemoura.github.io/static/nfm2026/
- Epoch AI, LLM inference price trends. https://epoch.ai/blog/llm-inference-price-trends
- W. S. Jevons, The Coal Question, 1865; on the rebound effect see B. Alcott, “Jevons’ paradox”, Ecological Economics 54 (2005), doi:10.1016/j.ecolecon.2005.03.020. Checked: title, author, journal and volume via Crossref.
- FIA, “What are compute futures”. https://www.fia.org/fia/articles/explainer-what-are-compute-futures-and-how-do-they-work
- EQT Ventures on outcome-based pricing. https://stories.eqtventures.com/articles/monetising-the-agentic-workforce-is-outcome-based-pricing-the-answer
- Regulation (EU) 2023/2854 (Data Act), Article 29: “From 12 January 2027, providers of data processing services shall not impose any switching charges on the customer for the switching process.” https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:32023R2854
- “Going Beyond Hyperscaler Clouds in the Sky Ecosystem with SkyPilot”. https://www2.eecs.berkeley.edu/Pubs/TechRpts/2023/EECS-2023-179.html
- ABI Research, “Physical AI at Scale: Why Robotics Needs a New Data Infrastructure”. https://www.abiresearch.com/blog/physical-ai-at-scale-why-robotics-needs-a-new-data-infrastructure
- Google Project Suncatcher: two prototype TPU satellites with Planet Labs by early 2027 (Interesting Engineering); Starcloud satellite with an NVIDIA GPU. https://interestingengineering.com/innovation/google-project-suncatcher-space-ai ; https://www.fierce-network.com/cloud/space-data-centers-starcloud-spacex-and-project-suncatcher-explained
- S. Burleigh, K. Fall, E. Birrane, “Bundle Protocol Version 7”, RFC 9171, 2022. https://www.rfc-editor.org/rfc/rfc9171
- “Barbarians at the Gate: How AI is Upending Systems Research”, arXiv:2510.06189. https://arxiv.org/abs/2510.06189v1
- “DBOS: A DBMS-oriented Operating System”, PVLDB 15. https://mail.vldb.org/pvldb/volumes/15/paper/DBOS%3A%20A%20DBMS-oriented%20Operating%20System
- J. Hellerstein, Hydro. https://jhellerstein.github.io/blog/hello-aws
- J. Hellerstein, P. Alvaro, “Keeping CALM: When Distributed Consistency Is Easy”, CACM 2020.
- M. Kleppmann, local-first software (SE Radio 716, 2026). https://se-radio.net/2026/04/se-radio-716-martin-kleppmann-local-first-software/
- Ink & Switch, “Malleable Software”, 2025. https://www.inkandswitch.com/essay/malleable-software/
- Biomemory DNA storage in datacenters (Blocks & Files, 2026). https://www.blocksandfiles.com/architecture/2026/03/06/french-dna-coming-to-a-datacenter-near-you-soon/4093753
- “Morgan Stanley estimates global AI debt issuance to double to $570 billion in 2026” (Reuters via newkerala, 10 June 2026): “global debt issuance for AI companies to top $500 billion in 2026”. https://www.newkerala.com/news/a/morgan-stanley-estimates-global-ai-debt-issuance-double-248.htm
- Bank of England, Financial Stability Report, July 2026, section 2.3: “chips have short and uncertain lifecycles … debt maturities aligned with the asset life of AI chips would imply shorter tenors than are typically preferred by most credit investors”. https://www.bankofengland.co.uk/-/media/boe/files/financial-stability-report/2026/financial-stability-report-july-2026.pdf
- Stockholm Data Parks: heat recovery from data centres paid for by the district heating network. https://stockholmdataparks.com/
- J. Spolsky, “Strategy Letter V” (commoditize your complements), 2002. https://www.joelonsoftware.com/2002/06/12/strategy-letter-v/
- B. Laurie, A. Langley, E. Kasper, “Certificate Transparency”, RFC 6962, 2013 (the version deployed logs implement). https://www.rfc-editor.org/rfc/rfc6962
- B. Laurie, E. Messeri, R. Stradling, “Certificate Transparency Version 2.0”, RFC 9162, 2021. https://www.rfc-editor.org/rfc/rfc9162
- Sigstore Rekor, an append-only transparency log for signed software artefacts. https://docs.sigstore.dev/logging/overview/
- A. Verma et al., “Large-scale cluster management at Google with Borg”, EuroSys 2015.
- “Kubernetes v1.34: DRA has graduated to GA”, Kubernetes blog, 2025. https://kubernetes.io/blog/2025/09/01/kubernetes-v1-34-dra-updates/ ; documentation: https://kubernetes.io/docs/concepts/scheduling-eviction/dynamic-resource-allocation/
- KEP-3866, “Add an nftables-based kube-proxy backend”: alpha 1.29, beta 1.31, stable 1.33; iptables remains the default. https://www.k8s.dev/resources/keps/3866/ ; “NFTables mode for kube-proxy”, Kubernetes blog, 2025. https://kubernetes.io/blog/2025/02/28/nftables-kube-proxy/
- KEP-5495: deprecate ipvs mode in kube-proxy (deprecated in 1.35). https://www.k8s.dev/resources/keps/5495/
- kcp: “Kubernetes-like control planes for form-factors and use-cases beyond Kubernetes and container workloads”; it serves Kubernetes-style APIs with no nodes. https://github.com/kcp-dev/kcp
- Virtual Kubelet: a kubelet implementation that “masquerades as a kubelet for the purposes of connecting Kubernetes to other APIs” (ACI, AWS Fargate and others). https://github.com/virtual-kubelet/virtual-kubelet
- Talos Linux: an immutable, API-managed OS that runs only Kubernetes. https://www.talos.dev/
- Oxide Computer, Hubris: a small open-source operating system for deeply-embedded systems (the microcontrollers of Oxide’s racks). https://hubris.oxide.computer/
- Kubernetes, “Considerations for large clusters”: designed for at most 110 pods per node, 5,000 nodes, 150,000 pods and 300,000 containers. https://kubernetes.io/docs/setup/best-practices/cluster-large/
- Kubernetes cluster networking model: every pod has its own IP, pods communicate without NAT. https://kubernetes.io/docs/concepts/cluster-administration/networking/
- J. Ousterhout, “It’s Time to Replace TCP in the Datacenter”, arXiv:2210.00714. https://arxiv.org/abs/2210.00714
- J. Aslan, K. Mayers, J. Koomey, C. France, “Electricity Intensity of Internet Data Transmission: Untangling the Estimates”, Journal of Industrial Ecology 22(4), 2018, doi:10.1111/jiec.12630: 0.06 kWh/GB in 2015, halving about every two years. We extrapolate to 2026 (0.06 / 2^5.5 kWh/GB); the extrapolation is ours.
- C. Lattner et al., “MLIR: Scaling Compiler Infrastructure for Domain Specific Computation”, CGO 2021; preprint “MLIR: A Compiler Infrastructure for the End of Moore’s Law”, arXiv:2002.11054. https://arxiv.org/abs/2002.11054
- D. Ackley, robust-first computing and the Movable Feast Machine. https://highscalability.com/pursue-robust-indefinite-scalability-with-the-movable-feast/ ; T2 Tiles: https://creativegood.com/blog/21/ackley-and-tiles.html
- Assessing the elephant in the room in scheduling for current hybrid HPC-QC clusters (arXiv:2504.10520). https://arxiv.org/pdf/2504.10520
- Gset best-known MaxCut values: G1 = 11624, G2 = 11620, G22 = 13359, confirmed in two independent sources (e.g. arXiv:2606.03917 and the Tabu-search comparison table of Ma and Hao 2017 as cited). Instances: https://web.stanford.edu/~yyye/yyye/Gset/
- E. Alpaydin, C. Kaynak, “Optical Recognition of Handwritten Digits”, UCI Machine Learning Repository (CC BY 4.0). https://archive.ics.uci.edu/dataset/80/optical+recognition+of+handwritten+digits ; files: https://archive.ics.uci.edu/ml/machine-learning-databases/optdigits/optdigits.tra
- AMD EPYC 9454P: 48 cores, 290 W default TDP, configurable 240–300 W (reseller specification sheets; AMD lists the same). https://www.scan.co.uk/products/amd-epyc-9454p-s-sp5-5nm-zen-4-48-core-96-thread-275ghz-38ghz-turbo-256mb-290w-cpu-oem
- Fraunhofer ISE, Energy-Charts API (public net generation; day-ahead prices CC BY 4.0 from Bundesnetzagentur | SMARD.de). https://api.energy-charts.info/
- IPCC AR5 WGIII Annex III, Table A.III.2, life-cycle emission medians (gCO2e/kWh): coal 820, gas 490, biomass 230, solar PV utility 48, geothermal 38, hydro 24, nuclear 12, wind onshore 11 (the code uses 11.5, a transcription slip kept so that the published results reproduce; at most 0.5 g/kWh), wind offshore 12. Checked against the primary: https://www.ipcc.ch/site/assets/uploads/2018/02/ipcc_wg3_ar5_annex-iii.pdf ; NREL harmonisation for comparison: https://www.nrel.gov/docs/fy21osti/80580.pdf
- National Energy System Operator, Carbon Intensity API (forecast and actual, CC BY 4.0). https://carbonintensity.org.uk/
Quellen, die im Text nicht zitiert werden, aber als Hintergrund dienten:
- S. Ambrogio et al., “An analog-AI chip for energy-efficient speech recognition and transcription”, Nature 620 (2023). Up to 12.4 TOPS/W. https://www.nature.com/articles/s41586-023-06337-5
- N. A. Aadit et al., “Massively parallel probabilistic computing with sparse Ising machines”, Nature Electronics (2022). Background for p-bit throughput; no figure is taken from it.
- NTT, coherent Ising machine with up to 1936 coupled DOPOs, Nature Communications 9 (2018). https://ideas.repec.org/a/nat/natcom/v9y2018i1d10.1038_s41467-018-07328-1.html
- Lightmatter photonic interconnect roadmap. https://convergedigest.com/ai-infrastructure-summit-lightmatters-photonic-roadmap/?amp=1
Häufig gestellte Fragen
Was ist ein Substrat in physis?
Warum Nodes aus Kubernetes entfernen?
Wie entscheidet der Scheduler?
Wie wurde das getestet?
Kann ich es selbst ausführen?
Testen Sie sich: Infrastruktur von morgen
5 questions · ~2 min