
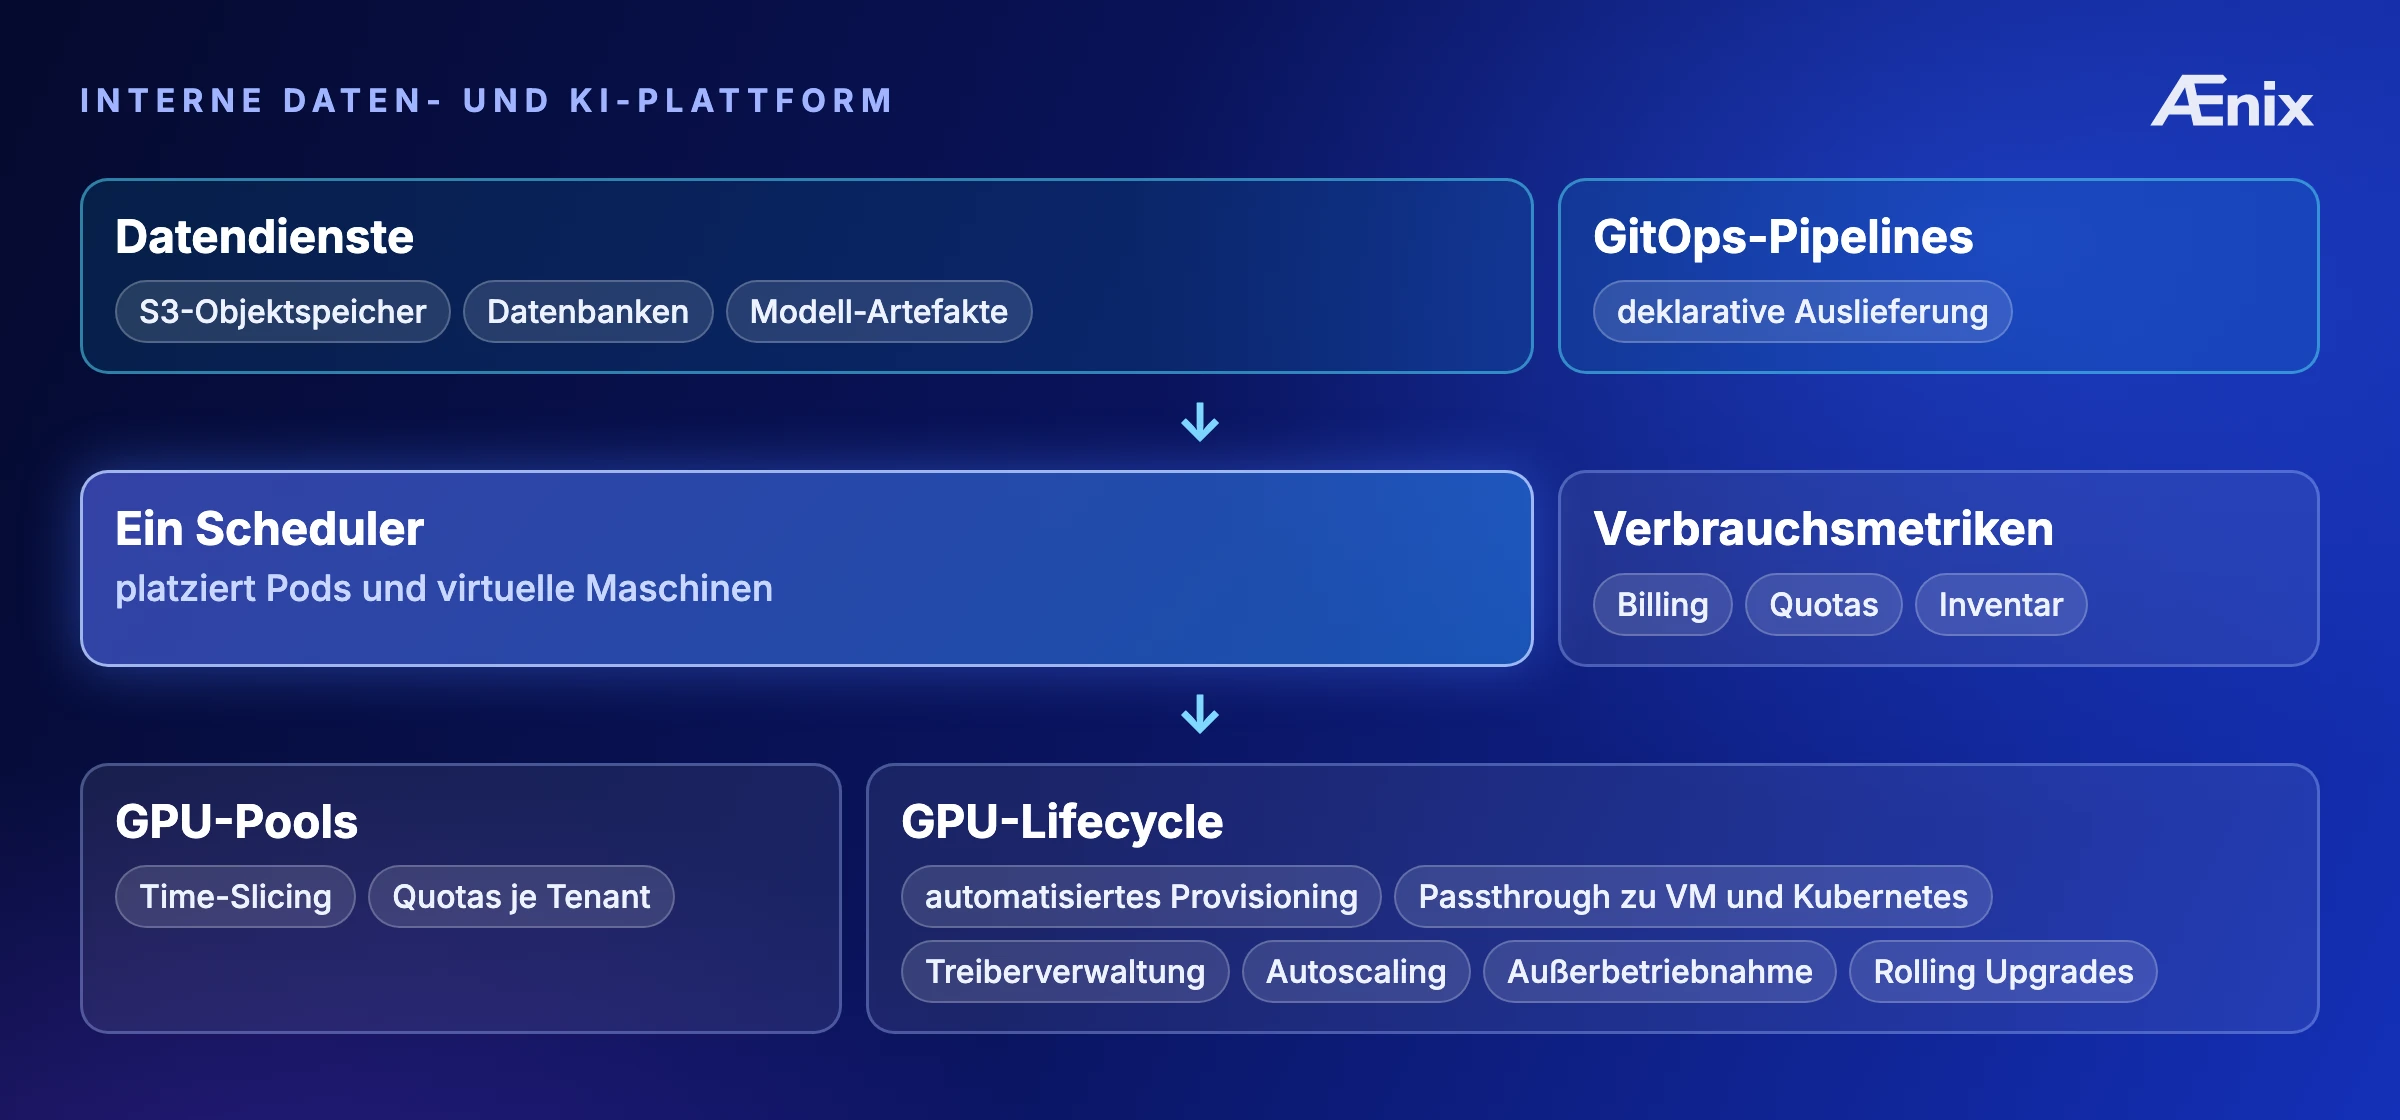
Eine interne Plattform für zwei Dinge, die große Organisationen sonst zweimal bauen: Daten — Analytik, Lakes und Marts, Modelltraining — und KI/ML-Services von der Entwicklung über das Training bis zum Serving. Darunter liegt KI-taugliche Infrastruktur: GPU-Ressourcenpools mit Quotas je Tenant, ein einziger Scheduler, der Pods und virtuelle Maschinen platziert, und Verbrauchsmetriken, die fein genug sind, um Teams zu verrechnen und zu sehen, wohin Kapazität tatsächlich geht. Das Projekt ist in Einführung: GPU-Unterstützung läuft, das MVP der KI-Services ist weitgehend fertig.
Über das Projekt
Der Kunde baut eine interne Plattform, die Datenmanagement und KI/ML-Arbeit für die gesamte Organisation abdeckt, statt jede Funktion ihren eigenen Stack ansammeln zu lassen. Auf der Datenseite: Analytik, Data Lakes und Data Marts, Modelltraining. Auf der KI/ML-Seite: Modelle betreiben, entwickeln und trainieren, als Service für andere Teams.
Beides wird üblicherweise als getrennte Programme geführt — und verbringt danach Jahre damit, sich Datensätze zuzukopieren. Hier teilen sie sich von Anfang an Infrastruktur, Mandantenfähigkeit und Quotas.
Ziele
- Eine interne Plattform für Datenmanagement und KI/ML-Services statt zweier Betriebsmodelle über einem Bestand.
- GPU-Kapazität, die zwischen Teams geteilt werden kann, ohne jemanden auszuhungern und ohne Karten brachliegen zu lassen.
- Verbrauch genau genug messen, um intern zu verrechnen und Kapazitätsentscheidungen auf Belege zu stützen.
- Mandantenfähigkeit stark genug, dass Teams auf gemeinsamer Hardware isoliert arbeiten.
- Automatisierung des GPU-Lifecycles von der Bereitstellung bis zur Außerbetriebnahme.
Lösung
KI-taugliche Infrastruktur: GPUs für Kubernetes und für VMs.
- GPU-Infrastrukturschicht — GPU-Ressourcenpools und Quotas je Tenant und je Projekt.
- Ein Scheduler — ein Planer für Pods und virtuelle Maschinen, mit Auslastungsmetriken, die Leistungsverrechnung und tiefe Analyse speisen.
- Daten und Pipelines — S3-kompatibler Speicher, Datenbanken und Modell-Artefakte, Pipelines GitOps-artig automatisiert.
Vollständiges GPU-Lifecycle-Management. Automatisiertes GPU-Provisioning, Passthrough in VMs und in Kubernetes sowie Treiberverwaltung — zusammengeführt statt pro Fall geskriptet:
- Voller Autopilot für NVIDIA-Karten; GPU-Passthrough für andere Hersteller.
- Automatische Treiberinstallation und GPU-Ressourcenverwaltung in Kubernetes.
- Lifecycle- und Ressourcenmanagement, Autoscaling und Provisioning auf Abruf.
- Sicherheit und Mandantenfähigkeit, Außerbetriebnahme und Rolling Upgrades.
Was die Plattform heute kann
- Monitoring — Auslastung, Last und die ungenutzte Kapazität, die vorher niemand erfasst hat.
- Provisioning — schnelle Zuteilung von GPU oder vGPU an ein ML-Projekt.
- Mandantenfähigkeit — isolierte Arbeitsbereiche je Team.
- Billing und Quotas — Limits, Tarife, Verbrauchserfassung.
- Dynamische Zuteilung — GPUs gehen bei Freigabe zurück in den Pool, statt reserviert zu bleiben.
- Inventar — jede Karte, ihr Standort und ihr Zustand in einem Register.
Roadmap
- Phase 1 — fertig. GPU-Unterstützung. Autopilot für NVIDIA, Passthrough für andere Hersteller, Monitoring und Ressourcenerfassung. Das ist die Infrastrukturschicht.
- Phase 2 — zwei Monate, rund 70% erledigt. Erstes MVP der KI-Services. KI-Services im Plattform-Dashboard, Unterstützung für GPUs anderer Hersteller, verbreitete selbst gehostete Modelle.
- Phase 3 — drei Monate. Erweiterte Services. Bessere Orchestrierung der KI-Services, Enterprise-Werkzeugsatz für GPUs, MIG-Unterstützung.
- Phase 4 — Ausbau. Feinabstimmung der KI-Plattform und Automatisierung für Nicht-NVIDIA-GPUs.
Warum dieser Fall zählt
Daten und KI auf einer Plattform
Gleicher Speicher, gleiche Mandantenfähigkeit, gleiche Quotas. Kein zweites Betriebsmodell und keine Kopie jedes Datensatzes zwischen zwei Stacks.
Pods und VMs, ein Scheduler
Erst das macht Leistungsverrechnung möglich: Zwei Scheduler, die beide die Karten für ihr Eigentum halten, liefern keine Zahl, die jemand unterschreibt.
Brachliegende GPUs sind eine messbare Größe
Auslastung, Last und ungenutzte Kapazität je Tenant — und frei werdende Karten gehen zurück in den Pool statt gebucht zu bleiben.
Eine Roadmap mit einer fertigen Phase
GPU-Unterstützung läuft; die KI-Service-Schicht entsteht darauf. Veröffentlicht während der Umsetzung, nicht im Rückblick.
Ein ähnliches Projekt besprechen
Ein 30-minütiges Discovery-Gespräch reicht, um zu klären, ob diese Architektur zu Ihrer Umgebung passt und was der erste Schritt wäre.
Diese Case Study beschreibt ein laufendes Projekt und erscheint anonymisiert: Der Kunde wird über sein Profil beschrieben, nicht über seinen Namen. Eine Kundenreferenz ist unter NDA auf Anfrage möglich — sprechen Sie mit dem Ænix-Vertrieb.
Ænix hat Cozystack, ein CNCF-Sandbox-Projekt (Antrag auf CNCF Incubation in der Due-Diligence-Prüfung) unter der Apache-2.0-Lizenz, entwickelt und pflegt es gemeinsam mit Maintainern anderer Unternehmen. Darauf baut Ænix drei Plattformen, die sich kombinieren statt ausschließen lassen: Ænix Public Cloud Platform, Ænix Private Cloud Platform und Ænix AI Platform.